
Strata 0.2.10 は 8 GB のカードで 128K コンテキストを開き、Qwen3.8 を速くする
要約
Strata 0.2.10 は既定の投機的デコーダを 625 MB の小さなモデルに替え、8 GB のカードでも 128K のコンテキストを開けるようにした。Linux の二枚差しでは全カード分割によりコード編集がほぼ二倍になる。
おすすめ- ソフト名
- Strata
- バージョン
- 0.2.10
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsmacOSLinux
- 更新日時
- 2026-11-03 23:00
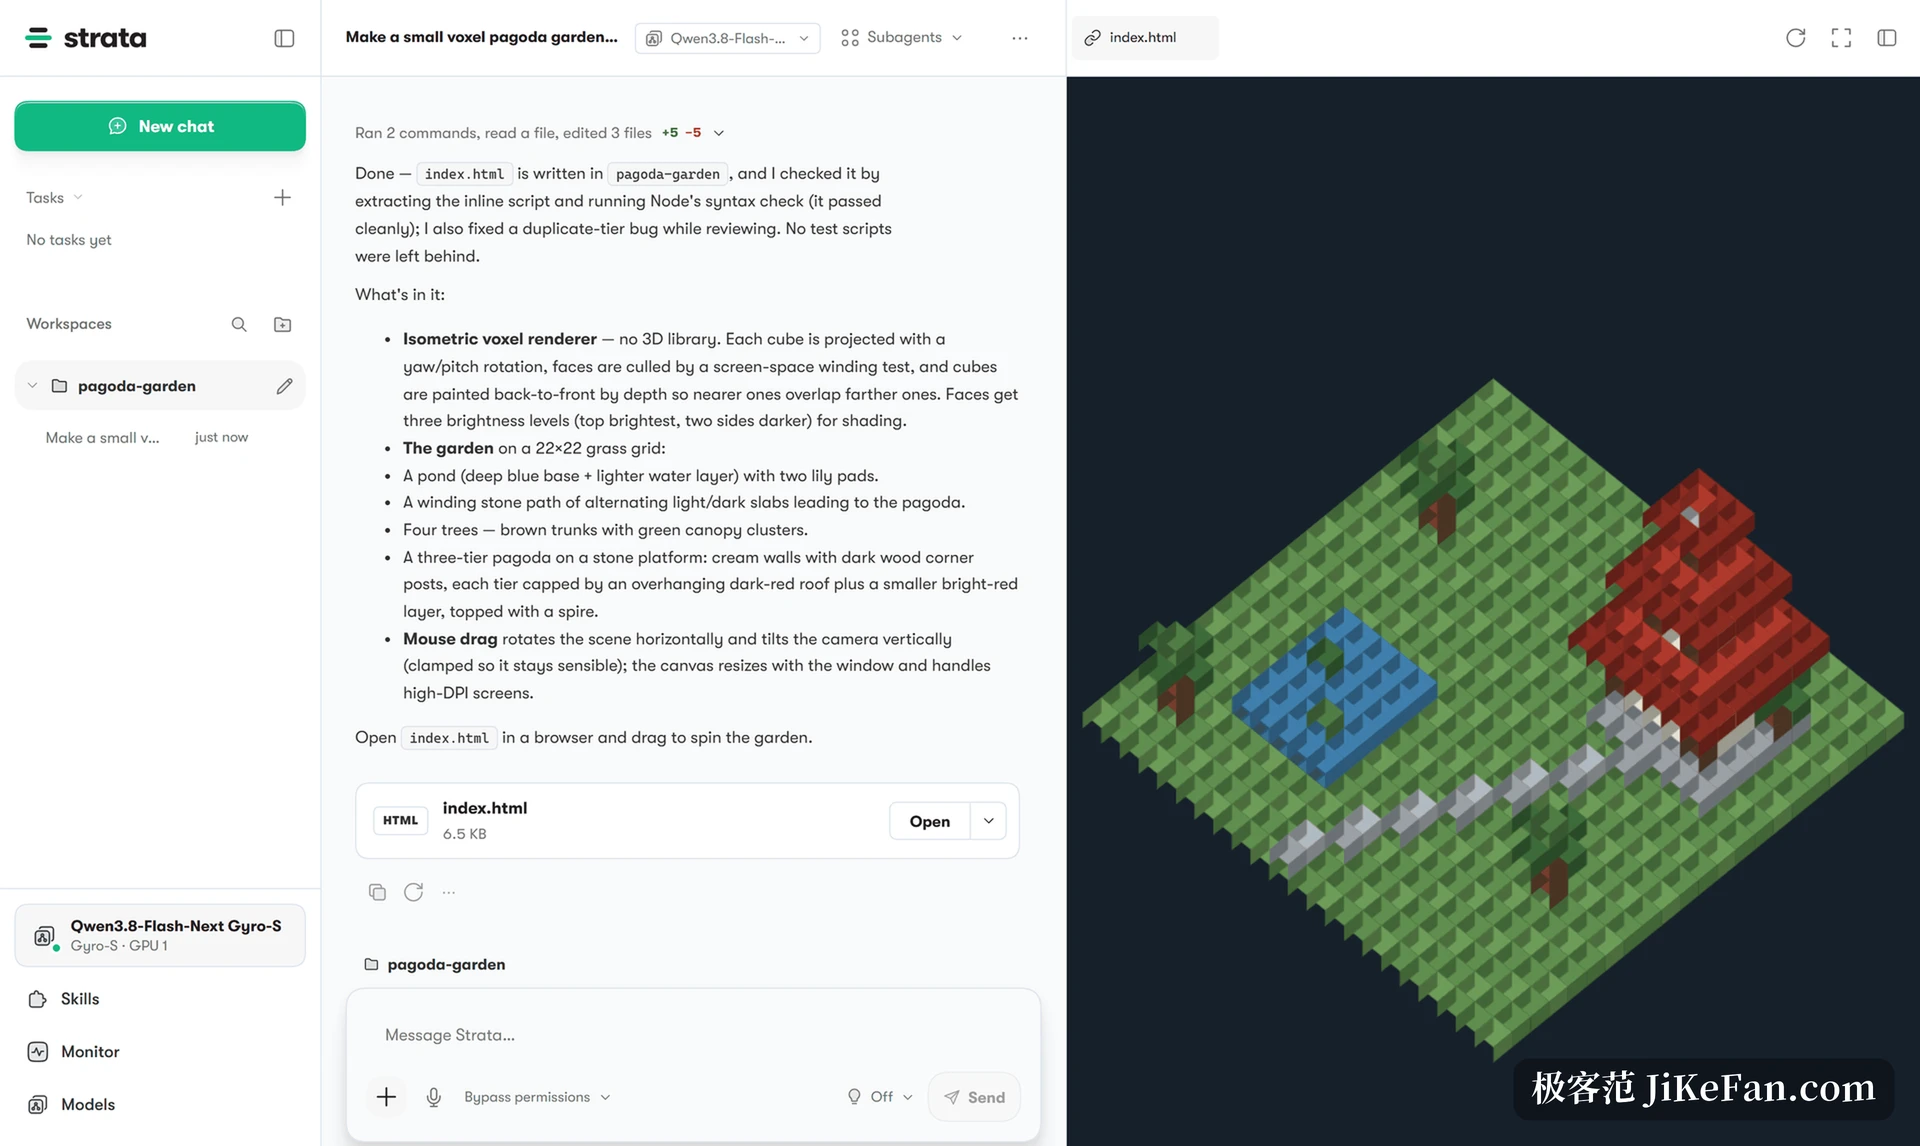
大きなモデルを自分のパソコンで動かすとき、いちばん堪えるのは二つだ。カードのメモリが足りず長いコンテキストを開けないこと。そして、作業にならないほど遅いこと。Strata 0.2.10 はこの両方に同時に手を入れた。既定の投機的デコーダを六百 MB あまりの小さな助っ人に替え、8 GB のカードでも 128K のコンテキストを開けるようにした。
この版が変えたもの
Strata は自分のパソコンで動く大規模モデルのクライアントで、C++ で書かれ、MIT ライセンス、コードは GitHub にあり、いま四万に近い星が付いている。立ち位置は狭くはっきりしている。コンシューマー向けのハードのためのもので、入口はデスクトップアプリと端末の二つ。入れてからモデルを選べば、会話もコードも画像の読み取りも始められる。アカウント登録は要らず、どのサーバーも経由しない。
版の番号には注意がいる。アプリと端末はどちらも 0.2.10、制御の部品と各エンジンのパッケージは 0.1.56 だ。公開された説明は要点を淡々と並べている。DFlash2 が既定の草稿役になる、Linux で複数カードの全カード分割エンジンが自動で有効になる、ISTA-DAS Coder という新しいモデルが加わる、Mac で画像を読める、8 GB のカードから 128K のコンテキストが使える。
六百 MB で五 GB の投機層を置き換える
投機的デコードの考え方は、小さな補助モデルに次に来る内容を先に推測させ、それを主モデルがまとめて検算するというものだ。当たるほど、一文字ずつ生成する時間が節約できる。前の版が使っていた投機層は MTP と呼ばれ、グラフィックメモリをおよそ 5.2 GB 占めていた。この版は DFlash2 に替え、占有は 625 MB ほどになる。差し引きで四 GB あまりが空く。
空いたメモリはそのまま使えるコンテキストになる。公開された比較は同じエンジンと同じファイルで、Ryzen AI Max の Windows 機では短い回答が 12 パーセント、長い回答が 8.8 向上し、RTX PRO 5000 の貪欲デコードでは 7.9、Apple M5 Max では 7.4、DGX Spark では 5.8 だった。反例もあり、Intel Arc A750 では MTP より 2.6 遅い。公式がそのまま書いている。
代償は同時実行だ。DFlash2 は一度に一つの要求しか扱わないので、複数を同時に走らせるには MTP に戻すことになり、モデルの系列が Qwen3.8 でない場合も同じだ。この自動選択はプログラムに入っている。自動を選べばハードと状況で決め、選び間違えても手で指定でき、実行ごとに読み込む草稿役は一つだけで、二つを同時に載せることはない。
8 GB のメモリに 128K をどう収めるか
長いコンテキストが食べるのはキャッシュだ。以前は 8 GB のカードで 64K 以上を開こうとすると、専門家のキャッシュが埋まった時点で起動に失敗し、利用者は四十八 K ほどまで戻すしかなかった。この版は資源の置き方を変えた。メモリが厳しくなると、グラフィックメモリとシステムメモリの間でデータを動的に移し、利用者が設定したコンテキスト長をできるだけ保ち、必要ならキャッシュの一部をシステムメモリや SSD に逃がす。
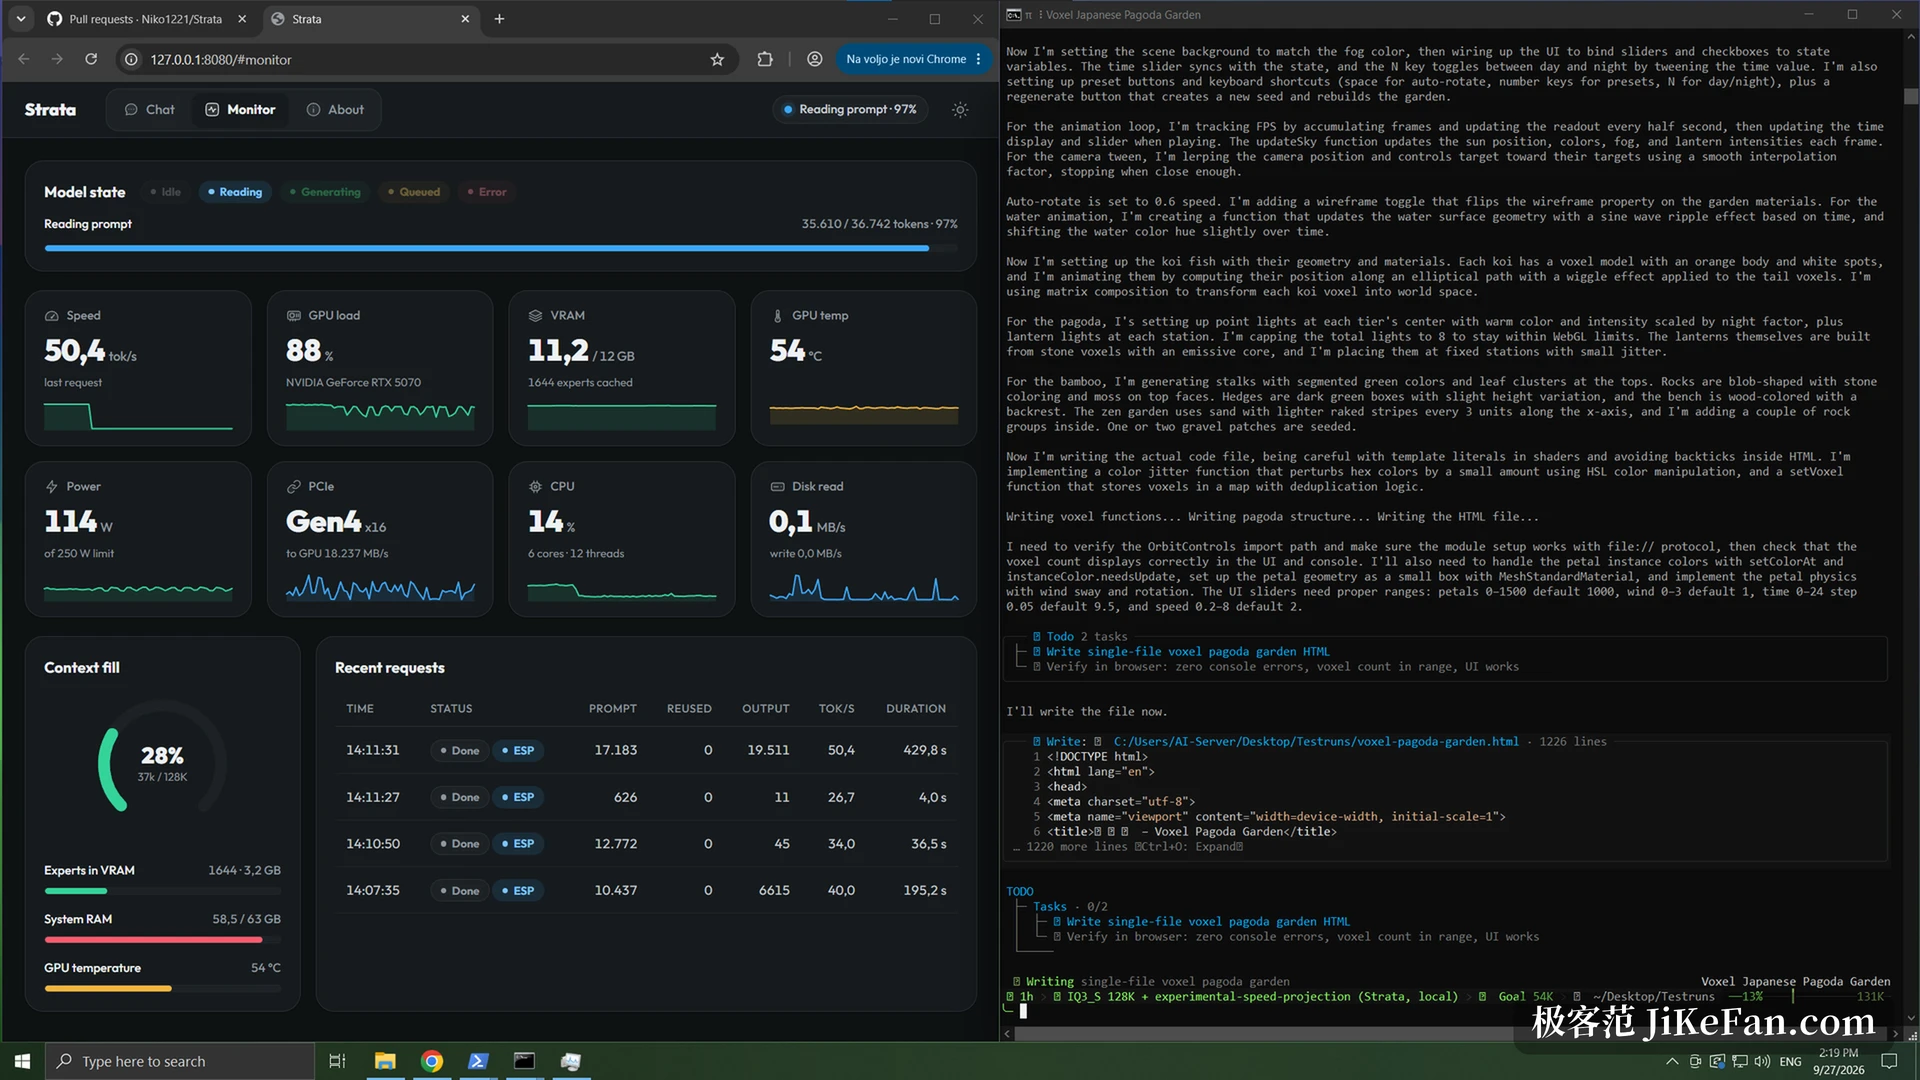
実測はこうだ。試験機を 8 GB のカードの条件に縛り、Qwen3.8 の IQ3_S 量子化で 128K を開くと、DFlash2 モードで毎秒 63 から 73 トークンを生成し、32K のプロンプトを読むのに 19.8 秒かかり、その時点でグラフィックメモリは 390 MB 残っていた。実在する Intel Arc A750 の 8 GB では、128K の四つの起動の組み合わせがすべて成功し、毎秒 12.7 から 14.8 トークンだった。12 GB のカードは影響を受けず、速度はそのまま保たれる。
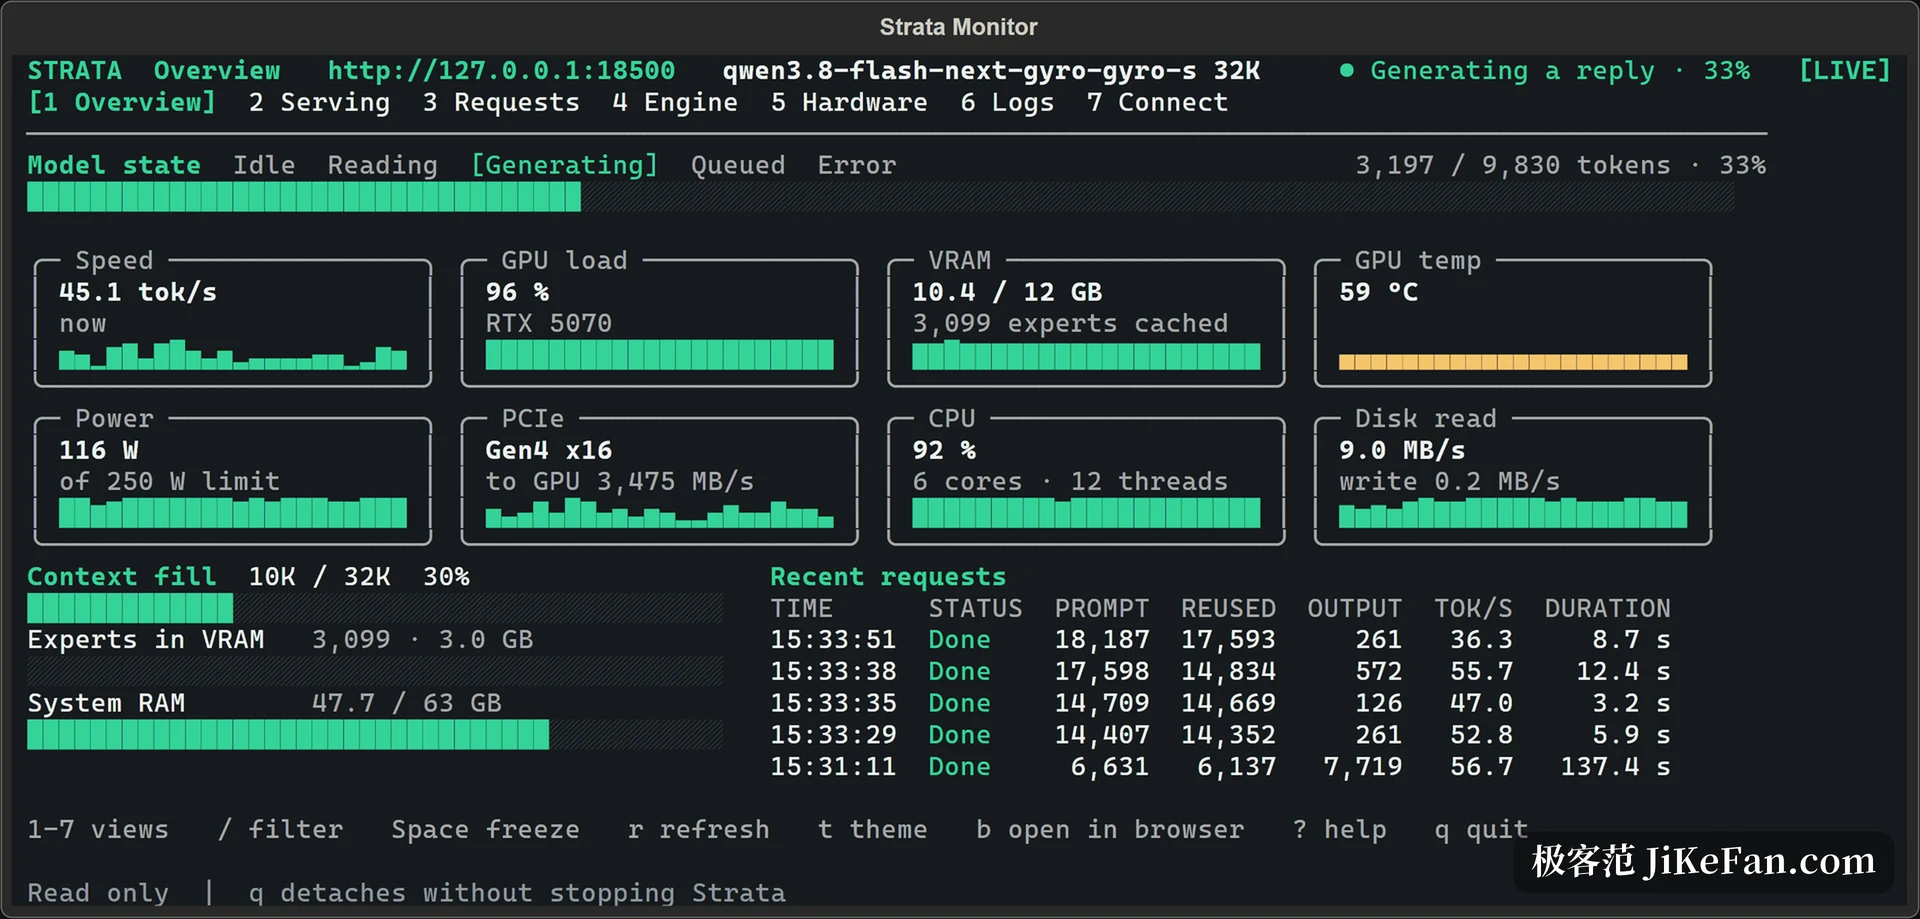
この道にも敷居はある。負荷がシステムメモリとディスクに分散されるぶん、本体のメモリへの要求が上がる。コミュニティの目安は 32 GB で始め、48 GB でちょうどよく、64 GB で余裕が生まれるというものだ。ディスクにも場所がいる。モデルのファイル自体が小さいわけではない。
二枚差しで、コード編集がほぼ二倍
複数カードの従来のやり方は層の分割だ。各カードが層の一部を持ち、計算した結果を次のカードへ渡す。この版は Linux の端末で別の分割を既定で有効にする。全カード分割と呼ばれ、どのカードも各層の一部を持ち、すべてのカードが同時に重みを読み同時に計算する。利点はメモリがより均等に分かれることで、代償はカード同士が中間結果を頻繁に交換するため、接続の帯域が効いてくることだ。
公式は RTX A6000 の二枚を Linux で測っている。コード編集は毎秒 195 トークンから 377 から 394 へ、新しいコードを書くのは 139 から 144 が 189 から 232 へ、普通の文章は 93 から 139 から 146 へ、エージェントのループは 112 から 119 が 165 へ上がった。長いプロンプトを読むのは逆に少し遅くなり、32K のプロンプトが 7.65 秒から 10.1 秒になる。最初の一語までの遅れと引き換えにした処理量だ。
自動で有効になる条件は厳しい。Linux であること、計算能力 8.6 か 12.0 の NVIDIA のカード二枚、または特定の量子化ファイルを組み合わせた Radeon AI PRO R9700 四枚であること。モデルはエンジンが扱える Qwen3.8 で、すべてのルーティング専門家がグラフィックメモリに収まり、さらに 43 GB ほどの空きメモリが残っている必要がある。条件を満たさなければ素直に層の分割へ戻り、理由が示され、手で切ることもできる。
ついでに直した二点
一つは Windows での起動だ。一部のバックグラウンド起動の状況では、ディスク読み取りの優先度がとても低く抑えられ、モデルの読み込みが目に見えて遅くなっていた。この版は優先度を戻した。もう一つは Mac での画像入力で、M5 Max では八回の画像要求が八回とも正しく読め、画像つきの生成は毎秒 19 から 22 トークン、純粋な文章では 21 から 22、画像の塔が追加で 319 MB のグラフィックメモリを占め、エンジンのメモリのピークは 74 GB のままで、文章だけの場合と並んだ。
新しく加わった ISTA-DAS Coder は、DeepSeek-V4.1-Flash の 384 の専門家から層ごとに 192 を取る構成だ。R9700 四枚では毎秒 59.2 トークンでデコードし、一枚では 22.8、Apple M5 Max では 19.1 から 22.5 だった。いずれも公式の説明にある数字で、取った機械が違うため横並びの比較に意味は薄い。桁を見るだけでいい。
誰が更新すべきか
8 GB から 12 GB のコンシューマー向けカードを持ち、長いコンテキストを使いたい人なら、替える価値がある。まったく起動しなかった状況が動くようになるからだ。二枚差しでちょうど Linux 上で Qwen3.8 を回している人には、全カード分割の利得はかなり直接的に効く。大きなカードを一枚だけ持ち、普段は会話しかしない人にとって、更新後に感じる違いは、初回起動で 1.2 GB ほどの草稿役のファイルを余分に取得することくらいだ。
念のため書いておくと、こうしたプロジェクトは反復が速く、版の番号が一日で変わるのも珍しくない。公式の文書はハード、量子化の段階、同時実行の設定についてかなり細かく書いてある。動かす前に自分の構成と照らして読むほうがよく、他人のパラメータをそのまま写さないほうがいい。