
-
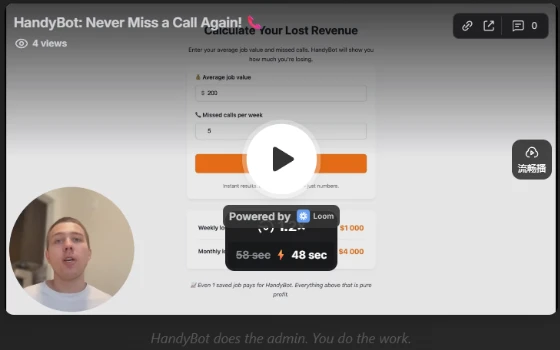
HandyBot が職人の電話を取り、話しながら予定を暦へ書き込む
米国の出張サービス業者に向けた AI の電話受付サービス。かかってきた電話を AI が一日中受け、何をするかを確かめたうえで予約を店主の暦へ入れ、顧客への追いかけと通話の記録まで代わる。月 199 ドル、七日間の試用はカードの登録が不要。
-
Chatterfly:Fn を押して話すだけで、そのまま読める文章になる
二〇二六年九月に試験提供が始まった音声入力の道具。Fn を押して普段どおりに話し、離すと話し言葉の重複を除いた読みやすい文章になる。会議の記録や広告の文案など、用途に合わせた整文もできる。
-
ブラウザで録音を整える Adobe の音声強化、無料枠と制限の中身
録音を放り込むと背景の雑音を消し、音量をそろえ、明瞭さを上げる Adobe のウェブ道具。導入も設定も要らず、無料の範囲は一日一時間の音声まで。
-
十分の音声で別の声を作る、RVC のその場の声変換と遅れの数字
声質の変換とその場の声チェンジを行うオープンソースの枠組み。学習には少なくとも十分の静かな音声が要り、端から端までの遅れは 170 ミリ秒に届く。画面も二種類そろっている。
-
一行の命令で四本の音の筋に分ける、Demucs という分離モデル
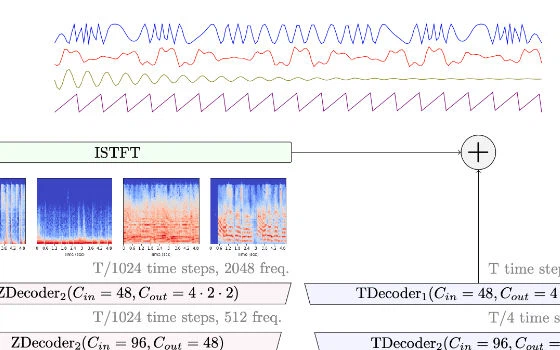
混ぜられた曲をドラム、ベース、声、残りの伴奏に分けるオープンソースの分離モデル。コマンドライン一行で走り、Python からも呼べる。コードは MIT ライセンス。
-
一曲を声と伴奏に分ける、Ultimate Vocal Remover は入れてすぐ使える
音源分離のモデルで曲を声と伴奏に分けるオープンソースの道具。公式のインストーラは画面、Python、PyTorch と依存をまとめて同梱していて、事前の準備が要らない。
-
語ごとの時刻と話者まで付ける、WhisperX が足した二つの工程
Whisper の二つの穴を埋める流れだ。時刻は文の単位で止まり、まとめて処理する手段もない。WhisperX は強制アラインメントで語の時刻まで詰め、話者も見分け、large-v2 で実時間の 70 倍とうたう。
-
書き起こしを自分のマシンに留める、Buzz というデスクトップ道具の中身
自分のパソコンの中で書き起こしと翻訳を済ませるデスクトップの道具で、土台は Whisper。音声や動画のファイルとリンクを扱い、マイクからはその場で書き起こし、話者も見分け、テキストと SRT、VTT に書き出せる。
-
Whisper は六つの大きさで配られ、選ぶ決め手はビデオメモリになる
文字起こしと英語への翻訳、言語の判定を一つの流れでこなす汎用の音声認識モデル。大きさは約 3900 万から約 15.5 億パラメータまで六種類。コードも重みも MIT ライセンスで配布される。
-
IndexTTS を自分のマシンで動かす、感情も話速もパラメータで振れる
手元のマシンに導入して動かすゼロショット音声合成。参照音声は一本でよく、感情も話速も発音もパラメータで調整できる。重みの扱いは汎用のオープンソース許諾ではなく、プロジェクト独自のライセンスで決まる。
-
F5-TTS は MIT のコードと非商用の重みを並べて配る、導入は pip 一行
フローマッチングで音声を合成するオープンソースのプロジェクト。pip パッケージ、コマンドライン推論、Gradio の画面を用意する。コードは MIT だが、学習済みの重みは学習データの都合で非商用に限られる。
-
CosyVoice は 9 言語と中国語 18 方言をカバーし、ゼロショット複製もこなす
オープンソースの音声合成モデル。最新世代は言語をまたぐゼロショット複製に対応し、9 つの外国語と十を超える中国語の方言と訛りを覆い、Apache 2.0 ライセンスで公開されている。
-
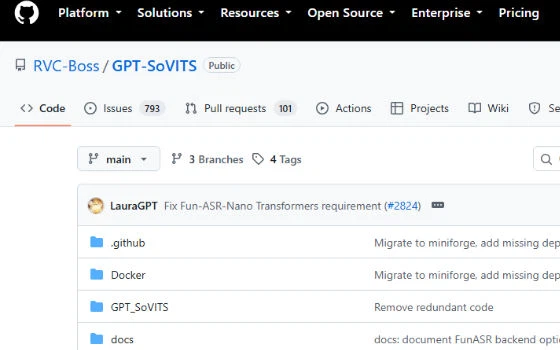
GPT-SoVITS は一分の音声で声を調整し、五秒でゼロショット合成する
オープンソースの音声合成 WebUI。五秒の人声があればゼロショットで合成でき、一分の音声データがあればより近い声質に調整できる。推論は中国語、英語、日本語、韓国語、広東語の五つをまたげる。
-
Fish Audio は十秒の音声で声を作り、無料枠は毎月 8000 クレジット
登録にカードは要らず、無料枠は毎月 8000 クレジット。十秒の音声を上げれば使える声が手に入り、合成時には 60 種類を超える感情タグで語り口を調整できる。
-
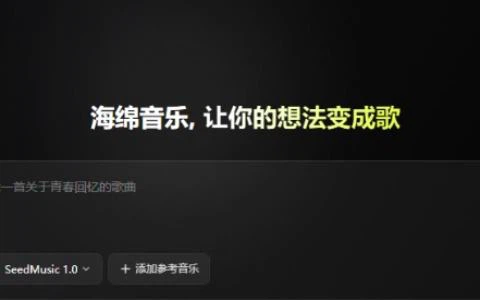
一文で歌になる Haimian Music、曲調も気分も声質も選べる
ブラウザだけで動く音楽制作ツール。中央の入力欄に欲しい雰囲気を書けば、編曲も歌唱もモデルが引き受けて歌入りの曲を返す。歌詞がある人は貼り付けてジャンル・気分・声質を選ぶだけ。歌詞が書けない人向けの入口も別に用意されている。
-
第 1 / 2 页