
Ornith は 9B から 397B まで、訓練の課題をモデル自身に作らせる
要約
DeepReinforce の Ornith は、課題を出すこと、足場を組むこと、解き方を書くことをモデル自身に任せ、規模は 9B から 397B までの三つ。MIT の許可で出され、256K の前後関係と手元での運用に対応する。
おすすめ- ソフト名
- Ornith
- バージョン
- 1.5
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsmacOSLinux
- 公式サイト
- https://ornith.ai
- 更新日時
- 2026-10-10 14:39
Ornith は「何を訓練するか」と「どう訓練するか」をまとめてモデル自身に任せる公開のプログラミングのモデルの一族で、名はギリシア語の「鳥」から取られている。
Ornith は人工知能の研究をする場である DeepReinforce から出され、代理によるプログラミングの課題に向く。決まった訓練の流れの中でモデルをより正確に調えるところで止まらず、訓練そのものの組み立てをモデルへ返す。課題はモデルが提案し、解くための足場はモデルが組み、最後の解き方の筋もモデルが生む。提供側はこの道を自らを高める道と呼び、一族全体の本筋に置いている。
いままでに二つの世代がある。2026 年 6 月に出た Ornith-1.0 は「自前の足場」という枠組みを示し、2026 年 8 月に出た Ornith-1.5 はその枠組みを「足場と解き方の共同の最適化」から完全な自己改善の巡りへ広げた。
自前の足場から自己改善の巡りへ
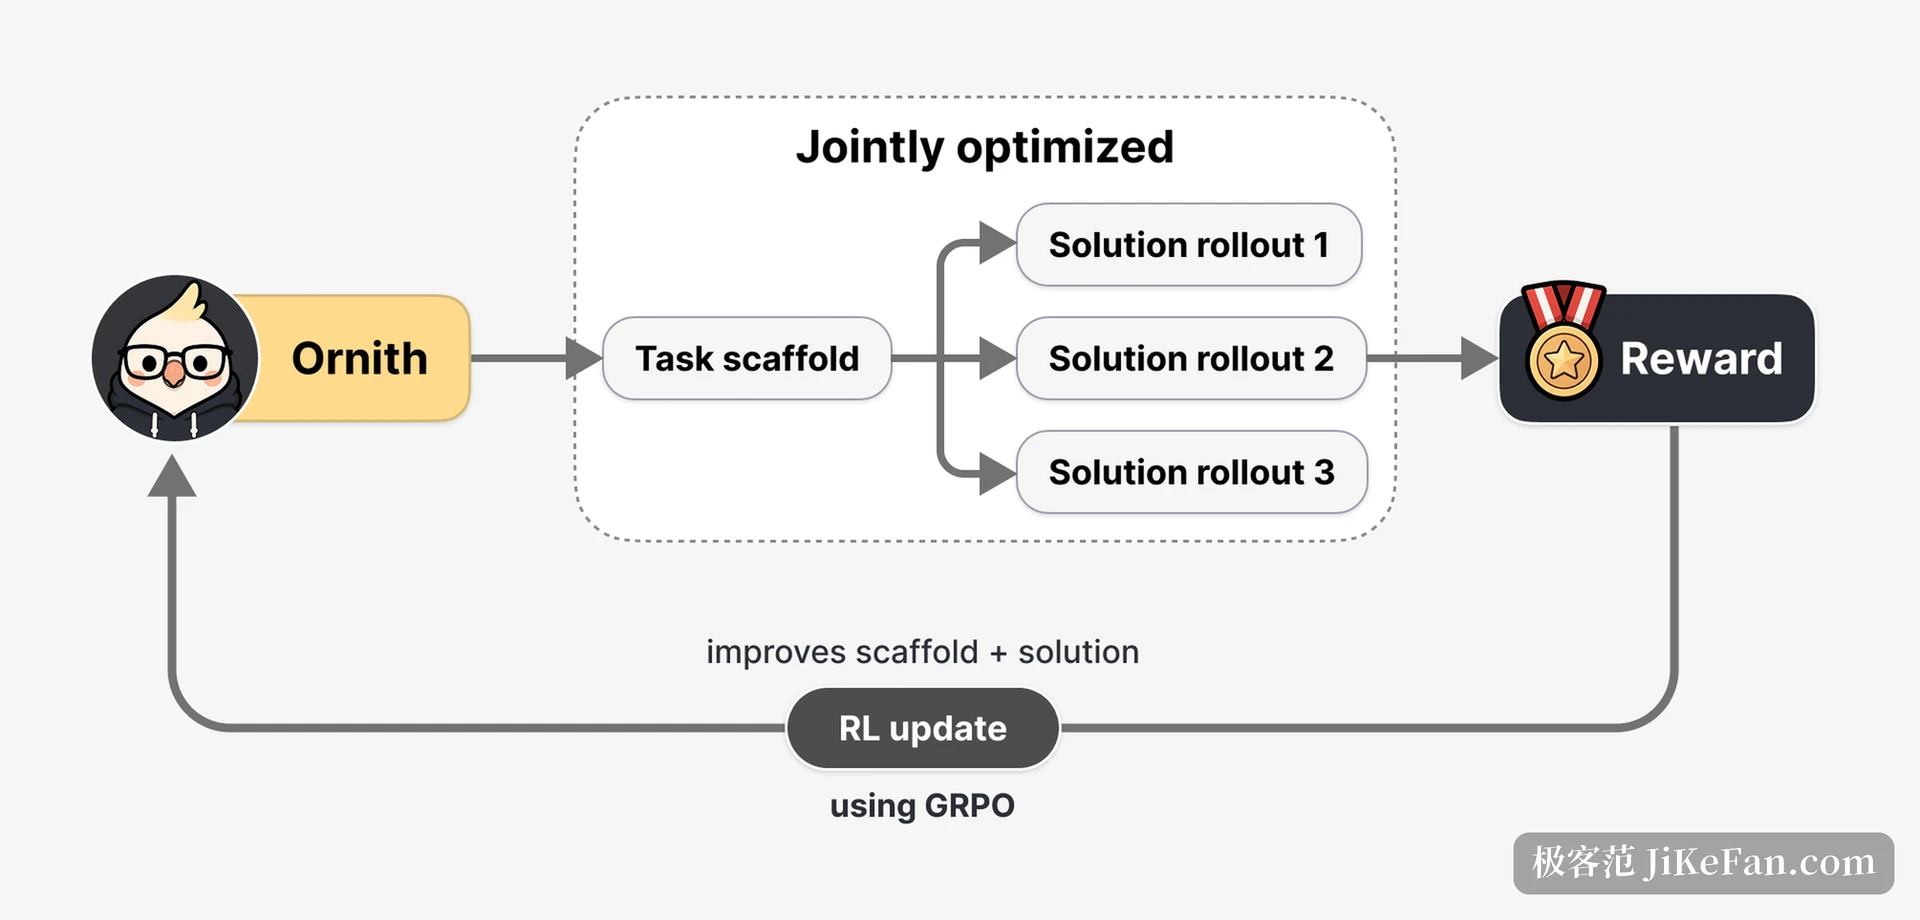
Ornith-1.0 の中核は、足場を学べる対象として扱うことだ。普通の強化学習では、道具を呼ぶ順、誤りのあとのやり直しの筋、記憶の組み方といったものが人が書いた固定の骨組みで決まり、モデルはその中で解き方を出すだけである。Ornith-1.0 では、モデルが訓練の各巡でまず課題の記述からより細かな足場の一案を出し、その足場の下で解き方の筋を生む。解き方が報酬を得ると、その報酬は「足場を書く」段と「解き方を書く」段の両方へ返る。何度も繰り返すうちに、課題の種類ごとの段取りが自ずと現れ、人が種類ごとに指定する必要はなくなる。
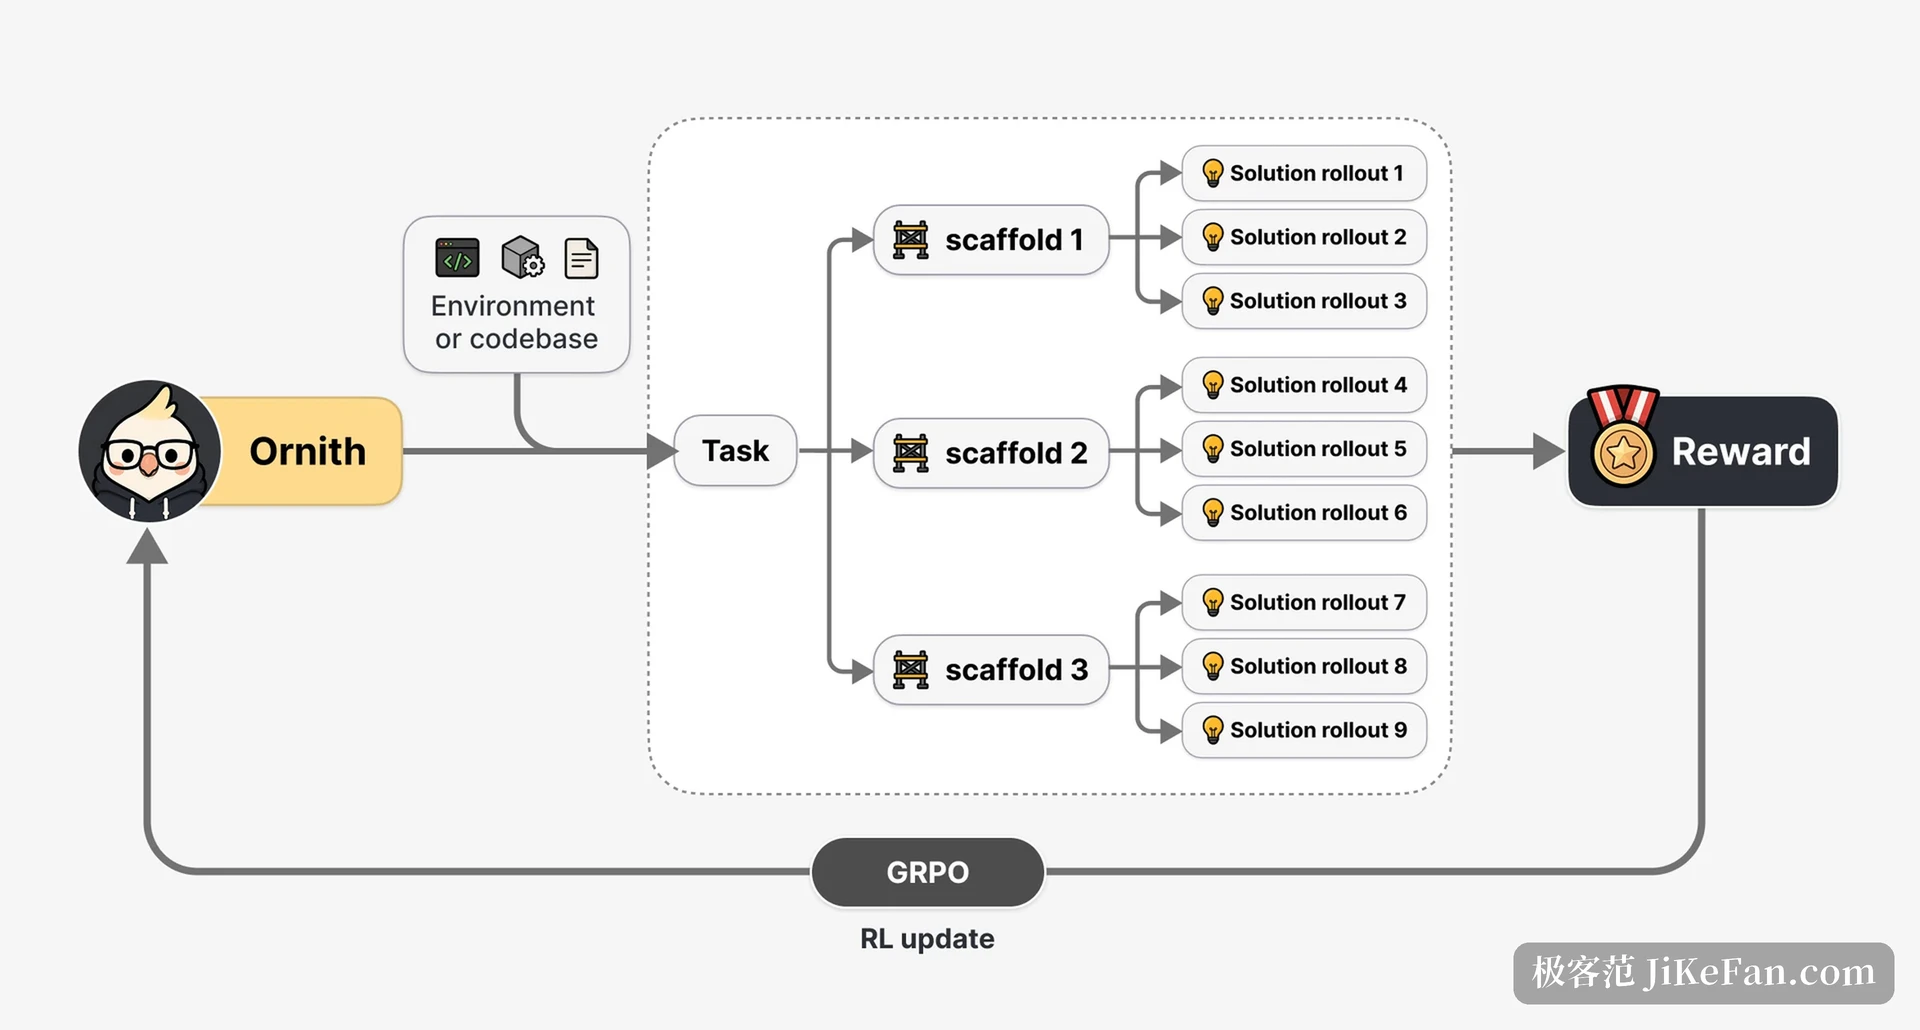
Ornith-1.5 はこの考えをさらに推し進める。訓練の巡りは二段から三段になる。モデルはまず以前より難しい新しい課題を出し、その課題のために専用の足場を組み、最後にその足場の下で解き方の筋を生む。報酬は三段を通るので、モデルが学ぶのは「どう解けばより正確か」だけでなく、「どうより値打ちのある課題を出すか」「どうより効く足場を組むか」も含まれる。
課題の出し方、三つの報酬を掛ける
モデルに課題を出させると、いちばん分かりやすい危うさは、柔らかい相手ばかり選ぶこと、あるいは似たような課題を繰り返し生むことだ。Ornith-1.5 は三つの信号を掛け合わせて向きを縛る。有効さ、前沿の難しさ、目新しさである。有効さは、課題と足場がはっきり定まり確かめられる学びの場になっているかを見る。足場が動かない、あるいは評価のものさしが課題の仕様と合わないときは、この項がそのまま零になり、課題全体の報酬も消える。
前沿の難しさは、モデルがその課題で実際に成功する割合から見積もる。割合が 0.2 に近いほど難しさの報酬は高く、モデルがその種類をますます確かに解くようになると、その課題の報酬は自然に下がり、課題を出す向きはより難しい側へ押される。目新しさは繰り返しを押さえるために、いまの課題と過去の課題のバッファとの間の最大の似かよりを逆に数える。三つを掛けるということは、確かめられ、手応えがあり、繰り返しでない課題だけが報酬を得るということだ。
三つの規模と公式の評価
Ornith-1.5 は三つの規模を用意し、データの中心から端末までの全体を覆う。397B の専門家の混成の版は旗艦の場に向き、35B-A3B の版は一つの記号あたり約 3B の値だけを働かせ、9B の密な版は一枚のカードと縁の装置に向く。前の世代の Ornith-1.0 はこの三つに加えて 31B の密なモデルも出していた。一族の確認点は同じ OpenAI と両立する口を共有する。
規模
Terminal-Bench 2.1
SWE-bench Verified
装置の位置づけ
397B MoE
86.1
86.0
複数のカードの節点
35B-A3B MoE
68.5
79.0
中規模の班
9B Dense
47.0
70.6
一枚と端末
このうち 9B の版からは、数を縮めた Mobile の版も生まれ、提供側は iPhone と Android の装置の上で直接動くと述べる。三つのモデルはいずれも 256K、つまり 262,144 記号の前後関係の窓に対応し、YaRN の倍率 4.0 を使えばおよそ百万記号まで広げられる。
どう動かすか、手元での推論と公開の許可
Ornith の一族は推し量るモデルなので、既定では助手の返事はまず think の推し量りの塊を出し、そのあと最終の答えを出す。公式の作り方はこの考えの連なりを別の欄に分けて返し、道具の呼びの解き読みも開くので、各種の代理を組む枠組みへつなぎやすい。
動かし方について、Ornith には預ける口も価格の表もなく、すべての力はモデルの重みとして出され、自分で置く必要がある。提供側は vLLM や SGLang といった推論の積み重ねの作り方を示し、長い前後関係に向けた専用の設定も用意する。数を縮めた形式は GGUF と MLX を覆い、llama.cpp と Ollama を通して手元で動かせる。
重みは MIT の許可で出され、提供側は「世界のどこからでも得られ、地域に縛られない」と説明する。研究の用途も商業の配置も、余分な許しの段を要さない。
Ornith は「何を訓練するか」と「どう訓練するか」をまとめてモデル自身に任せる。課題を出し、足場を組み、解き方を書くことが一つの閉じた巡りになり、有効さと難しさと目新しさを掛けた報酬が向きを縛る。三つの規模でデータの中心から携帯までの装置を覆い、MIT の許可と手元だけの配置で使う自由をまるごと手に入れる。