
九種語言、十八種以上方言,還加上跨語言零樣本複製:CosyVoice 的覆蓋面
摘要
開源的語音合成模型,最新一代支援跨語言的零樣本複製,涵蓋九種外語與十多種中文方言與口音,並以 Apache 2.0 授權釋出。
推薦- 軟體名稱
- CosyVoice
- 版本
- 3
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinuxmacOS
- 更新時間
- 2026-10-06 19:49
多數開源語音合成模型賣的是同一件事:像不像人。CosyVoice 走的是另一條路,把重心壓在覆蓋面上——九種語言、十八種以上中文方言與口音,再加上跨語言的零樣本聲音複製。倉庫簡介寫得很直接:一個多語言大語音生成模型,提供推論、訓練與部署的全端能力。
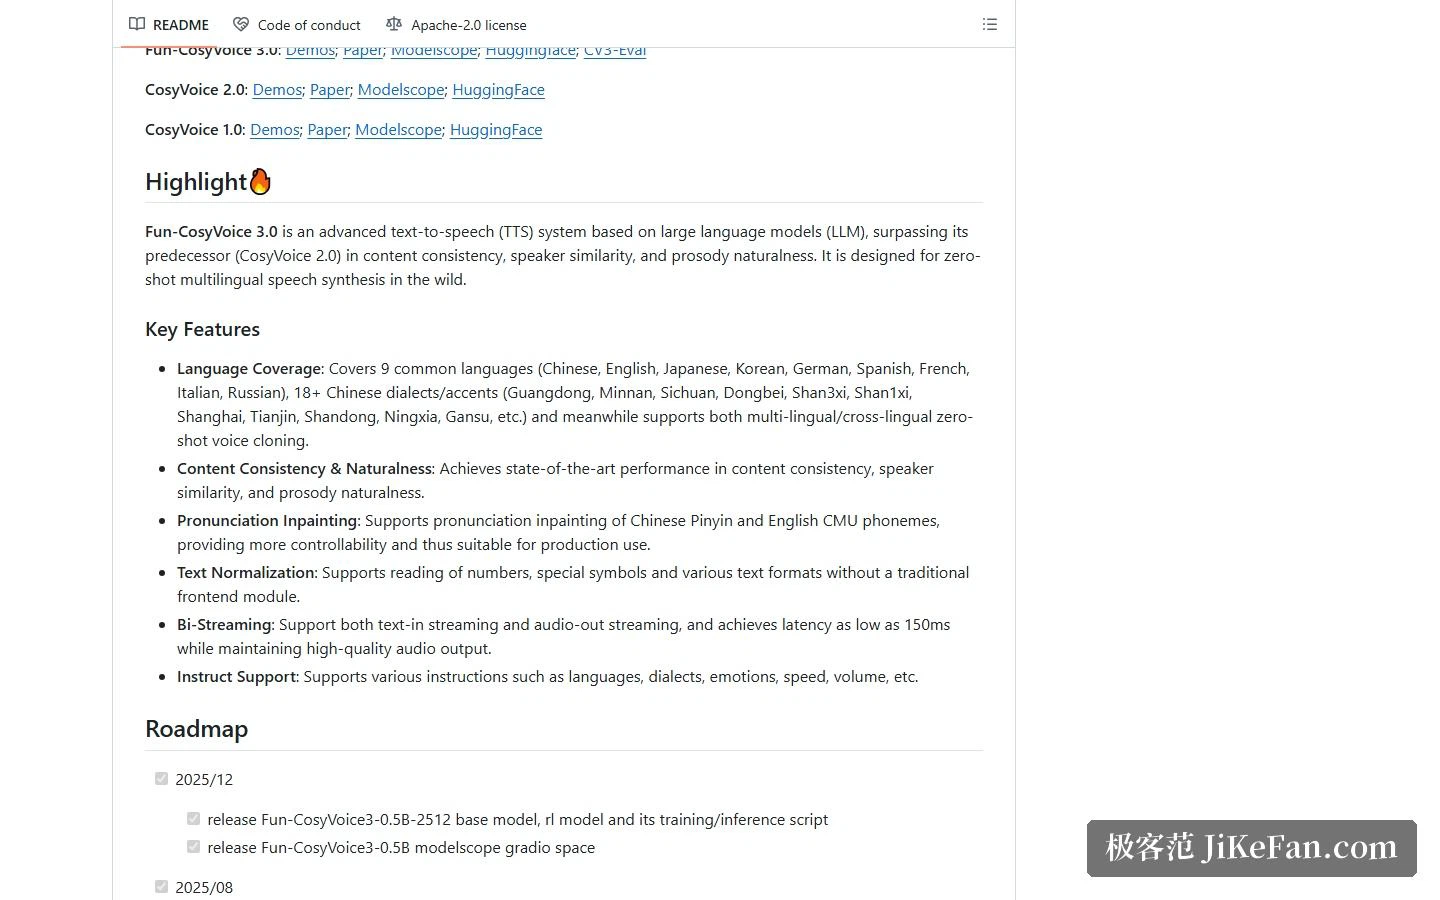
程式碼以 Apache 2.0 授權開源,目前這一代是 Fun-CosyVoice 3.0。官方說明它是架在大語言模型上的語音合成系統,在內容一致性、說話者相似度與韻律自然度三項上都比前一代 CosyVoice 2.0 更強。
先看覆蓋範圍:九種語言加十八種中文方言
官方列出的九種語言是中文、英語、日語、韓語、德語、西班牙語、法語、義大利語與俄語。對中文使用者來說,更該看的是方言那一欄:十八種以上中文方言與口音,官方舉的例子裡能看到廣東、閩南、四川、東北、陝西、山西、上海、天津、山東、寧夏與甘肅。
方言支援的難處不在「能不能唸」,而在語料稀少、發音規律和國語差得遠。把這一塊單獨列進核心特性,說明這個專案在中文語境下的投入是有意為之,而不是順手帶上的。
零樣本複製,以及用指令調語氣
聲音複製方面,官方把「多語言」與「跨語言」的零樣本複製寫在同一句說明裡——意思是用一種語言錄的樣本,可以去合成另一種語言的語音,不必為每個語種重新準備資料。
另一個實用的功能是指令控制:語言、方言、情感、語速、音量都能用指令指定。對做有聲內容的人來說,這比反覆重新生成碰運氣要可控得多。官方還單獨列出發音修正能力,支援中文拼音與英文 CMU 音素的干預,遇到多音字或外文專有名詞可以手工糾正。
串流推論:延遲最低約 150 毫秒
官方在特性裡寫明支援文字輸入串流與音訊輸出串流的雙向串流,延遲最低可達 150 毫秒,同時維持音訊品質。這個數字的意義在即時對話——若要把語音合成接進客服機器人或語音助理,延遲就是能不能用的分水嶺。
版本與模型怎麼選
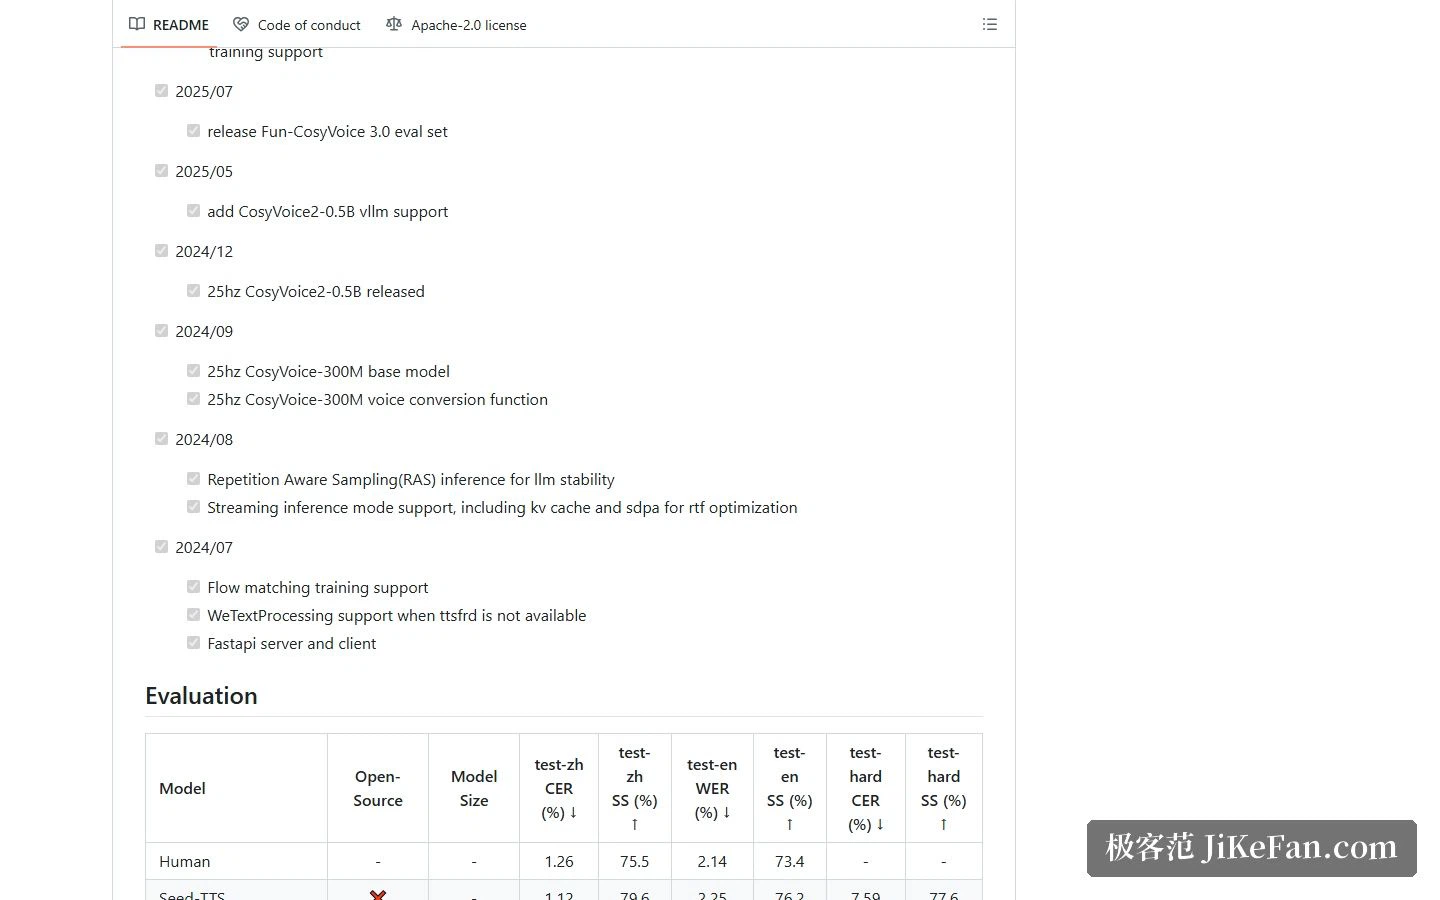
專案目前有三代:CosyVoice 1.0、CosyVoice 2.0 與 Fun-CosyVoice 3.0,官方分別給了論文與模型倉庫的入口。可下載的預訓練模型不只一個:三百兆參數規模的 CosyVoice-300M,以及它的微調版 300M-SFT 與指令版 300M-Instruct,再往上還有 CosyVoice2-0.5B 與最新的 Fun-CosyVoice3-0.5B。
官方文件裡明確推薦用 Fun-CosyVoice3-0.5B,理由是效果更好。如果你的場景偏重指令控制,選帶 Instruct 的版本;如果只是快速跑通流程,三百兆那個版本體積更小、顯示記憶體壓力也更低。
裝起來:一個 Conda 環境加模型下載
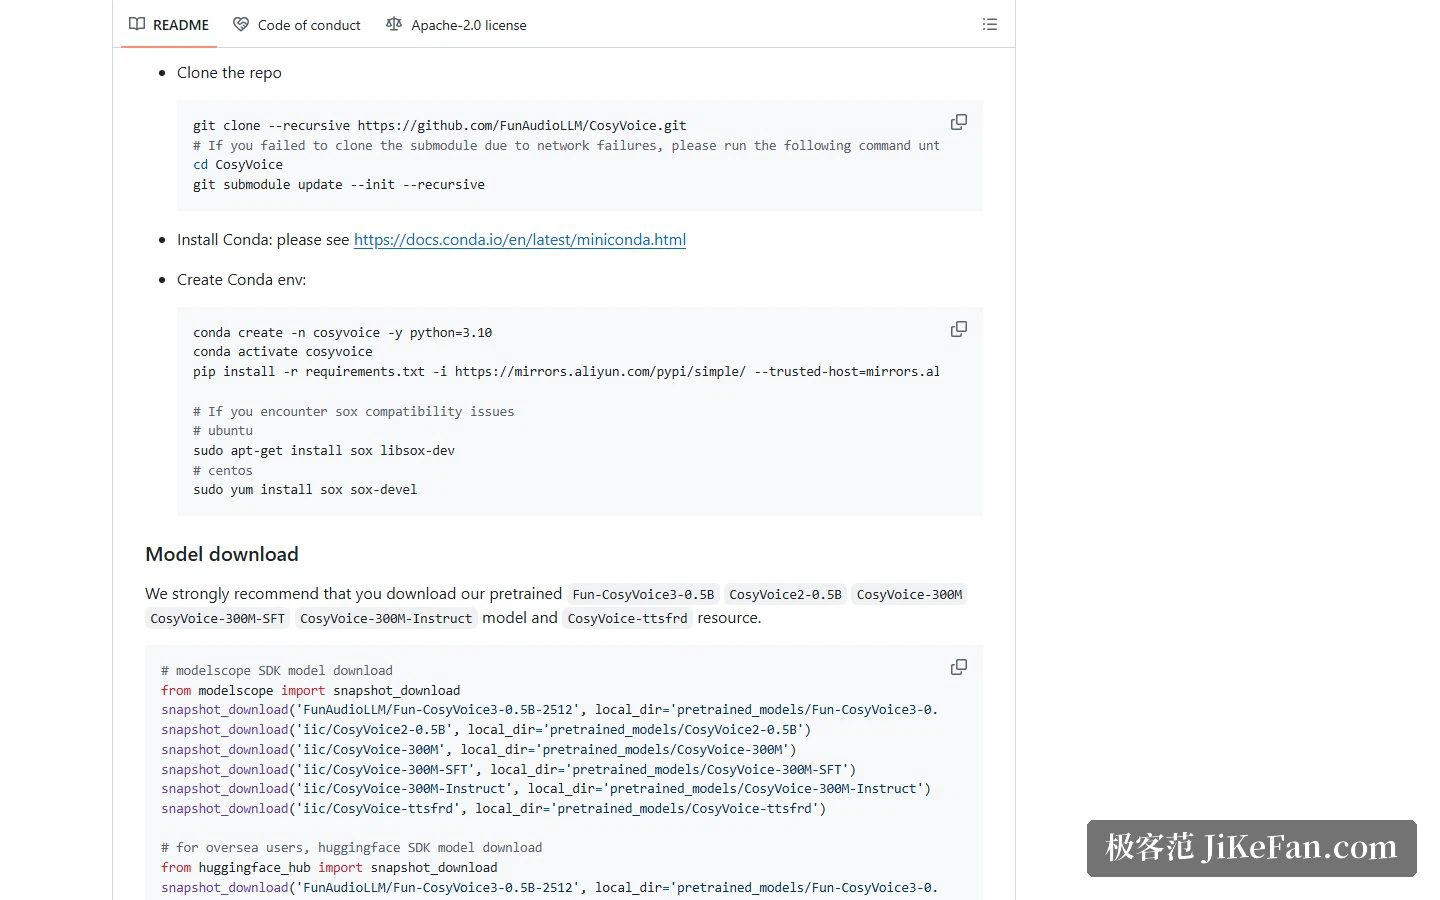
官方給的路徑是先複製倉庫並拉取子模組,接著用 Conda 建一個 Python 3.10 的環境裝依賴,最後按需下載預訓練模型。模型可以從 ModelScope 或 HuggingFace 拉取,國內使用者走前者會順一些。
有個細節值得留意:文字正規化預設走 wetext,如果你另外解壓並安裝了 ttsfrd 資源包,數字與符號的讀法會更好。官方也說明這一步不是必要的,可以跳過。
跑起來,以及需要更快推論時
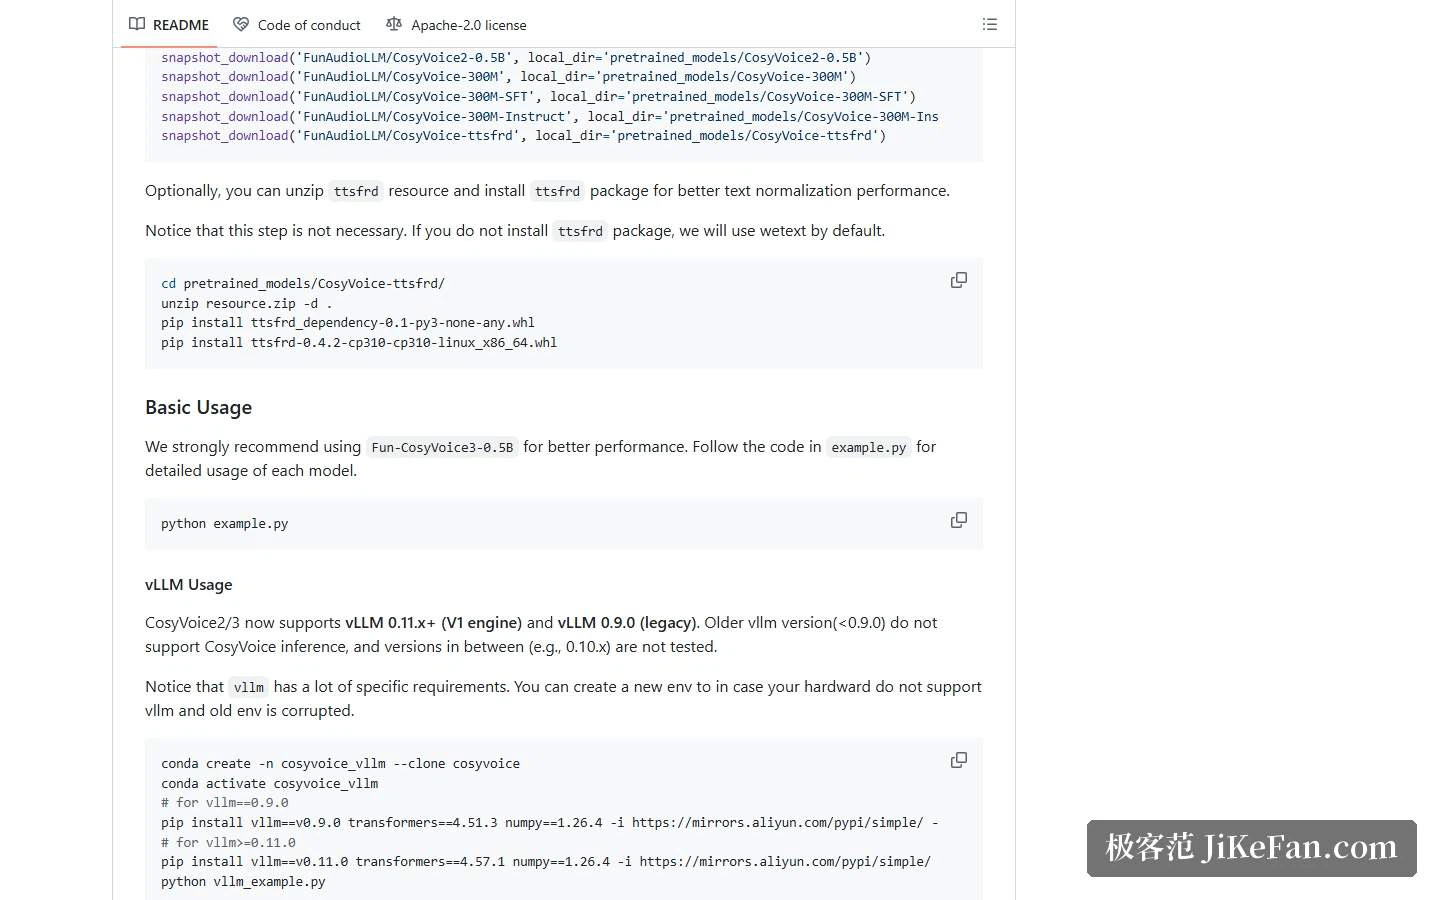
最簡單的驗證方式是跑官方範例腳本,或者起一個網頁示範,指定模型目錄與連接埠就能在瀏覽器裡試聽。如果對吞吐量或延遲有更高要求,CosyVoice 2 與 3 支援用 vLLM 加速推論,但版本有講究:官方說明支援 0.11 以上的新版引擎與 0.9.0 的舊版,低於 0.9.0 的版本無法推論,而兩者之間的版本沒有經過驗證。
適合誰
如果你的需求集中在中文,尤其是需要方言、需要可控的語氣與發音修正,CosyVoice 的能力組合比通用英文 TTS 更對得上。加上程式碼開源、可本機部署,對資料不出內網有要求的場景也比較友善。
需要提前確認的仍是兩件事。一是模型權重的授權條款——倉庫裡的程式碼是 Apache 2.0,但把生成結果用於商業用途之前,建議再核對一遍模型本身的授權說明。二是聲音複製的合法性:用別人的聲音、尤其是公眾人物的聲音製作內容,可能涉及人格權與聲音權,權利來源要落到紙面上。
開源語音模型這兩年進步很快,覆蓋的語言與方言越來越全。技術層面的選擇變多了,剩下的問題反而回到人身上:你想讓機器用誰的聲音、說什麼話。