
十分鐘語音就能訓練出另一個音色:RVC 的即時變聲與延遲數字
摘要
開源的音色轉換與即時變聲框架。官方建議至少準備十分鐘低底噪語音來訓練,端到端延遲可做到 170 毫秒,並同時提供網頁介面與獨立的即時變聲介面。
推薦- 軟體名稱
- RVC
- 版本
- 2.3.260718
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinux
- 更新時間
- 2026-10-06 23:15
它和語音合成有什麼不同
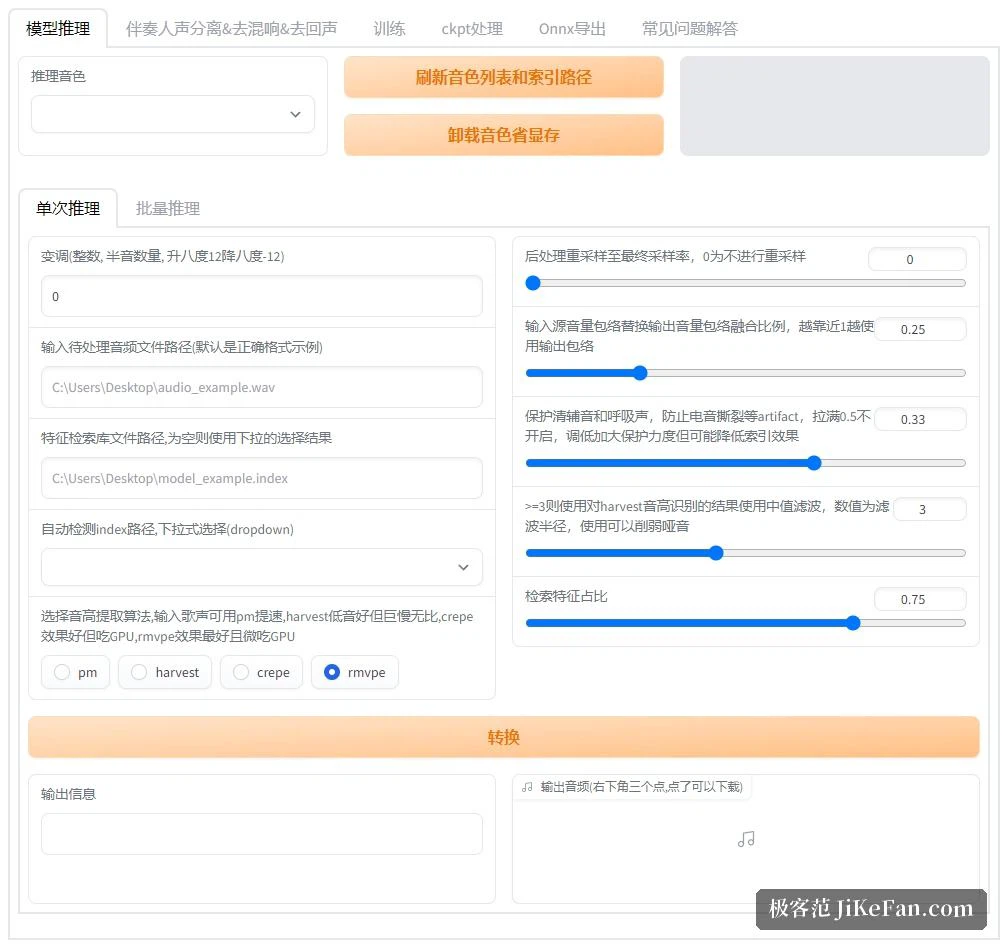
RVC 全名 Retrieval-based-Voice-Conversion-WebUI,官方定位是「簡單易用的語音音色轉換/變聲器框架」。它做的事和語音合成不同:不是從文字生成語音,而是把一段已經錄好的聲音,換成另一個音色。
這類工具過去的門檻不低,RVC 把門檻壓到兩個數字上:訓練至少需要 10 分鐘語音資料,即時變聲的端到端延遲是 170 毫秒。
輸入的是語音本身,不是稿子。你給它一段錄音,它輸出內容相同、音色換成目標模型的版本——改變的是「誰在說」,而不是「說了什麼」。
官方在簡介裡列的第一條特性是:使用 top1 檢索把輸入源特徵替換為訓練集特徵,用來杜絕音色洩漏。檢索到的特徵來自訓練集本身,輸出因此更貼近目標音色,而不是把輸入源的口音與音質一併帶過去。
10 分鐘資料就能訓練
官方建議至少收集 10 分鐘低底噪語音資料,用少量資料訓練也能得到較好結果。這個量級意味著不需要專業錄音室,一段安靜的室內錄音基本夠用。
硬體要求同樣不高,官方明確寫了「即便在相對較差的顯卡上也能快速訓練」。底模由接近 50 小時的開源高品質 VCTK 訓練集訓練而成,官方稱無版權方面的顧慮;此外還能在 ckpt 處理頁籤裡用 ckpt-merge 做模型融合來改變音色。
裝起來:相依按顯卡分三檔
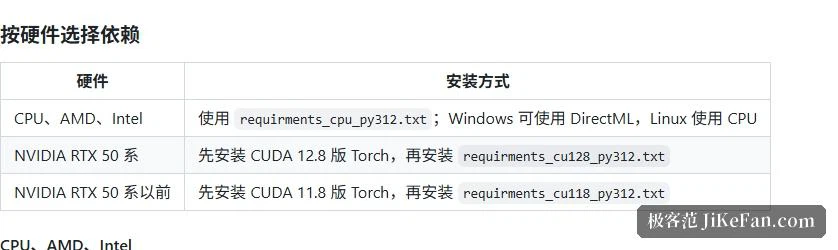
這個分支面向 64 位 Python 3.12,Ubuntu 側推薦 24.04。相依按硬體分三檔:純 CPU 與 AMD、Intel 顯卡用一份相依檔;NVIDIA 顯卡再按新舊分開——RTX 50 系先裝 CUDA 12.8 版 Torch,RTX 50 系以前先裝 CUDA 11.8 版 Torch,之後再裝各自對應的相依檔,注意是先裝 Torch 再裝相依檔。裝完可用一條指令印出 Torch 與 CUDA 版本,先確認環境再往下走。
AMD 與 Intel 顯卡走的是 CPU 相依方案:Windows 上可用 DirectML,Linux 上直接用 CPU。非 NVIDIA 平台不是不能跑,但要接受算力上的落差。
模型要放對位置
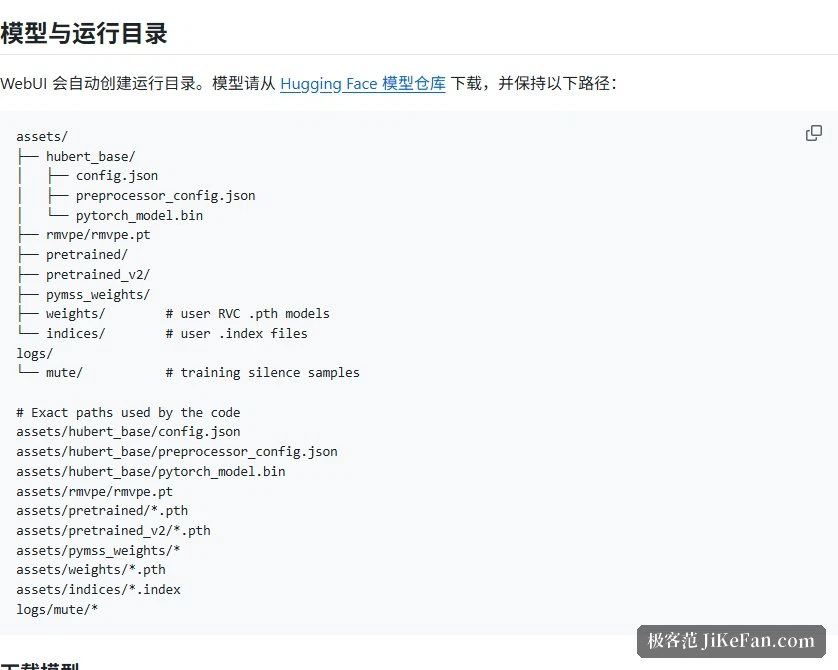
WebUI 會自動建立執行目錄,但模型要自己下載並放到指定位置。官方要求保持固定結構:特徵提取用的 hubert_base、音高提取用的 rmvpe 權重、訓練用的 pretrained 與 pretrained_v2、人聲分離用的 pymss_weights,以及存放使用者模型的 weights 與存放索引的 indices。
下載同樣走命令列工具,按用途分幾組:推論與特徵提取必需一組,v1/v2 訓練必需另一組,人聲分離可選一組;僅 Windows 上的 DirectML 環境還需額外一份 onnx 格式的音高權重。另外 Windows 要自己把 FFmpeg 的兩個可執行檔放進專案根目錄。
即時變聲與延遲
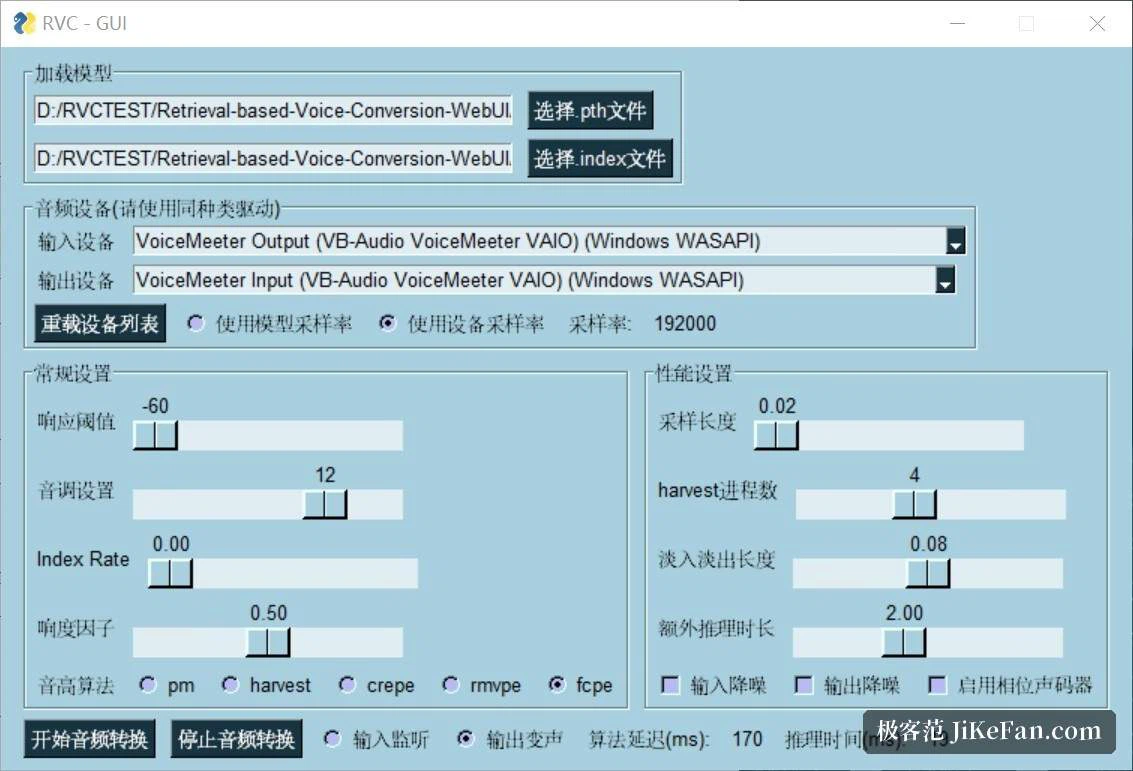
官方給了網頁介面與獨立的即時變聲介面兩個入口。延遲是這裡最值得看的一項——官方稱已實現端到端170 毫秒,若使用 ASIO 輸出入裝置可以做到端到端 90 毫秒,但官方也坦言這非常依賴硬體驅動的支援。
能壓到這個量級,音高提取演算法是關鍵一環。官方採用的是 InterSpeech2023 的 RMVPE 演算法,評價是「根絕啞音問題,速度快、資源佔用小」;介面裡也可切回 pm、harvest 或 crepe。
啟動方式與許可
啟動指令就一條,預設監聽 7865 埠,沒有桌面環境的 Ubuntu 伺服器可以加參數跳過自動開啟瀏覽器;使用者模型放 weights 目錄、索引放 indices 目錄。
許可以 MIT 許可證開源,底模用的是開源 VCTK 資料集、官方稱無版權方面的顧慮。有一點需要自己把關:音色轉換處理的是他人的聲音,把結果用於公開內容時,請先確認已取得相應授權。