
把時間戳細到每個詞、還標出是誰在說:WhisperX 補的那兩步
摘要
衝著 Whisper 的兩個缺口而來:時間戳只到句子一級,而且本身不支援批次處理。WhisperX 用強制對齊把時間戳細到每個詞,再標出說話者,large-v2 上號稱 70 倍實時。
推薦- 軟體名稱
- WhisperX
- 版本
- 3.8.7
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinuxmacOS
- 更新時間
- 2026-10-06 19:53
Whisper 少掉的兩件事
WhisperX 是衝著一個很具體的抱怨來的。Whisper 轉寫出來的文字很準,但時間戳只到句子一級,做字幕時就會發現文字和畫面對不上,差個幾秒是常態,而且它本身不支援批次處理。
補法是在 Whisper 之外再加兩步。先把轉寫結果和音訊做一次強制對齊,把時間戳細到每個詞;再把音訊按說話者切開,替每一句標上是誰說的。官方把這套流程串成一條產線,對外提供命令列與 Python 兩種用法。
一條四步的產線
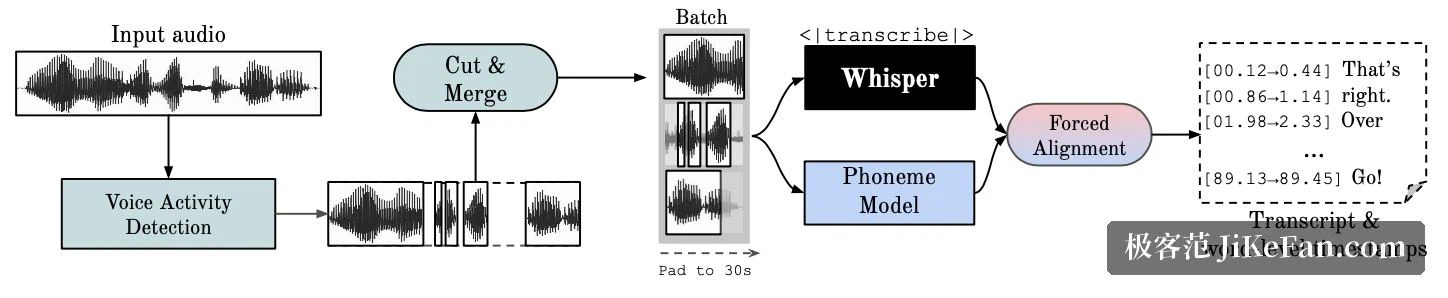
官方倉庫附的流程圖把過程拆成四步:先做語音活動偵測,把靜音段濾掉;再交給轉寫模型批次出文字;然後用音素級辨識模型做強制對齊,拿到詞級時間戳;最後用說話者分離模型區分不同的人。
幾個關鍵指標都寫在官方說明裡:在 large-v2 模型上做批次推論可以達到 70 倍實時;轉寫後端用的是 faster-whisper,large-v2 在 beam size 設為 5 的情況下顯示記憶體需求小於 8GB;詞級時間戳來自 wav2vec2 強制對齊;說話者分離來自 pyannote-audio,輸出的是說話者 ID 標籤。整條流程的論文發表在 INTERSPEECH 2023,主題是長音訊的時間精確轉寫。
前置的語音活動偵測還有個副作用值得一提:官方說它能在減少幻覺的同時不損失辨識準確率,並且讓批次處理更容易做——這也是它能把速度拉上去的前提之一。
安裝:一條 pip 指令
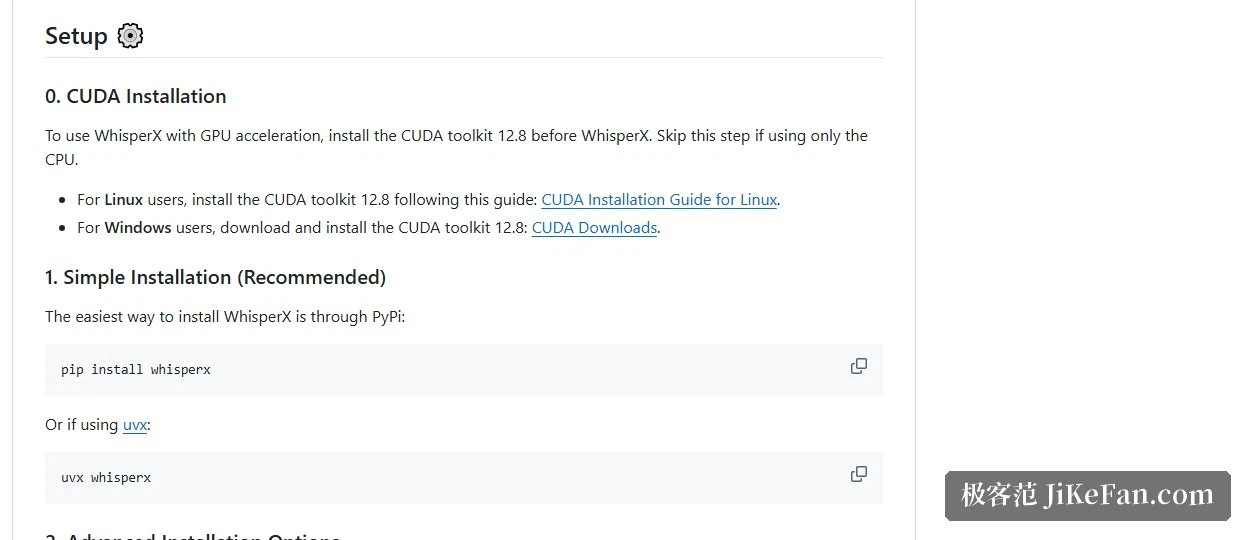
官方推薦的安裝方式很簡單,一條 pip 指令就夠;如果機器上裝了 uv,也可以直接用 uvx 把指令跑起來,不必先裝進環境。想在 GPU 上加速,得先裝好 CUDA 12.8;只用 CPU 的話可以跳過這一步。
要開啟說話者分離,得額外準備一組 Hugging Face 存取權杖,透過命令列參數傳進去,並且先在模型頁面同意使用條款。也就是說,轉寫與對齊本身不依賴連網,但說話者分離這一步會牽涉模型下載與授權。
命令列怎麼用
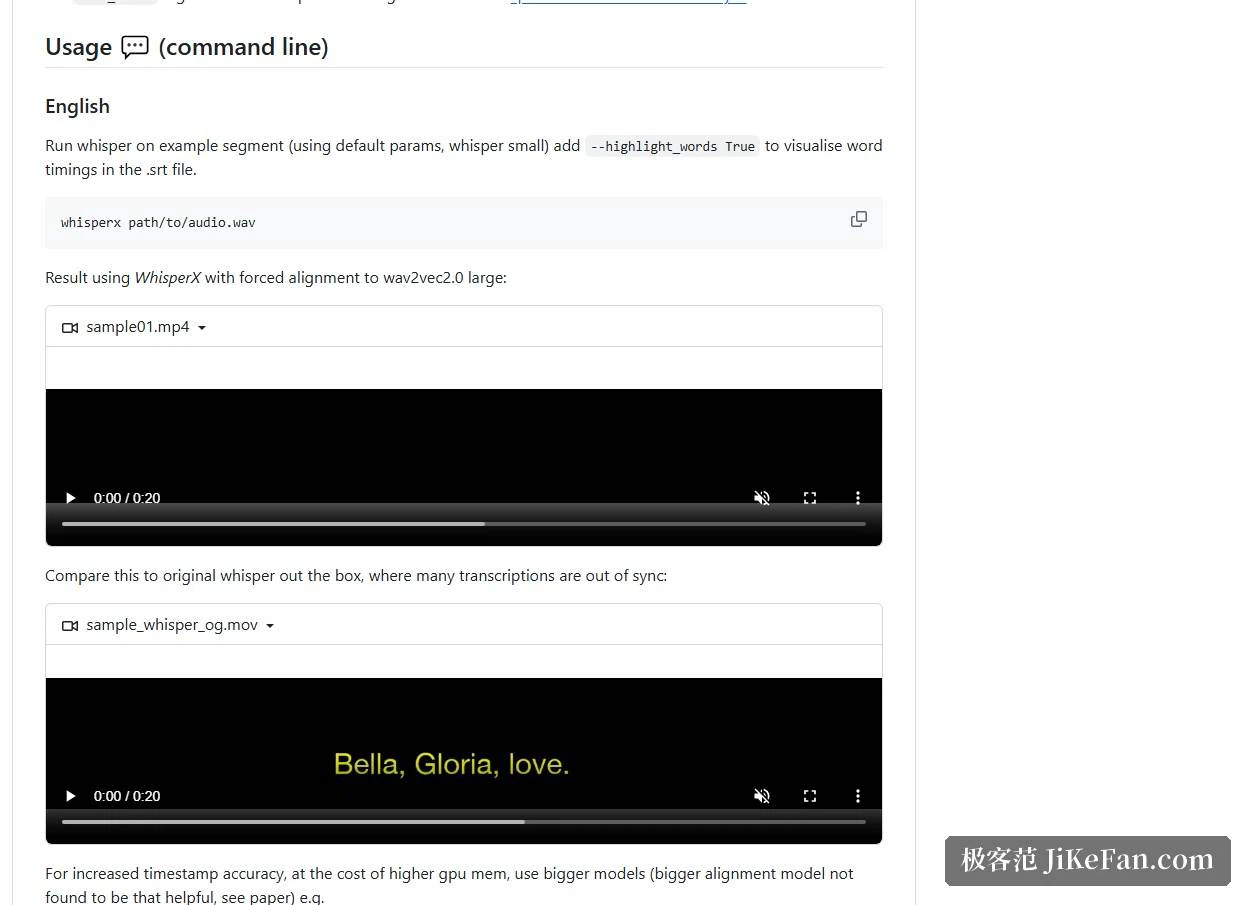
最基本的用法是把音訊檔路徑交給它,預設用較小的模型與預設參數跑一遍。要讓時間戳更準,可以換更大的模型並明確指定對齊模型,代價是佔用更多顯示記憶體。多人音訊加上說話者分離參數,字幕裡還能開啟逐詞高亮,方便逐個核對每個詞的時間點。
沒有顯卡同樣能用,加兩個參數切到 CPU 計算即可,官方也說明這種方式同時適用於在 Mac 上執行。要注意的是,詞級對齊用的音素模型是按語言準備的:英語、法語、德語、西班牙語、義大利語有現成的預設模型,其他語言得自己找對應的模型並測試效果。
faster-whisper:把轉寫後端單獨拿出來用
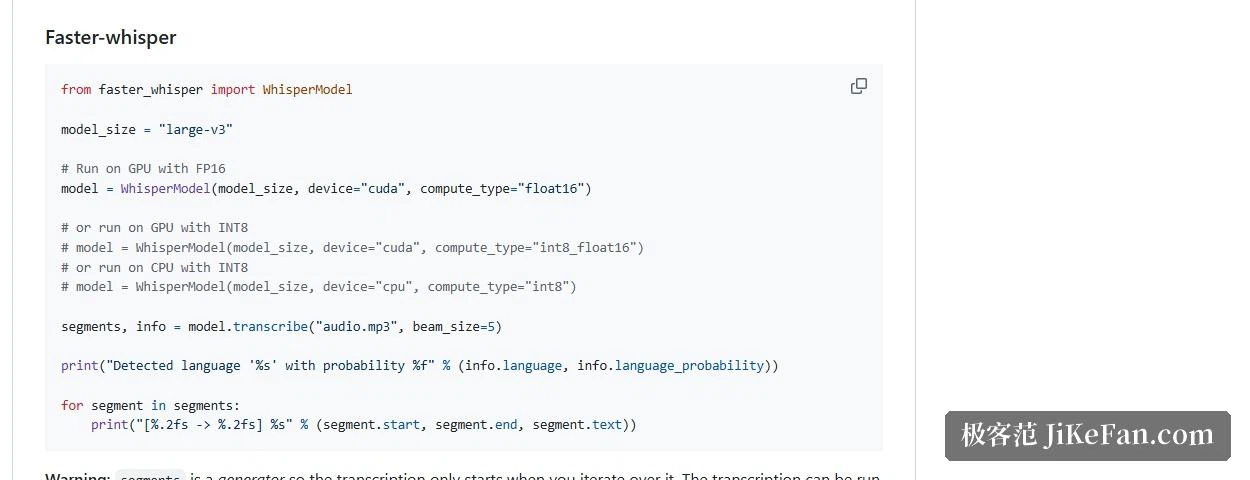
WhisperX 的轉寫環節用的是 faster-whisper。後者是一套獨立的開源實作,用 CTranslate2 這個推論引擎重寫了 Whisper,官方描述是同等準確率下最快比原版快 4 倍,並且佔用更少記憶體;在 CPU 與 GPU 上都能用 8 位量化再提一檔效率。
如果你只需要轉寫、不需要詞級對齊與說話者分離,直接用它會更輕。安裝同樣是 pip 一條指令,而且它對系統相依比較友善:不像原版那樣要求系統裡先裝好 FFmpeg,音訊解碼交給 PyAV 完成,因為 PyAV 已經把 FFmpeg 的函式庫打包在自己的套件內。執行環境要求 Python 3.9 或更高版本。
官方基準測試裡的數字
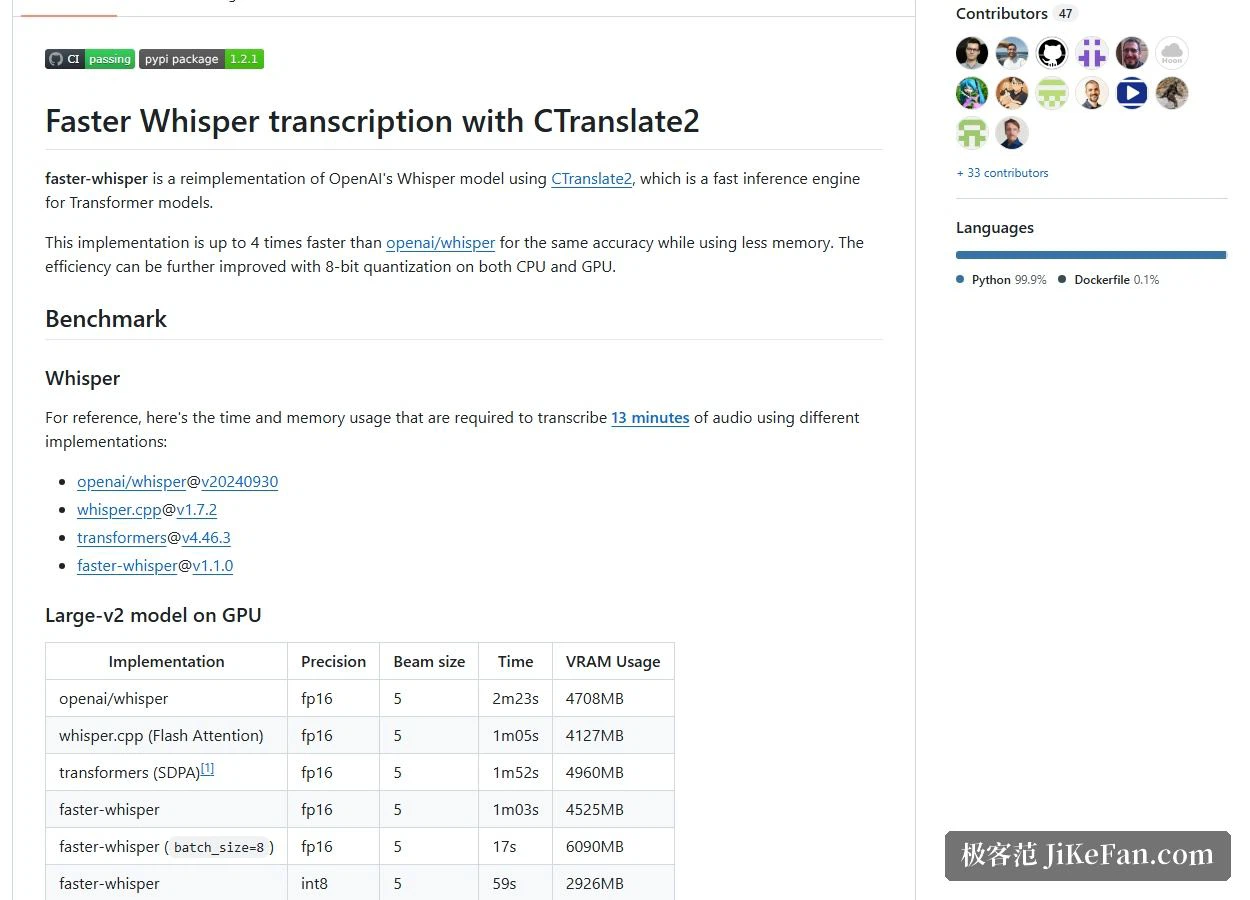
官方給了一組可重現的對比:用 13 分鐘音訊,在 RTX 3070 Ti 8GB 上跑 large-v2 模型,精度 fp16、beam size 取 5。
原版實作花 2 分 23 秒、佔用 4708MB。whisper.cpp 加上 Flash Attention 是 1:05、4127MB。單純的 faster-whisper 是 1:03、4525MB。批次大小開到 8 之後,faster-whisper 只要 17 秒、6090MB。切到 int8 是 59 秒、2926MB;int8 再加批次 8,16 秒跑完、4500MB。
這張表裡最值得看的是批次那一列:同樣是 fp16 精度,預設逐條跑要 1:03,開成批次只要 17 秒;如果顯示記憶體吃緊,切到 int8 可以把佔用壓到 2926MB。CPU 側也有對應的數據:小模型在 8 執行緒的桌機處理器上,原版要 6 分 58 秒,faster-whisper 的 int8 批次是 51 秒。
官方也提醒,比較不同實作時要注意參數對齊:相同的 beam size、相近的辨識準確率、CPU 場景下相同的執行緒數,否則數字沒有可比性。例如原版預設的 beam size 是 1,而 faster-whisper 預設是 5。
用 Python 呼叫更順手
要在自己的腳本裡用,faster-whisper 的介面只有幾行:指定模型大小、裝置與計算精度,然後呼叫轉寫。有一點要留意,它回傳的轉寫結果是一個產生器,真正的計算發生在你開始走訪它的時候,所以要先轉成清單或用迴圈取出來,否則看起來像是沒跑到。批次是另一套介面,把模型包一層並給出批次大小即可;需要詞級時間戳時打開對應參數,就能逐詞拿到開始與結束時間。想過濾長靜音,打開 VAD 過濾就行,官方預設只去掉超過 2 秒的靜音,這個門檻可以自訂。
幾個要提前知道的限制
詞級對齊不是萬能。官方明確列出:年份縮寫、帶貨幣符號的金額這類在對齊模型詞典裡找不到的寫法,無法給出時間點,也就沒有時間戳;重疊說話的情況,Whisper 與 WhisperX 處理得都不算好;說話者分離本身也遠談不上完美;另外對齊模型按語言準備,換語言就要換模型。
授權是 BSD 與 MIT
WhisperX 以 BSD 授權開源,faster-whisper 以 MIT 授權開源,兩者都在倉庫根目錄提供授權檔。寬鬆的授權意味著把它接進自己的字幕流程、或拿來做二次開發,授權上的障礙都不大。
適合哪些人
如果你的目標是把長音訊變成能直接用的字幕檔,WhisperX 的價值就落在這條產線上:時間戳精確到詞,多人內容能區分說話者,命令列與 Python 兩套介面都能接進現有的處理流程。官方稱它在 large-v2 上能做到 70 倍實時,對動輒幾小時的素材來說,這個差距很實在。
但它並不打算做成開箱即用的桌面應用:環境要自己配,模型與語言要自己選,對多數人來說真正的門檻不是指令,而是顯卡與模型大小的取捨。如果只是想快速把錄音轉成文字、不需要詞級時間戳,直接用 faster-whisper 會更省事。