
一行指令拆出四條音軌:Demucs 這個開源分離模型
摘要
把混好的歌曲拆成鼓、貝斯、人聲與其餘伴奏的開源分離模型。以命令列一行執行,也能從 Python 直接呼叫,程式碼採 MIT 授權。
推薦- 軟體名稱
- Demucs
- 版本
- 4.0.1
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinuxmacOS
- 更新時間
- 2026-10-06 17:10
它拆出什麼
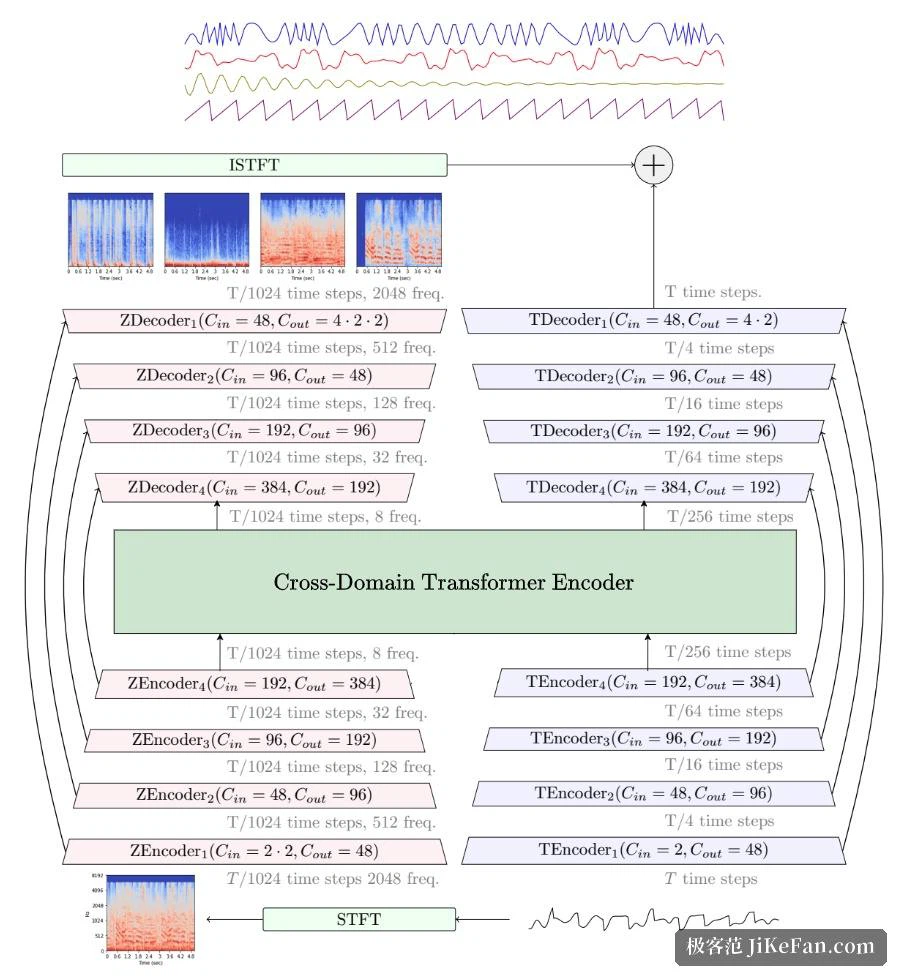
Demucs 是一個開源的音源分離模型,目標很直接:把一首混好的歌拆成幾條獨立音軌——鼓、貝斯、人聲,以及剩下的其它伴奏。它是「模型加命令列」這種形態,想接進自己的腳本,比圖形介面工具方便。
它由 Défossez 等人提出,經歷過多次版本迭代,v4 是目前的主版本。有一件事需要先講清楚:作者已經離開 Meta,原來的倉庫不再維護,只處理重要修復——這一點對要不要把它放進長期專案很關鍵,本文末尾會展開。
官方對它的描述是「當前先進的音樂音源分離模型」,目前能把鼓、貝斯與人聲從其餘伴奏中分離出來。也就是說輸出的是四條音軌,而不是簡單的「人聲/伴奏」兩分。
效果上的數字官方也給了:Hybrid Transformer Demucs 在 MUSDB HQ 測試集上的 SDR 為 9.00 dB;如果再疊加稀疏注意力與按源微調,可以做到 9.20 dB。這套模型是在 MUSDB HQ 資料集之外,又加了 800 首歌曲一起訓練出來的。
模型怎麼選
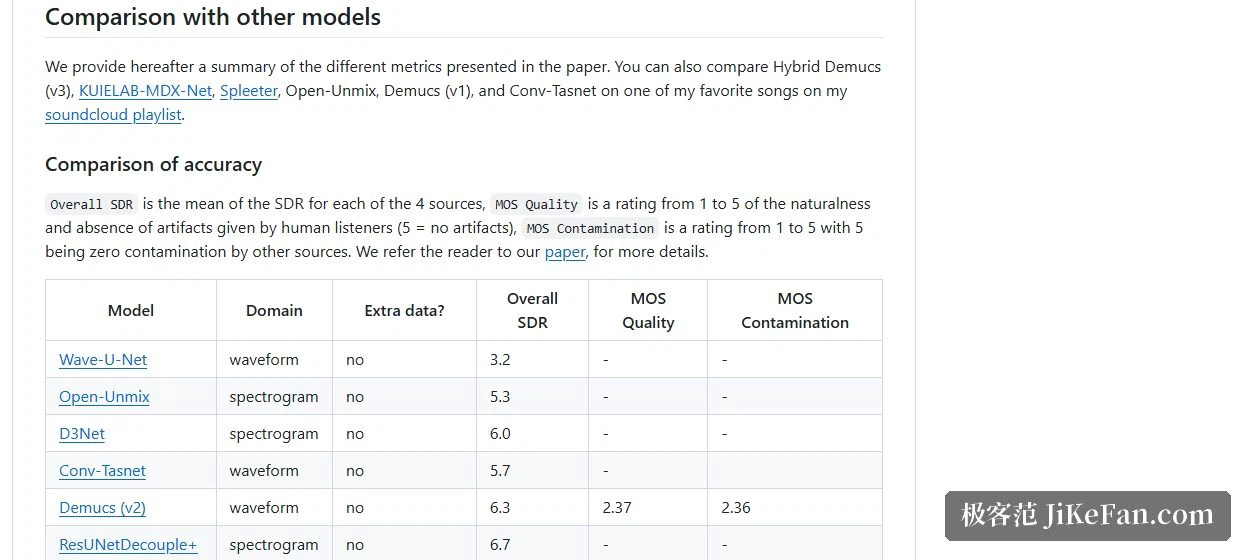
裝好之後可選的模型不止一個,官方給了明確的取捨:預設模型是 htdemucs;想要更好一點的效果可以用微調版 htdemucs_ft,代價是分離耗時大約是預設模型的四倍。另有一個實驗性的六源版本,會額外拆出鋼琴與吉他——但官方自己說了,鋼琴這一路目前效果不算好。
另外兩個模型算是「歷史戰績」型選手:mdx 曾在 MDX 挑戰賽的 A 軌拿到第一,mdx_extra 在 B 軌排名第二;兩者還各有一個量化版本,體積更小、品質可能略降。
裝起來與基本用法
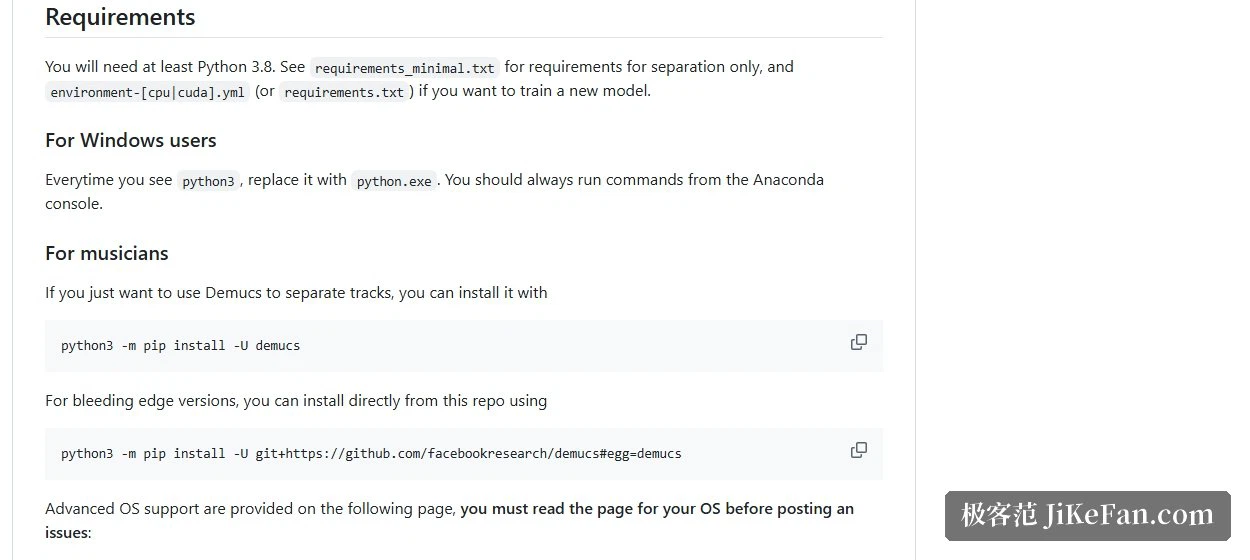
安裝只要一條 pip 指令,要求 Python 3.8 或更高版本。官方同時提供了 conda 環境檔與容器映像兩種方式,適合需要重現環境、或者要跑在伺服器上的場景。
最常用的呼叫方式是把音訊檔路徑交給它,跑完在輸出目錄裡拿結果:以模型名命名的目錄下再按曲名分目錄,裡面是四個 44.1kHz 的立體聲檔案——鼓、貝斯、其它、人聲。輸出預設是 wav,也可以用參數改精度,或者直接存成 mp3。
如果只想要人聲、不要其它音軌,可以打開只分離人聲的模式,也就是常說的卡拉 OK 用法。官方提醒這個模式並不是「只算人聲」——它先把整軌全部分離再混合,所以既不會更快,也不會更省記憶體。
顯示記憶體、速度與呼叫方式
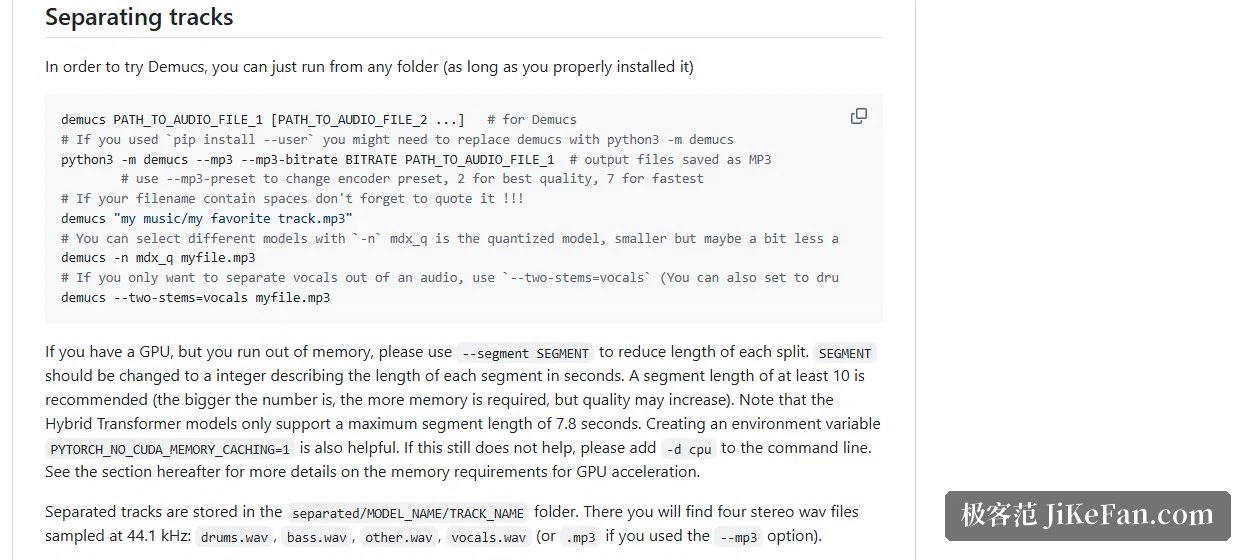
顯示記憶體方面官方給的數字是:用 GPU 至少要 3GB,但按預設參數跑大約需要 7GB。不夠有兩條退路——調小分段長度,或者乾脆切到 CPU 計算。用 CPU 的代價是時間,官方給的經驗值是處理時間約為音訊時長的 1.5 倍。
除了命令列,它也能直接從 Python 程式裡呼叫:把命令列參數原樣傳給介面即可,等於把分離這一步嵌進自己的批次流程。
維護狀態與許可
這一節需要如實說明:作者在倉庫首頁寫明自己已不再就職於 Meta,因此原倉庫不再維護,只處理重要的問題修復,功能請求也不再受理,同時把工作轉移到自己新建的分支倉庫。
許可上,Demucs 以 MIT 許可證開源,寬鬆度足夠放進商業流程,只是要接受「上游基本凍結」這個現實:選它意味著你用的是一套已經穩定的實作,而不是一個還在快速演進的專案。
適合哪些人
如果你的需求是「把一批音訊按四條音軌拆開,並且希望這一步能寫進腳本」,Demucs 的形態比圖形介面工具更順手:裝一次、呼叫一次、輸出固定的目錄結構,剩下的交給自己的流程編排。
反過來,如果你只是想偶爾給一首歌做伴奏,或者希望點幾下滑鼠就能試遍各種模型組合,那帶介面的工具會更省心。Demucs 的價值不在門檻低,而在可控與可重複。