
一首歌拆成人聲與伴奏:Ultimate Vocal Remover 裝好就能用
摘要
用音源分離模型把歌曲拆成人聲與伴奏的開源工具。官方安裝包把介面、Python、PyTorch 與相依套件一起打包,事前不必準備任何前置條件。
推薦- 軟體名稱
- Ultimate Vocal Remover
- 版本
- 5.6
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinuxmacOS
- 更新時間
- 2026-10-06 19:04
它到底在做什麼
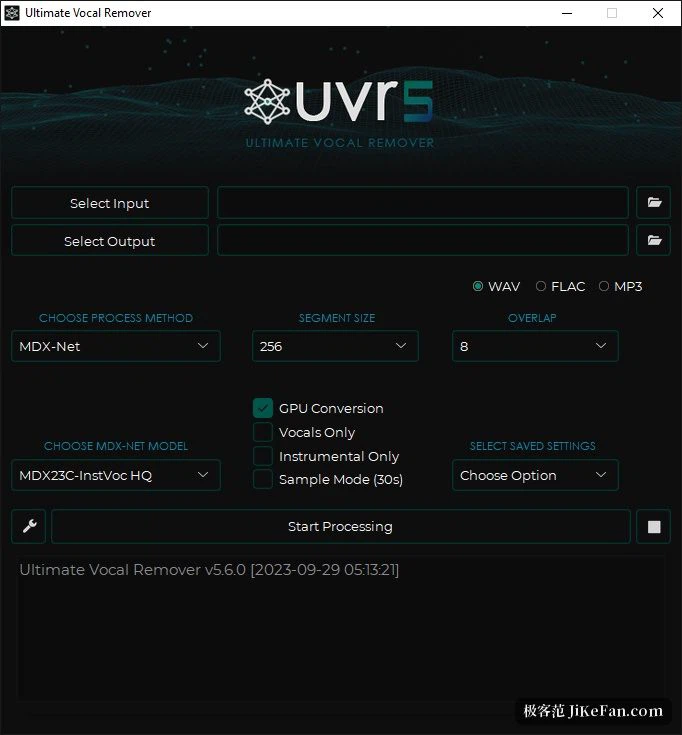
名字很長,事情卻很直接。Ultimate Vocal Remover 是一個做音源分離的開源工具:把一首歌拆成人聲與伴奏,或者只把人聲抹掉、留下伴奏。對做翻唱、混音、二次創作的人來說,這是最常用的第一步前置處理。
它最大的特點是「開箱即用」。官方安裝包把介面、Python、PyTorch 與其他相依套件打包在一起,官方說明裡明確寫了不需要額外準備前置條件,下載安裝即可使用。
官方對它的描述是:使用先進的音源分離模型,從音訊檔中去除人聲。這裡說的是「分離」而不是「濾波」——不是把某個頻段一刀切掉,而是讓模型判斷哪些成分屬於人聲、哪些屬於伴奏,再把它們分別還原成獨立音軌。
包裡的模型絕大部分是專案自己的成果:官方說明除了 Demucs v3 與 v4 的四軌模型之外,包內提供的模型都由 UVR 的核心開發者訓練。也就是說,裝上之後介面裡可選的那一批模型,來源是清楚的。
順便帶著的配套工具
除了標準分離,它還帶了一些配套工具,例如時間伸縮與變調——這兩項依賴 Rubber Band 函式庫;處理非 wav 格式的音訊則依賴 FFmpeg。官方也給了「把可執行檔直接放進應用程式目錄」的免安裝做法,不想折騰環境變數的人可以照做。
三個平台怎麼裝
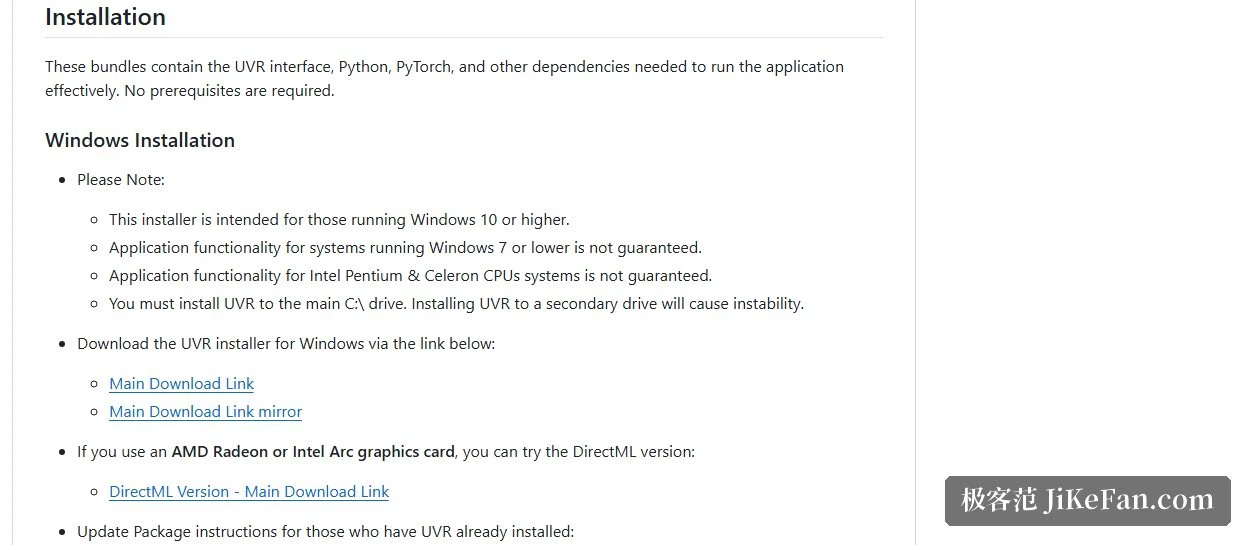
Windows 使用者直接下載安裝程式:要求 Windows 10 或更高版本,而且必須裝在 C 槽——官方特別提醒裝到副磁碟會引起不穩定。如果用的是 AMD Radeon 或 Intel Arc 顯卡,可以改用 DirectML 版本,官方也坦言 AMD 顯卡的支援目前仍然有限。
macOS 需要 Big Sur 或更高版本,並按 M1 與 Intel 兩種機型分別下載。官方提到 M1 的 MPS 加速已經擴展到支援 Demucs v4 與全部 MDX-Net 模型,另外首次啟動可能要等 5 到 10 分鐘。
Linux 側官方給的是手動流程:面向 Debian 與 Arch 系發行版,先裝 FFmpeg、Python 套件管理員與 tk 元件,再建虛擬環境安裝相依套件,最後以腳本方式啟動。
硬體門檻與相依
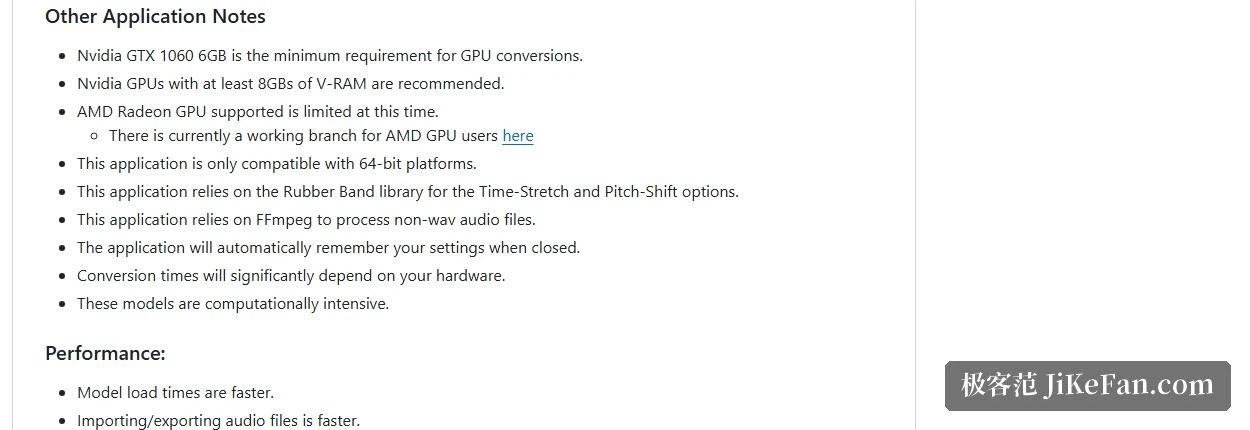
顯卡是這類工具繞不開的話題。官方給出的最低要求是 Nvidia GTX 1060 6GB,但建議顯示記憶體 8GB 以上;軟體只支援 64 位系統。官方同時提示轉換耗時明顯取決於硬體——分離模型本身就是計算密集的負載。
沒有獨顯也不是不能用,但要有心理準備:CPU 跑分離的時間會明顯長於音訊本身的長度。穩妥的做法是先用一段短音訊把流程走通,確認參數合適再處理整張專輯。
授權是 MIT
UVR 的程式碼以 MIT 授權開源。官方在授權說明裡補了一句給第三方開發者的話:如果要把這些模型用在自己的應用裡,請按 MIT 授權的方式署明 UVR 及其開發者。寬鬆授權加上「模型來自官方」這一點,讓它比同類閉源工具更適合放進長期的流程。
另外,應用程式會在關閉時自動記住你的設定,省去每次重新配置的麻煩。
適合哪些人
如果你只是偶爾想要一首歌的伴奏,網頁版工具就夠了。但如果你需要處理整批檔案、需要反覆換模型對比效果、或者不希望把音訊上傳到別人的伺服器,本地工具的價值就體現出來了:裝一次,之後每次分離都在自己的機器上完成。
需要提醒的是,分離品質受模型與素材影響很大,官方也坦言這些模型計算量不小。把它當成「前置處理的第一步」而不是「一鍵完美出活」更合適——分出音軌之後,通常還需要在音訊軟體裡做一輪修整。