
拿到 MIT 的程式碼,卻拿到非商用的權重:F5-TTS 該怎麼讀授權
摘要
以流匹配做語音合成的開源專案,提供 pip 套件、命令列推論與 Gradio 網頁介面。程式碼是 MIT,預訓練權重卻因訓練資料的限制只能非商用。
推薦- 軟體名稱
- F5-TTS
- 版本
- 1.1.22
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinuxmacOS
- 更新時間
- 2026-10-06 20:44
F5-TTS 是一篇論文的官方實作,論文標題起得俏皮:一個用流匹配假造流暢忠實語音的說書人。名字輕鬆,技術路線並不含糊。它用流匹配來做語音合成,主幹是 Diffusion Transformer 搭配 ConvNeXt V2。
專案開源,已經發布過二十多個版本,倉庫裡同時維護著基礎模型,以及推論、訓練、部署相關的程式碼。
三個關鍵詞:流匹配、ConvNeXt V2、Sway Sampling
官方在專案說明裡把三件事並列成要點。第一件是 F5-TTS 本身,用 Diffusion Transformer 搭配 ConvNeXt V2,官方的原話是訓練與推論都更快。第二件是 E2 TTS,一個採用 Flat-UNet Transformer 結構的復現版本。第三件是 Sway Sampling,一種推論階段的流步取樣策略,官方稱它能明顯改善生成表現。
對使用者來說,前兩點決定模型的能力上限,第三點決定同一個模型能跑出什麼效果。Sway Sampling 屬於推論期就能生效的調整,不必重新訓練,這也是它被單獨列出來的原因。
裝起來:一行 pip,或者換成 Docker
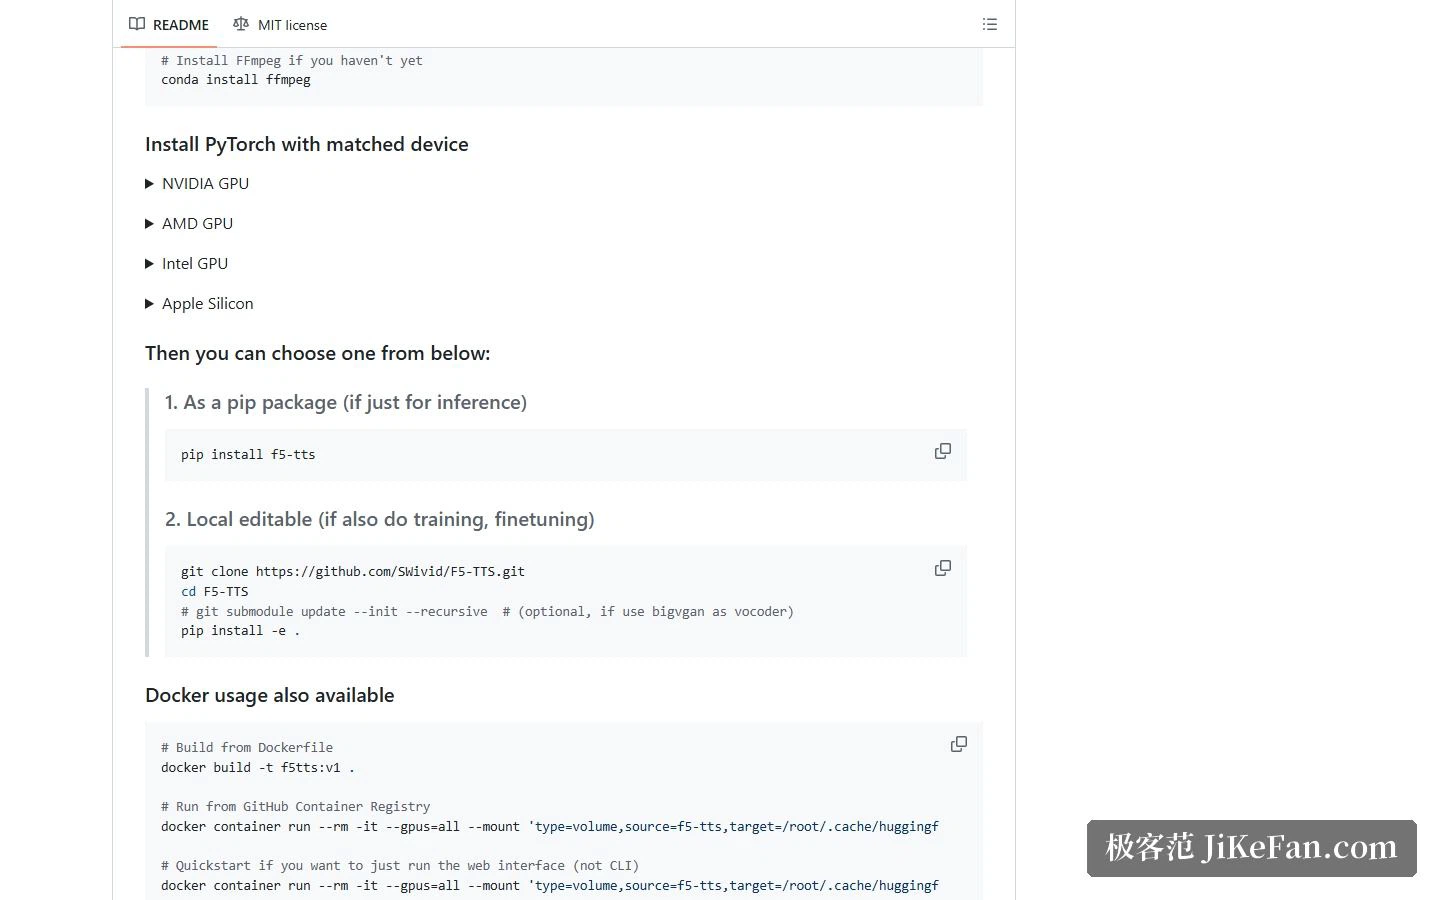
官方把安裝方式分成兩類,取決於你想做什麼。只做推論的話,直接裝 pip 套件就夠;要訓練或微調,就得把倉庫複製下來做可編輯安裝。裝 PyTorch 之前要先按自己的裝置選版本,官方分別給了 NVIDIA、AMD、Intel 與 Apple Silicon 幾種平台的安裝指令。
除此之外還有 Docker 這條路:既可以自己用倉庫裡的 Dockerfile 建置,也可以直接拉官方映像跑起來,官方甚至給了一條只啟動網頁介面的快捷指令。
三種用法:命令列、網頁介面、語音對話
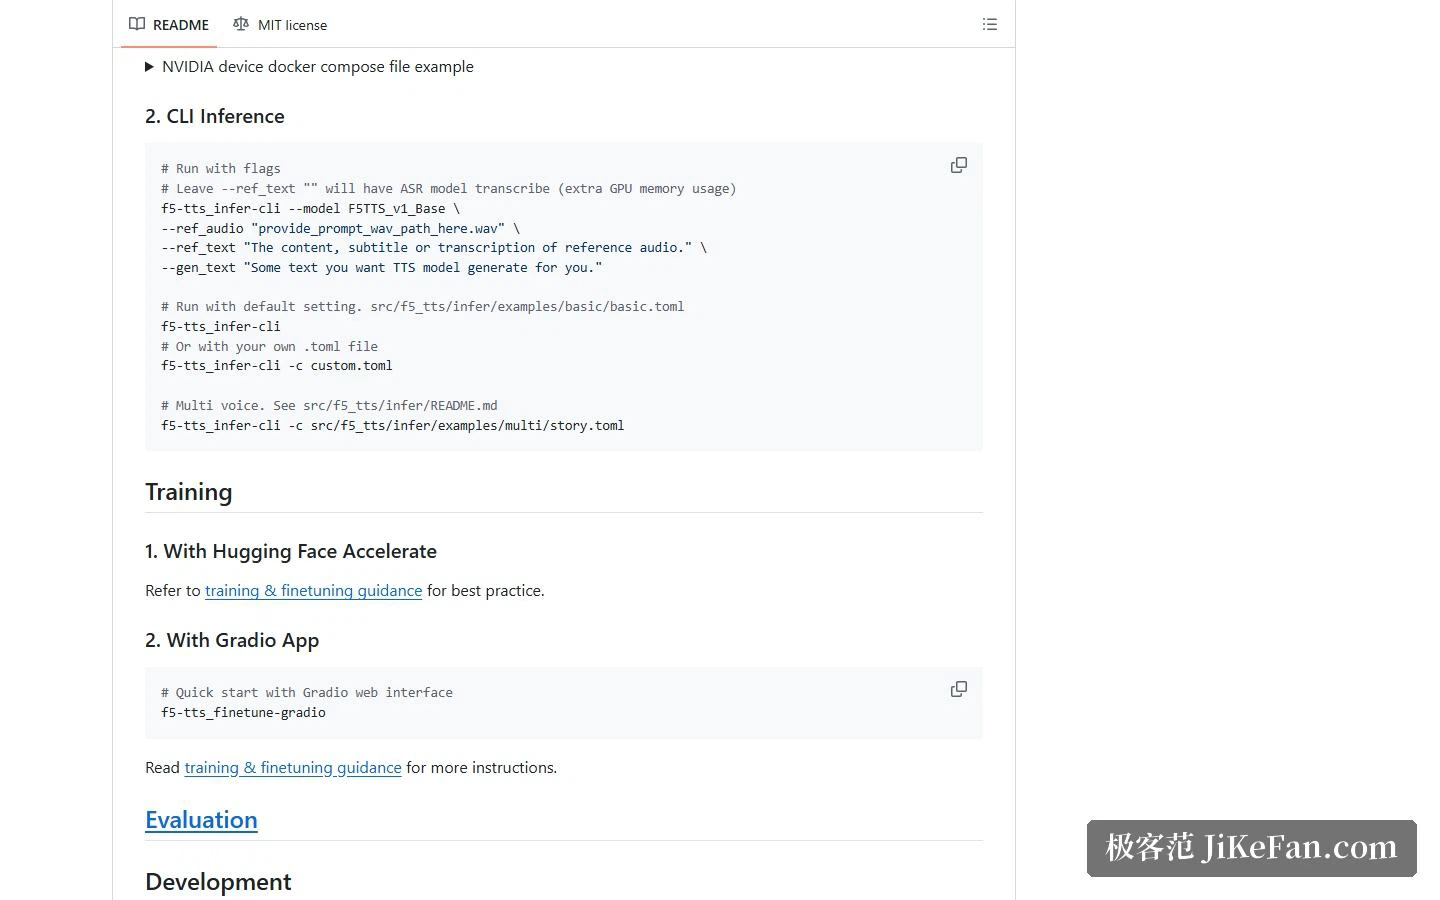
命令列工具的參數很直觀:給一段參考音訊、給出這段音訊對應的文字,再寫一句想生成的文字,模型就會用參考音訊的音色把目標文字讀出來。官方還提到一個細節——參考文字可以留空,此時會呼叫語音辨識模型自動轉寫,代價是多佔一些顯示記憶體。
不想碰命令列的話,可以啟動 Gradio 網頁介面。官方列出的功能包括基礎語音合成、多風格與多說話者生成,以及一個由三十億參數級別的指令微調語言模型驅動的語音對話功能。也就是說,這個介面不只是把文字轉成音訊,還能做一輪語音形式的對話互動。
效能數據:單張 L20 上跑出來的結果
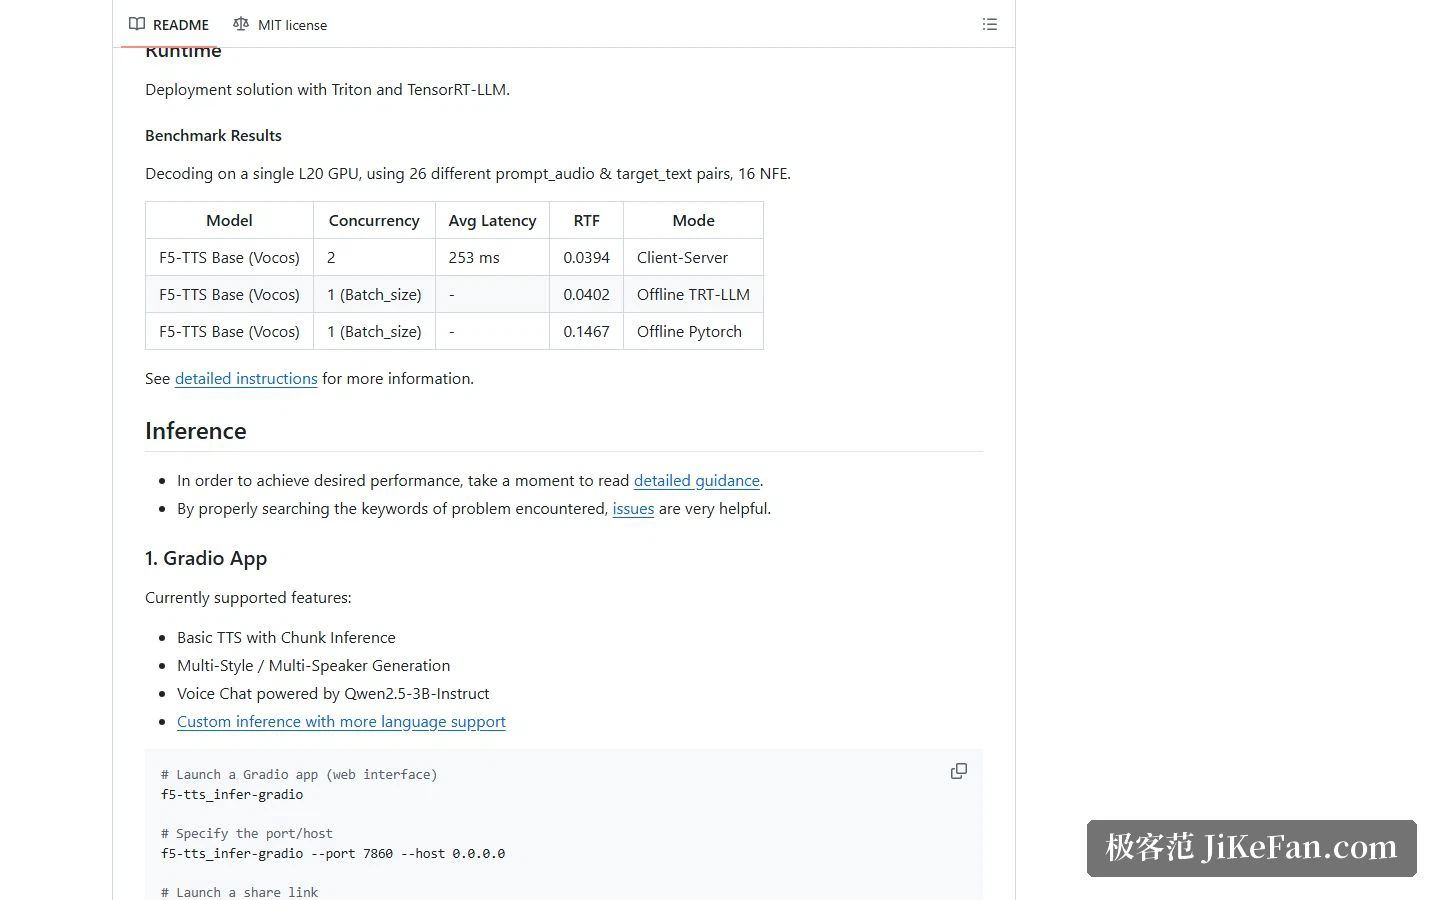
官方在部署方案一節給了基準測試,測法是單張 L20 顯卡、26 組不同的參考音訊與目標文字配對、16 步推論。F5-TTS Base 在並發為 2 的客戶端與服務端模式下,平均延遲 253 毫秒,即時率約 0.0394;換成離線 TensorRT-LLM 模式即時率是 0.0402,而離線 PyTorch 模式則是 0.1467。即時率越低,代表生成速度領先播放速度的倍數越多,從這組數字也能看出不同部署方式的落差。
訓練與微調
專案同樣把訓練路徑分成兩條:一條走 Hugging Face Accelerate,適合常規的訓練與微調;另一條是 Gradio 介面,官方給了一個專門的微調介面啟動指令,不寫程式也能跑起來。對只想把模型調成自己想要的音色的人,後一條路更省事。
授權:程式碼 MIT,模型非商用
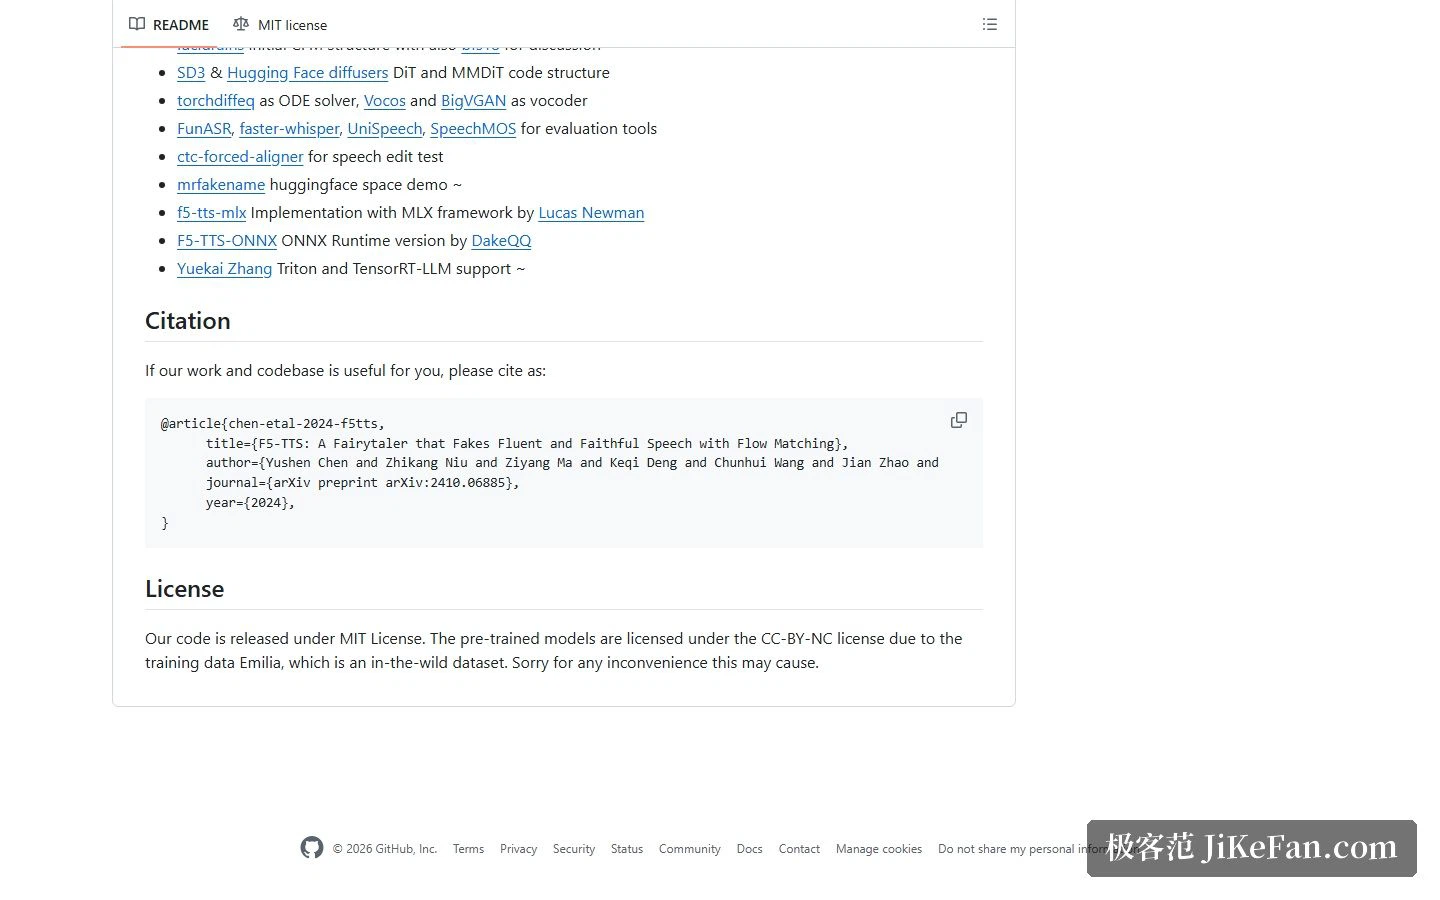
這一段要看仔細。官方在授權一節寫明:程式碼以 MIT 授權釋出,但預訓練模型的授權不同——因為訓練資料集屬於野外採集,所以預訓練模型採用非商用的 Creative Commons 授權。官方在原文裡也為此道了歉。
這意味著你可以自由地用這套程式碼做二次開發,但如果打算把官方預訓練模型直接用在商業專案裡,就有授權上的障礙。要繞開這一條,通常得換成授權更寬鬆的資料集自行訓練,而這需要額外的算力與資料準備。
適合誰
如果你是研究者、開發者,想在一個結構清晰、迭代活躍的開源語音合成專案上做實驗,F5-TTS 的程式碼品質與說明文件的完整度都不錯:安裝方式多、部署方案給了 Triton 與 TensorRT-LLM、推論和訓練都有現成入口。
如果你只是想找一個能直接商用的語音合成方案,那要先解決授權的問題,或者評估自訓練的成本。另外,無論用哪個模型,聲音複製的授權邊界都值得先確認清楚——用別人的聲音做內容,尤其是公眾人物的聲音,可能涉及人格權與聲音權。
開源專案把能力擺出來了,也把限制寫在授權那一節。用之前花兩分鐘讀一遍條款,往往比事後返工划算得多。