
五秒就能合成、一分鐘就能調出專屬音色:GPT-SoVITS 的上手閘檻
摘要
開源的語音合成 WebUI。五秒人聲就能做零樣本合成,一分鐘語料足以微調出更接近的音色;推論還能跨語言,涵蓋中文、英文、日文、韓文與粵語。
推薦- 軟體名稱
- GPT-SoVITS
- 版本
- 20260917
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinuxmacOS
- 更新時間
- 2026-10-06 18:49
讓機器學會某一個人的說話方式,這幾年的門檻一直在往下掉。GPT-SoVITS 把這條線壓到兩個數字:五秒與一分鐘。五秒是人聲樣本的下限,用它就能在零樣本模式下直接合成;一分鐘是訓練資料的下限,用它微調之後,音色的相似度會明顯上升。專案在 GitHub 上開源,倉庫標題寫得很直白——一分鐘的語音資料也足以訓練出一個能用的 TTS 模型。
兩條路:不訓練,與只訓練一點
官方把能力拆成兩條路徑,各自對應一種需求。
零樣本 TTS 是最省事的那條。丟進五秒的人聲樣本,立刻就能把文字轉成語音。適合先看看效果、或者只是偶爾用一次的人。不必等訓練,也不必準備資料集。
少樣本 TTS 是效果更好的那條。一分鐘的訓練資料換來更高的相似度與更自然的聽感。一分鐘這個量級的意義在於它拿掉了什麼:訓練自己的語音模型,從需要錄好幾小時音的專業工作,變成隨手錄一段就能試的事。
它會說哪些語言
官方列出的語種是英語、日語、韓語、粵語與中文。更有意思的是跨語言這一條:推論時使用的語言,不必和訓練集一樣。也就是說,用一種語言錄的樣本,理論上可以拿去說另一種語言,不必為每個語種另外準備一套資料。
WebUI 裡自帶資料準備工具
真正做過語音複製的人會知道,麻煩的通常不是模型,而是前期的資料處理:錄音裡混著背景音樂怎麼辦、長音訊怎麼切、切完誰來寫轉寫文字。GPT-SoVITS 把這些環節一起做進了 WebUI——內建人聲伴奏分離、自動切分訓練集、多語言語音辨識標註與文字標註。
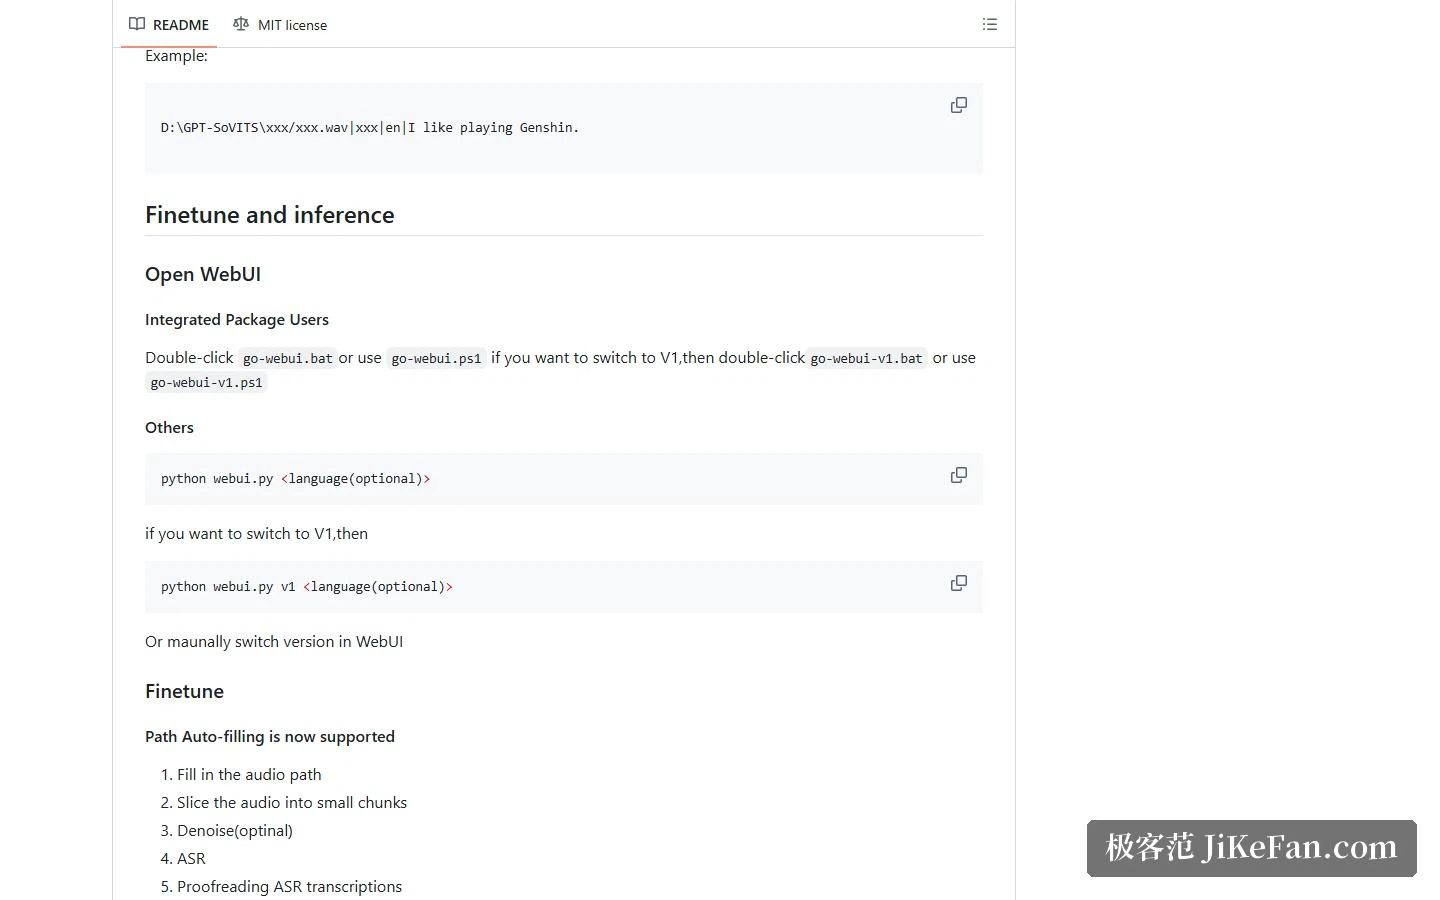
所以實際的操作順序是:填音訊路徑、切片、視需要降噪、跑語音辨識、校對轉寫文字,然後切到微調頁訓練。語音辨識這一塊整合了 Fun-ASR、SenseVoice 與 FunASR 幾套工具,新手不必自己去拼這條流水線。
版本不少,怎麼挑
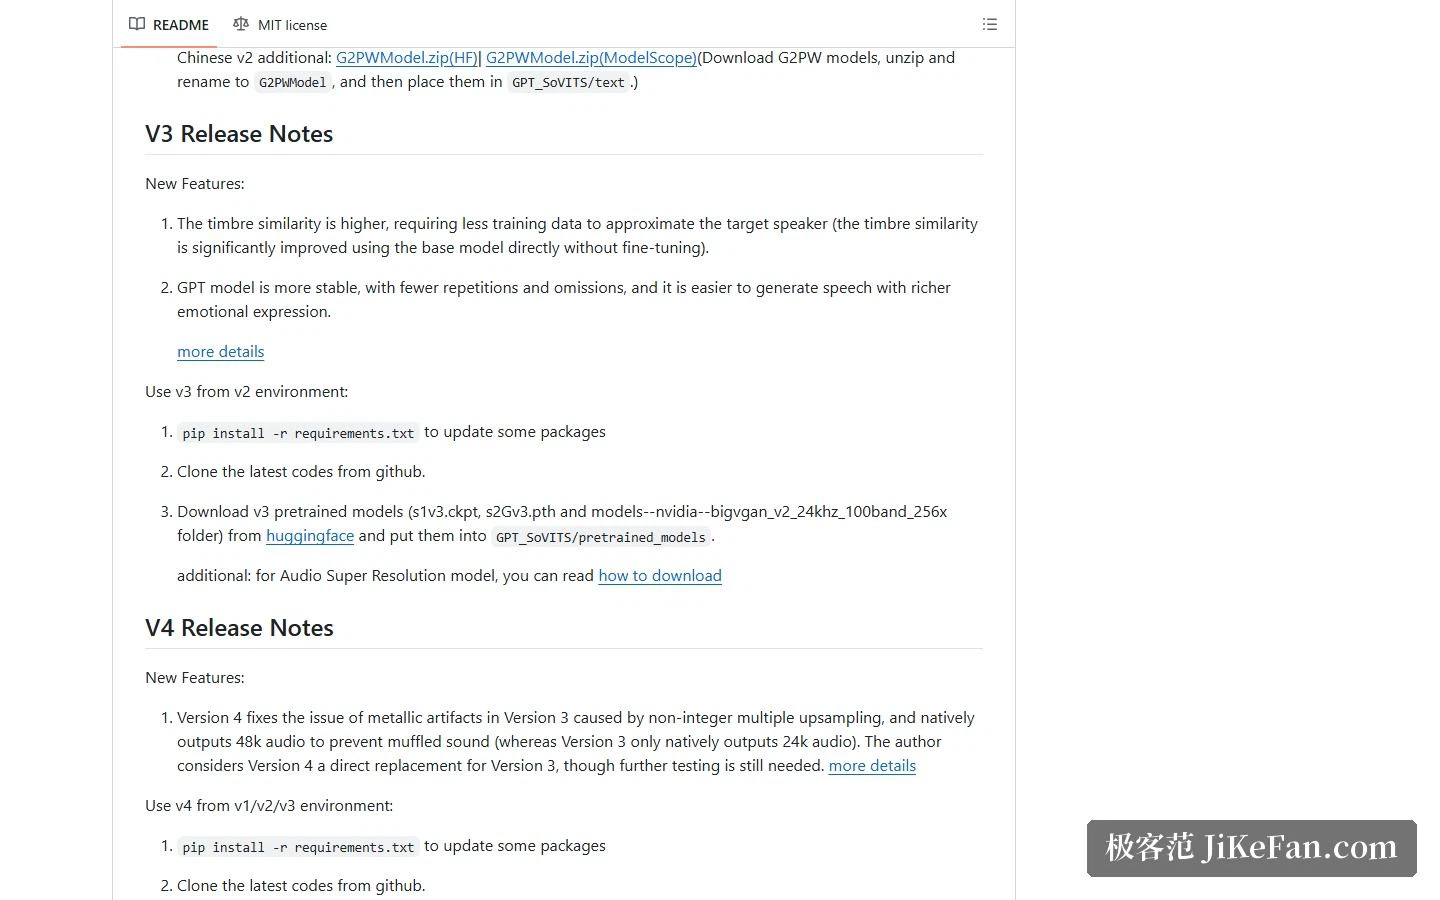
倉庫目前提供 V1、V2、V2Pro、V3 與 V4 等多個版本,啟動時用參數切換,Windows 整合包也配了對應的啟動腳本。幾個關鍵差異值得記住:V2 把預訓練模型規模從兩千小時擴到五千小時,並新增韓語與粵語;V3 在不微調的情況下,音色相似度就有明顯提升,同時 GPT 模組更穩定、情緒更豐富;V4 修掉了 V3 因為非整數倍上採樣帶來的金屬雜音,並原生輸出 48kHz 音訊,而 V3 是 24kHz。
裝起來麻煩嗎
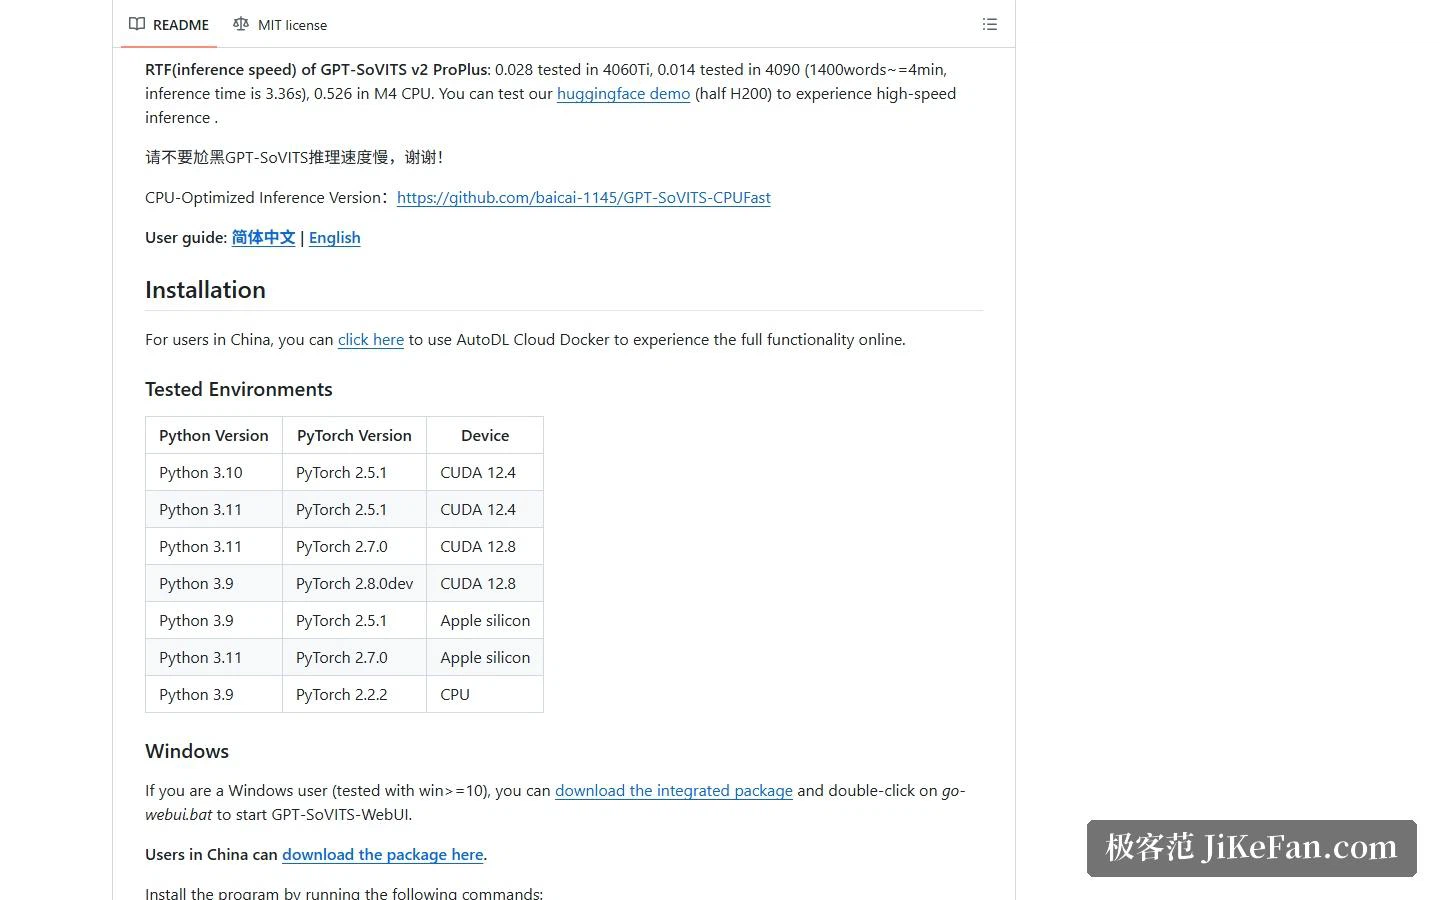
官方給了幾條路。最省事的是 Windows 整合包:下載解壓後雙擊啟動腳本,WebUI 就打開了。想在命令列裡管理環境的話,Windows 有 PowerShell 安裝腳本,Linux 與 macOS 有 shell 腳本,兩者都能指定裝置類型與模型下載來源。再往下是手動安裝與 Docker 兩條路,前者要自己把依賴與 FFmpeg 裝好,後者官方提醒輕量映像不含語音辨識與人聲分離模型,需要另外下載。
環境方面,官方列出的測試組合涵蓋 Python 3.9 到 3.11、PyTorch 2.2 到 2.7,裝置既有走獨立顯卡的桌機組合,也有純 CPU 的輕量組合。有一點要提前知道:官方說明在部分平台上,用 GPU 訓練出來的模型品質明顯不如其他裝置,因此專案在這些平台上暫時改用 CPU 訓練,速度會慢不少。
適合誰
如果你的需求是「訓練一個屬於自己、或某個指定音色的語音模型,而且希望資料留在本機」,GPT-SoVITS 的定位正好對得上:資料量要求低、工具鏈完整、授權是 MIT,用起來限制不多。
但它需要一張夠用的顯卡,或者接受 CPU 推論的慢速度;在部分平台上,訓練階段的耗時會明顯更長,這點要有心理準備。另外,聲音複製的邊界不在技術而在授權:拿別人的聲音、尤其是公眾人物的聲音做內容,可能涉及人格權與聲音權,動手前先把權利來源確認清楚。
用一分鐘的資料訓練一個 TTS 模型,幾年前是難以想像的事。工具越強,使用者越需要自己守住那條線——能用與該用,始終是兩件事。