
-
Chatterfly, Fn을 누르고 말하면 바로 완성된 글이 된다
2026년 9월 시험판을 시작한 음성 입력 도구. Fn을 누르고 평소처럼 말한 뒤 손을 떼면 군더더기를 걷어 낸 글이 나오고, 회의록이나 광고 문안 같은 상황에 맞춰 다듬을 수도 있다.
-
10분 음성으로 다른 목소리를 만드는 RVC, 실시간 변성과 지연 수치
음색 변환과 실시간 변성을 하는 오픈소스 틀이다. 학습에는 최소 10분의 조용한 음성이 필요하고, 끝에서 끝까지 지연은 170밀리초에 이르며, 화면도 두 가지로 제공된다.
-
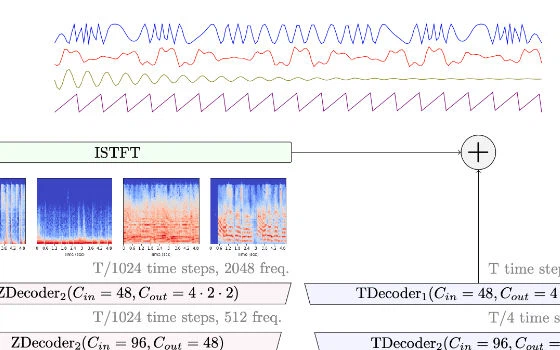
명령줄 한 줄로 네 갈래 음을 뽑는 Demucs라는 분리 모델
섞인 곡을 드럼, 베이스, 보컬, 나머지 반주로 나누는 오픈소스 분리 모델이다. 명령줄 한 줄로 돌고 파이썬에서도 부를 수 있으며 코드는 MIT 라이선스다.
-
곡을 목소리와 반주로 나누는 Ultimate Vocal Remover, 설치하면 바로 쓴다
음원 분리 모델로 노래를 목소리와 반주로 가르는 오픈소스 도구다. 공식 설치 파일이 화면과 파이썬, PyTorch, 의존성을 함께 담고 있어 미리 준비할 것이 없다.
-
낱말 단위 시각과 화자 표시까지 붙이는 WhisperX의 두 단계
Whisper의 두 구멍을 메우는 흐름이다. 시각은 문장 단위에서 멈추고 묶음 처리 수단도 없다. WhisperX는 강제 정렬로 낱말 시각까지 좁히고 화자도 구분하며, large-v2에서 실시간의 70배라고 내건다.
-
받아쓰기를 내 컴퓨터에 붙잡아 두는 데스크톱 도구, Buzz
내 컴퓨터 안에서 받아쓰기와 번역을 끝내는 데스크톱 도구이고 토대는 Whisper다. 음성과 영상 파일은 물론 링크를 받고, 마이크에서 바로 받아쓰며, 화자도 구분하고, 텍스트와 SRT, VTT로 내보낸다.
-
Whisper는 여섯 크기로 나오고, 고르는 기준은 그래픽 메모리다
받아쓰기와 영어 번역, 언어 판별을 한 번에 처리하는 범용 음성 인식 모델이다. 크기는 약 3900만에서 약 15.5억 파라미터까지 여섯 가지이고, 코드와 가중치 모두 MIT 라이선스다.
-
IndexTTS를 내 PC에서 돌린다, 감정과 말 속도 모두 파라미터로 조절
내 PC에 설치해 실행하는 제로샷 음성 합성이다. 참조 음성 한 개면 목소리를 복제하고, 감정과 말 속도, 발음을 모두 파라미터로 조정한다. 가중치는 일반 오픈소스 라이선스가 아니라 프로젝트 자체 라이선스를 따른다.
-
F5-TTS는 MIT 코드와 비상업용 가중치를 함께 주고, 설치는 pip 한 줄
플로 매칭으로 음성을 합성하는 오픈소스 프로젝트다. pip 패키지와 명령줄 추론, Gradio 웹 화면을 제공한다. 코드는 MIT이지만 사전학습 가중치는 학습 데이터 때문에 비상업용으로 제한된다.
-
CosyVoice, 9개 언어와 중국어 18개 방언을 덮고 제로샷 복제까지 한다
오픈소스 음성 합성 모델이다. 최신 세대는 언어를 넘는 제로샷 복제를 지원하고, 9개 외국어와 열 가지가 넘는 중국어 방언과 억양을 아우르며 Apache 2.0 라이선스로 공개됐다.
-
GPT-SoVITS, 1분 음성으로 목소리 모델을 다듬고 5초로 제로샷 합성한다
오픈소스 음성 합성 WebUI다. 5초 분량의 사람 목소리로 제로샷 합성이 되고, 1분 분량의 학습 데이터로 더 가까운 음색을 만들 수 있다. 추론은 중국어, 영어, 일본어, 한국어, 광둥어 다섯 언어를 넘나든다.
-
Fish Audio, 10초 음성으로 목소리를 만들고 매달 8000 크레딧을 준다
가입에 카드가 필요 없고 무료 요금제는 매달 8000 크레딧을 준다. 10초짜리 음성을 올리면 쓸 만한 목소리가 나오고, 합성할 때는 60가지가 넘는 감정 태그로 말투를 조절한다.
-
한 문장이면 노래가 된다, Haimian Music에서 장르와 분위기와 음색까지 고른다
브라우저에서 바로 쓰는 음악 제작 도구다. 가운데 입력창에 원하는 분위기를 적으면 편곡과 보컬까지 모델이 맡아 노래 한 곡을 돌려준다. 가사가 있는 사람은 붙여 넣고 장르와 분위기와 음색만 고르면 된다.
-
第 1 / 1 页