
F5-TTS는 MIT 코드와 비상업용 가중치를 함께 주고, 설치는 pip 한 줄
요약
플로 매칭으로 음성을 합성하는 오픈소스 프로젝트다. pip 패키지와 명령줄 추론, Gradio 웹 화면을 제공한다. 코드는 MIT이지만 사전학습 가중치는 학습 데이터 때문에 비상업용으로 제한된다.
추천- 이름
- F5-TTS
- 버전
- 1.1.22
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsLinuxmacOS
- 업데이트
- 2026-10-06 20:44
F5-TTS는 한 편의 논문을 공식으로 구현한 것이다. 논문 제목은 장난스럽다. 플로 매칭으로 유창하고 충실한 음성을 흉내 내는 이야기꾼, 정도의 뜻이다. 이름은 가볍지만 기술 노선은 가볍지 않다. 합성은 플로 매칭으로 하고, 골격은 Diffusion Transformer에 ConvNeXt V2를 얹는다.
프로젝트는 오픈소스이고 스무 개가 넘는 버전을 이미 공개했으며, 저장소에는 기본 모델과 함께 추론, 학습, 배포를 위한 코드가 나란히 들어 있다.
세 가지 열쇠: 플로 매칭, ConvNeXt V2, Sway Sampling
공식 설명은 세 가지를 나란히 요점으로 세운다. 첫째는 F5-TTS 자체로, Diffusion Transformer에 ConvNeXt V2를 조합하며 공식 표현으로는 학습과 추론이 모두 빠르다. 둘째는 E2 TTS로, Flat-UNet Transformer 구조로 다시 만든 판이다. 셋째는 Sway Sampling으로, 추론 단계에서 플로의 걸음을 어떻게 뽑을지 정하는 전략이며 생성 품질을 뚜렷하게 끌어올린다고 공식은 말한다.
쓰는 사람 입장에서 앞의 둘은 모델이 낼 수 있는 상한을 정하고, 셋째는 같은 모델에서 무엇을 끌어낼지 정한다. Sway Sampling이 따로 한 줄을 받은 이유는 추론 시점에 바로 효력이 있고 다시 학습할 필요가 없기 때문일 것이다.
설치: pip 한 줄, 아니면 Docker로
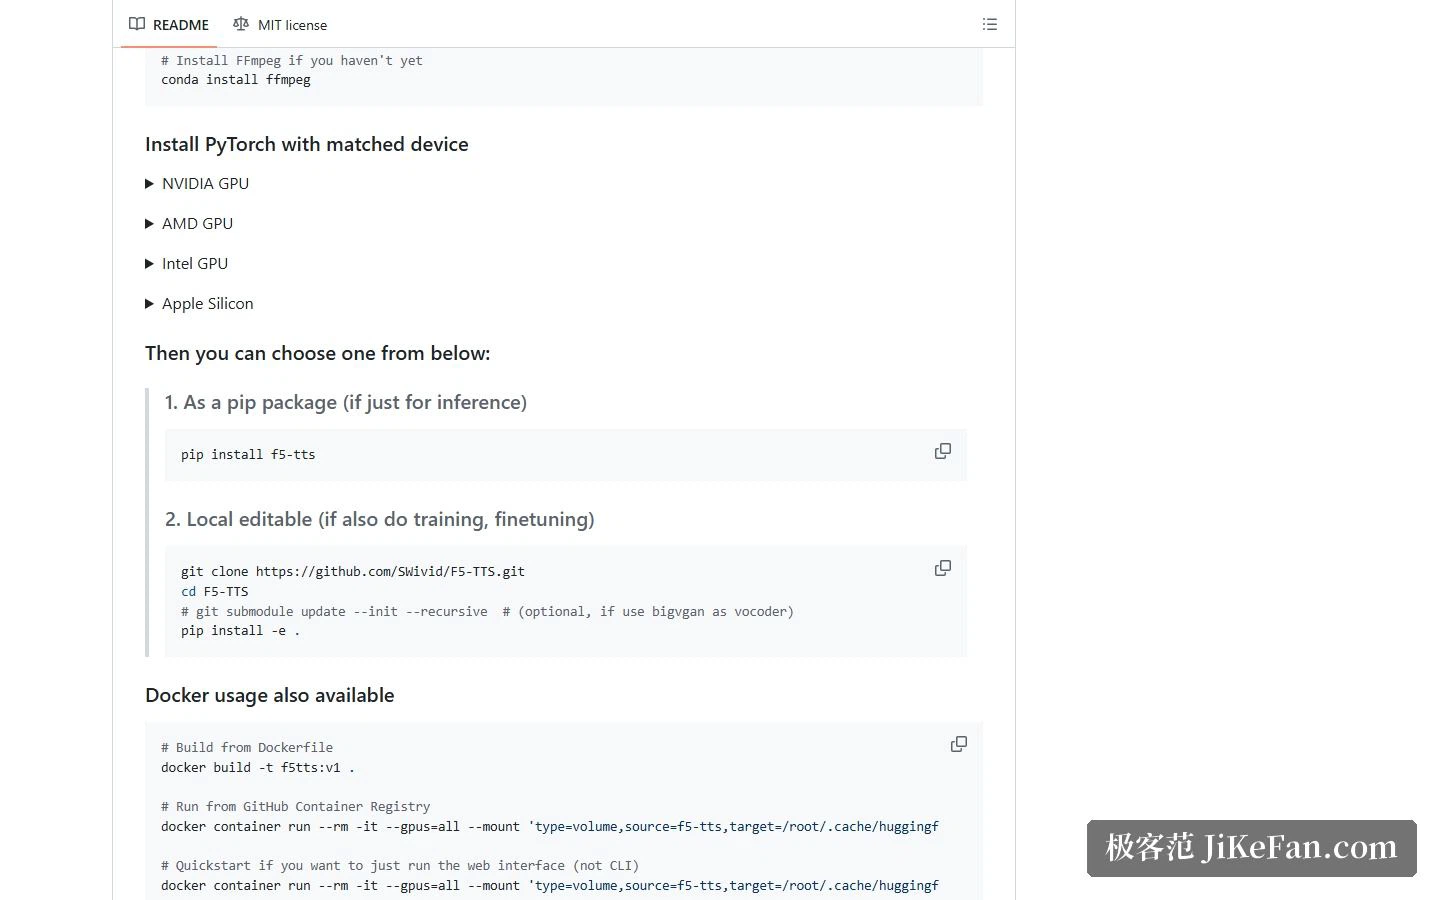
설치는 무엇을 하려는지에 따라 둘로 갈린다. 추론만 한다면 pip 패키지로 충분하다. 학습이나 미세조정까지 하려면 저장소를 복제해 편집 가능 설치를 한다. PyTorch를 넣기 전에 장치에 맞춰 버전을 골라야 하고, 공식은 NVIDIA, AMD, Intel, Apple Silicon 각각의 명령을 제시한다.
또 하나의 길이 Docker다. 저장소의 Dockerfile로 직접 빌드해도 되고 공식 이미지를 받아 돌려도 되며, 공식은 화면만 띄우는 짧은 명령까지 제공한다.
세 가지 사용법: 명령줄, 웹 화면, 음성 대화
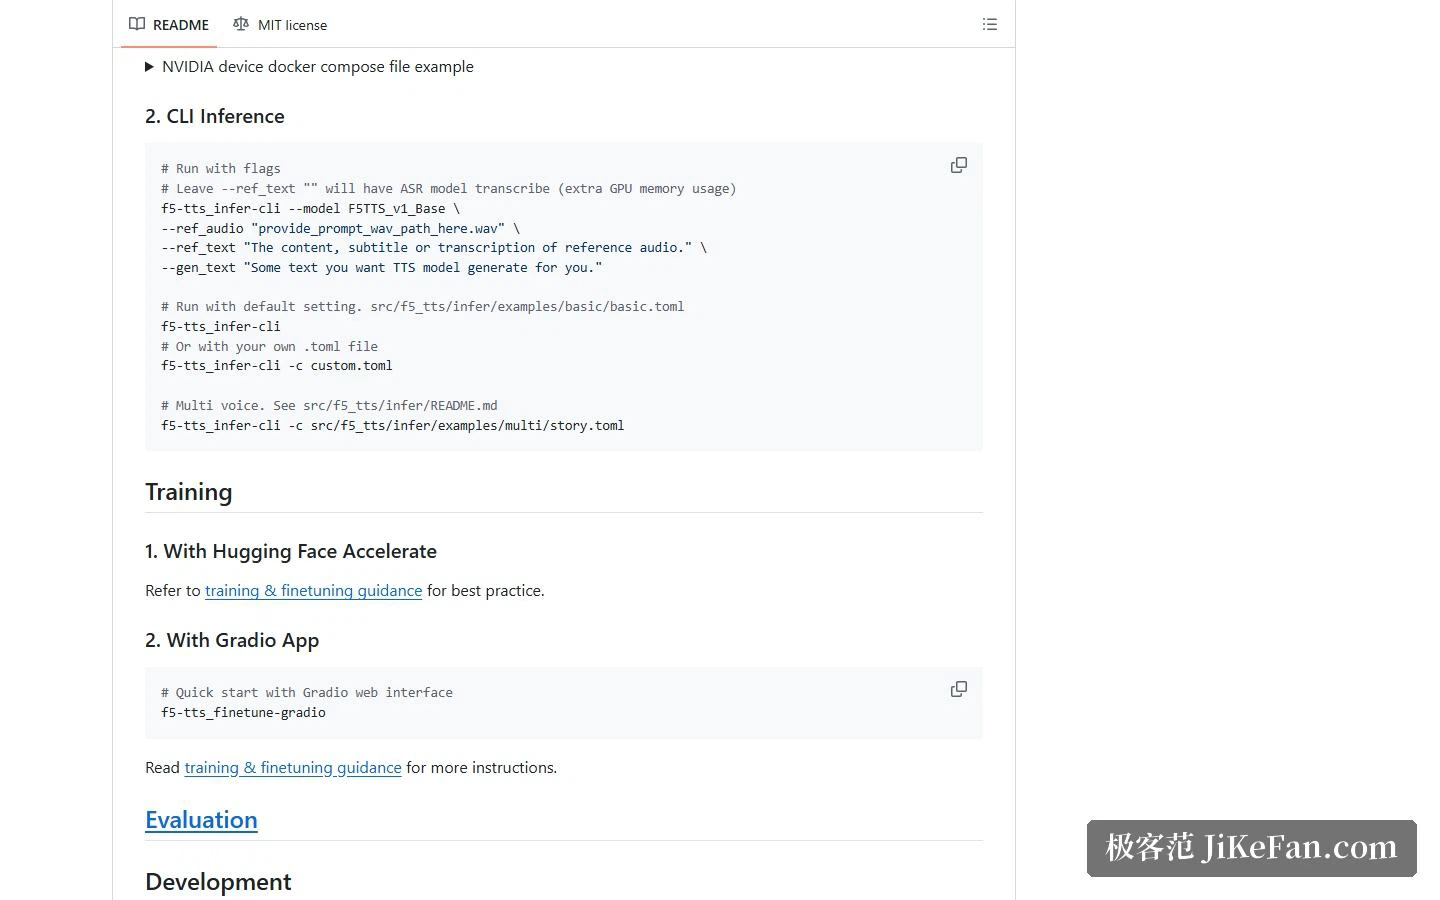
명령줄 인자는 이해하기 쉽다. 참조 음성 하나, 그 음성에 대응하는 텍스트 하나, 그리고 만들고 싶은 문장 하나를 주면, 모델이 참조 음성의 음색으로 목표 문장을 읽는다. 세부가 하나 있다. 참조 텍스트는 비워 둘 수 있고, 그러면 음성 인식 모델이 자동으로 받아쓴다. 대신 메모리를 조금 더 쓴다.
명령줄이 부담스럽다면 Gradio 화면을 띄우면 된다. 공식이 든 기능은 기본 합성을 넘어 여러 스타일과 여러 화자 생성, 그리고 30억 파라미터급 지시 조정 언어 모델이 이끄는 음성 대화까지 포함한다. 이 화면은 글자를 소리로 바꾸는 데 그치지 않고, 음성으로 한 차례 대화를 주고받을 수 있다.
성능 수치: L20 한 장에서 잰 결과
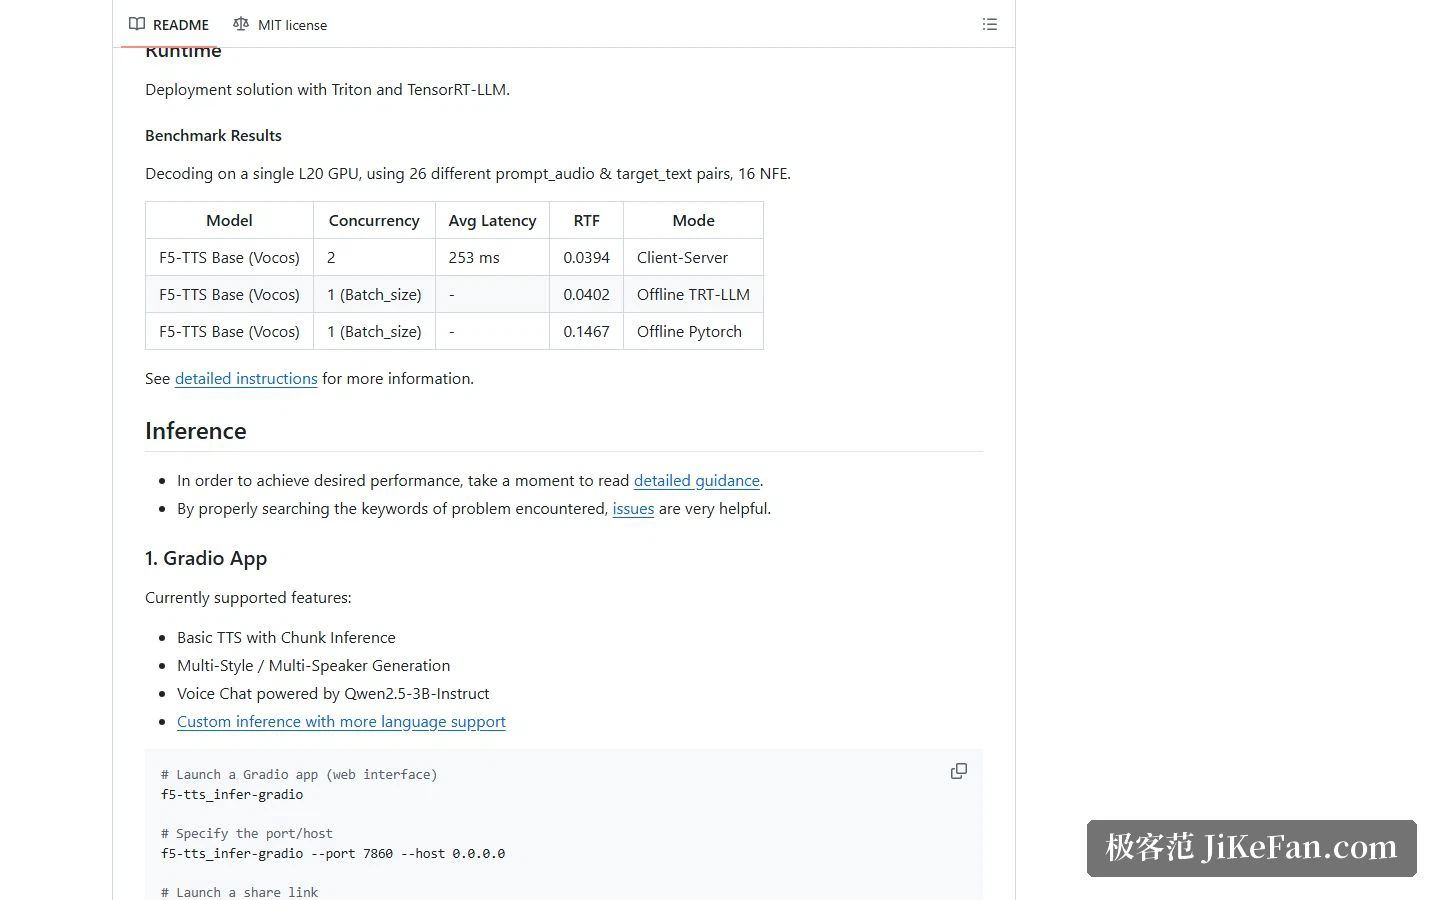
배포 절에 벤치마크가 있다. L20 카드 한 장, 참조 음성과 목표 텍스트의 짝 26가지, 추론 16스텝. F5-TTS Base는 동시 접속 2의 클라이언트-서버 방식에서 평균 지연 253밀리초, 실시간률 약 0.0394를 기록한다. 오프라인 TensorRT-LLM에서는 0.0402, 오프라인 PyTorch에서는 0.1467이다. 실시간률이 낮을수록 생성이 재생보다 얼마나 앞서 달리는지를 뜻하는 배수가 크고, 세 숫자의 벌어짐이 배포 방식의 차이를 그대로 보여 준다.
학습과 미세조정
학습도 같은 방식으로 두 갈래다. 하나는 Hugging Face Accelerate를 거치는 길로 일반적인 학습과 미세조정에 맞는다. 다른 하나는 Gradio 화면이고, 공식은 미세조정 전용 화면을 띄우는 명령을 제공해 코드 없이도 돌아가게 한다. 모델을 원하는 음색 쪽으로 휘고 싶은 사람에게는 두 번째 길이 훨씬 수월하다.
라이선스: 코드는 MIT, 모델은 비상업
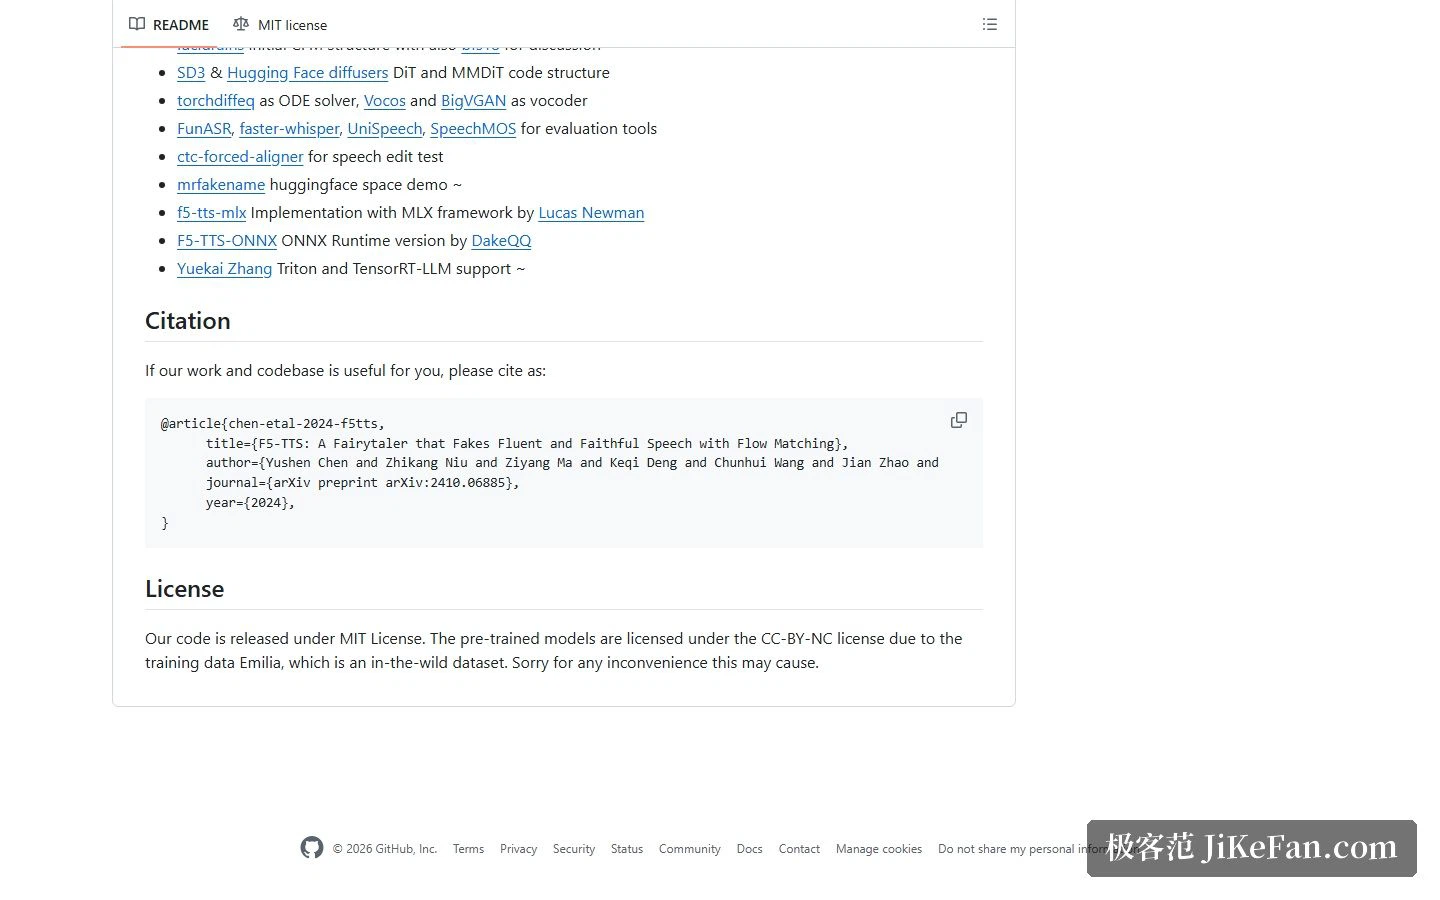
이 부분은 꼼꼼히 봐야 한다. 라이선스 절은 코드가 MIT로 공개된다고 밝히면서, 사전학습 모델의 허락은 다르다고 적는다. 학습 데이터가 야외에서 모은 것이라 사전학습 모델은 비상업용 Creative Commons 라이선스를 따른다. 공식은 같은 문단에서 그 점을 사과한다.
즉 코드 위에서 자유롭게 더 만들 수는 있지만, 공식 사전학습 모델을 그대로 상업 프로젝트에 넣으면 라이선스 벽에 부딪힌다. 이를 피하려면 보통 더 관대한 라이선스의 데이터셋으로 직접 학습해야 하고, 거기에 추가 연산과 데이터 준비가 든다.
누구에게 맞는가
연구자나 개발자로서 구조가 분명하고 개발이 활발한 오픈소스 음성 합성에서 실험하고 싶다면 코드 품질과 문서의 충실도가 나쁘지 않다. 설치 경로가 여러 개이고, 배포는 Triton과 TensorRT-LLM을 제시하며, 추론과 학습 모두 바로 쓸 입구가 있다.
반대로 그냥 상업적으로 쓸 수 있는 음성 합성 수단을 찾는다면, 먼저 라이선스 문제를 풀거나 직접 학습하는 비용을 따져야 한다. 어느 모델을 쓰든 목소리 복제의 허용 경계는 미리 확인해 두는 편이 좋다. 남의 목소리, 특히 공인의 목소리로 콘텐츠를 만드는 일은 인격권과 음성권에 닿을 수 있다.
오픈 프로젝트는 능력을 탁자 위에 올리고 제약은 라이선스 절에 적는다. 시작 전에 이 분을 읽는 편이, 나중에 다시 만드는 것보다 대개 싸게 끝난다.