
IndexTTS를 내 PC에서 돌린다, 감정과 말 속도 모두 파라미터로 조절
요약
내 PC에 설치해 실행하는 제로샷 음성 합성이다. 참조 음성 한 개면 목소리를 복제하고, 감정과 말 속도, 발음을 모두 파라미터로 조정한다. 가중치는 일반 오픈소스 라이선스가 아니라 프로젝트 자체 라이선스를 따른다.
추천- 이름
- IndexTTS
- 버전
- 2.5
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsLinux
- 업데이트
- 2026-10-06 20:19
저장소 제목이 곧 사양서다
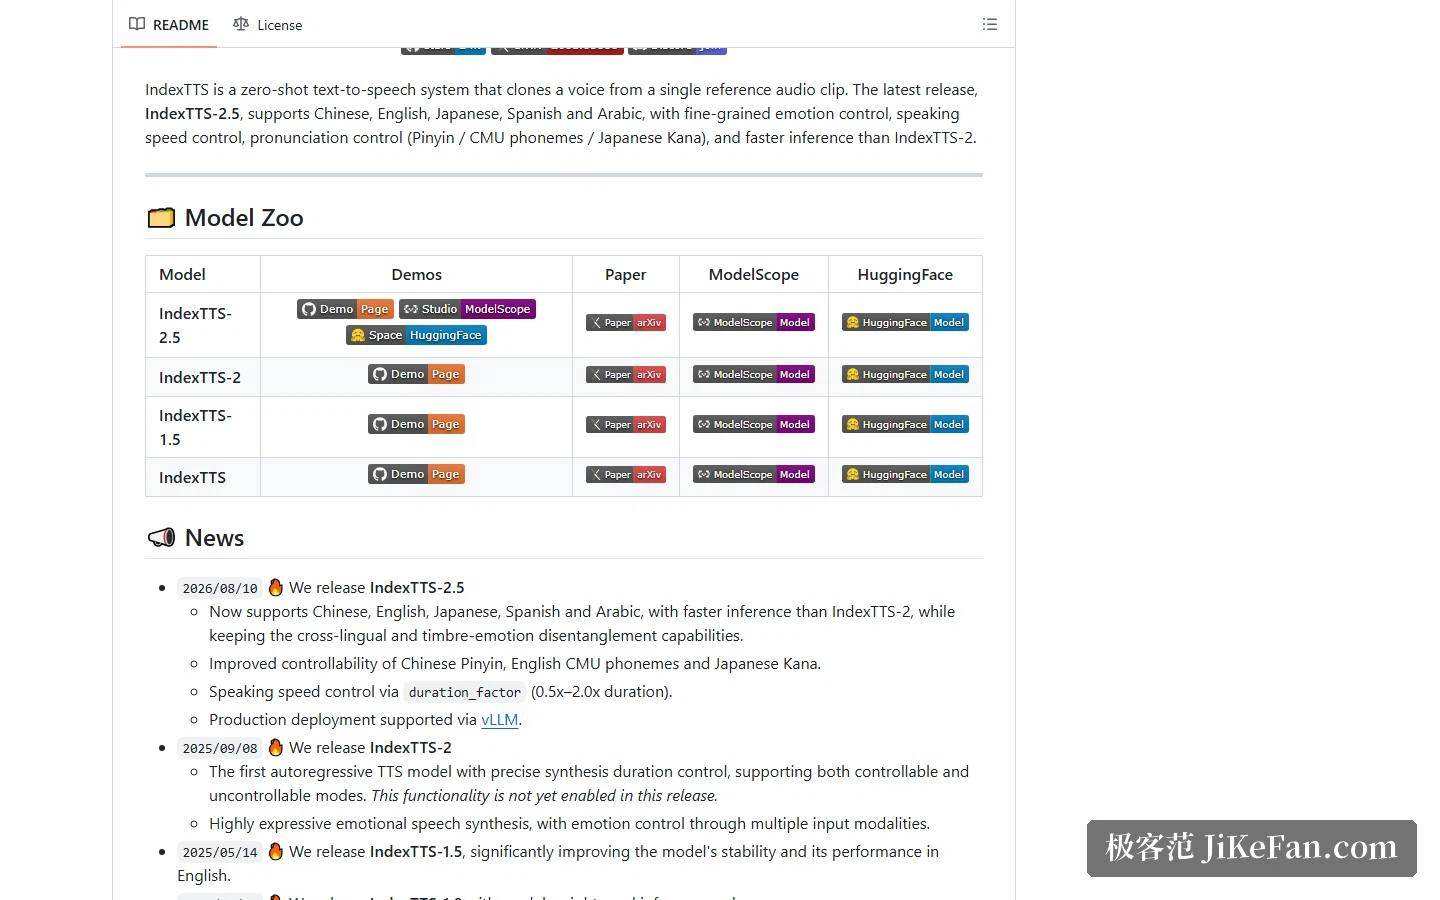
IndexTTS는 저장소 첫 줄에서 자기 자리를 밝힌다. 산업 등급이고, 제어할 수 있고, 효율적인 제로샷 음성 합성이다. 형용사 셋은 세 가지 약속에 대응한다. 실제 서비스의 부하를 감당한다, 동작을 조정할 수 있다, 쓸 만한 속도로 돈다. 목소리를 복제하는 입구도 그만큼 노골적이다. 참조 음성 한 개를 건네면 되고, 그 사이에 학습 단계는 없다.
현재 최신 판은 IndexTTS-2.5다. 중국어, 영어, 일본어, 스페인어, 아랍어 다섯 가지를 다루고, 추론은 이전 세대인 IndexTTS-2보다 빠르다고 설명한다. 언어를 넘는 능력과, 앞선 판이 세운 음색과 감정의 분리는 그대로 유지된다.
네 번의 판, 하나의 계보
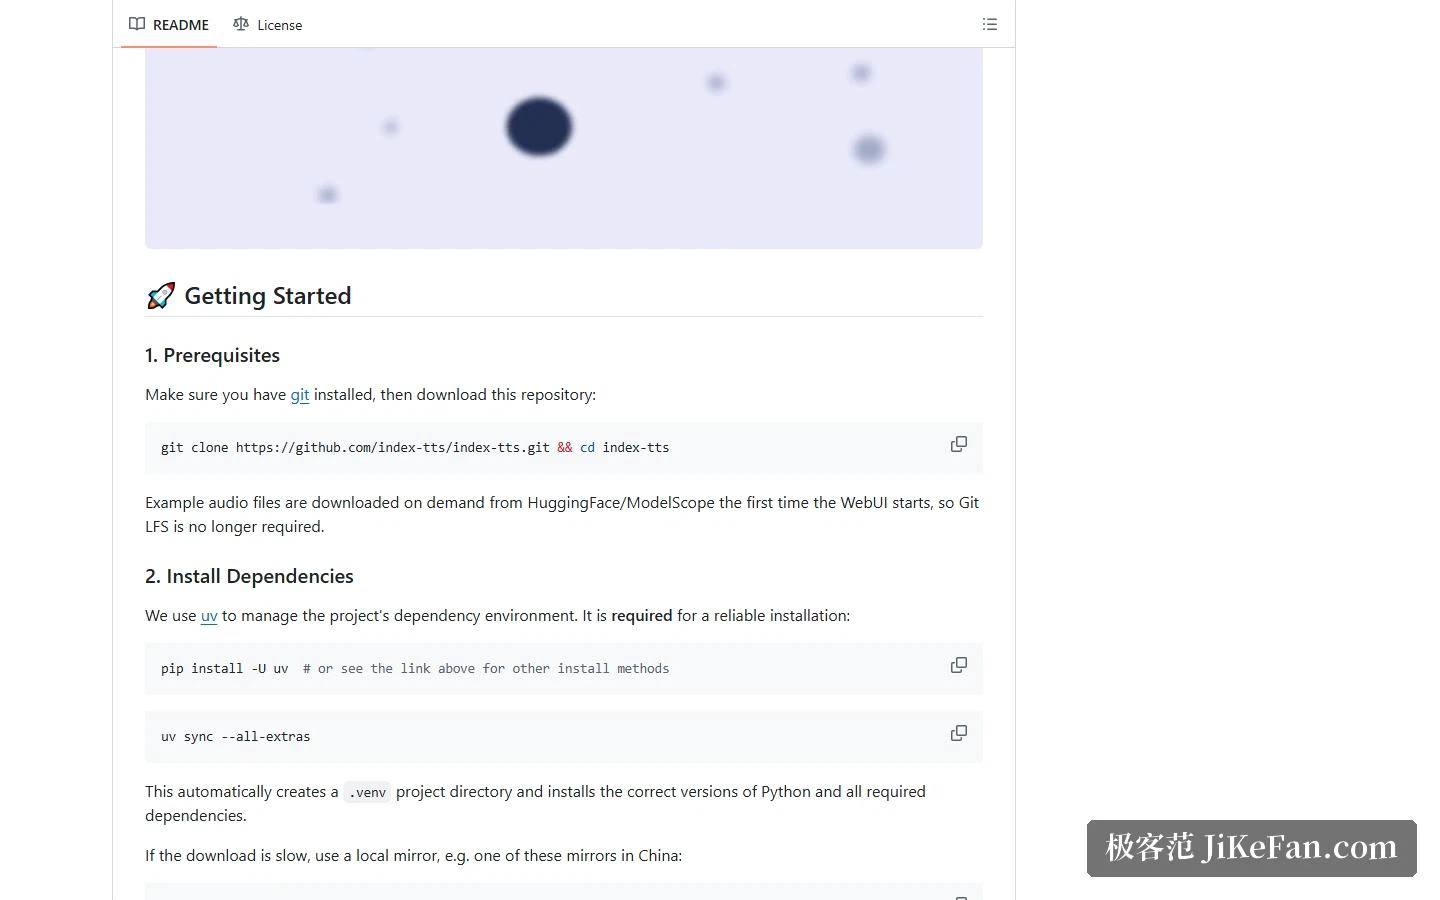
변경 기록은 꾸밈없이 흐름을 말한다. 처음은 기본판 IndexTTS였다. 1.5판은 안정성과 영어 출력에 무게를 두었다. 2판은 이 계열에서 처음으로 합성 길이를 정확히 제어하는 자기회귀 음성 모델이었지만, 같은 설명에서 그 기능이 당시 공개에서는 켜지지 않았다고 밝힌다. 2.5판에서 언어가 다섯으로 늘고, 병음과 음소의 발음 제어가 나아졌으며, 말 속도 제어와 vLLM 운용 경로가 더해졌다.
네 판은 모델 목록에 나란히 놓여 있고, 각각 시연과 논문, 가중치 내려받기 지점이 붙어 있다. 무엇을 고를지는 내 용도에 어떤 능력이 필요한지로 정해진다. 숫자가 큰 쪽을 고르는 문제가 아니다.
세 개의 조정 축
여기가 IndexTTS가 가장 또렷한 지점이다. 감정 하나만 봐도 지정하는 방법이 세 가지다. 감정 참조 음성을 따로 주고 그 세기를 emo_alpha로 조절할 수 있다. 값은 0에서 1까지이고 기본은 최대다. 대신 길이 여덟의 부동소수점 배열을 줄 수도 있으며, 순서는 기쁨, 분노, 슬픔, 두려움, 혐오, 우울, 놀람, 평온으로 고정된다. 문장으로 감정을 설명하는 방법도 있다.
말 속도는 duration_factor로 다룬다. 받는 값은 절반에서 두 배까지이고 기본은 원래 속도다. 기본보다 크면 느려지고 작으면 빨라진다. 영상에 목소리를 입힐 때 값어치를 한다. 화면 길이는 정해져 있고 목소리를 그 안에 넣어야 하기 때문이다.
발음이 세 번째 축이고, 대상은 세 가지 표기다. 중국어 병음, 영어 CMU 음소, 일본어 가나다. 읽는 방법이 여럿인 글자나 외래 고유명사가 잘못 읽힐 때, 다시 녹음하지 않고 손으로 고칠 수 있다.
4090 한 장에서의 실시간률
공개된 기준 측정은 4090 한 장에서 KV 캐시를 켜고 돌렸다. IndexTTS-2.5의 실시간률은 bf16에서 0.2065, fp32에서 0.2060이다. 비교 대상으로 IndexTTS-2.0은 fp16에서 0.3257, fp32에서 0.3748이었다. 이 숫자는 작을수록 좋다. 생성이 재생 속도에 비해 얼마나 여유를 남기는지를 뜻하므로, 두 세대의 효율 차이가 숫자에서 바로 읽힌다.
의존성은 uv에 맡긴다
권장 설치 방식은 조금 특이하다. 먼저 pip으로 uv를 설치하고, 그 uv로 프로젝트 전체를 동기화한다. uv가 가상 환경을 스스로 만들고 파이썬 판과 의존 패키지 판을 함께 고정하기 때문이며, 설명서는 이 점을 확실한 설치의 전제라고 부른다. 같은 문서가 환경을 손으로 활성화하지 말라고 못 박는다. 의존 충돌이 대개 거기서 시작된다.
설치할 때 구성 요소를 골라 넣을 수 있다. 브라우저 화면이 필요하면 webui 항목을, 가속이 필요하면 DeepSpeed 항목을 더한다. 주의가 두 개 붙는다. DeepSpeed는 윈도우에서 빌드가 까다로울 수 있고, 그럴 때는 한 번에 전부 넣는 지정을 빼고 손으로 고른다. 또 하나는 설치 도중 CUDA 오류가 나오면 CUDA 툴킷이 12.8 이상인지 확인하라는 것이다.
가중치, 그래픽 확인, 첫 실행
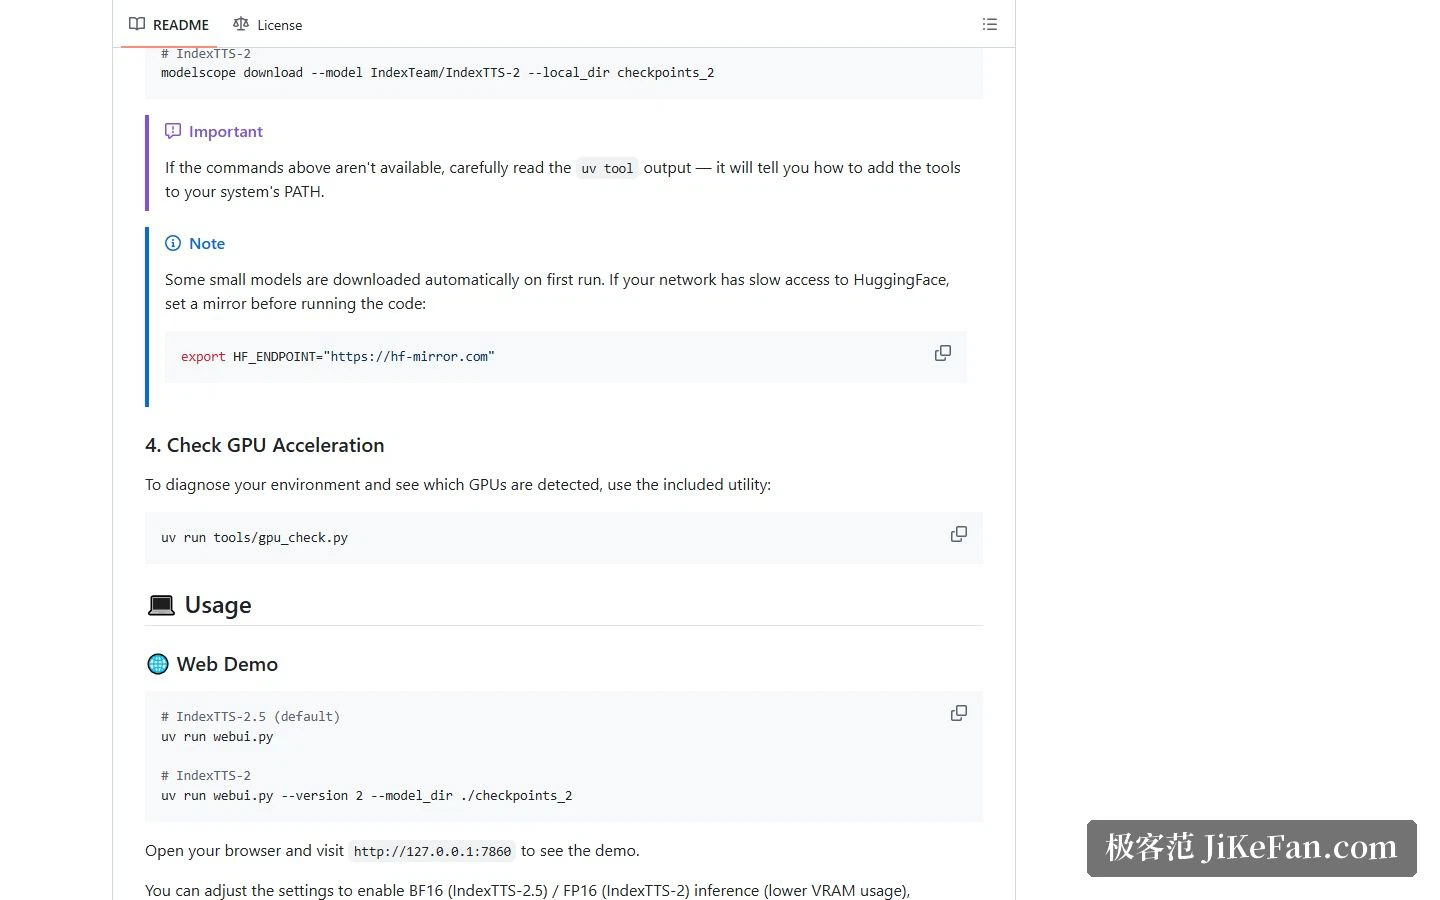
가중치는 따로 받는다. HuggingFace나 ModelScope에서 가져와 로컬 디렉터리에 넣으면 프로그램이 읽는다. 예시 음성은 화면을 처음 띄울 때 필요에 따라 내려받으므로 Git LFS가 더는 필요 없다. 회선이 좋지 않은 사람에게는 관문이 하나 줄어드는 셈이다.
실행 전에 그래픽 감지 스크립트를 한 번 돌려, 환경이 어떤 GPU를 인식하는지 확인한다. 그다음 화면을 띄우고 브라우저로 로컬 페이지를 열면 써 볼 수 있다. 반정밀도 추론은 그 페이지에서 전환할 수 있고, BF16이나 FP16이 더 빠르고 쓰는 그래픽 메모리도 적으며 품질 손실은 아주 작다고 설명한다.
라이선스는 따로 봐야 하는 부분
소스는 공개되어 있지만 라이선스는 흔한 MIT도 Apache도 아니다. bilibili 모델 사용 허가이며, 저장소에 중국어판과 영어판 두 벌이 들어 있다. 실무적 의미는 쓸 수 있는 범위가 이 문서로 정해진다는 것이다. 범용 오픈소스 허가로 정해지지 않는다. 상업적 사용이나 재배포를 계획한다면 먼저 읽고, 내 쓰임이 허용 범위 안에 있는지 확인하는 편이 좋다.
어떤 사람에게 맞나
합성한 목소리를 실제 제품에 넣고, 게다가 조정하고 싶다는 요구라면 여기의 제어 밀도는 높다. 감정은 배열로도 문장으로도 지정되고, 말 속도는 정확히 늘였다 줄였다 할 수 있고, 발음은 글자 단위로 고칠 수 있으며, vLLM으로 돌리는 경로까지 있다. 장난감 프로젝트에 붙는 구성 목록이 아니다.
진입 장벽도 실제로 있다. NVIDIA 그래픽 카드가 필요하고, CUDA 툴킷 12.8 이상이 필요하고, 의존성 설치는 uv라는 도구 묶음을 거쳐야 한다. 덧붙여, 목소리를 복제하는 도구에 공통된 이야기지만, 남의 목소리로 무엇을 만들면 동의 문제가 따라온다. 공인이라면 더욱 그렇다. 말 속도와 감정을 잘게 흔들 수 있을수록, 어디에 쓰는 것이 맞는지 스스로 알고 있어야 한다.
제어를 잘게 만드는 대가는 복잡도다. 파라미터가 늘어날수록 결과의 좋고 나쁨을 가르는 것은 모델의 능력이 아니라, 내용 자체를 얼마나 이해하고 있는가가 된다.