
Whisper는 여섯 크기로 나오고, 고르는 기준은 그래픽 메모리다
요약
받아쓰기와 영어 번역, 언어 판별을 한 번에 처리하는 범용 음성 인식 모델이다. 크기는 약 3900만에서 약 15.5억 파라미터까지 여섯 가지이고, 코드와 가중치 모두 MIT 라이선스다.
추천- 이름
- Whisper
- 버전
- 15.5
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsLinuxmacOS
- 업데이트
- 2026-10-06 16:03
하나의 모델이 파이프라인을 대신한다
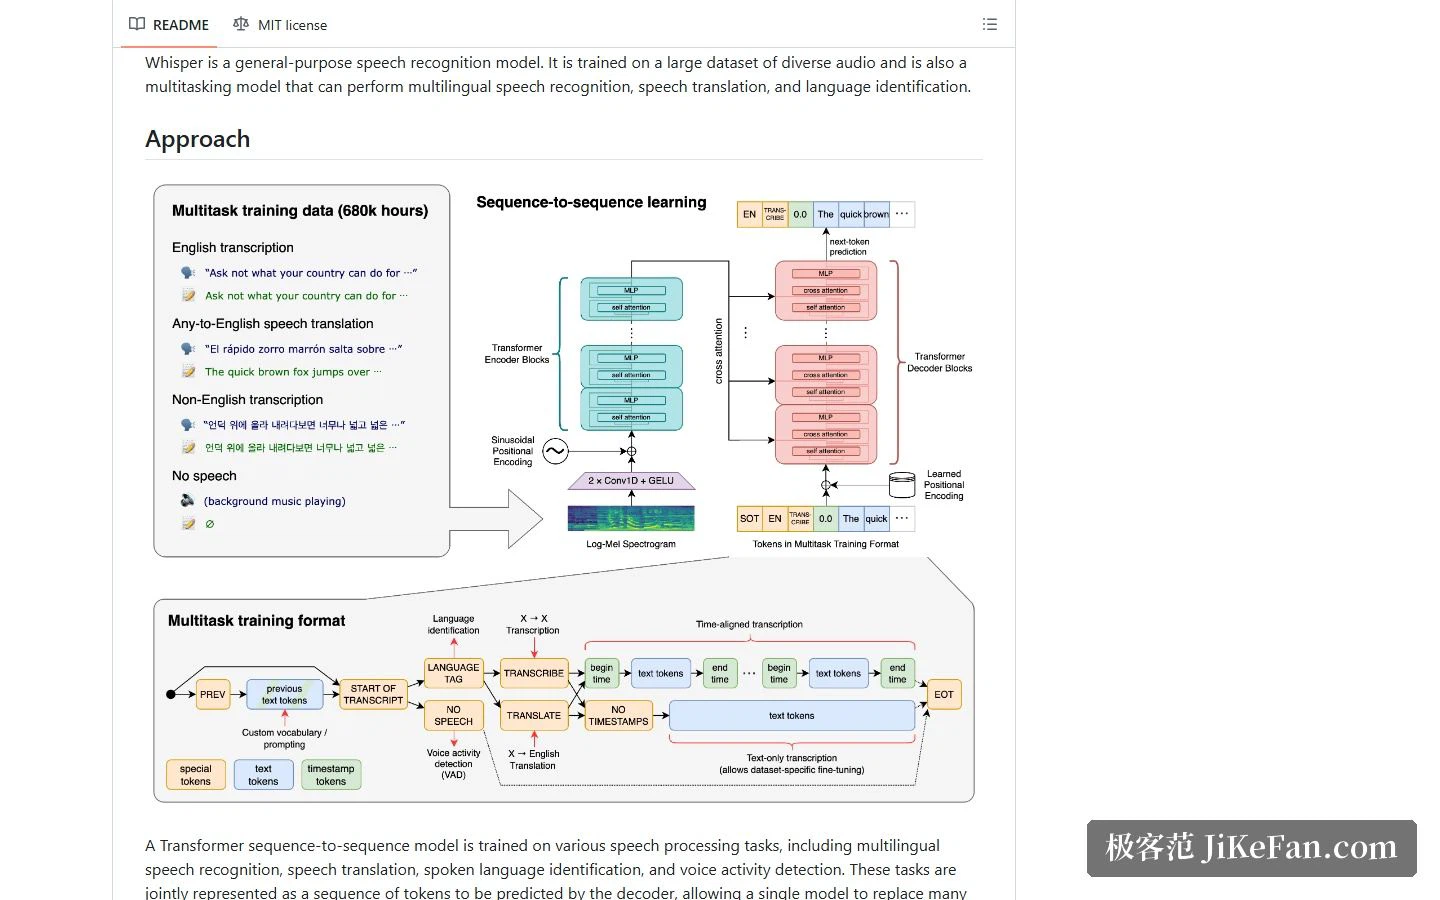
Whisper는 여러 단계를 하나의 모델로 바꿔 놓는 부류의 프로젝트다. 전통적인 음성 처리는 단계를 여러 번 밟는다. 먼저 언어를 가리고, 다음에 받아쓰고, 번역이 필요하면 별도의 번역 모델을 뒤에 붙이며, 음성 활동 감지는 또 따로 한 단계로 옆에 놓인다. Whisper는 이런 작업을 디코더가 예측하는 하나의 토큰 열로 묶고, 하나의 인코더·디코더 트랜스포머 안에서 함께 학습한다.
저장소가 밝히는 다중 과제 학습 데이터는 68만 시간이고, 여러 언어와 다양한 녹음 조건에서 모였다. 내건 목표는 간단하다. 범용 음성 인식 모델, 그뿐이다.
네 가지 능력, 번역은 한 방향
공식 목록은 네 항목이다. 다국어 받아쓰기, 음성 번역, 말소리의 언어 판별, 음성 활동 감지. 여기서 번역은 영어가 아닌 음성을 곧바로 영어 텍스트로 바꾸는 일을 뜻한다. 임의의 두 언어를 서로 옮기는 것이 아니다. 흐름을 짜기 전에 이 차이를 짚고 가야 한다. 한 방향이라는 점을 알고 설계에 들어가야 하는 대목이다.
긴 녹음은 30초 창으로 나눈다
긴 음성은 미끄러지는 창으로 다룬다. 설명에 따르면 받아쓰기 호출은 파일 전체를 읽고, 30초를 한 창으로 삼아 구간마다 자기회귀 방식으로 예측한다. 한 시간짜리 녹음이면 백 개가 넘는 창이 연달아 처리되며, 직접 잘라서 넘길 필요가 없다.
여섯 크기를 어떻게 고를까
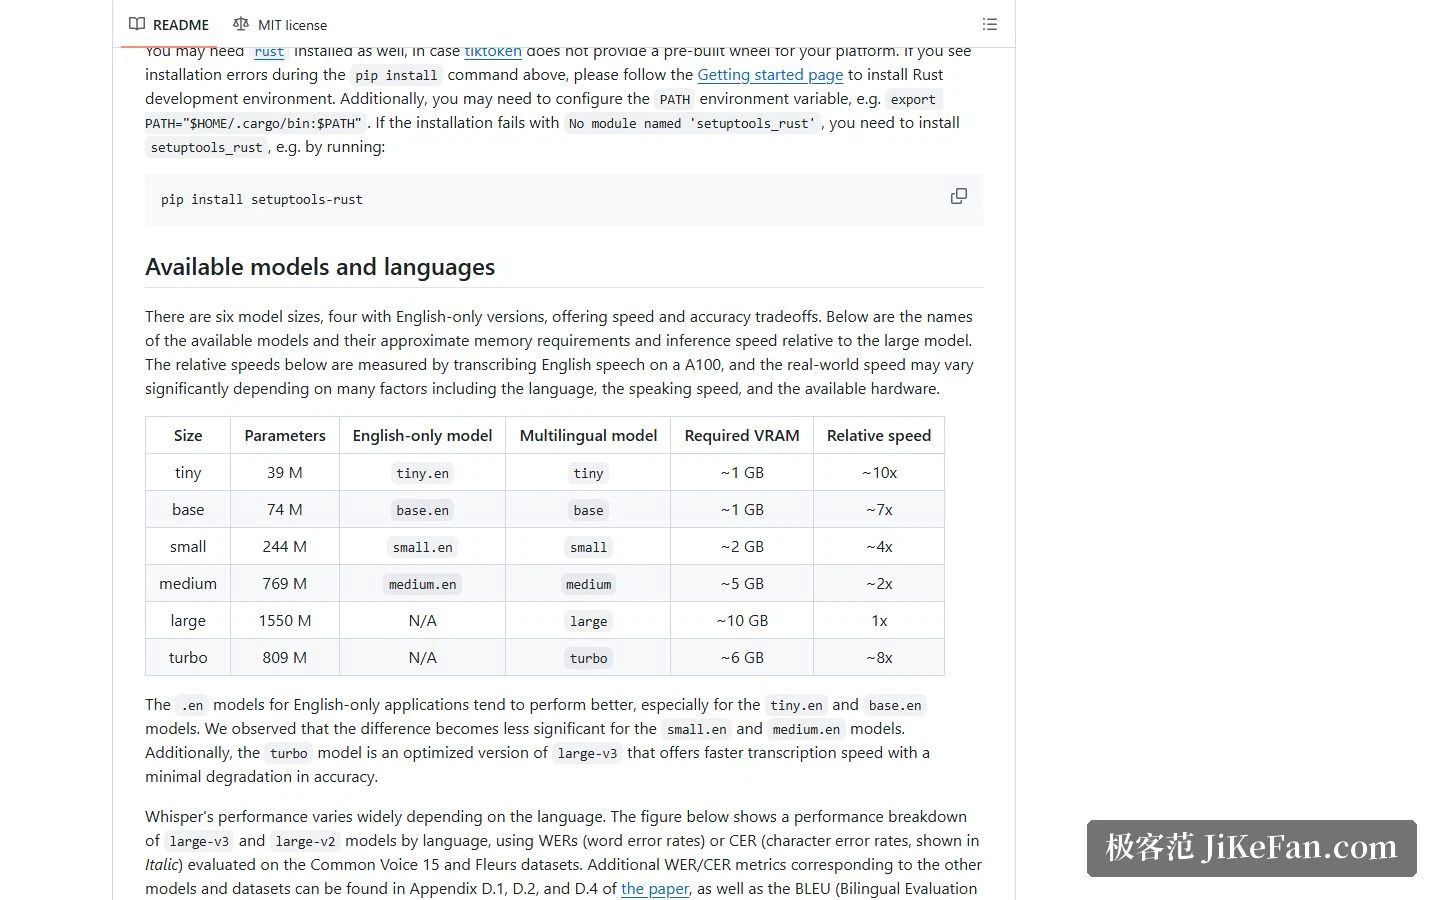
가장 먼저 봐야 할 표다. 크기는 여섯이고, 파라미터는 tiny의 약 3900만에서 large의 약 15.5억까지, 필요한 그래픽 메모리는 약 1GB에서 약 10GB까지 올라간다. 상대 속도 열은 large를 기준으로 삼아 tiny가 대략 10배, turbo가 대략 8배다. 속도와 크기는 거의 매끄러운 맞바꿈 곡선을 그린다.
메모리가 빠듯하면 tiny와 base가 모두 약 1GB에 들어간다. 평범한 노트북에서도 무리는 아니다. 정확도를 올리려면 medium과 large로 간다. 가운데 turbo는 따로 짚을 만하다. large-v3의 최적화 판이라고 설명되며, 아주 작은 정확도 손실을 대가로 받아쓰기를 확실히 빠르게 만든다. 절충안이라는 자리다.
또 tiny, base, small, medium 네 크기에는 영어 전용 판도 있다. 영어만 다루는 작업에서는 이런 판이 더 나은 경우가 많다고 공식은 본다. 다만 파라미터가 커질수록 그 차이는 눈에 덜 띈다.
설치는 pip와 ffmpeg 하나
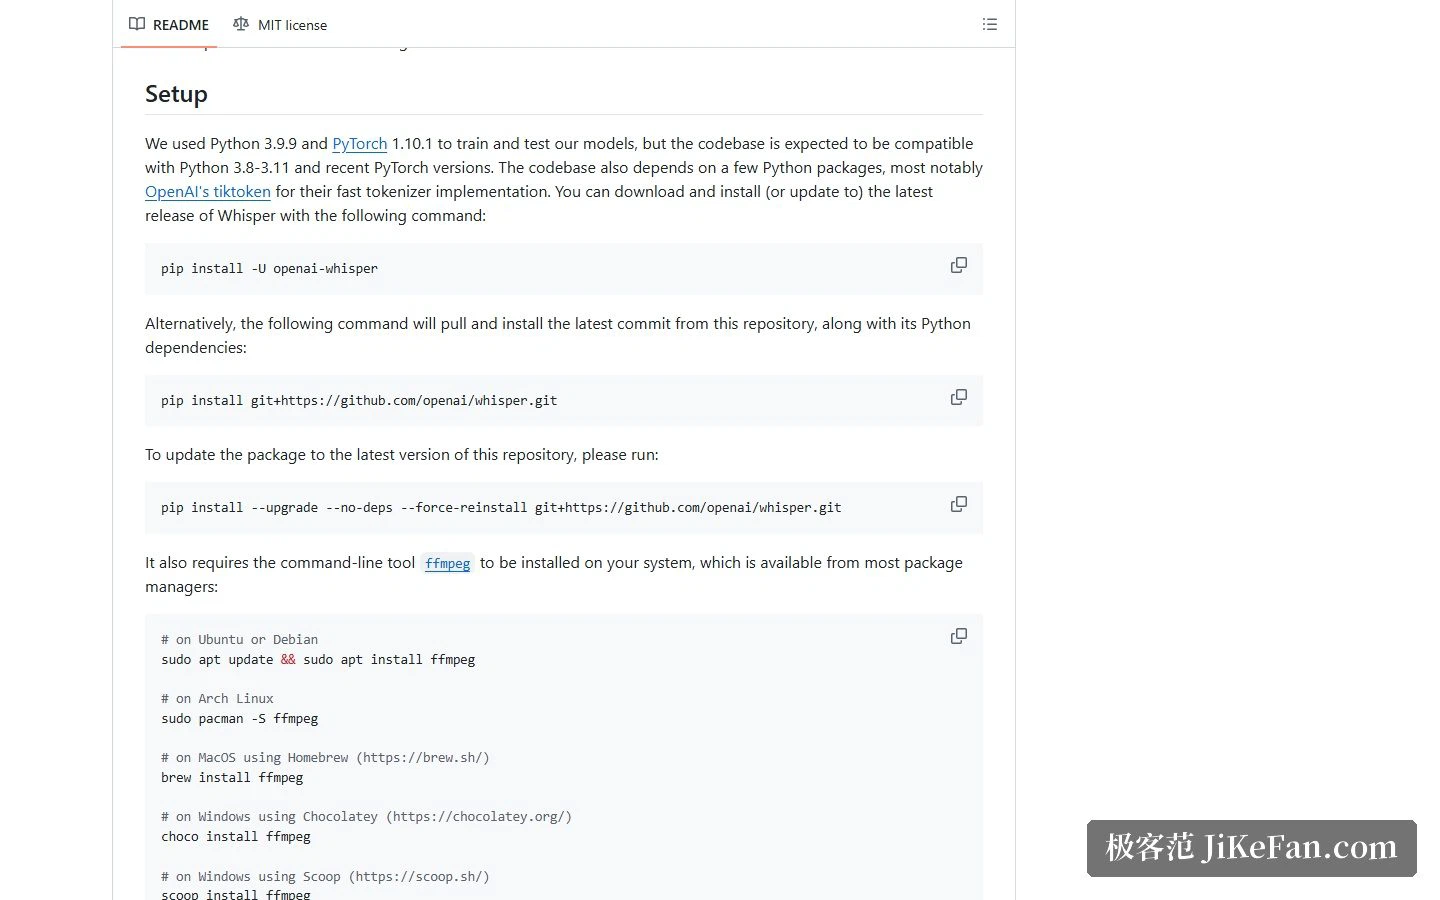
설치 자체는 pip 한 줄이면 된다. 정말 신경 쓸 것은 시스템 의존성이다. Whisper는 음성을 푸는 데 ffmpeg라는 명령줄 도구를 부른다. 공식은 운영체제별 설치 방법을 늘어놓았고, 흔히 쓰는 패키지 관리자는 대체로 다뤄져 있다.
한 가지 더. 플랫폼에 미리 빌드된 토크나이저 패키지가 없으면 pip 과정에 Rust 환경이 필요하다고 공식은 알린다. 모듈을 찾을 수 없다는 오류가 나오면 맞는 패키지를 더하면 해결된다. 버전은 파이썬 3.8부터 3.11까지, 그리고 비교적 최신 PyTorch를 지원한다.
두 개의 입구, 명령줄과 파이썬
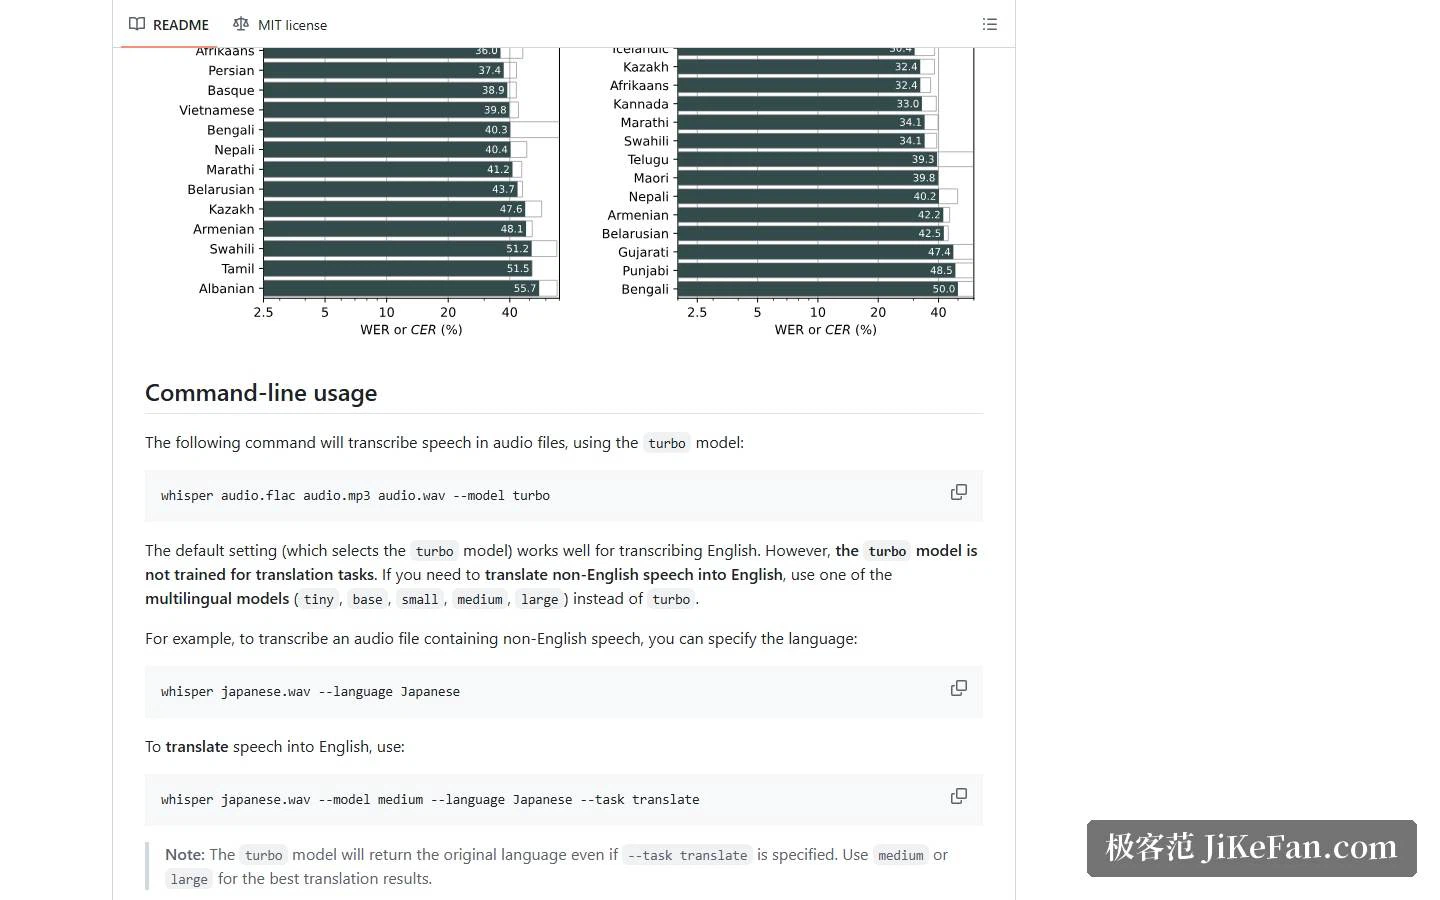
명령줄이 가장 빠른 확인 방법이다. 음성 파일을 인수로 두고, 모델 지정으로 크기를 고르고, 영어가 아닌 음성이면 언어 지정을 더하고, 번역하려면 작업 지정을 바꾼다.
기억해 둘 제약이 있다. turbo는 번역용으로 학습된 적이 없다고 공식이 분명히 말한다. 번역을 지정해도 원래 언어의 내용이 돌아온다. 번역을 쓰려면 tiny, base, small, medium, large 같은 다국어 모델로 돌아가야 하고, 공식은 번역에서 medium이나 large가 더 낫다고 권한다.
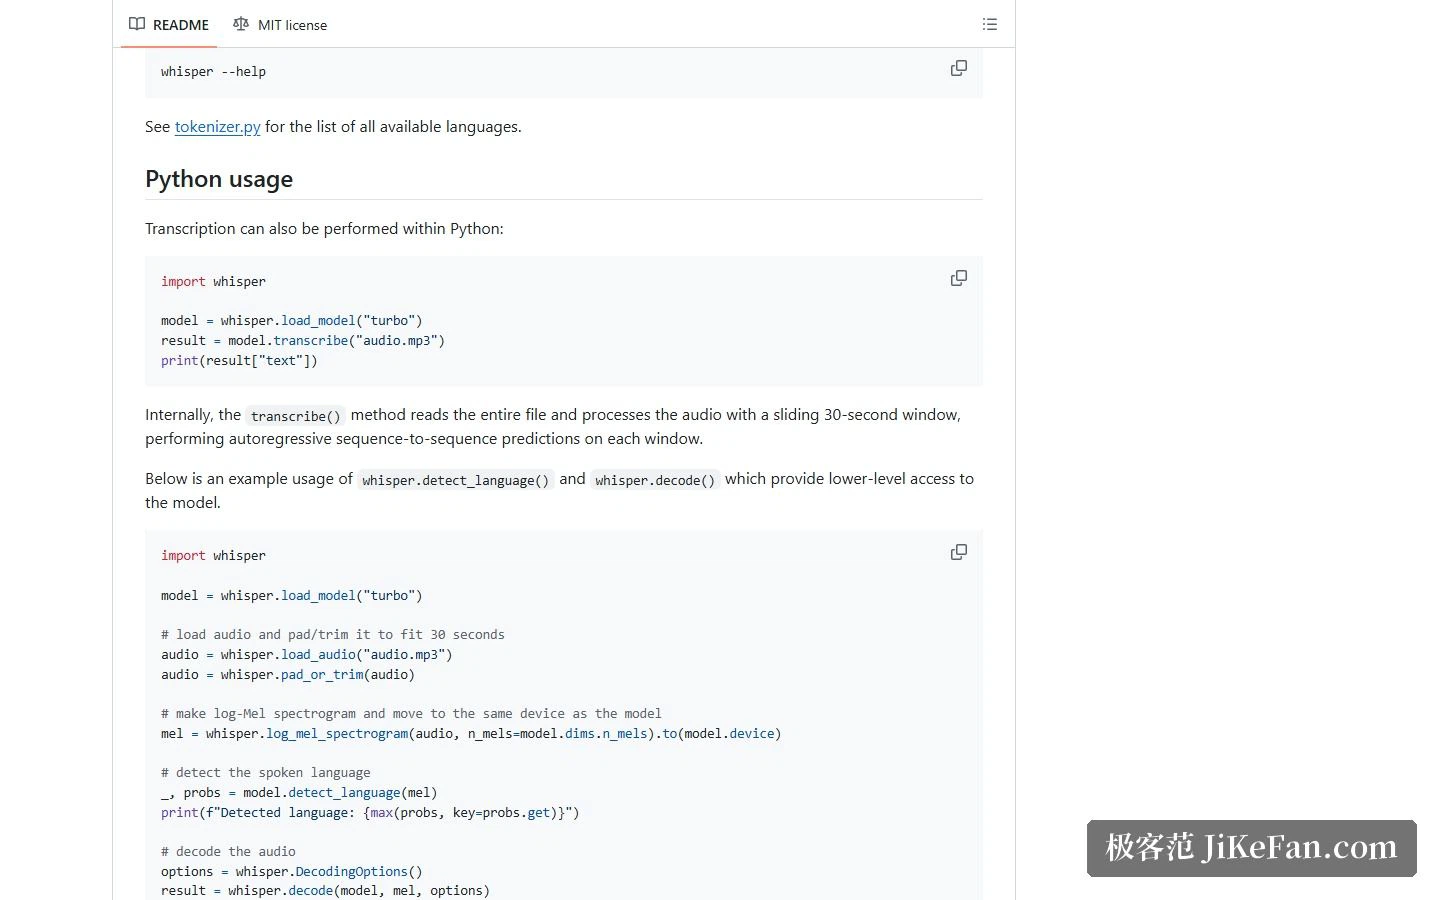
파이썬에서의 호출도 짧다. 모델을 읽고, 음성 경로를 받아쓰기 메서드에 넘기고, 결과에서 텍스트 항목을 꺼낸다. 세 손이면 된다. 더 낮은 층의 인터페이스도 열려 있어, 음성을 직접 읽고, 로그 멜 스펙트로그램을 계산하고, 언어 판별이나 디코딩을 따로 부를 수 있다. 더 복잡한 처리에 끼워 넣을 때 유용하다.
라이선스는 확실한 이점이다
코드와 모델 가중치가 모두 MIT 라이선스로 나오고 상업적 제한은 거의 없다. 음성 인식 분야에서 흔한 일은 아니다. 많은 모델이 가중치에 별도의 더 엄격한 조건을 붙인다. 음성 인식을 자기 제품에 넣으려면 이 한 가지로 법무와 주고받을 일이 꽤 줄어든다.
어떤 사람에게 맞나
영상에 자막을 한꺼번에 달고 싶다, 회의 녹음을 글로 정리하고 싶다, 자기 앱에 로컬 받아쓰기를 더하고 싶다. 그런 요구라면 진입 문턱이 낮다. 설치에 한 줄, 실행에 한 줄, 여섯 크기는 작은 쪽부터 시험하고 부족하면 올리면 된다. MIT 라이선스가 있으니 연동이 돌아간 뒤에 서류 이야기가 다시 돌아오지도 않는다.
만능은 아니다. 번역은 영어로 향하는 한 방향뿐이다. 실시간성이 필요한 상황이라면 내 하드웨어가 따라오는지부터 따져야 한다. 시끄러운 곳에서의 정확도는 녹음 품질을 그대로 따른다. 오프라인 받아쓰기 도구로 본다면 기대는 잘 어긋나지 않는다.
코드가 열려 있고 허가가 느슨하다는 점이 많은 프로젝트가 Whisper를 기본값으로 삼는 이유다. 도구 자체의 문턱은 이미 낮다. 남는 차이는 대개 건네는 음성이 얼마나 깨끗한가에 있다.