
낱말 단위 시각과 화자 표시까지 붙이는 WhisperX의 두 단계
요약
Whisper의 두 구멍을 메우는 흐름이다. 시각은 문장 단위에서 멈추고 묶음 처리 수단도 없다. WhisperX는 강제 정렬로 낱말 시각까지 좁히고 화자도 구분하며, large-v2에서 실시간의 70배라고 내건다.
추천- 이름
- WhisperX
- 버전
- 3.8.7
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsLinuxmacOS
- 업데이트
- 2026-10-06 19:53
Whisper가 빠뜨린 두 가지
WhisperX는 아주 구체적인 불만에서 나왔다. Whisper의 받아쓰기는 정확하지만 시각은 문장 단위에서 멈춘다. 자막을 만들면 글자와 화면이 어긋나는 것을 곧 알게 되고, 몇 초 차이는 일상이다. 게다가 Whisper 자체에는 묶음 처리 수단이 없다.
고치는 방법은 Whisper 바깥에 두 단계를 더하는 것이었다. 먼저 받아쓴 결과를 음성에 강제로 맞춰 시각을 낱말 하나하나까지 좁힌다. 다음에 음성을 화자별로 나누고, 각 대사가 누구의 것인지 표시한다. 공식은 이것을 하나의 흐름으로 묶고 명령줄과 파이썬 두 가지 입구를 내놓는다.
네 단계로 된 흐름
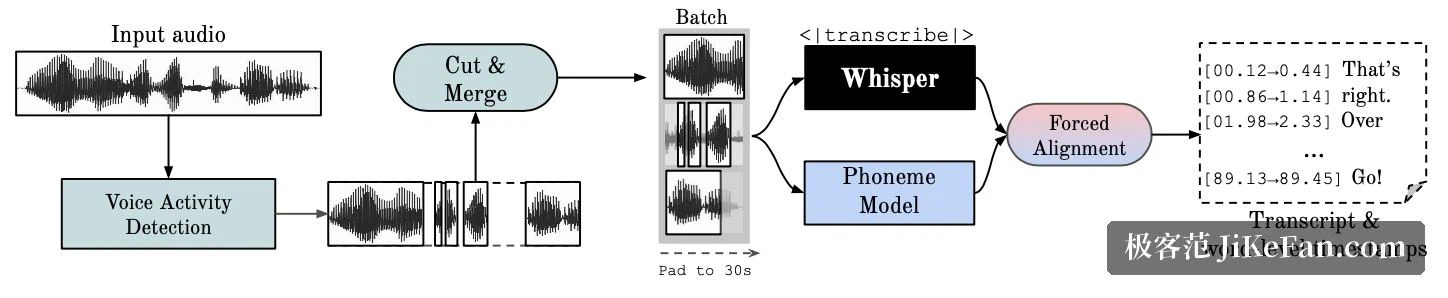
저장소의 그림은 과정을 네 단계로 나눈다. 먼저 음성 활동 감지로 무음 구간을 걸러 낸다. 다음에 받아쓰기 모델이 묶음으로 글자를 낸다. 이어 음소 단위로 인식하는 모델이 강제 정렬을 해서 낱말별 시각을 얻는다. 마지막으로 화자 분리 모델이 목소리를 가른다.
핵심 수치는 공식 설명에 늘어서 있다. large-v2에서 묶음 추론은 실시간의 70배에 이른다. 받아쓰기 토대는 faster-whisper이고, large-v2는 beam size를 5로 둔 설정에서 그래픽 메모리가 8GB 미만이면 된다. 낱말별 시각은 wav2vec2 강제 정렬에서 나온다. 화자 분리는 pyannote-audio가 맡고, 나오는 것은 화자 식별자다. 이 흐름의 논문은 INTERSPEECH 2023에서 발표되었고, 긴 음성을 시각에 맞춰 받아쓰는 것을 주제로 내걸었다.
앞단의 음성 활동 감지에는 짚고 갈 부수 효과가 있다. 환각을 줄이면서 인식 정확도는 잃지 않고, 묶음 처리를 하기 쉬워진다고 하며, 이것이 속도를 끌어올린 전제 가운데 하나다.
설치는 pip 한 줄
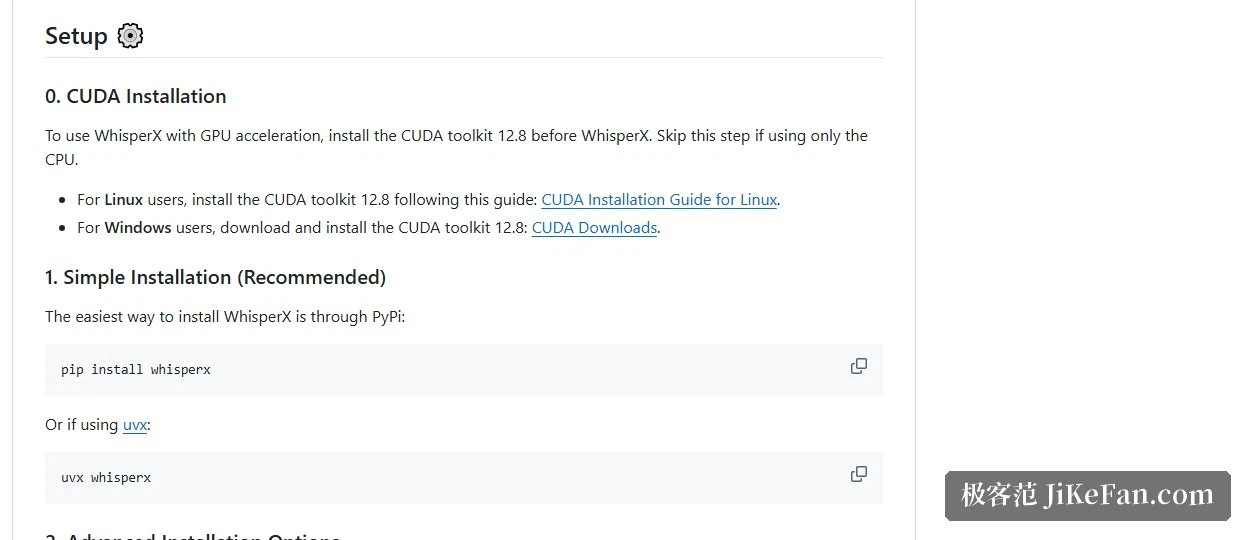
권장 설치는 짧다. pip 한 줄이면 된다. uv가 깔린 기계라면 환경에 넣지 않고 uvx로 그대로 돌릴 수 있다. GPU 가속을 원하면 CUDA 12.8을 먼저 갖춰야 한다. CPU만 쓴다면 이 단계는 건너뛴다.
화자 분리까지 쓰려면 조금 더 필요하다. Hugging Face 접근 토큰을 마련해 명령줄 인수로 넘기고, 모델 페이지에서 이용 조건에 먼저 동의해야 한다. 즉 받아쓰기와 정렬은 통신에 기대지 않지만, 화자 분리에서는 모델 내려받기와 허가가 걸린다.
명령줄 사용법
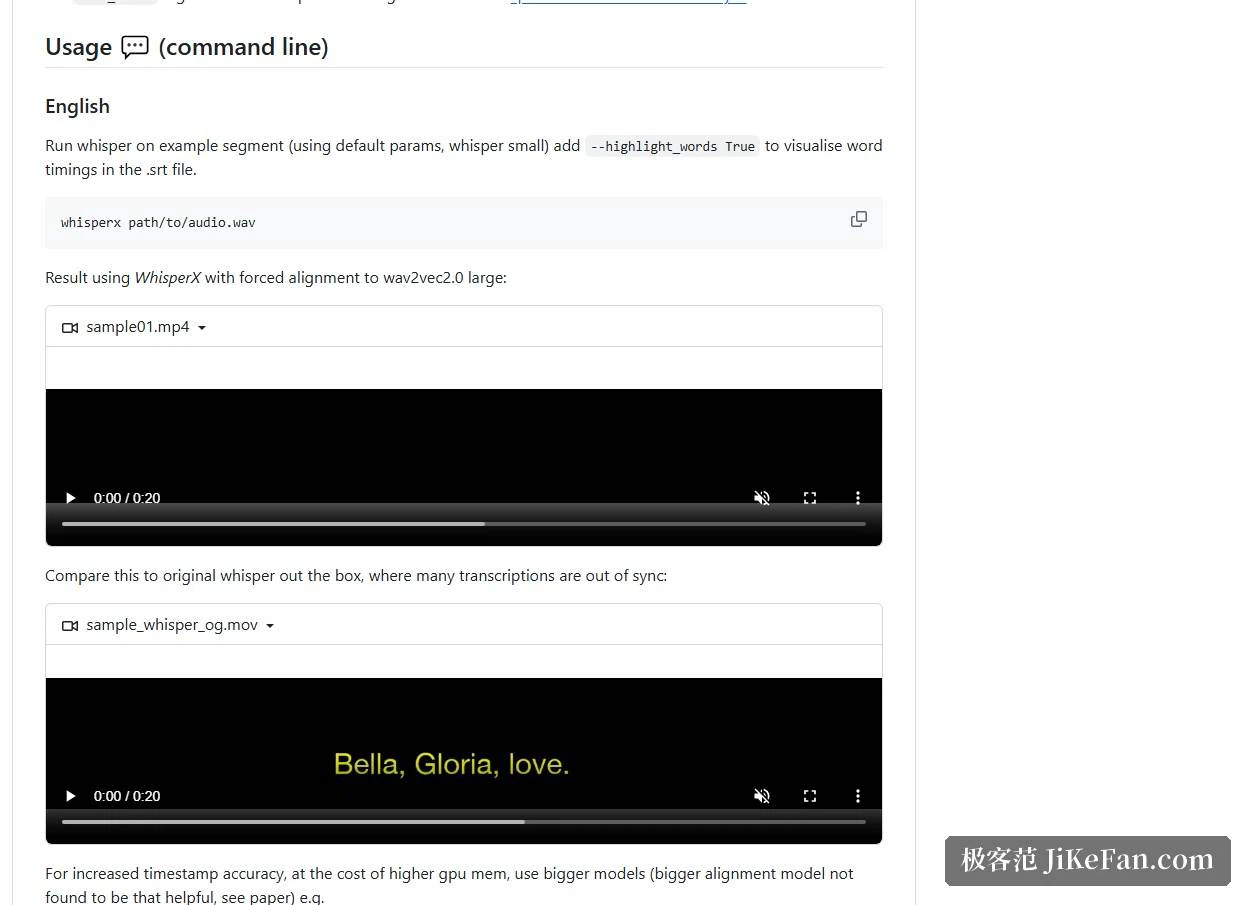
가장 기본은 음성 파일 경로를 넘기는 것이다. 기본값으로는 작은 모델과 기본 설정으로 한 번 돈다. 시각을 더 조이고 싶으면 큰 모델에 정렬 모델을 분명히 지정한다. 대신 그래픽 메모리를 더 쓴다. 화자가 여럿인 음성에는 화자 분리 지정을 더하고, 낱말별 강조를 켜면 한 낱말씩 시각을 확인할 수 있다.
그래픽 카드가 없어도 쓸 수 있다. 두 가지 지정으로 계산을 CPU로 옮기면 되고, Mac에서의 실행도 이걸로 덮는다고 공식은 설명한다. 주의할 점은 낱말 정렬에 쓰는 음소 모델이 언어별로 준비된다는 것이다. 영어, 프랑스어, 독일어, 스페인어, 이탈리아어에는 기본 모델이 있고, 다른 언어는 맞는 모델을 직접 찾아 시험해야 한다.
faster-whisper를 단독으로 쓰기
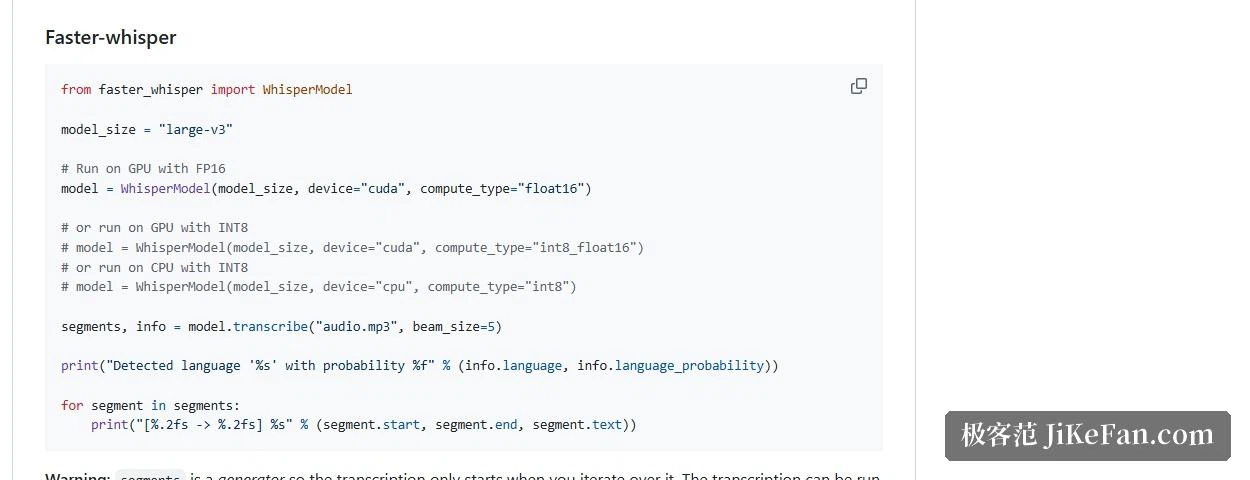
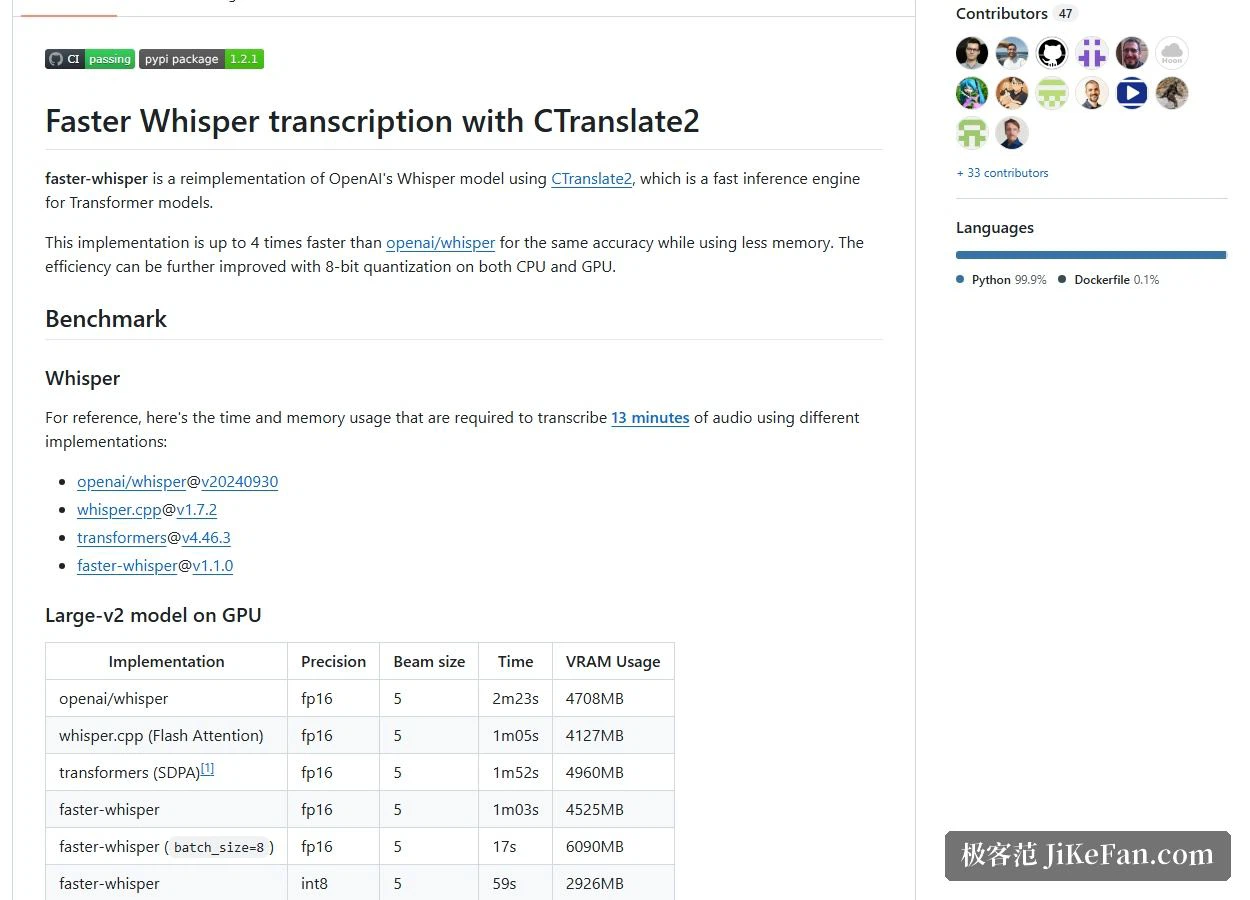
WhisperX의 받아쓰기 단계는 faster-whisper가 맡는다. 이쪽은 독립된 오픈소스 구현으로, 추론 엔진인 CTranslate2 위에 Whisper를 다시 쓴 것이다. 같은 정확도라면 최대 원본의 4배 빠르고 메모리 사용도 적다고 설명하며, CPU와 GPU 모두에서 8비트 양자화로 효율을 한 단계 더 올린다.
받아쓰기만 필요하고 낱말 정렬과 화자 분리가 필요 없다면 이것만 쓰는 쪽이 가볍다. 설치는 역시 pip 한 줄이고, 시스템 의존성에도 관대하다. 원본처럼 FFmpeg를 시스템에 미리 깔 필요가 없는데, 음성 해제를 PyAV가 맡기 때문이다. PyAV가 FFmpeg 라이브러리를 자기 패키지에 함께 담고 있다. 파이썬 3.9 이상이 필요하다.
공식 기준 측정의 숫자
재현할 수 있는 비교가 있다. 13분 음성, RTX 3070 Ti 8GB, large-v2 모델, 정밀도 fp16, beam size 5 조건이다.
원본 구현은 2분 23초에 4708MB였다. Flash Attention을 쓰는 whisper.cpp는 1:05에 4127MB. 순수한 faster-whisper는 1:03에 4525MB. 묶음 크기를 8로 올리자 faster-whisper는 17초에 6090MB였다. int8로 바꾸면 59초에 2926MB, int8에 묶음 8을 더하니 16초에 4500MB였다.
이 표에서 볼 줄은 묶음 줄이다. 같은 fp16 정밀도에서 기본값인 하나씩 처리는 1:03, 묶음으로 하면 17초. 그래픽 메모리가 빠듯하면 int8로 2926MB까지 내릴 수 있다. CPU 쪽 숫자도 있다. 작은 모델을 8스레드 데스크톱 프로세서에서 돌리면 원본은 6분 58초, faster-whisper의 int8 묶음은 51초였다.
공식은 구현끼리 견줄 때 조건을 맞추라고도 경고한다. 같은 beam size, 비슷한 인식 정확도, CPU라면 같은 스레드 수여야 숫자에 의미가 있다. 예를 들어 원본의 기본 beam size는 1, faster-whisper의 기본은 5다.
파이썬에서 부르면 다루기 쉽다
내 스크립트에 넣으려면 faster-whisper의 창구는 몇 줄이면 된다. 모델 크기, 장치, 계산 정밀도를 지정하고 받아쓰기를 부른다. 기억할 점은 돌아오는 결과가 생성기라는 것이다. 실제 계산은 그것을 훑기 시작할 때 일어나므로 목록으로 바꾸거나 반복으로 꺼내야 한다. 그러지 않으면 아무것도 돌지 않은 것처럼 보인다. 묶음 처리는 별도 창구로, 모델을 감싸고 묶음 크기를 준다. 낱말별 시각은 지정을 켜면 한 낱말씩 시작과 끝이 들어온다. 긴 무음을 걸러내려면 VAD 필터를 켠다. 기본값은 2초를 넘는 무음만 빼고, 이 기준은 직접 바꿀 수 있다.
미리 알아 둘 제약
낱말 정렬은 만능이 아니다. 공식이 분명히 드는 것은 이렇다. 연도 약어나 통화 기호가 붙은 금액처럼 정렬 모델의 어휘에 없는 표기는 시각을 줄 수 없어 타임스탬프도 붙지 않는다. 목소리가 겹치는 상황은 Whisper도 WhisperX도 잘 다루지 못한다. 화자 분리 자체도 완벽과는 거리가 멀다. 또 정렬 모델은 언어별로 준비되므로 언어를 바꾸면 모델도 바뀐다.
라이선스는 BSD와 MIT
WhisperX는 BSD, faster-whisper는 MIT로 공개되며, 둘 다 저장소 최상위에 라이선스 문서를 둔다. 느슨한 조건이라 내 자막 흐름에 붙이거나 그 위에 손을 대도 승인에서 막히는 일은 거의 없다.
어떤 사람에게 맞나
긴 음성을 바로 쓸 수 있는 자막 파일로 만들고 싶다면 WhisperX의 값은 이 흐름에 있다. 시각은 낱말까지 닿고, 여러 사람이 나오는 소재에서도 화자를 구분하며, 명령줄과 파이썬 양쪽에서 지금 있는 처리에 끼워 넣을 수 있다. large-v2에서 실시간의 70배라면 몇 시간짜리 소재에서는 차이가 뚜렷하다.
다만 설치하고 잊는 데스크톱 앱을 목표로 하지는 않는다. 환경은 직접 꾸미고 모델과 언어도 직접 고른다. 대부분에게 진짜 벽은 명령이 아니라 카드와 모델 크기의 맞바꿈이다. 녹음을 빠르게 글로 바꾸고 싶을 뿐이고 낱말별 시각이 필요 없다면 faster-whisper를 단독으로 쓰는 편이 덜 번거롭다.