
GPT-SoVITS, 1분 음성으로 목소리 모델을 다듬고 5초로 제로샷 합성한다
요약
오픈소스 음성 합성 WebUI다. 5초 분량의 사람 목소리로 제로샷 합성이 되고, 1분 분량의 학습 데이터로 더 가까운 음색을 만들 수 있다. 추론은 중국어, 영어, 일본어, 한국어, 광둥어 다섯 언어를 넘나든다.
추천- 이름
- GPT-SoVITS
- 버전
- 20260917
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsLinuxmacOS
- 업데이트
- 2026-10-06 18:49
기계에게 특정한 목소리로 말하게 하는 일의 문턱은 해마다 내려가고 있다. GPT-SoVITS는 그 선을 두 숫자로 눌렀다. 5초와 1분이다. 5초는 사람 목소리 샘플의 하한이고, 이것만 있으면 제로샷 모드로 바로 음성을 합성한다. 1분은 학습 데이터의 하한이고, 이것으로 미세조정하면 음색의 근접도가 눈에 띄게 올라간다. 프로젝트는 오픈소스이며 저장소 제목도 솔직하다. 1분 분량의 음성으로도 쓸 만한 TTS 모델을 학습할 수 있다는 문장이다.
두 갈래 길: 학습 없이, 혹은 조금만 학습해서
공식은 기능을 두 갈래로 나누고, 각각 다른 종류의 수요에 대응한다.
제로샷 TTS는 손이 가장 덜 가는 길이다. 5초짜리 목소리 샘플을 넣으면 곧바로 텍스트가 음성이 된다. 결과가 쓸 만한지 먼저 보고 싶거나 아주 가끔 목소리가 필요한 사람에게 맞는다. 학습 대기열도, 데이터셋 준비도 없다.
소량 데이터 TTS는 소리가 더 좋은 길이다. 1분의 학습 데이터가 더 높은 유사도와 더 자연스러운 발성을 사 온다. 1분이라는 기준의 의미는 무엇을 없앴는지에 있다. 자기 목소리 모델을 학습하는 일이 몇 시간씩 녹음해야 하는 전문 작업에서, 휴대전화로 한 단락 녹음하고 시도해 볼 수 있는 일이 된 것이다.
어떤 언어를 말하는가
공식 목록은 영어, 일본어, 한국어, 광둥어, 중국어다. 더 흥미로운 쪽은 언어를 넘는 추론이다. 합성할 때 쓰는 언어가 학습 데이터의 언어와 같지 않아도 된다. 한 언어로 녹음한 샘플을 원칙적으로 다른 언어를 말하게 하는 데 쓸 수 있고, 언어마다 데이터를 따로 준비할 필요가 없다.
WebUI에 데이터 준비 도구가 들어 있다
실제로 목소리를 복제해 본 사람은 안다. 어려운 것은 대개 모델이 아니라 그 앞단의 준비다. 녹음에 배경 음악이 섞였을 때 어떻게 할지, 긴 음성을 어떻게 자를지, 자른 뒤의 받아쓰기를 누가 쓸지. GPT-SoVITS는 그 공정을 WebUI 안으로 넣었다. 목소리와 반주 분리, 학습 세트 자동 분할, 다국어 음성 인식 라벨링, 텍스트 주석까지 포함한다.
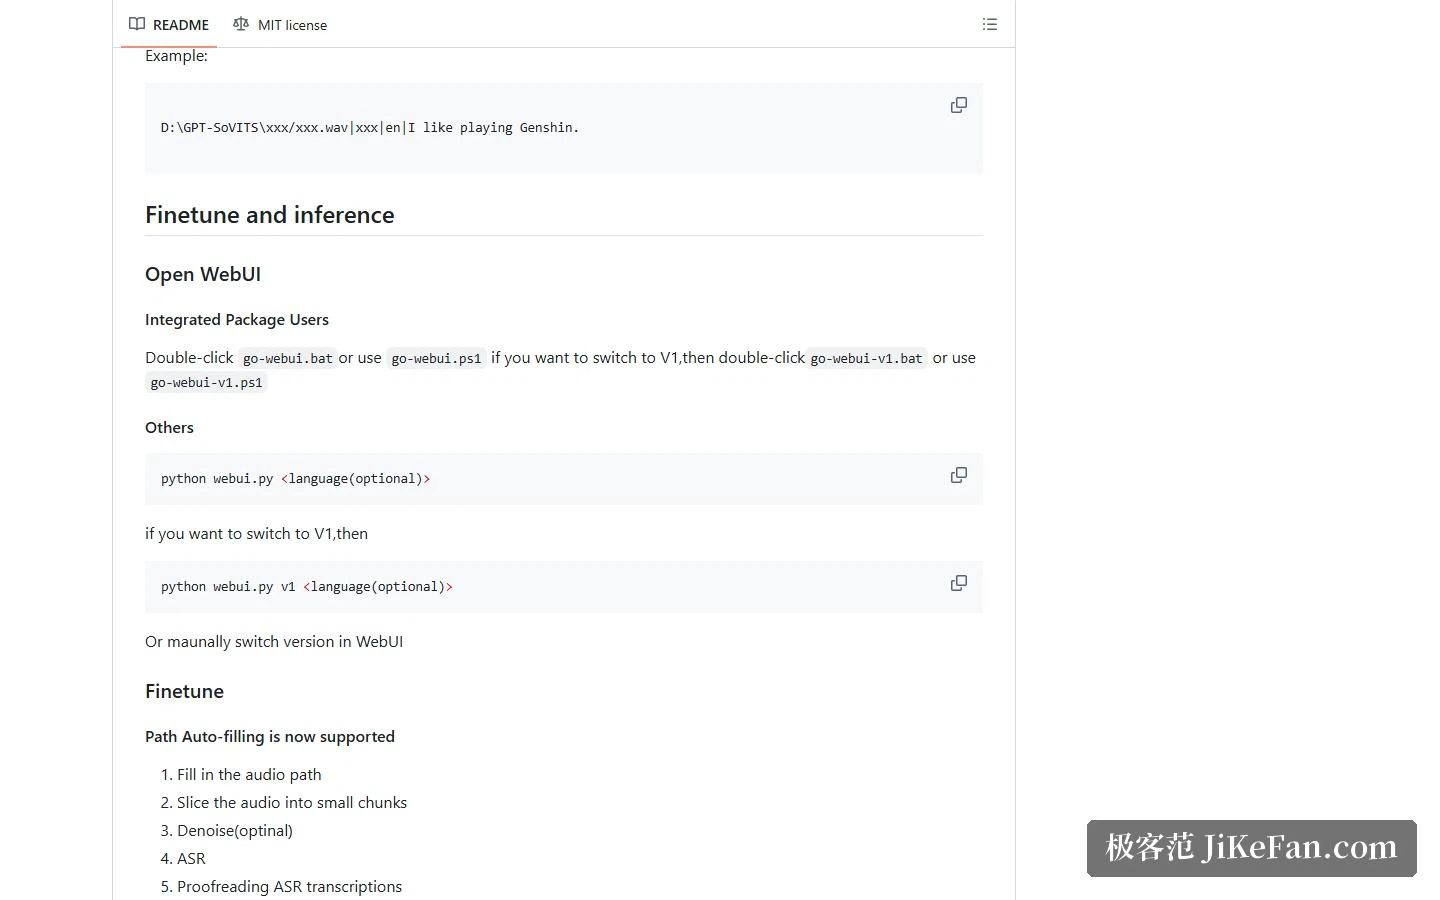
그래서 실제 순서는 이렇다. 음성 경로를 지정하고, 자르고, 필요하면 잡음을 줄이고, 음성 인식을 돌리고, 받아쓴 글을 고친 다음, 미세조정 화면으로 넘어가 학습한다. 인식 쪽에는 Fun-ASR, SenseVoice, FunASR 같은 도구가 묶여 있어, 초보자가 이 흐름을 직접 조립하지 않아도 된다.
버전이 많다, 무엇을 고를까
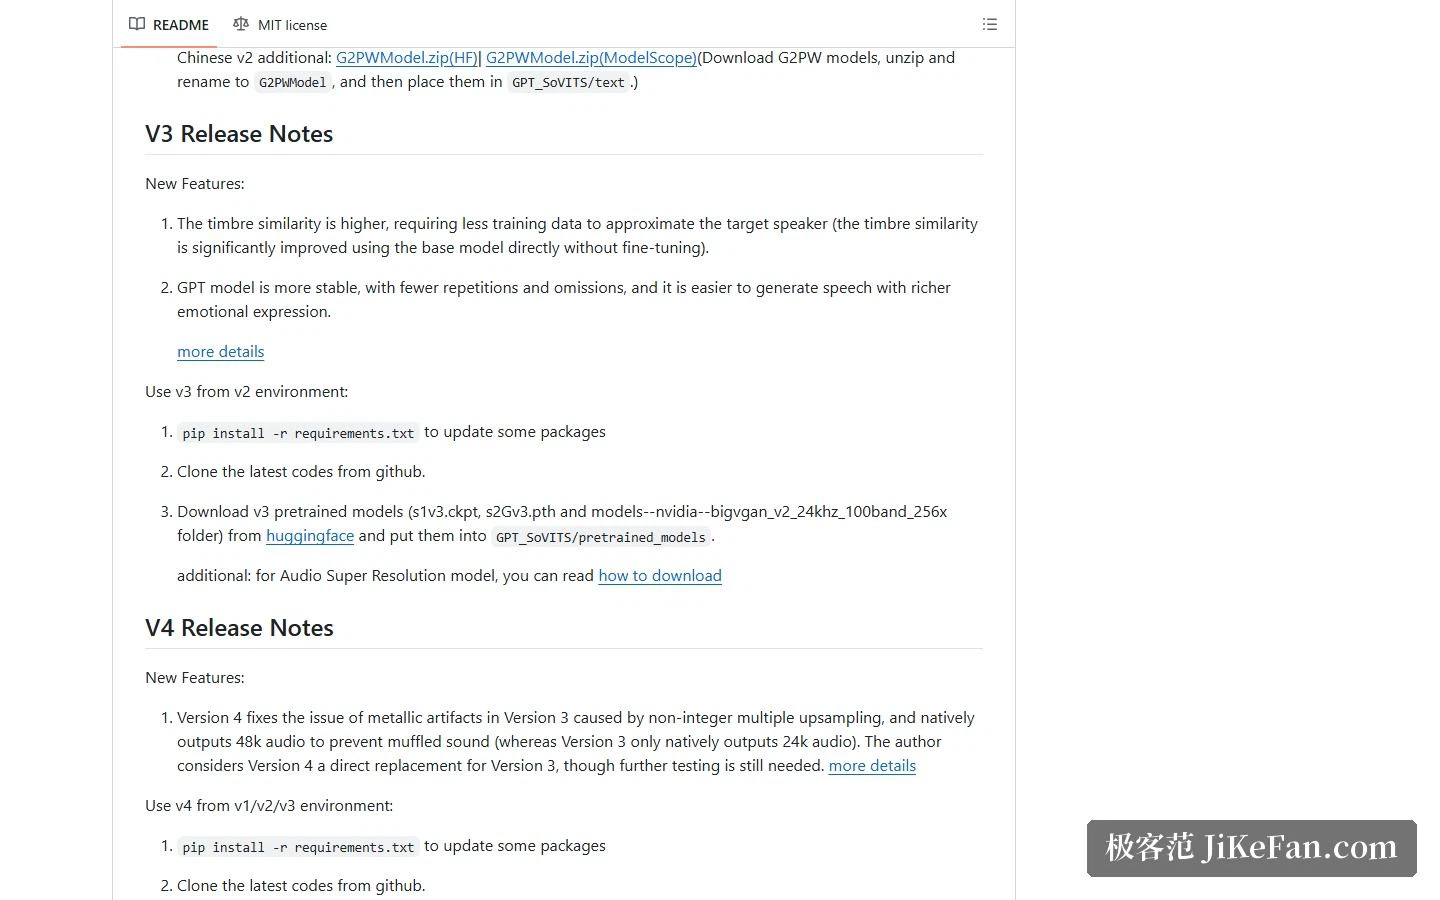
저장소에는 V1, V2, V2Pro, V3, V4 등 여러 버전이 있고, 실행할 때 인자로 바꿀 수 있으며 Windows 통합 패키지에도 대응하는 실행 스크립트가 들어 있다. 기억해 둘 차이는 몇 가지다. V2는 사전학습 모델을 2천 시간에서 5천 시간으로 늘리고 한국어와 광둥어를 더했다. V3는 미세조정 없이도 음색 유사도가 뚜렷하게 올라갔고 GPT 모듈이 더 안정적이며 감정도 풍부해졌다. V4는 V3가 정수 배가 아닌 업샘플링 때문에 만들던 금속성 잡음을 고쳤고, 48kHz를 그대로 출력한다. V3는 24kHz다.
설치는 번거로운가
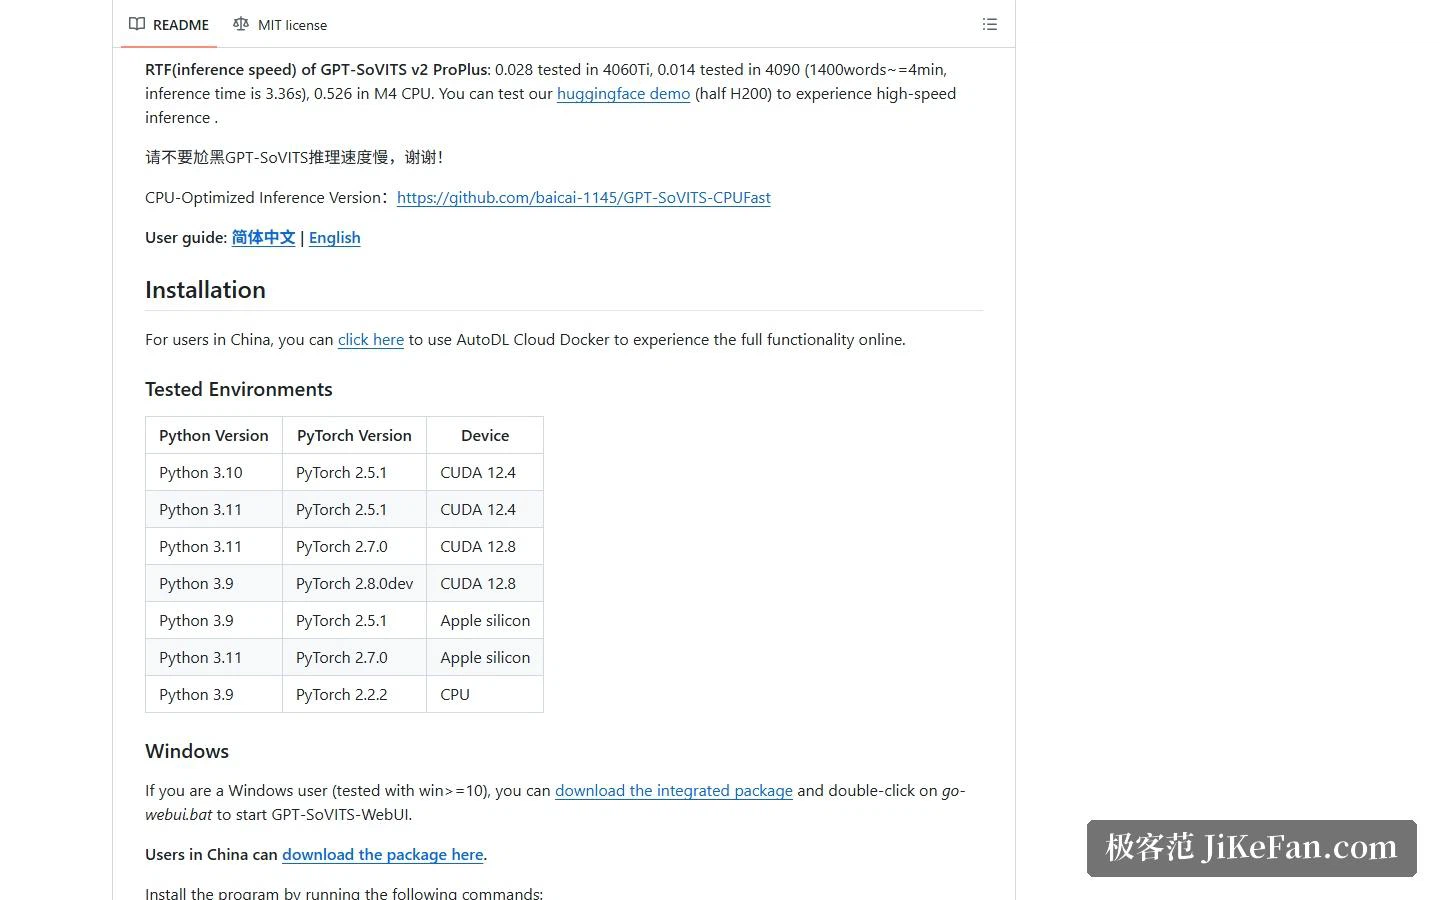
길은 여러 개다. 가장 간단한 것은 Windows 통합 패키지로, 내려받아 풀고 실행 스크립트를 두 번 누르면 WebUI가 열린다. 명령줄에서 환경을 관리하고 싶다면 Windows용 PowerShell 스크립트, Linux와 macOS용 셸 스크립트가 있고, 둘 다 장치 종류와 모델 내려받기 출처를 지정할 수 있다. 그 아래에 수동 설치와 Docker가 이어진다. 수동은 의존성과 FFmpeg를 직접 갖춰야 하고, Docker는 경량 이미지에 음성 인식과 목소리 분리 모델이 빠져 있어 따로 받아야 한다고 공식이 알린다.
환경 쪽으로는 검증된 조합이 Python 3.9에서 3.11까지, PyTorch 2.2에서 2.7까지를 덮고, 외장 그래픽카드로 돌리는 데스크톱 구성부터 CPU만으로 돌리는 경량 구성까지 있다. 미리 알아 둘 점이 하나 있다. 일부 플랫폼에서는 GPU로 학습한 모델의 품질이 다른 장치보다 뚜렷하게 떨어져서, 프로젝트가 그런 플랫폼에서는 당분간 CPU 학습으로 돌린다. 그만큼 느리다.
누구에게 맞는가
자기 목소리, 혹은 특정 음색의 음성 모델을 만들고 데이터는 자기 기기에 두고 싶다면 이 위치가 그대로 맞는다. 필요한 데이터가 적고, 도구가 갖춰져 있으며, MIT 라이선스라 제약도 적다.
다만 쓸 만한 그래픽카드가 필요하거나, CPU 추론의 느림을 받아들여야 한다. 일부 플랫폼에서는 학습 단계가 눈에 띄게 길어지므로 미리 계산에 넣어야 한다. 이와 별개로 목소리 복제의 경계는 기술이 아니라 권리에 있다. 남의 목소리, 특히 공인의 목소리로 콘텐츠를 만드는 일은 인격권과 음성권에 닿을 수 있다. 도구를 만지기 전에 권리의 출처를 분명히 해 두는 편이 좋다.
1분의 데이터로 TTS 모델을 학습한다는 일은 몇 년 전만 해도 상상하기 어려웠다. 도구가 강해질수록 선을 지키는 쪽은 쓰는 사람이 된다. 할 수 있는 일과 해도 되는 일은 언제나 다른 질문이다.