
CosyVoice, 9개 언어와 중국어 18개 방언을 덮고 제로샷 복제까지 한다
요약
오픈소스 음성 합성 모델이다. 최신 세대는 언어를 넘는 제로샷 복제를 지원하고, 9개 외국어와 열 가지가 넘는 중국어 방언과 억양을 아우르며 Apache 2.0 라이선스로 공개됐다.
추천- 이름
- CosyVoice
- 버전
- 3
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsLinuxmacOS
- 업데이트
- 2026-10-06 19:49
오픈소스 음성 합성 모델 대부분은 같은 것을 판다. 얼마나 사람처럼 들리는가. CosyVoice는 각도를 달리 잡아 커버리지를 앞세운다. 9개 언어, 중국어 방언과 억양 18가지, 그리고 언어를 넘는 제로샷 복제까지. 저장소 소개문은 담백하다. 다국어 대형 음성 생성 모델이며 추론과 학습과 배포를 모두 제공한다고 적혀 있다.
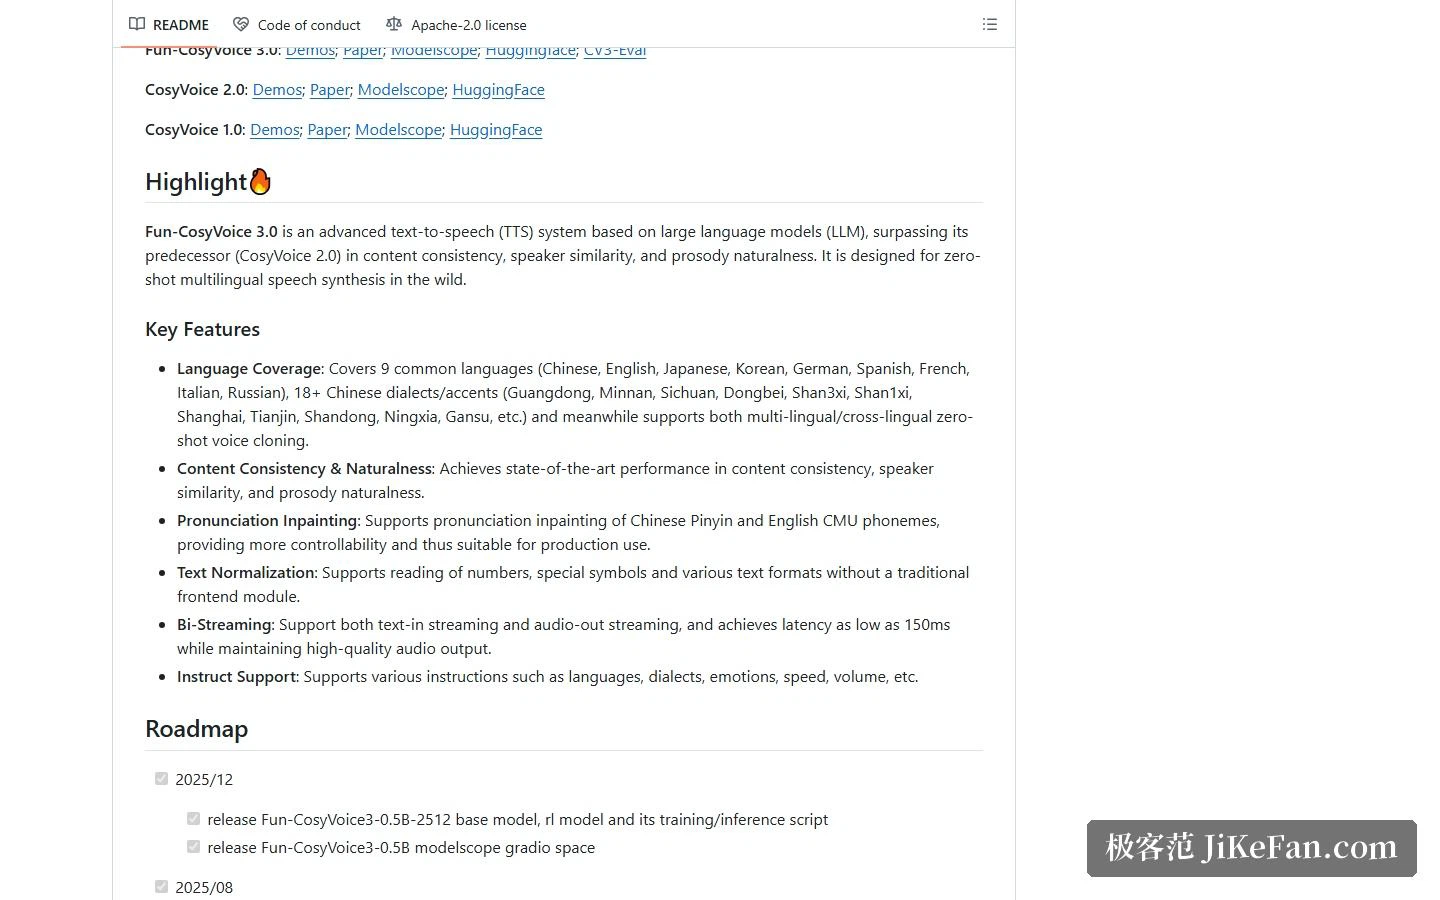
코드는 Apache 2.0 라이선스로 공개됐고, 현재 세대는 Fun-CosyVoice 3.0이다. 공식 설명은 대규모 언어 모델 위에 올린 음성 합성 시스템이며, 내용 일관성과 화자 유사도와 운율의 자연스러움 세 가지에서 CosyVoice 2.0을 앞선다고 한다.
먼저 커버리지부터: 9개 언어와 중국어 18개 방언
공식이 든 9개 언어는 중국어, 영어, 일본어, 한국어, 독일어, 스페인어, 프랑스어, 이탈리아어, 러시아어다. 중국어로 작업하는 사람에게 중요한 것은 방언 줄이다. 18가지가 넘는 중국어 방언과 억양이 있고, 공식 예시에는 광둥, 민난, 쓰촨, 둥베이, 산시성, 산시, 상하이, 톈진, 산둥, 닝샤, 간쑤가 나온다.
방언 지원의 어려움은 읽을 수 있느냐가 아니다. 말뭉치가 드물고 발음 체계가 표준어와 크게 다르다는 데 있다. 이 항목을 핵심 특징으로 따로 세운 것은 중국어권에 대한 투자가 곁다리가 아니라 의도였다는 뜻이다.
제로샷 복제, 그리고 지시로 말투 조정하기
목소리 복제에 대해 공식은 다국어와 언어 간 제로샷을 한 문장에 묶어 둔다. 한 언어로 녹음한 샘플을 다른 언어 합성에 쓸 수 있다는 의미이고, 언어마다 데이터를 다시 준비할 필요가 없다.
또 하나의 실용 기능은 지시 제어다. 언어, 방언, 감정, 말 속도, 음량을 명령으로 지정할 수 있다. 음성 콘텐츠를 만드는 쪽에서는 맞을 때까지 다시 생성하는 것보다 훨씬 통제가 쉽다. 발음 교정도 따로 적혀 있어 중국어 병음과 영어 CMU 음소로 개입할 수 있다. 다중 발음 글자나 외국 고유명사는 손으로 고치면 된다.
스트리밍 추론: 지연 최저 약 150밀리초
특징 항목에는 텍스트 입력 스트리밍과 음성 출력 스트리밍을 양방향으로 지원하고, 지연이 최저 150밀리초까지 내려가면서 음질을 유지한다고 적혀 있다. 이 숫자가 결정적인 곳은 실시간 대화다. 음성 합성을 상담 봇이나 음성 비서에 넣는다면, 지연이 쓸 수 있는지 없는지를 가르는 선이 된다.
버전과 모델, 무엇을 고를까
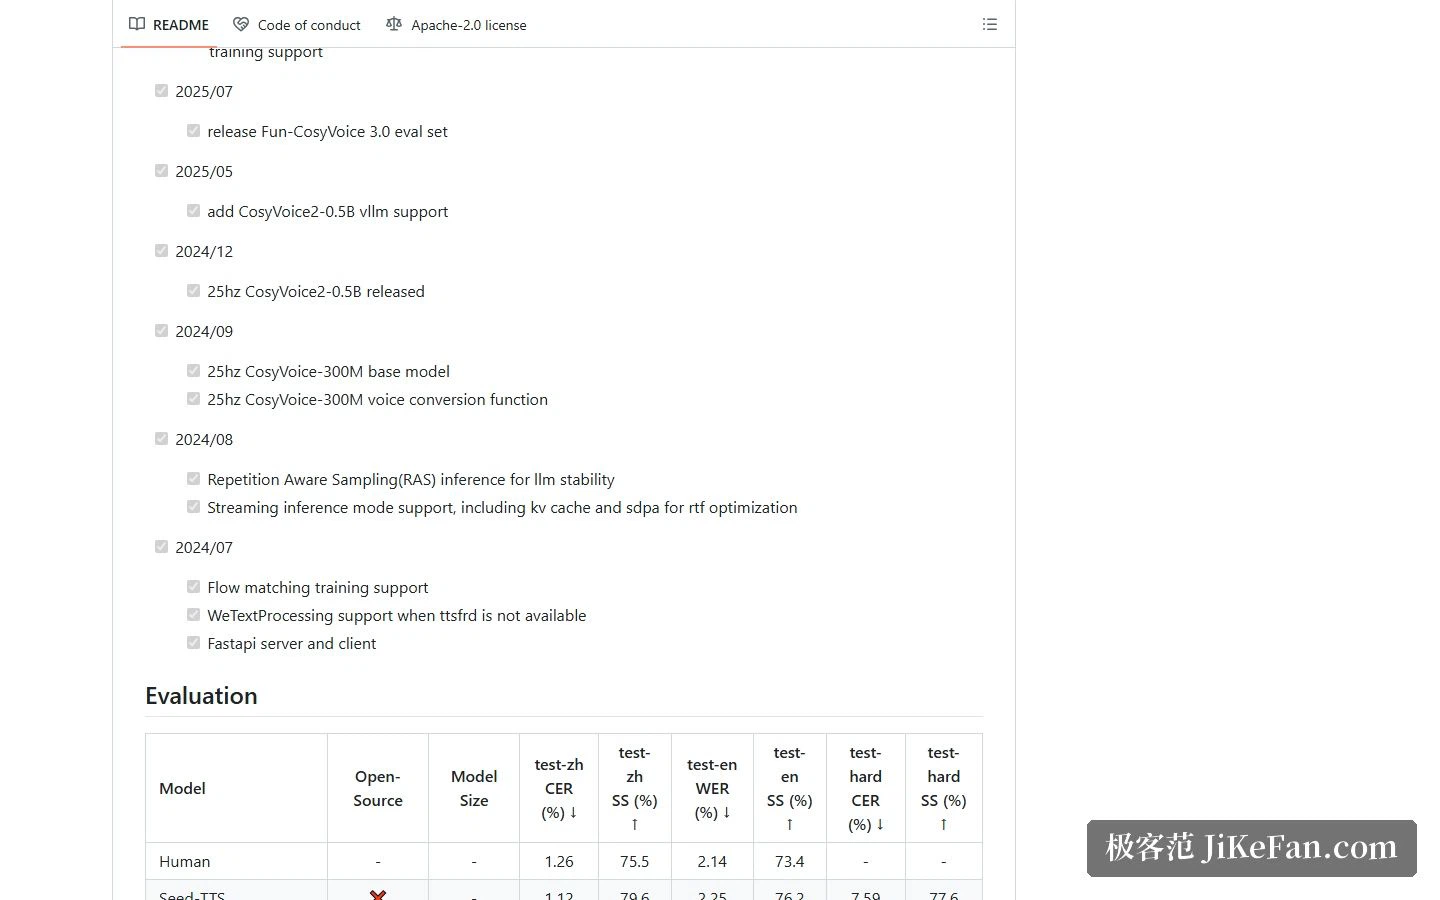
지금까지 세 세대가 있다. CosyVoice 1.0, CosyVoice 2.0, Fun-CosyVoice 3.0이고, 각각 논문과 모델 저장소 위치가 안내된다. 내려받을 수 있는 사전학습 모델도 하나가 아니다. 3억 파라미터 규모의 CosyVoice-300M, 그 미세조정판 300M-SFT와 지시판 300M-Instruct, 그 위에 CosyVoice2-0.5B와 최신 Fun-CosyVoice3-0.5B가 있다.
공식 문서는 Fun-CosyVoice3-0.5B를 이름을 짚어 권한다. 성능이 더 좋기 때문이다. 지시 제어가 중요한 상황이라면 Instruct가 붙은 판을, 흐름을 빨리 통과시키는 것이 목적이라면 3억짜리 판을 고르면 된다. 크기가 작고 메모리 부담도 훨씬 적다.
설치: Conda 환경 하나와 모델 내려받기
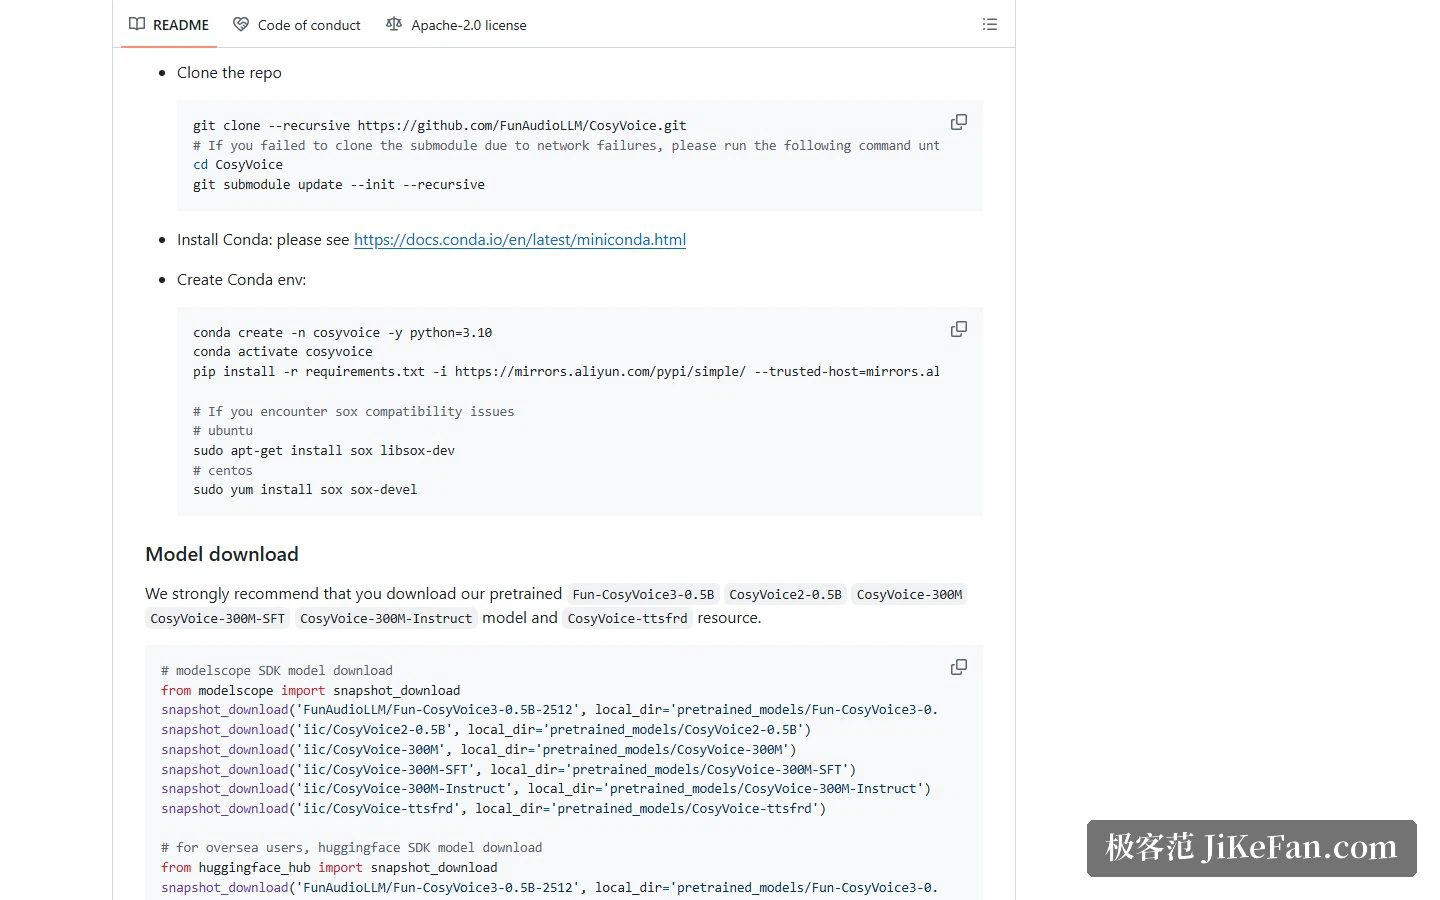
공식 경로는 저장소를 서브모듈까지 복제하고, Conda로 Python 3.10 환경을 만들어 의존성을 설치한 다음, 필요한 사전학습 모델을 받는 순서다. 모델은 ModelScope나 HuggingFace에서 받을 수 있고, 중국 내 사용자는 전자가 더 매끄럽다.
놓치기 쉬운 점이 하나 있다. 텍스트 정규화는 기본으로 wetext를 거친다. 따로 ttsfrd 리소스 팩을 풀어 설치해 두면 숫자와 기호를 더 잘 읽는다. 공식도 이 단계가 필수가 아니며 건너뛸 수 있다고 밝힌다.
돌려 보기, 그리고 더 빠르게 하고 싶을 때
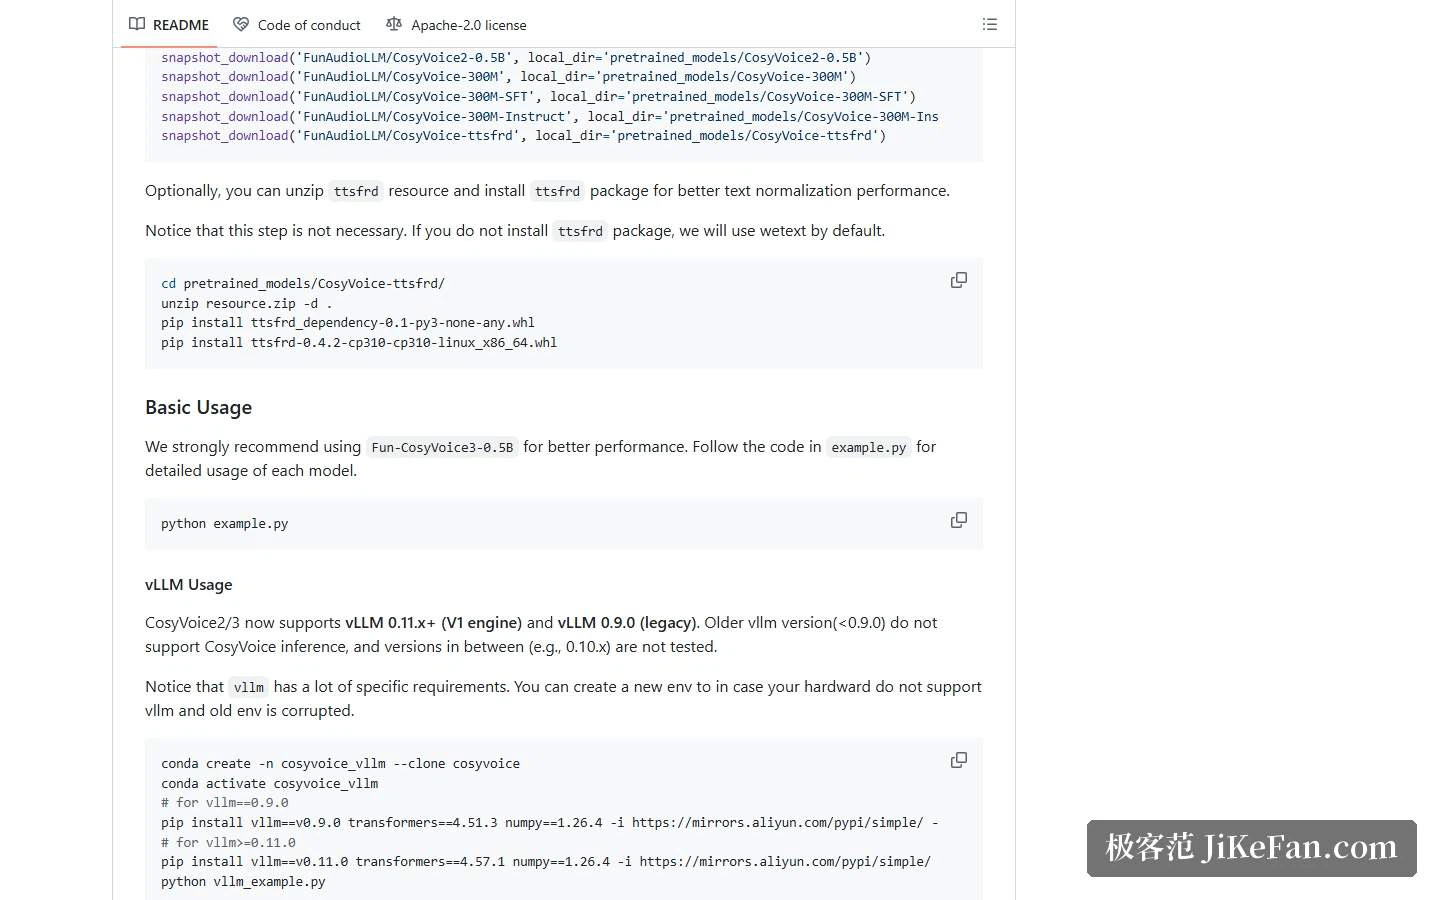
가장 간단한 확인은 공식 예제 스크립트를 돌리거나, 웹 데모를 띄워 모델 디렉터리와 포트를 지정하고 브라우저에서 들어 보는 것이다. 처리량이나 지연이 제약이 되면 CosyVoice 2와 3은 vLLM 가속을 지원한다. 다만 버전 조건이 있다. 공식은 새 엔진 0.11 이상과 구버전 0.9.0을 지원한다고 적고, 0.9.0 아래 버전은 추론이 아예 안 되며 그 사이 버전은 검증되지 않았다고 밝힌다.
누구에게 맞는가
필요가 중국어에 몰려 있다면, 특히 방언과 통제 가능한 말투와 발음 교정이 필요하다면 이 조합이 범용 영어 중심 TTS보다 잘 맞는다. 코드가 열려 있고 직접 띄울 수 있다는 점은 데이터를 사내망 밖으로 내보낼 수 없는 상황에도 유리하다.
먼저 확인할 것이 두 가지 남는다. 하나는 모델 가중치의 라이선스다. 저장소 코드는 Apache 2.0이지만, 생성 결과를 상업적으로 쓰기 전에 가중치 자체의 허용 조건을 다시 읽어 보는 편이 좋다. 다른 하나는 목소리 복제의 적법성이다. 남의 목소리, 특히 공인의 목소리로 콘텐츠를 만드는 일은 인격권과 음성권에 닿을 수 있다. 권리의 출처는 가정이 아니라 서면으로 남겨 두어야 한다.
오픈 음성 모델은 이 2년 사이 크게 나아졌고, 덮는 언어와 방언도 계속 채워지고 있다. 기술적 선택지는 늘었지만 남은 질문은 사람 쪽으로 돌아온다. 기계가 누구의 목소리를 쓰고 무엇을 말하게 할 것인가.