
IndexTTS を自分のマシンで動かす、感情も話速もパラメータで振れる
要約
手元のマシンに導入して動かすゼロショット音声合成。参照音声は一本でよく、感情も話速も発音もパラメータで調整できる。重みの扱いは汎用のオープンソース許諾ではなく、プロジェクト独自のライセンスで決まる。
おすすめ- ソフト名
- IndexTTS
- バージョン
- 2.5
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinux
- 更新日時
- 2026-10-06 20:19
リポジトリの題名がそのまま仕様書になっている
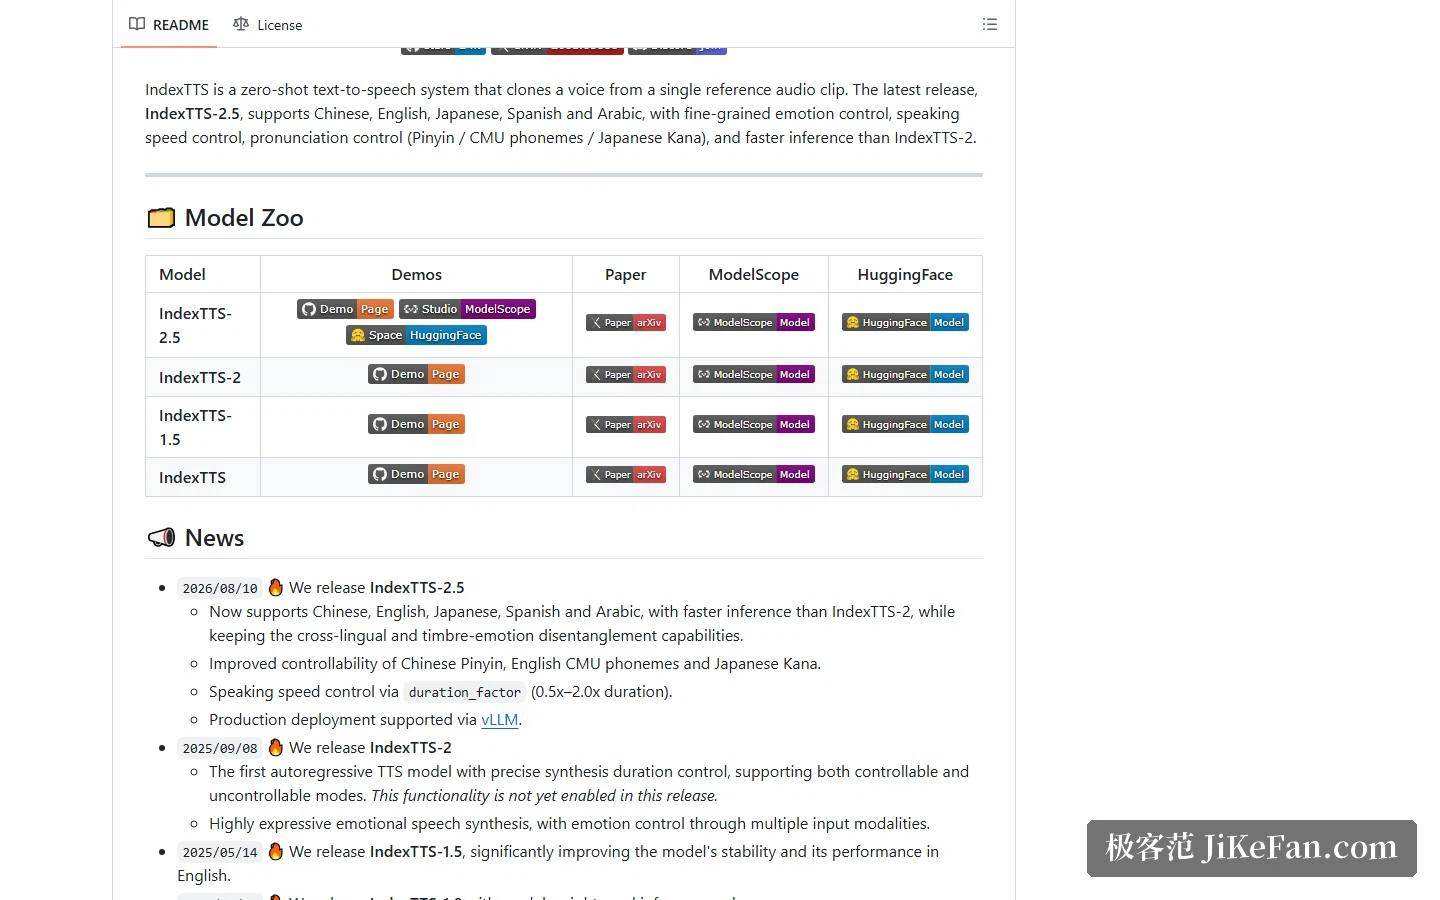
IndexTTS はリポジトリの一行目で自分の立ち位置を宣言している。産業用途に耐える、制御できる、そして高速なゼロショット音声合成だ。三つの形容詞は三つの約束に対応する。本番の流量を扱えること、挙動を操れること、意味のある速度で動くこと。声を複製する入口も同じくらい率直で、参照音声を一本渡せばよく、その間に学習の工程はない。
現在の最新版は IndexTTS-2.5。中国語、英語、日本語、スペイン語、アラビア語の五つを扱い、推論は前世代の IndexTTS-2 より速いと説明されている。言語をまたぐ能力と、前の版が築いた音色と感情の分離はそのまま保たれている。
四つの版、一本の系譜
更新履歴は飾り気なく経緯を語る。最初が基本版の IndexTTS。1.5 版は安定性と英語の出力に重心を置いた。2 版はこの系列で初めて合成時間の正確な制御に対応した自己回帰型の音声モデルだが、同じ説明の中で、その機能は当時の公開では有効になっていないと断っている。2.5 で言語が五つに広がり、ピンインと音素の発音制御が改善され、話速の制御と vLLM での運用経路も加わった。
四つの版はモデル一覧に並んでいて、それぞれデモ、論文、重みの入手先が添えられている。どれを選ぶかは、自分の用途にどの能力が要るかで決まる。数字の大きさで決める話ではない。
三つの調整軸
ここが IndexTTS の最も特徴的な部分だ。感情ひとつを取っても指定の方法が三通りある。感情の参照音声を別に渡し、その効き目を emo_alpha で調整できる。値は 0 から 1 までで、既定は最大。代わりに長さ八の浮動小数点の並びを渡すこともでき、順序は喜び、怒り、悲しみ、恐れ、嫌悪、憂鬱、驚き、平静で固定されている。文章で感情を説明する方法もある。
話速は duration_factor で扱う。受け付けるのは半分から二倍までで、既定は元の速さのまま。既定より大きいと遅くなり、小さいと速くなる。動画に声を当てるときに効いてくる。映像の長さは決まっていて、声をその中に収める必要があるからだ。
発音が三つ目の軸で、対象となる表記は三種類ある。中国語のピンイン、英語の CMU 音素、日本語のかな。読み方が複数ある字や、外来の固有名詞が誤って読まれる場合に、録り直さずに手で直せる。
一枚の 4090 での実時間率
公開されているベンチマークは 4090 一枚の上で、KV キャッシュを有効にして実行された。IndexTTS-2.5 の実時間率は bf16 で 0.2065、fp32 で 0.2060。比較として IndexTTS-2.0 は fp16 で 0.3257、fp32 で 0.3748 だった。この数字は小さいほど良い。生成が再生速度に対してどれだけ余裕を残しているかを表すので、二世代の効率差は数字から直接読み取れる。
依存関係は uv に任せる
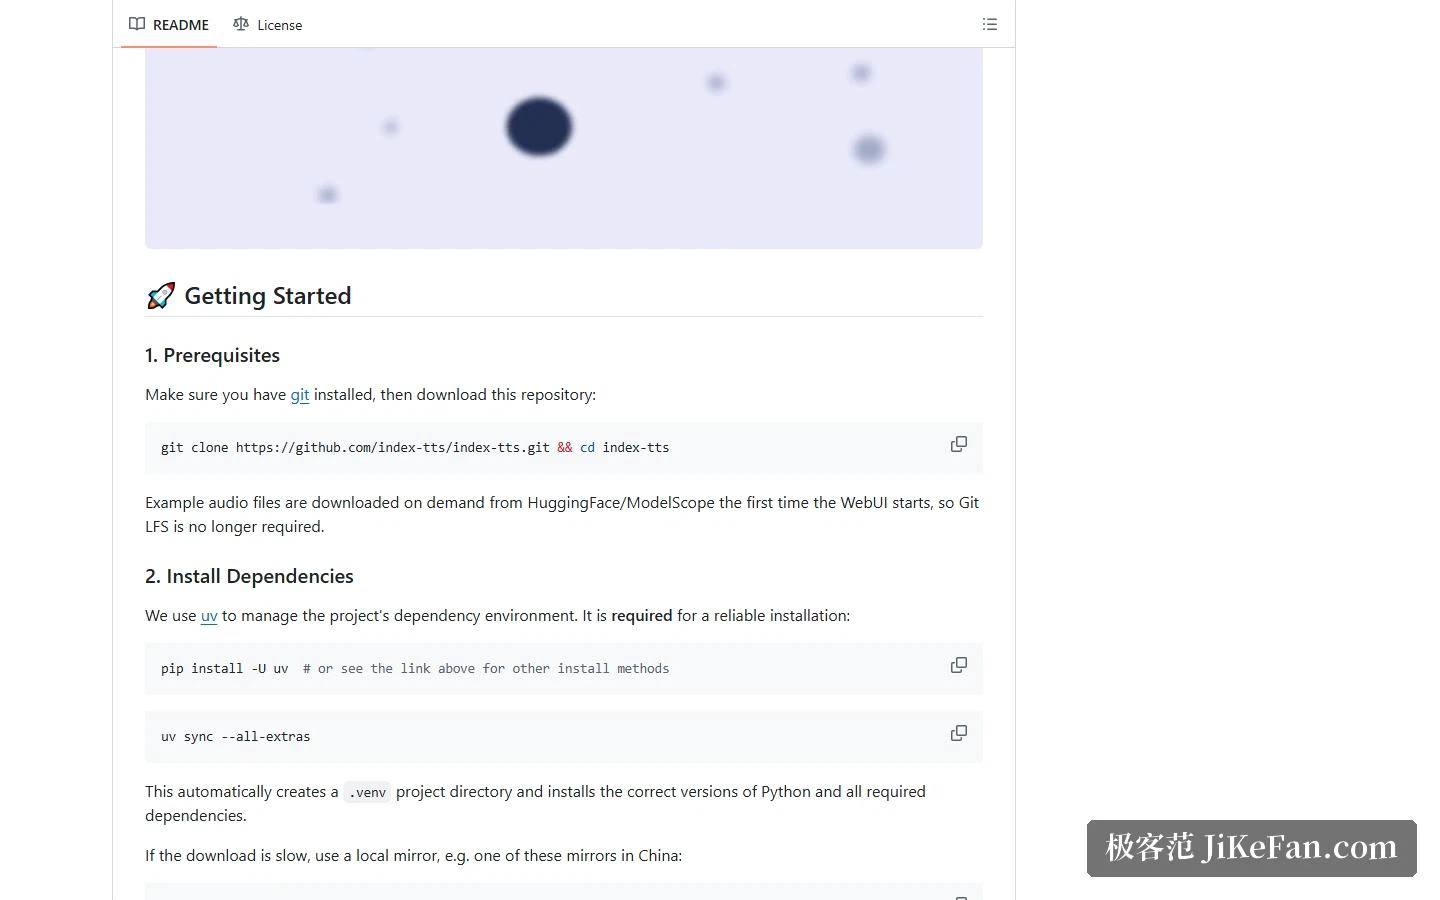
推奨される導入方法は少し変わっている。まず pip で uv を入れ、その uv でプロジェクト全体を同期する。uv が仮想環境を自分で作り、Python の版と依存パッケージの版をまとめて固定するからで、説明ではこれを確実な導入の前提と呼んでいる。同じ説明が、環境を手で有効化しないよう念を押す。依存の衝突はたいていそこから始まる。
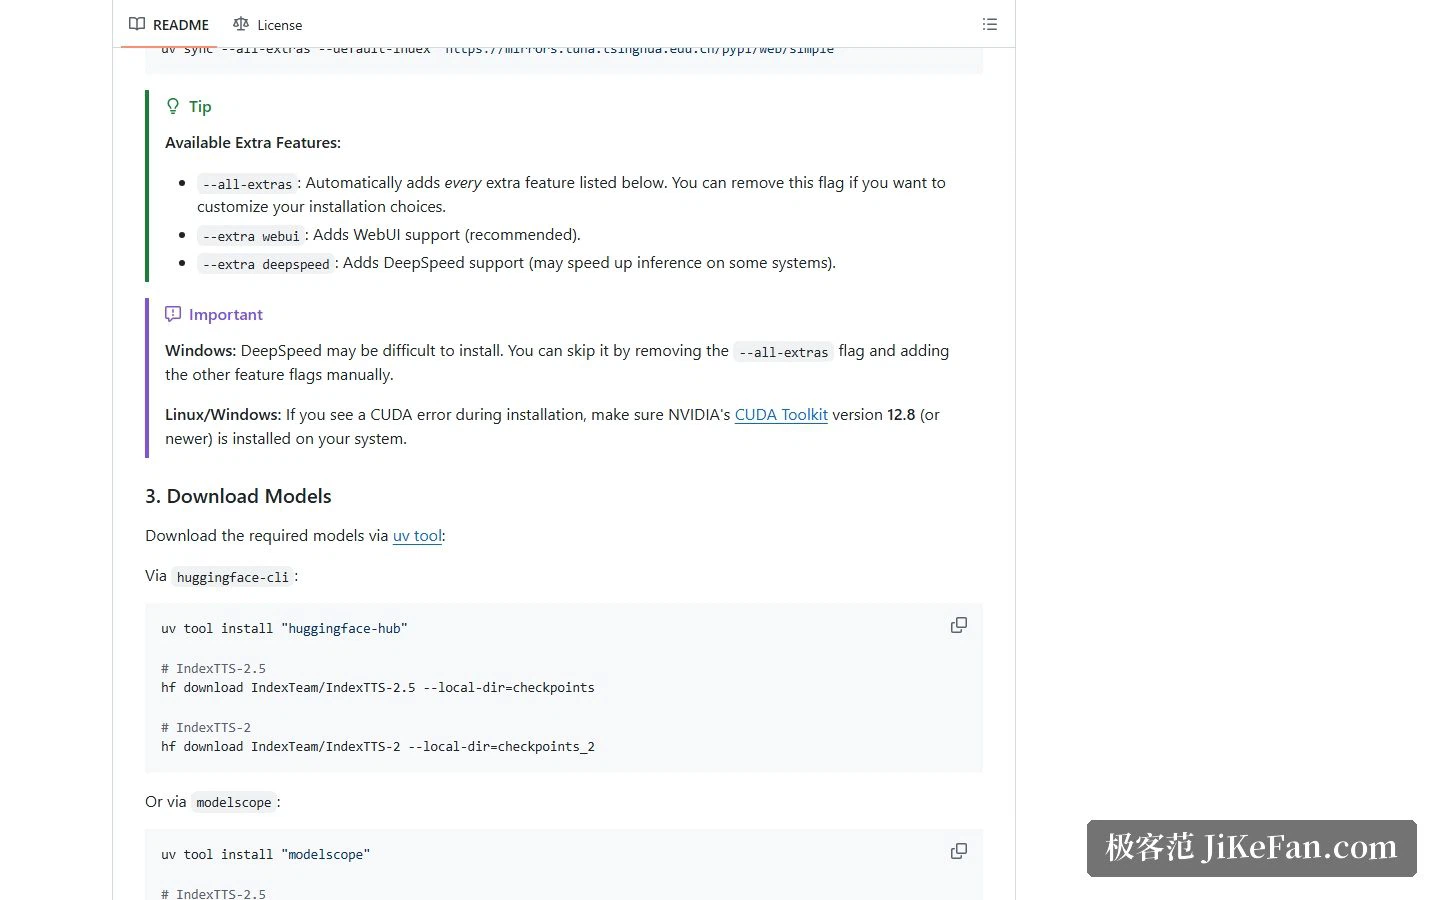
導入時に構成要素を選べる。ブラウザの画面が欲しければ webui の項目を、加速が欲しければ DeepSpeed の項目を足す。注意が二つ付いてくる。DeepSpeed は Windows でうまく組めないことがあり、その場合は全部を一度に入れる指定を外して手で選ぶ。もう一つは、導入中に CUDA のエラーが出たら、CUDA ツールキットが 12.8 以降かどうかを確かめること。
重み、グラフィックスの確認、最初の起動
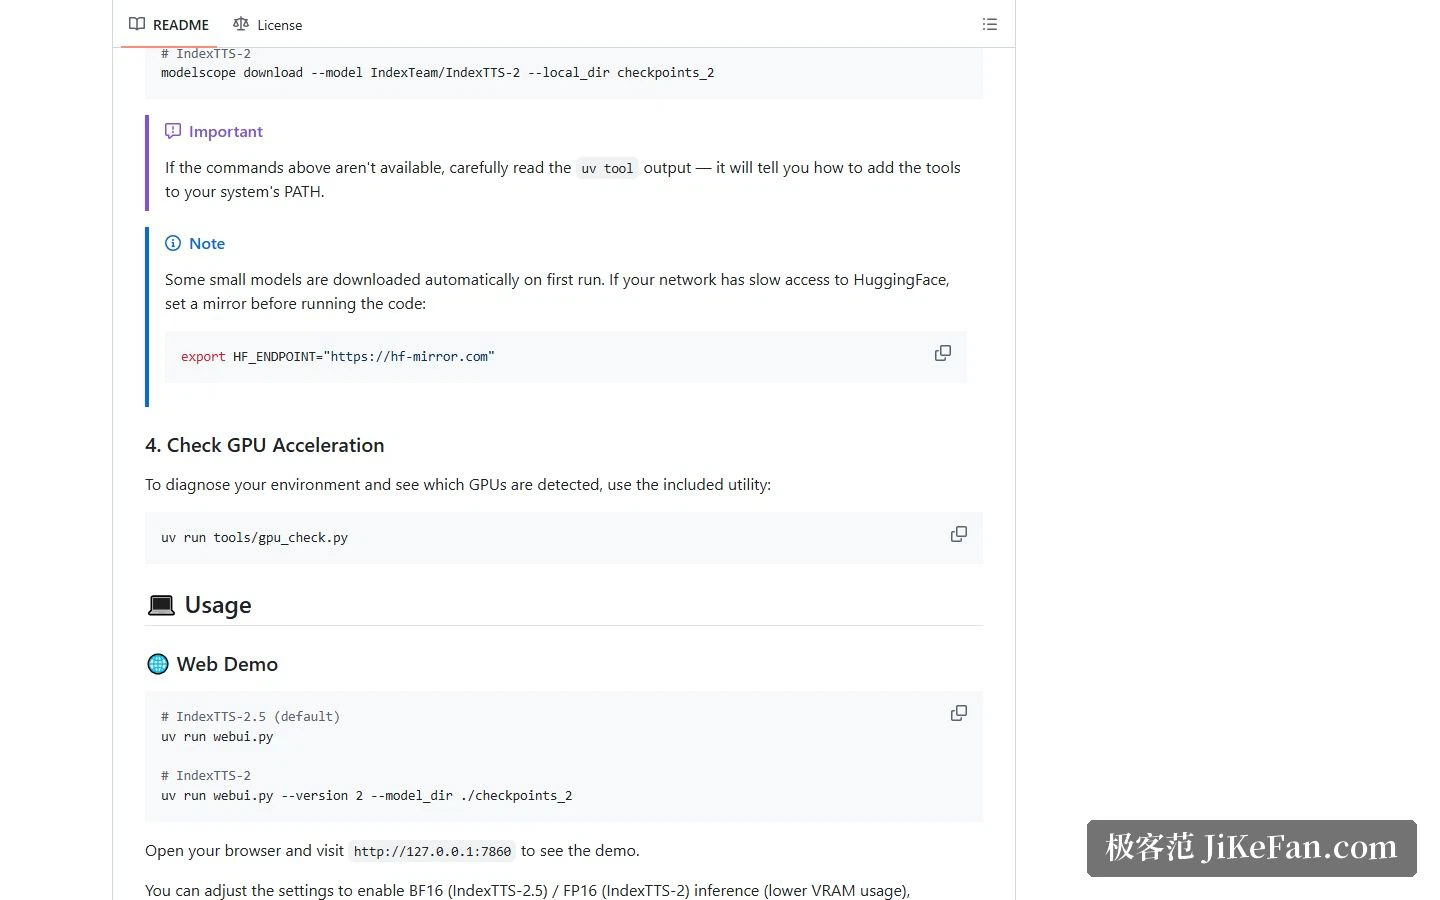
重みは別途入手する。HuggingFace か ModelScope から取ってきて、ローカルのディレクトリに置けばプログラムが読み込む。見本の音声は画面の初回起動時に必要に応じて取得されるので、Git LFS は要らなくなった。回線が心もとない人には関門が一つ減る。
起動の前に、グラフィックスを検出するスクリプトを一度走らせ、環境がどの GPU を認識しているかを確かめる。そのうえで画面を立ち上げ、ブラウザでローカルのページを開けば試せる。半精度の推論はそのページから切り替えられ、BF16 か FP16 のほうが速く、使うビデオメモリも少なく、画質の劣化はごくわずかだと説明されている。
ライセンスは別に目を通す部分
ソースは公開されているが、ライセンスは一般的な MIT でも Apache でもなく、bilibili のモデル利用許諾だ。リポジトリには中国語版と英語版の二つが置かれている。実務上の意味は、使える範囲がこの文書で決まるということで、汎用のオープンソース許諾で決まるわけではない。商用や再配布を視野に入れるなら、先に読んで、自分の使い方が許される範囲に入っているかを確かめたい。
どんな人に向くか
合成した声を実際の製品に組み込み、しかも調整したいという要件なら、ここでの制御の密度は高い。感情は並びでも文章でも指定でき、話速は正確に伸縮でき、発音は一文字ずつ直せて、vLLM で動かす経路まである。おもちゃのプロジェクトには並ばない構成だ。
導入の敷居も確かにある。NVIDIA のカードが要り、CUDA ツールキットの 12.8 以降が要り、依存の導入は uv という道具立てを通す。加えて、声を複製する道具に共通する話だが、他人の声で何かを作るなら許諾の問題が付いてくる。公人であればなおさらだ。話速や感情を細かく振れるほど、どこで使うのが適切かを自分で分かっている必要がある。
制御を細かくする代償は複雑さだ。パラメータが増えていくと、出来の良し悪しを決めるのはモデルの能力ではなく、内容そのものをどれだけ理解しているかになる。