
語ごとの時刻と話者まで付ける、WhisperX が足した二つの工程
要約
Whisper の二つの穴を埋める流れだ。時刻は文の単位で止まり、まとめて処理する手段もない。WhisperX は強制アラインメントで語の時刻まで詰め、話者も見分け、large-v2 で実時間の 70 倍とうたう。
おすすめ- ソフト名
- WhisperX
- バージョン
- 3.8.7
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinuxmacOS
- 更新日時
- 2026-10-06 19:53
Whisper が落としている二つ
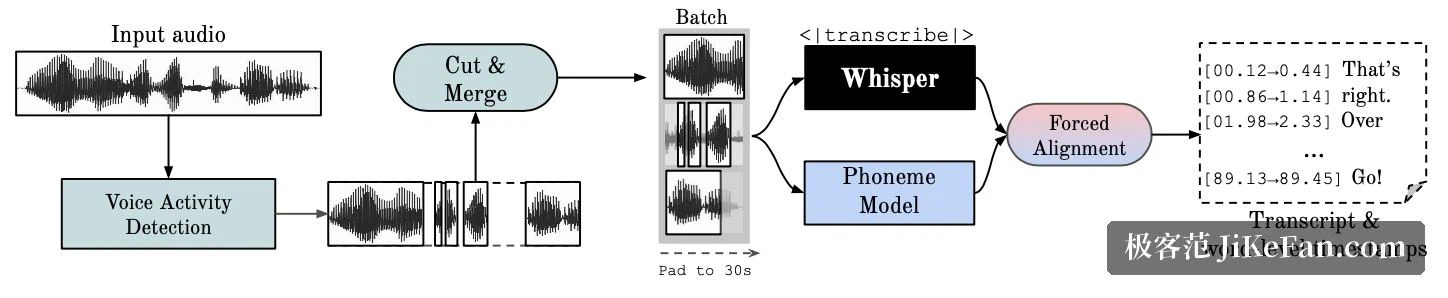
WhisperX は、ごく具体的な不満から生まれている。Whisper の書き起こしは正確だが、時刻は文の単位で止まる。字幕を作ると、文字と絵がずれるのがすぐ分かる。数秒のずれは日常的だ。しかもまとめて処理する手段を Whisper 自身は持っていない。
直し方は、Whisper の外に二つの段を足すことだった。まず書き起こした結果を音声に強制的に合わせ、時刻を語一つひとつまで細かくする。次に音声を話者ごとに切り、どの台詞を誰が言ったかを示す。公式はこれを一本の流れにまとめ、コマンドラインと Python の両方の入口を用意している。
四つの段からなる流れ
リポジトリの図は工程を四つに分けている。まず音声活動の検出で、無音の区間を落とす。次に書き起こしのモデルがまとめて文字を出す。続いて音素の単位で認識するモデルが強制アラインメントを行い、語ごとの時刻を得る。最後に話者を分けるモデルが声を切り分ける。
要となる数字は公式の説明に並んでいる。large-v2 でのまとめ推論は実時間の 70 倍に届く。書き起こしの土台は faster-whisper で、large-v2 は beam size を 5 にした設定でビデオメモリが 8GB 未満で済む。語ごとの時刻は wav2vec2 の強制アラインメントから来る。話者の分離は pyannote-audio によるもので、出てくるのは話者の識別子だ。この流れの論文は INTERSPEECH 2023 で発表され、長い音声を時刻どおりに書き起こすという主題を掲げている。
前段の音声活動の検出には、触れておきたい副作用がある。幻覚を減らしながら認識の精度を落とさない、しかもまとめて処理しやすくなると言われていて、これが速度を引き上げられた前提の一つになっている。
導入は pip 一行
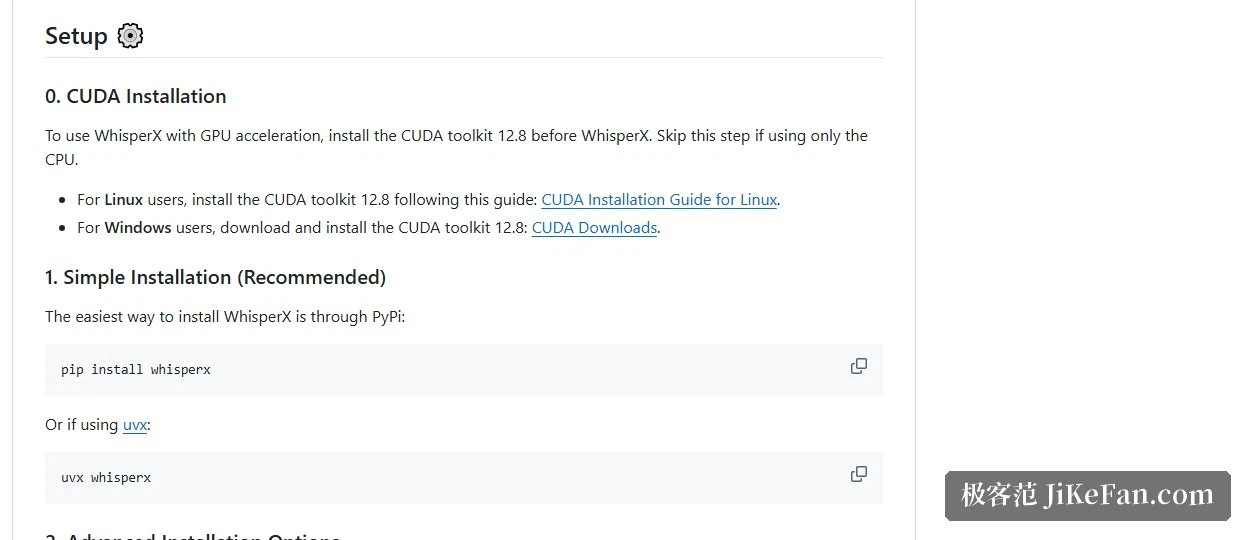
推奨される導入は短い。pip の一行で足りる。uv が入っているマシンなら、環境に入れずに uvx でそのまま走らせられる。GPU で加速したいなら CUDA 12.8 を先に入れておく。CPU だけで使うならこの段は省ける。
話者の分離まで使うなら、もう少し要る。Hugging Face のアクセストークンを用意し、コマンドラインの引数で渡す。加えて、モデルのページで利用条件に同意しておく必要がある。つまり書き起こしとアラインメントは通信に依存しないが、話者の分離ではモデルの取得と許諾が関わってくる。
コマンドラインの使い方
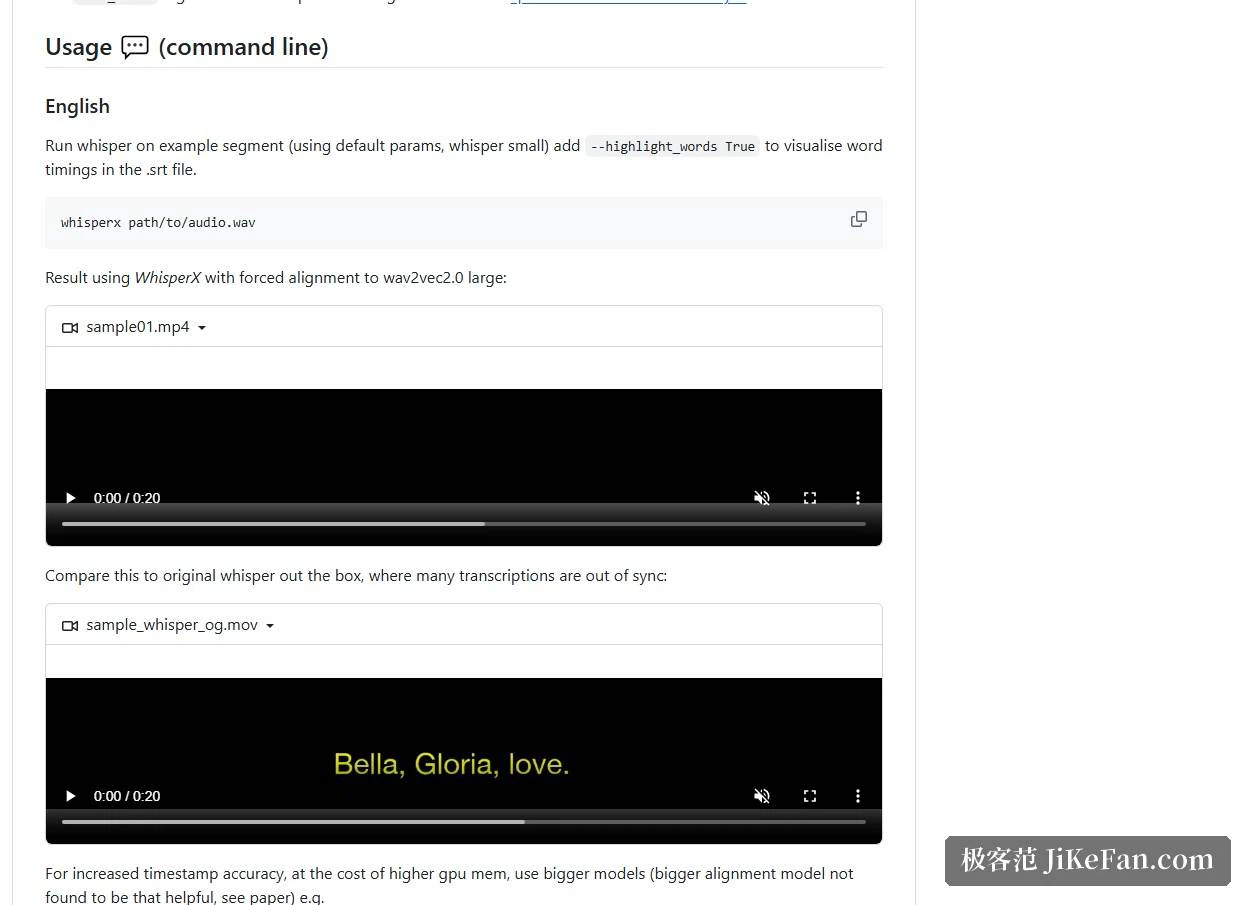
もっとも基本的な使い方は、音声ファイルの場所を渡すだけ。既定では小さめのモデルと既定の設定で一度走る。時刻を詰めたいなら、大きめのモデルに加えてアラインメントのモデルを明示する。代わりにビデオメモリを多く使う。複数の話者がいる音声では話者分離の指定を足し、語ごとの強調をオンにすれば、一語ずつの時刻を確かめられる。
グラフィックスが無くても使える。二つの指定で計算を CPU に移せばよく、Mac での実行もこれでまかなえると公式は説明している。注意したいのは、語のアラインメントに使う音素のモデルが言語ごとに用意されている点だ。英語、フランス語、ドイツ語、スペイン語、イタリア語には既定のモデルがあるが、それ以外の言語は合うモデルを自分で探して試すことになる。
faster-whisper を単体で使う
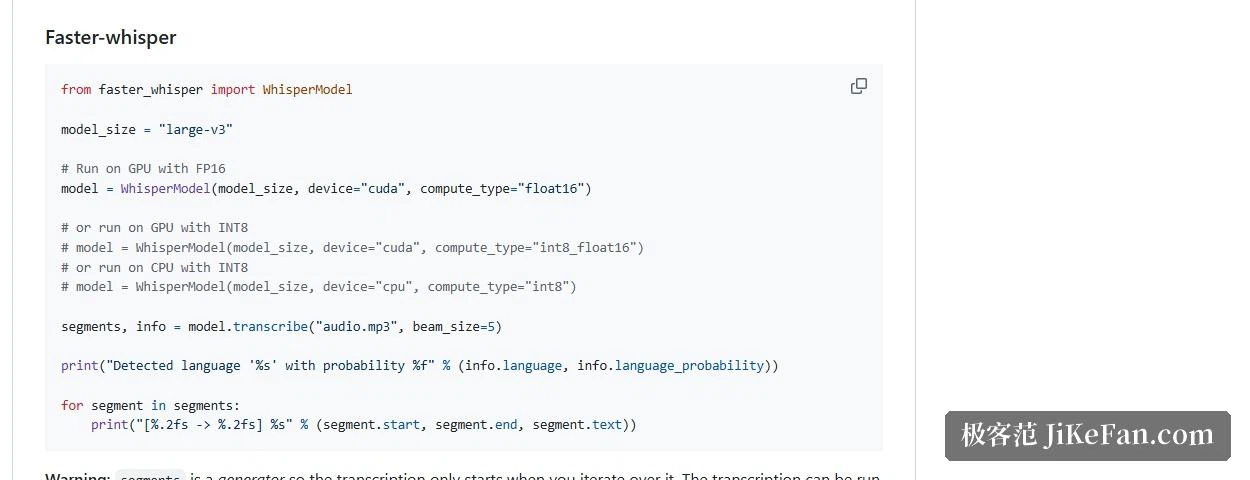
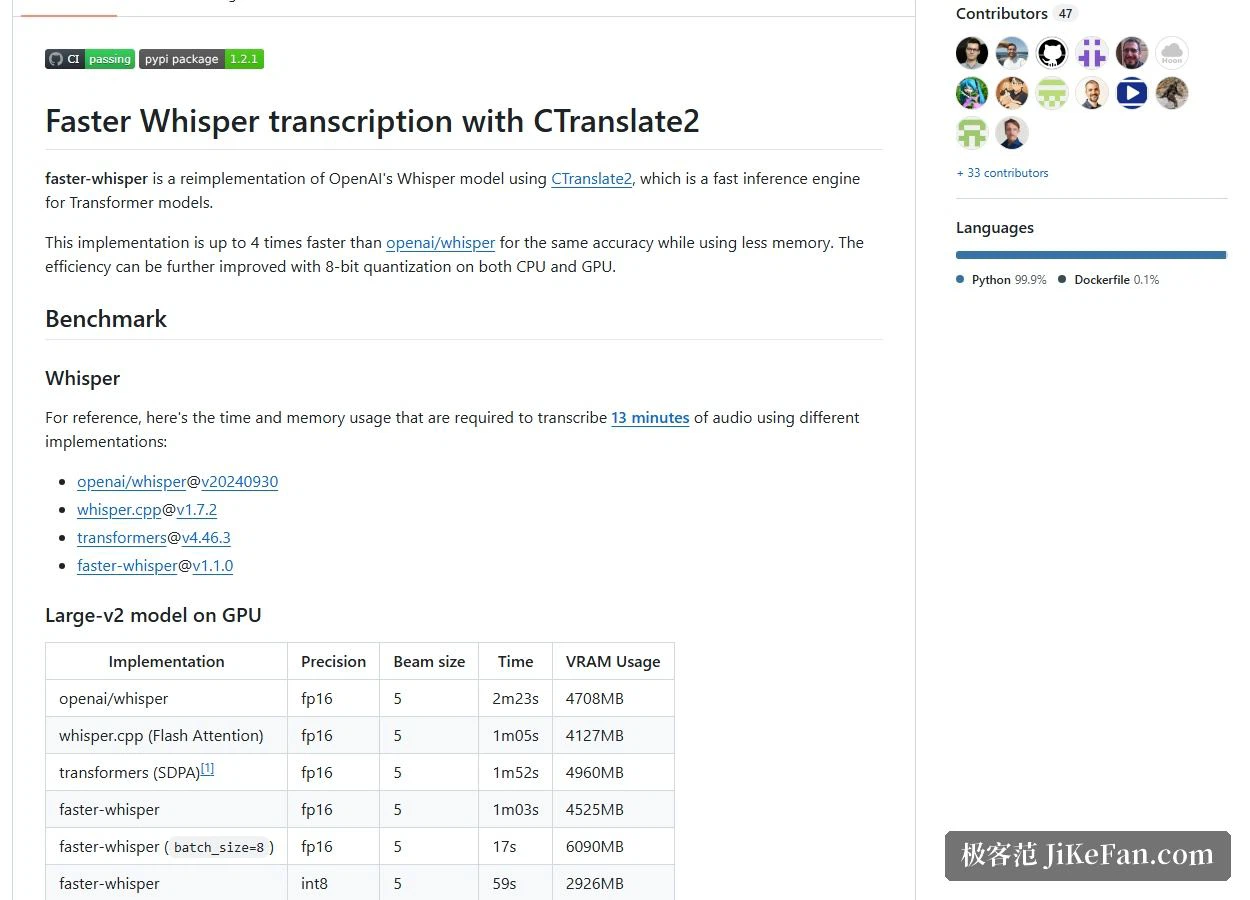
WhisperX の書き起こしの段は faster-whisper が担っている。こちらは独立したオープンソースの実装で、推論の仕組みである CTranslate2 の上に Whisper を書き直したものだ。同じ精度なら最大で元の 4 倍速く、メモリの使用も少ないと説明され、CPU でも GPU でも 8 ビットの量子化でさらに一段効率を上げられる。
書き起こしだけが必要で、語のアラインメントも話者の分離も要らないなら、こちらを単体で使うほうが軽い。導入はやはり pip 一行で、システム側の依存にも寛容だ。元の実装のように FFmpeg をシステムに入れておく必要はなく、音声のデコードは PyAV が担う。PyAV が FFmpeg のライブラリを自分のパッケージに同梱しているからだ。動かすには Python 3.9 以降が要る。
公式の基準測定にある数字
再現できる比較が用意されている。13 分の音声を、RTX 3070 Ti の 8GB で、large-v2 のモデル、精度は fp16、beam size は 5 という条件だ。
元の実装は 2 分 23 秒で 4708MB。Flash Attention を使う whisper.cpp は 1:05 で 4127MB。素の faster-whisper は 1:03 で 4525MB。まとめの大きさを 8 にすると faster-whisper は 17 秒で 6090MB。int8 にすると 59 秒で 2926MB、int8 にまとめ 8 を足すと 16 秒で 4500MB だった。
この表で見るべきはまとめの行だ。同じ fp16 の精度で、既定の一作ずつなら 1:03、まとめにすると 17 秒。ビデオメモリが厳しければ int8 で 2926MB まで下げられる。CPU 側の数字もある。小さなモデルを 8 スレッドのデスクトップ向け CPU で回すと、元の実装は 6 分 58 秒、faster-whisper の int8 まとめは 51 秒になる。
公式は、実装どうしを比べるときは条件をそろえよとも注意している。同じ beam size、近い認識精度、CPU なら同じスレッド数でなければ数字に意味はない。たとえば元の実装の既定は beam size が 1、faster-whisper の既定は 5 だ。
Python から呼ぶと扱いやすい
自分のスクリプトに組み込むなら、faster-whisper の窓口は数行で済む。モデルの大きさ、装置、計算の精度を指定し、書き起こしを呼ぶ。気をつけたいのは、返ってくる結果が生成器だという点だ。実際の計算はそれをたどり始めたときに起きるので、一覧に変換するか繰り返しで取り出す。そうしないと、何も走っていないように見える。まとめ処理は別の窓口で、モデルを包んでまとめの大きさを渡す。語ごとの時刻は指定をオンにすれば一語ずつ始まりと終わりが得られる。長い無音を落としたいときは VAD の絞り込みをオンにする。既定では 2 秒を超える無音だけが除かれ、この境目は自分で変えられる。
先に知っておきたい制約
語のアラインメントは万能ではない。公式がはっきり挙げているのは次のとおり。年の略記や通貨記号を伴う金額のように、アラインメントのモデルの語彙に無い書き方は時刻を与えられず、タイムスタンプも付かない。声が重なる状況は Whisper も WhisperX も得意ではない。話者の分離そのものも完璧にはほど遠い。さらにアラインメントのモデルは言語ごとに用意されるので、言語を変えればモデルも変わる。
ライセンスは BSD と MIT
WhisperX は BSD、faster-whisper は MIT で公開されていて、どちらもリポジトリの直下に許諾の文書を置いている。緩い条件なので、自分の字幕の流れに組み込むのも、その上で手を加えるのも、許認可でつまずくことはほとんどない。
どんな人に向くか
長い音声をそのまま使える字幕のファイルにしたいなら、WhisperX の値打ちはこの流れにある。時刻は語まで届き、複数人が出てくる内容でも話者を見分けられ、コマンドラインと Python の両方から今ある処理に差し込める。large-v2 で実時間の 70 倍とあれば、数時間におよぶ素材では差がはっきり出る。
ただし、入れて終わりのデスクトップアプリを目指してはいない。環境は自分で組み、モデルと言語も自分で選ぶ。多くの人にとって本当の壁は命令ではなく、カードとモデルの大きさの取捨になる。録音を手早く文字にしたいだけで、語ごとの時刻が要らないなら、faster-whisper を単体で使うほうが楽だ。