
十分の音声で別の声を作る、RVC のその場の声変換と遅れの数字
要約
声質の変換とその場の声チェンジを行うオープンソースの枠組み。学習には少なくとも十分の静かな音声が要り、端から端までの遅れは 170 ミリ秒に届く。画面も二種類そろっている。
おすすめ- ソフト名
- RVC
- バージョン
- 2.3.260718
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinux
- 更新日時
- 2026-10-06 23:15
音声合成とは別の仕事
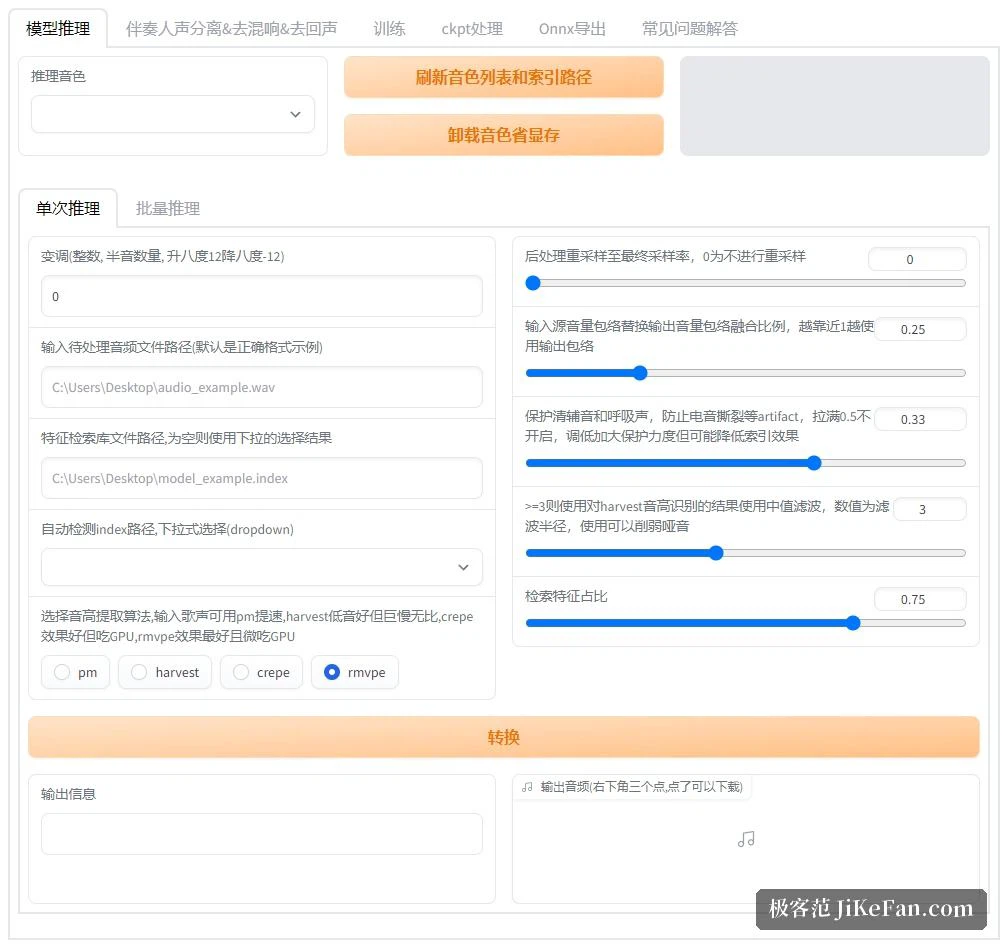
RVC は Retrieval-based-Voice-Conversion-WebUI の略で、公式は自分を「簡単で使いやすい声質の変換と声チェンジの枠組み」と説明している。やることは音声合成とは違う。文字から音声を作るのではなく、すでに録られた声を別の声質に置き換える。
この種の道具は以前は敷居が高かった。RVC はそれを二つの数字に縮めた。学習に最低 10 分の音声が要ること、その場の声チェンジで端から端までの遅れが 170 ミリ秒であること。
入力は声そのもので、台本ではない。録音を渡すと、内容は同じで声質だけ目標のモデルに変わった版が返る。変わるのは誰が話しているかで、何を言っているかではない。
公式が挙げる最初の性質は、top1 の検索で入力元の特徴を学習側の特徴に置き換え、声質の漏れを防ぐというものだ。検索される特徴は学習に使ったデータそのものから来るので、出力は目標の声に寄り、入力元の訛りや録音の質をそのまま持ち込まない。
十分のデータで学習できる
公式は少なくとも 10 分の、底の雑音が低い音声を集めるよう勧めていて、少ない量でもそれなりの結果が出ると添えている。この規模なら防音の部屋は要らず、静かな室内の録音でほぼ足りる。
ハードウェアの要求も同じくらい控えめだ。比較的弱いカードでも学習は速いと公式は明記している。土台のモデルは、公開されている高品質な VCTK の資料、およそ 50 時間で学習されていて、権利上の心配はないと公式は述べる。加えて、チェックポイントの項目にある ckpt-merge でモデルを混ぜ、声質をさらに動かせる。
導入は依存を三つに分ける
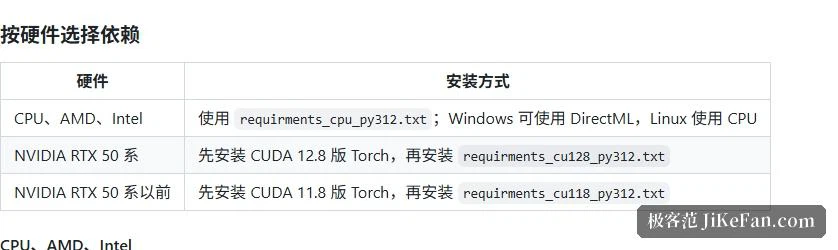
この枝は 64 ビットの Python 3.12 を対象にし、Ubuntu 側は 24.04 を勧める。依存はハードウェアで三つに分かれる。CPU と AMD、Intel は一つのファイルを共用する。Nvidia は新旧で分かれ、RTX 50 の系列は先に CUDA 12.8 版の Torch、RTX 50 より前は先に CUDA 11.8 版の Torch を入れ、そのあとでそれぞれ対応する依存のファイルを入れる。順序が大事で、Torch が先、依存が後だ。入れたあとは一行の命令で Torch と CUDA の版が出るので、先に環境を確かめてから先へ進む。
AMD と Intel のカードは CPU の依存の道を通る。Windows では DirectML、Linux ではそのまま CPU。Nvidia 以外でも動くが、計算力の差は受け入れることになる。
モデルは正しい場所に置く
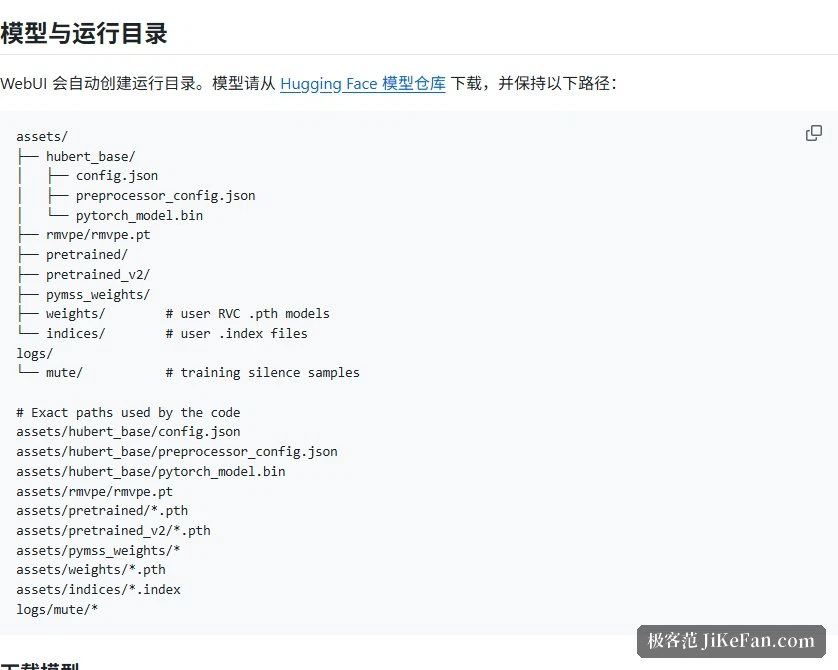
画面は動作に必要なフォルダを自分で作るが、モデルは自分で落として決まった場所に置く。公式が求めるのは固定の構成だ。特徴の抽出に hubert_base、音程の抽出に rmvpe の重み、学習に pretrained と pretrained_v2、声の分離に pymss_weights、利用者のモデルに weights、索引に indices。
取得もコマンドラインの道具を使い、用途ごとに組が分かれている。推論と特徴の抽出に要る組、v1 と v2 の学習に要る組、声の分離で使う任意の組。Windows の DirectML の環境だけは、onnx 形式の音程の重みを別に要する。さらに Windows では FFmpeg の二つの実行ファイルを自分でプロジェクトの直下に置く。
その場の声チェンジと遅れ
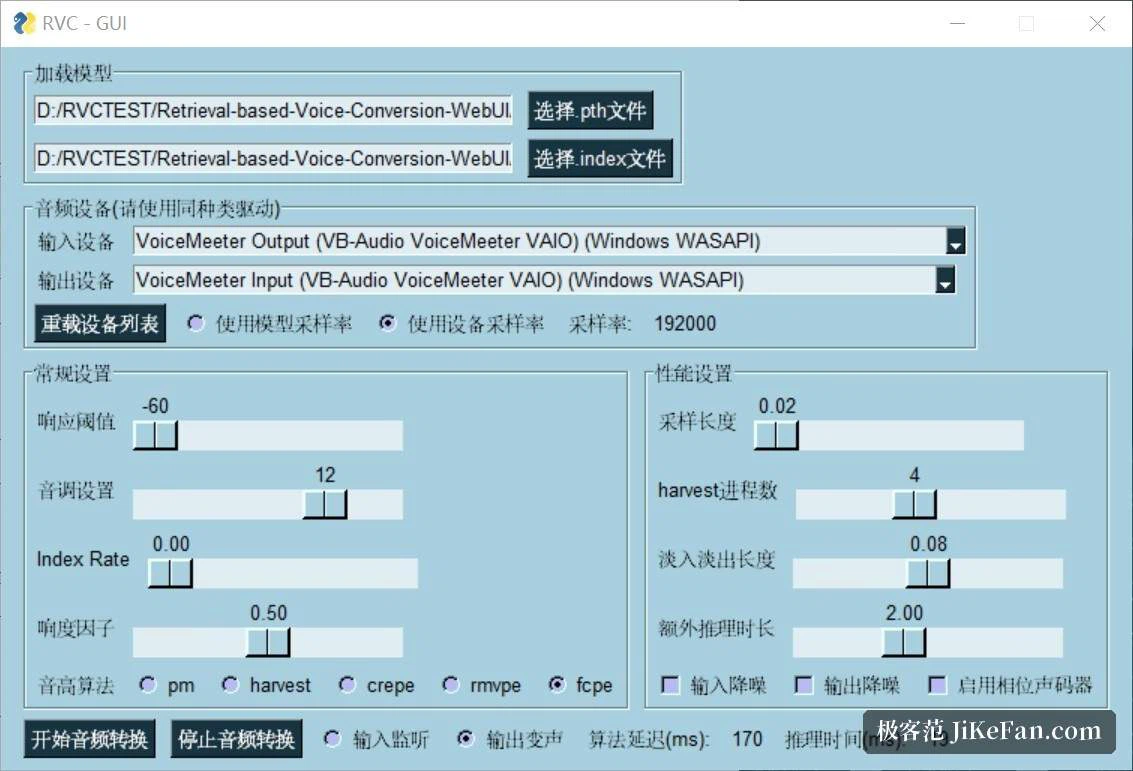
入口は二つ用意されている。画面と、独立したその場の声チェンジの画面だ。ここで見るべきは遅れで、端から端まで 170 ミリ秒を実現したと公式は述べる。ASIO の入出力の機器を使えば 90 ミリ秒にできるが、これはハードウェアのドライバの支えに大きく左右されると公式も認めている。
この水準まで縮められた鍵の一つが音程の抽出だ。公式は InterSpeech2023 の RMVPE という方式を使い、評価として「こもった声の問題を断ち、速く、資源の使用も小さい」と書く。画面から pm、harvest、crepe に切り替えることもできる。
起動の仕方と許諾
起動は一行で、既定では 7865 番のポートを見張る。画面の無い Ubuntu のサーバーでは、ブラウザを自動で開く動きを飛ばす指定を足せる。利用者のモデルは weights、索引は indices のフォルダに置く。
許諾は MIT で、土台のモデルは公開された VCTK の資料を使っており、権利上の心配はないと公式は述べる。ただし一つは自分の責任になる。声質の変換は他人の声を扱うので、結果を公開する前に、相応の許しを得ているかを確かめたい。
まとめると、RVC の面白さは二つの数字に集まる。学習に十分の音声、その場の変換で 170 ミリ秒。かつては設備と時間の問題だった工程が、静かな部屋と一枚のカードに収まった。そのぶん扱いには注意が要る。声はその人自身のものだからだ。