
F5-TTS は MIT のコードと非商用の重みを並べて配る、導入は pip 一行
要約
フローマッチングで音声を合成するオープンソースのプロジェクト。pip パッケージ、コマンドライン推論、Gradio の画面を用意する。コードは MIT だが、学習済みの重みは学習データの都合で非商用に限られる。
おすすめ- ソフト名
- F5-TTS
- バージョン
- 1.1.22
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinuxmacOS
- 更新日時
- 2026-10-06 20:44
F5-TTS は一本の論文の公式実装で、その論文の題は遊び心がある。フローマッチングで流暢で忠実な音声を偽装する語り手、というものだ。名は軽いが、技術の道筋は軽くない。合成はフローマッチングで行い、骨格には Diffusion Transformer と ConvNeXt V2 を組み合わせる。
プロジェクトはオープンソースで、すでに二十を超える版を公開しており、リポジトリには基本モデルと、推論、学習、配備のためのコードが並んで置かれている。
三つの鍵:フローマッチング、ConvNeXt V2、Sway Sampling
公式の説明は三つを並べて要点にしている。一つ目は F5-TTS そのもので、Diffusion Transformer に ConvNeXt V2 を組み合わせ、公式の言葉では学習も推論も速い。二つ目は E2 TTS で、Flat-UNet Transformer の構成で作り直した版だ。三つ目は Sway Sampling で、推論段階でのフローの刻みのサンプリング方針であり、生成の出来を明確に良くすると公式は言う。
使う側から見れば、最初の二つがモデルの能力の上限を決め、三つ目が同じモデルから何を引き出せるかを決める。Sway Sampling が独立した行をもらっているのは、推論の時点で効き、学習し直しが要らないからだろう。
導入:pip 一行、あるいは Docker に切り替える
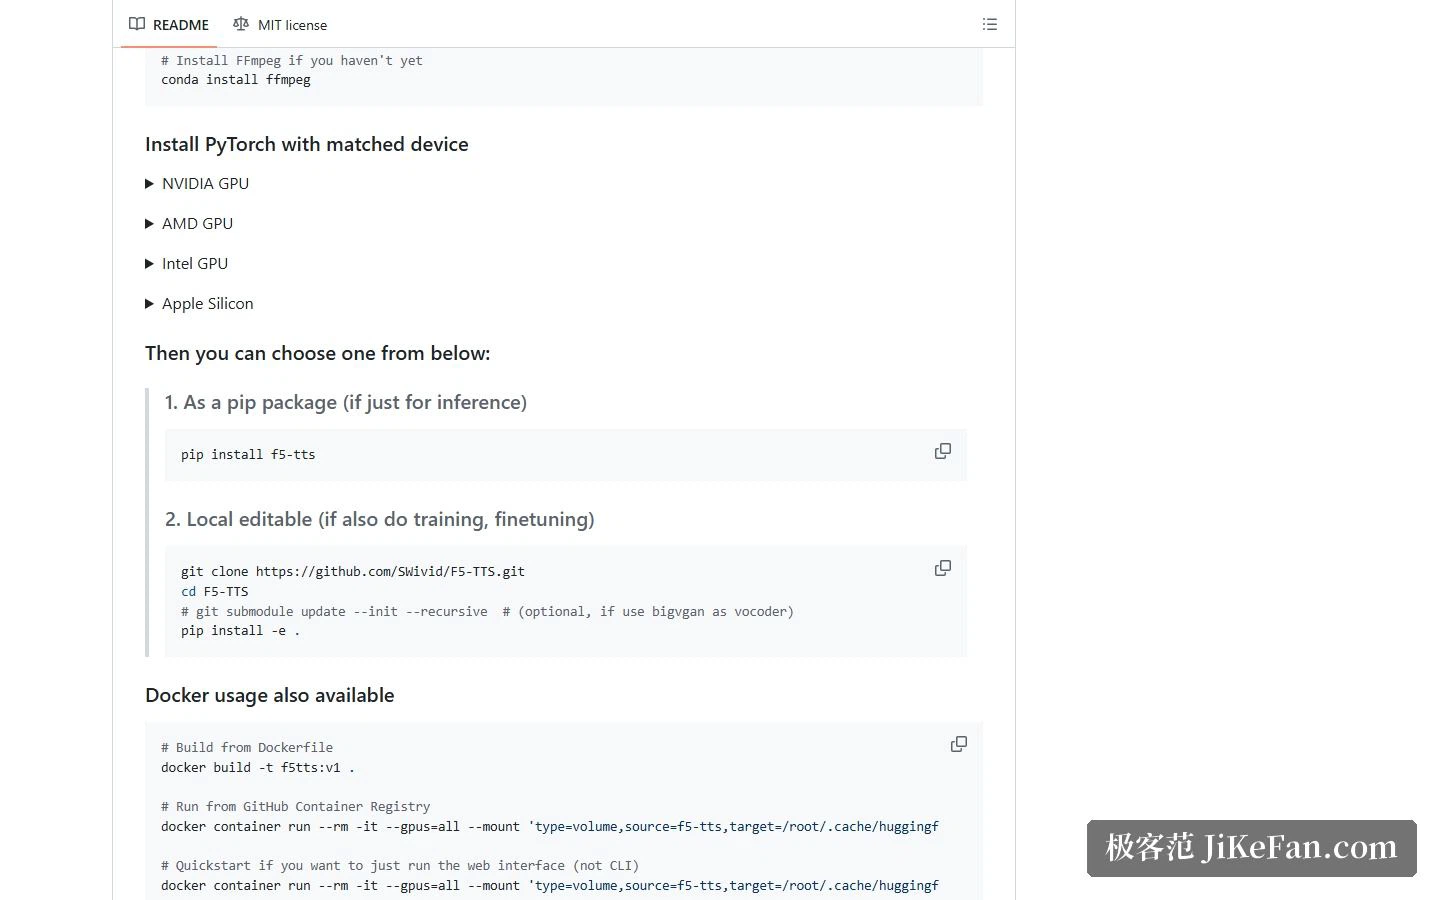
導入は何をしたいかで二つに分かれる。推論だけなら pip パッケージで足りる。学習や調整まで行うなら、リポジトリを複製して編集可能インストールにする。PyTorch を入れる前に、自分の機器に合わせて版を選ぶ必要があり、公式は NVIDIA、AMD、Intel、Apple Silicon それぞれのコマンドを用意している。
もう一つの道が Docker だ。リポジトリの Dockerfile から自分で建てることも、公式のイメージを引いて動かすこともでき、公式は画面だけを立ち上げる短いコマンドまで用意している。
三つの使い方:コマンドライン、画面、音声での対話
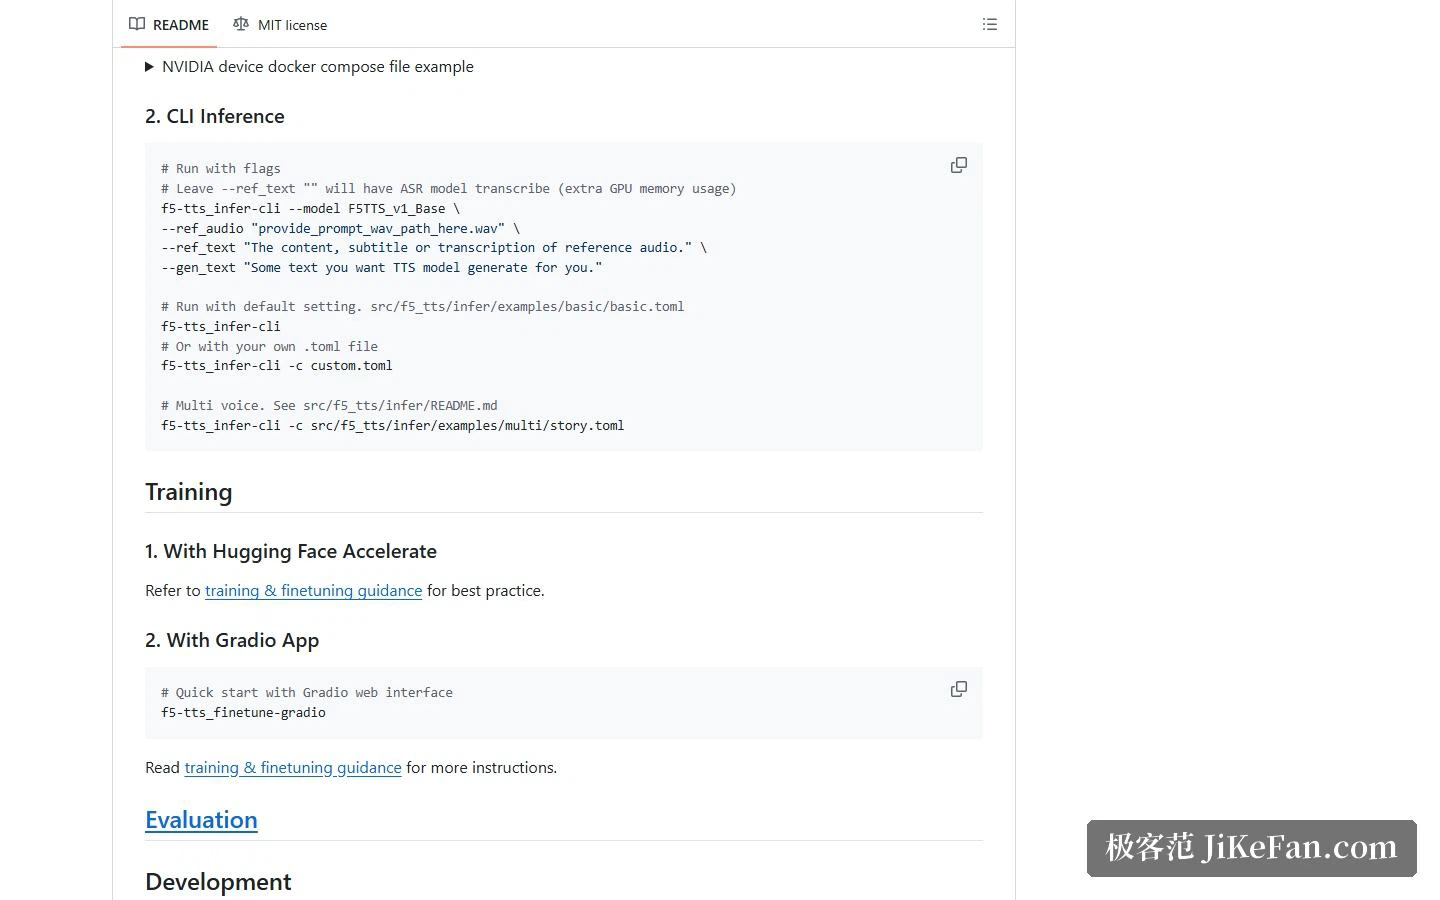
コマンドラインの引数は分かりやすい。参照の音声を一つ、その音声に対応するテキストを一つ、そして生成したい文を一つ渡せば、モデルは参照音声の声質で目標の文を読み上げる。細かい点が一つある。参照テキストは空のままでもよく、その場合は音声認識モデルが自動で書き起こす。代わりにメモリをいくらか余分に使う。
コマンドラインに触れたくないなら、Gradio の画面を立ち上げればいい。公式が挙げる機能は基本の合成にとどまらず、複数のスタイルと複数の話者での生成、さらに三十億パラメータ級の指示調整済み言語モデルが動かす音声対話まで含む。つまりこの画面は、文字を音声にするだけでなく、音声でのやり取りを一往復こなせる。
性能の数字:L20 一枚で測った結果
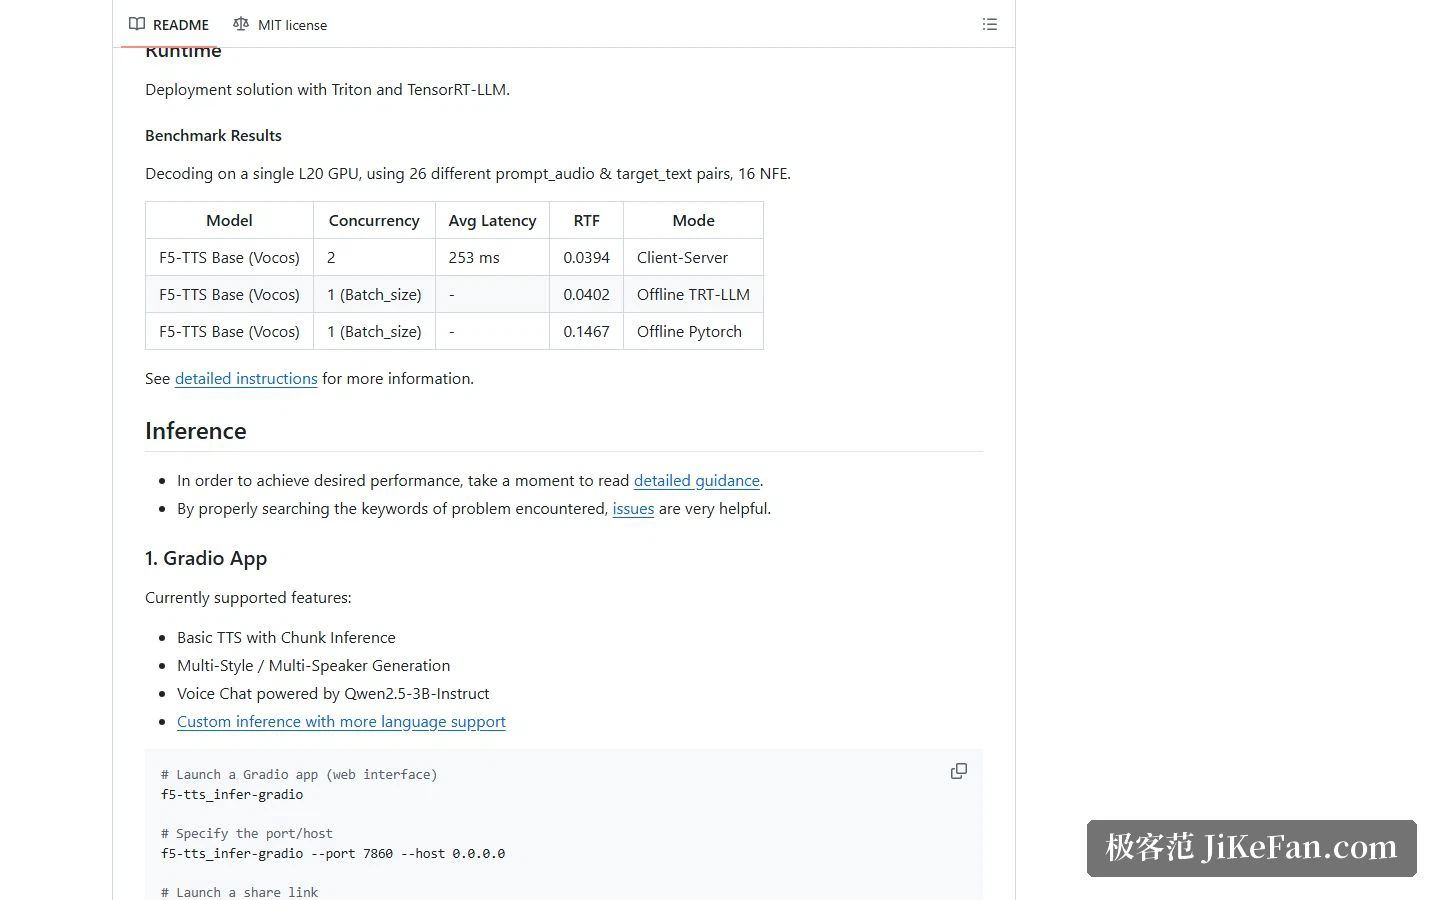
配備の節にベンチマークがある。L20 のカード一枚、参照音声と目標テキストの組を 26 通り、推論は 16 ステップ。F5-TTS Base は同時接続 2 のクライアント・サーバー方式で平均遅延 253 ミリ秒、リアルタイム率はおよそ 0.0394。オフラインの TensorRT-LLM では 0.0402、オフラインの PyTorch では 0.1467 になる。率が低いほど、生成が再生よりどれだけ先を走るかという倍率が大きい。三つの数字の開きが、配備の選び方の差をそのまま示している。
学習と調整
学習も同じように二本に分かれる。一つは Hugging Face Accelerate を通る道で、通常の学習と調整に向く。もう一つは Gradio の画面で、公式は調整専用の画面を立ち上げるコマンドを用意しており、コードを書かずに動かせる。モデルを好みの声質に寄せたいだけの人には、後の道のほうがはるかに楽だ。
ライセンス:コードは MIT、モデルは非商用
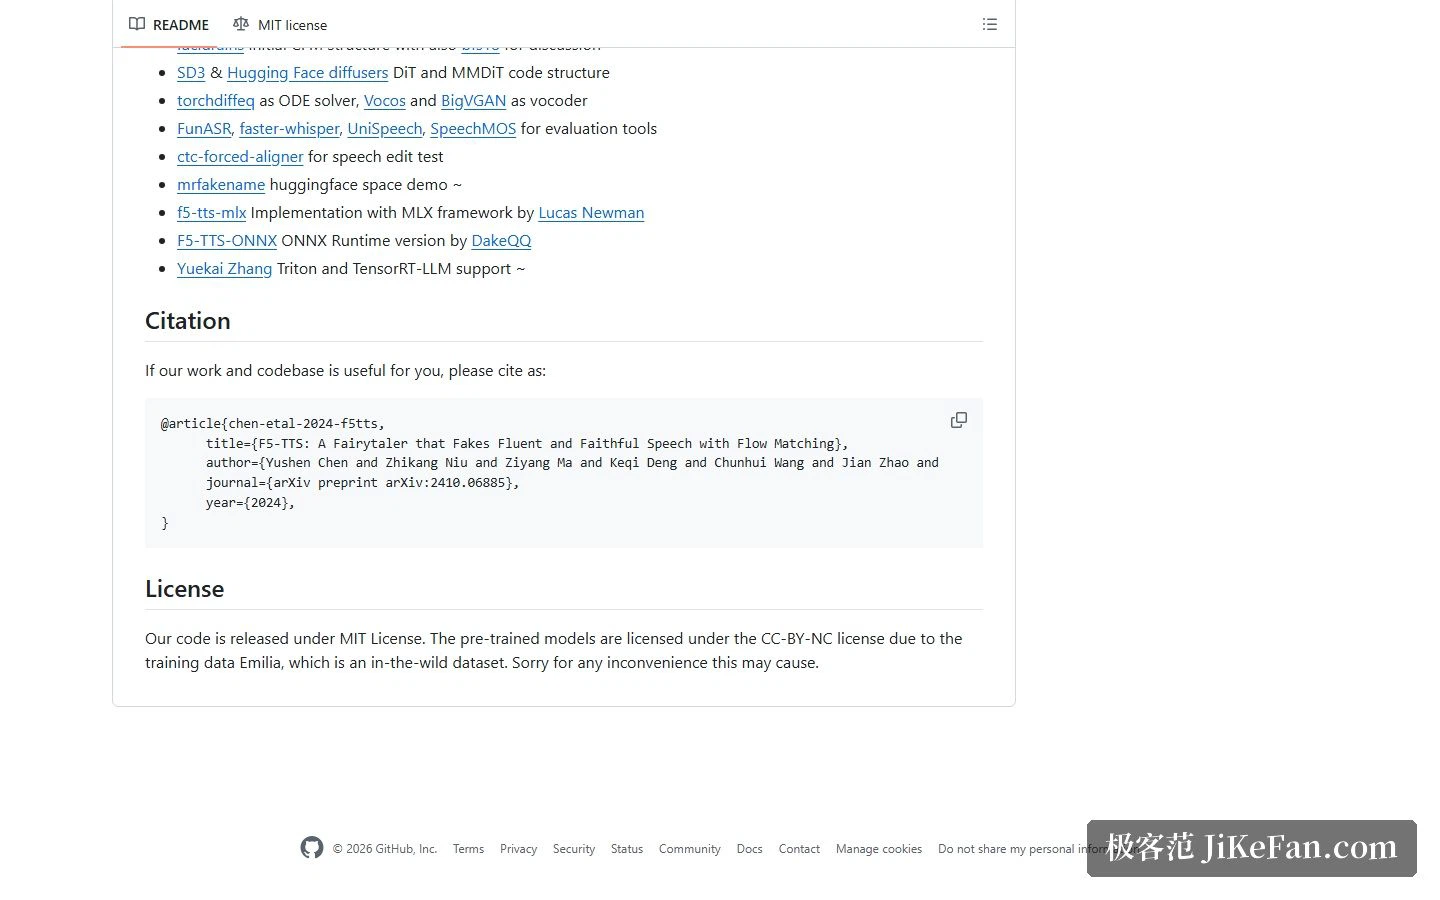
ここは丁寧に読むべきところだ。ライセンスの節には、コードは MIT で公開するが、学習済みモデルの許諾は別だと書かれている。学習データが野外で集めたものだから、学習済みモデルは非商用の Creative Commons ライセンスになる。公式は同じ段落でそのことについて詫びている。
つまりコードの上で自由に作り込むことはできるが、公式の学習済みモデルをそのまま商用の案件に持ち込むと許諾の壁に当たる。避けるには、より緩い許諾のデータセットで自分で学習し直すのが普通で、そこには追加の計算資源とデータの用意が要る。
どんな人に向くか
研究者や開発者として、構造が明快で開発も活発なオープンソースの音声合成で実験したいなら、コードの質も文書の揃い方も悪くない。導入の道が複数あり、配備は Triton と TensorRT-LLM が用意され、推論も学習も入り口がそろっている。
逆に、そのまま商用に使える音声合成の手段が欲しいだけなら、まずライセンスの問題を解くか、自分で学習する費用を見積もる必要がある。どのモデルを使うにせよ、声の複製の許諾の境目は先に確かめておきたい。他人の声、とりわけ公人の声でコンテンツを作るのは、人格権と声の権利に触れうる。
オープンなプロジェクトは能力を卓上に並べ、制約をライセンスの節に書く。使い始める前に二分読むほうが、あとで作り直すよりたいてい安く済む。