
Whisper は六つの大きさで配られ、選ぶ決め手はビデオメモリになる
要約
文字起こしと英語への翻訳、言語の判定を一つの流れでこなす汎用の音声認識モデル。大きさは約 3900 万から約 15.5 億パラメータまで六種類。コードも重みも MIT ライセンスで配布される。
- ソフト名
- Whisper
- バージョン
- 15.5
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinuxmacOS
- 更新日時
- 2026-10-06 16:03
一つのモデルが鎖を置き換える
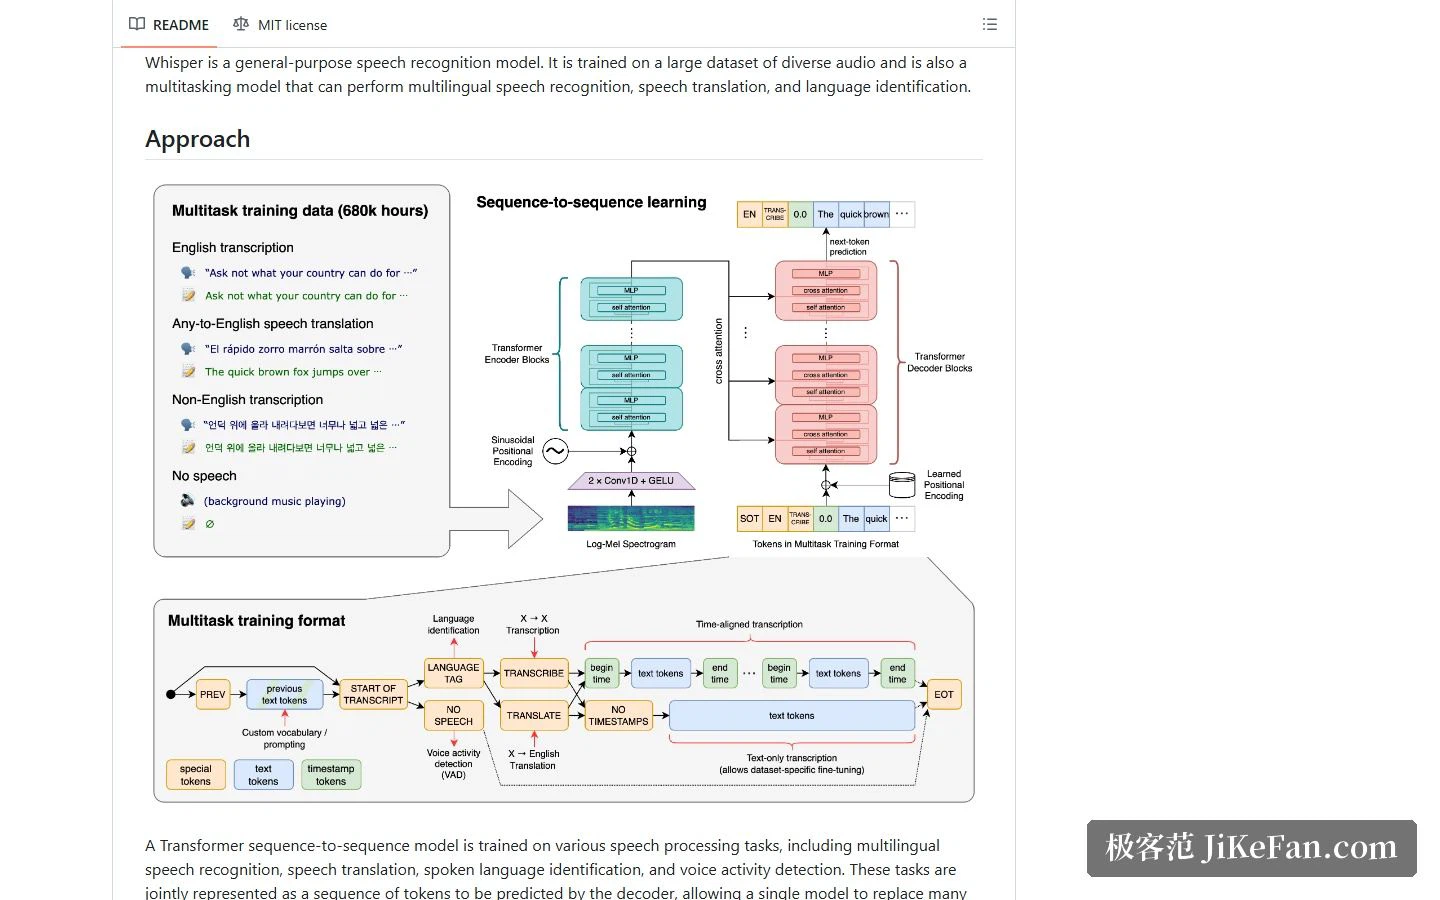
Whisper は、一連の流れを一つのモデルで置き換える類のプロジェクトだ。従来の音声処理はいくつもの段を踏む。まず言語を見分け、次に書き起こし、翻訳が要るなら別のモデルを後ろにつなぎ、音声活動の検出はまた独立した一手順として横に置かれる。Whisper はこれらの課題を、デコーダが予測する一続きのトークンにまとめ、一つのエンコーダ・デコーダ構成の Transformer の中で一緒に学ばせる。
リポジトリが示す多課題の学習データは 68 万時間で、多くの言語とさまざまな録音条件から集められている。掲げる目標はそっけない。汎用の音声認識モデル、それだけだ。
四つの能力、翻訳は一方向だけ
公式の一覧は四項目。多言語の書き起こし、音声翻訳、話し言葉の言語判定、音声活動の検出。ここでいう翻訳は、英語以外の音声をそのまま英語のテキストにすることを指す。任意の言語対の相互翻訳ではない。流れを組み立てる前に、この違いを押さえておきたい。一方向だと分かったうえで設計に入るべき箇所だ。
長い録音は 30 秒の窓に切る
長い音声はスライドする窓で扱う。説明によれば、書き起こしの呼び出しはファイル全体を読み込み、30 秒を一つの窓として区間ごとに自己回帰で予測する。一時間の録音なら百を超える窓が連続して処理されることになり、自分で切ってから渡す必要はない。
六つの大きさをどう選ぶか
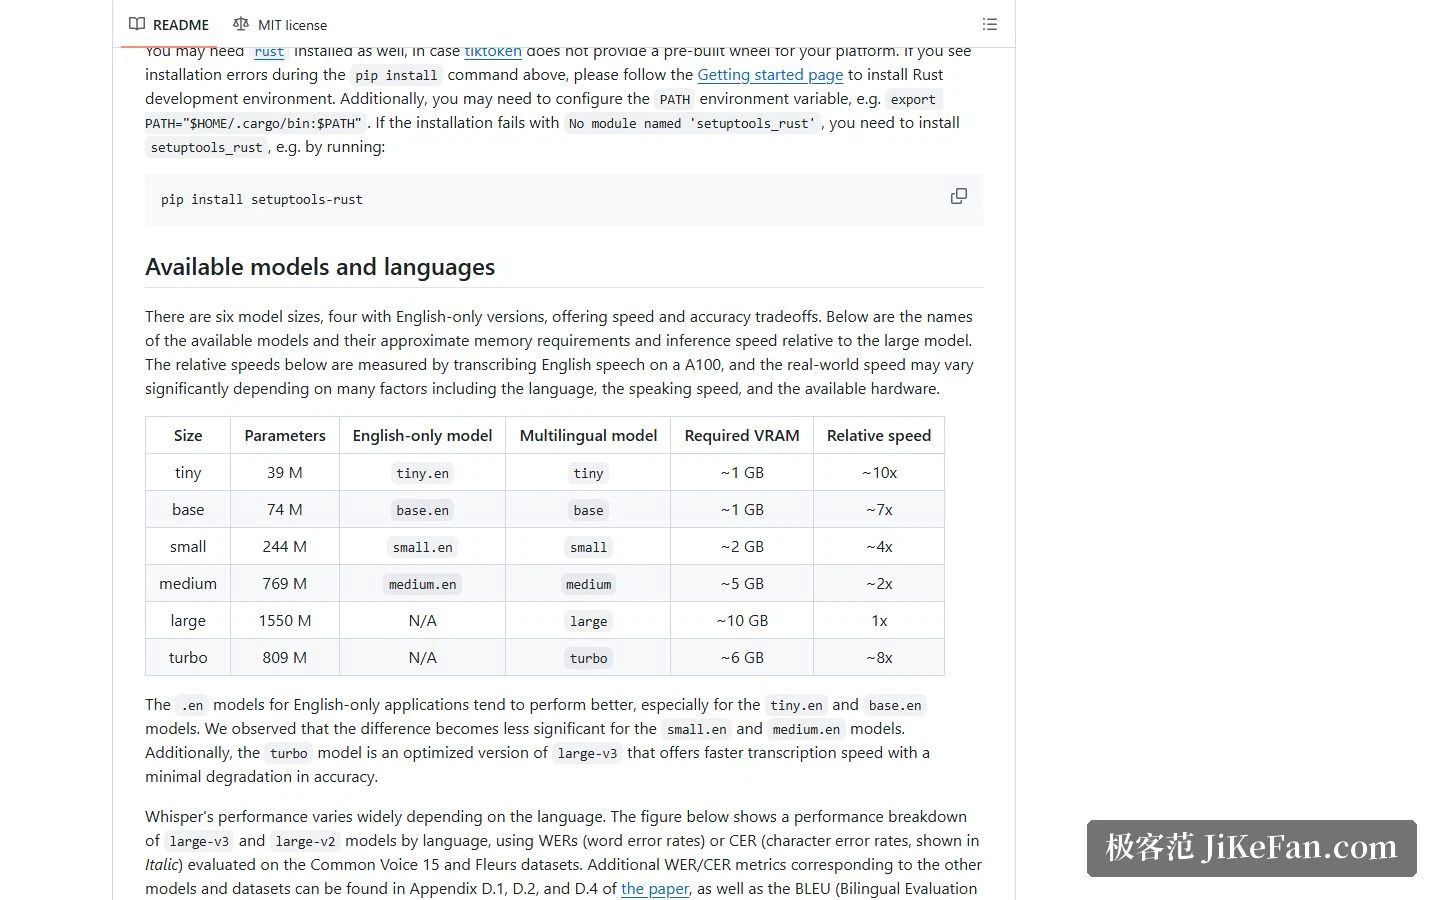
まず最初に見るべき表だ。大きさは六つあり、パラメータは tiny の約 3900 万から large の約 15.5 億まで、必要なビデオメモリは約 1GB から約 10GB まで上がる。相対速度の列は large を基準にしていて、tiny はおよそ 10 倍、turbo はおよそ 8 倍。速さと大きさはほぼ滑らかなトレードオフの曲線を描く。
メモリが厳しいときは、tiny と base がどちらも約 1GB に収まる。普通のノート PC でも無理はない。精度を上げたいなら medium と large に上がる。真ん中の turbo は別に触れておきたい。large-v3 の最適化版だと説明されていて、ごくわずかな精度の低下と引き換えに書き起こしを明らかに速くする。折衷案という位置づけだ。
さらに tiny、base、small、medium の四つには英語専用版も用意されている。英語だけの作業ではこちらのほうが良い結果になりやすいと公式は見ている。ただしパラメータが大きくなるほど、その差は目立たなくなる。
導入は pip と ffmpeg 一つ
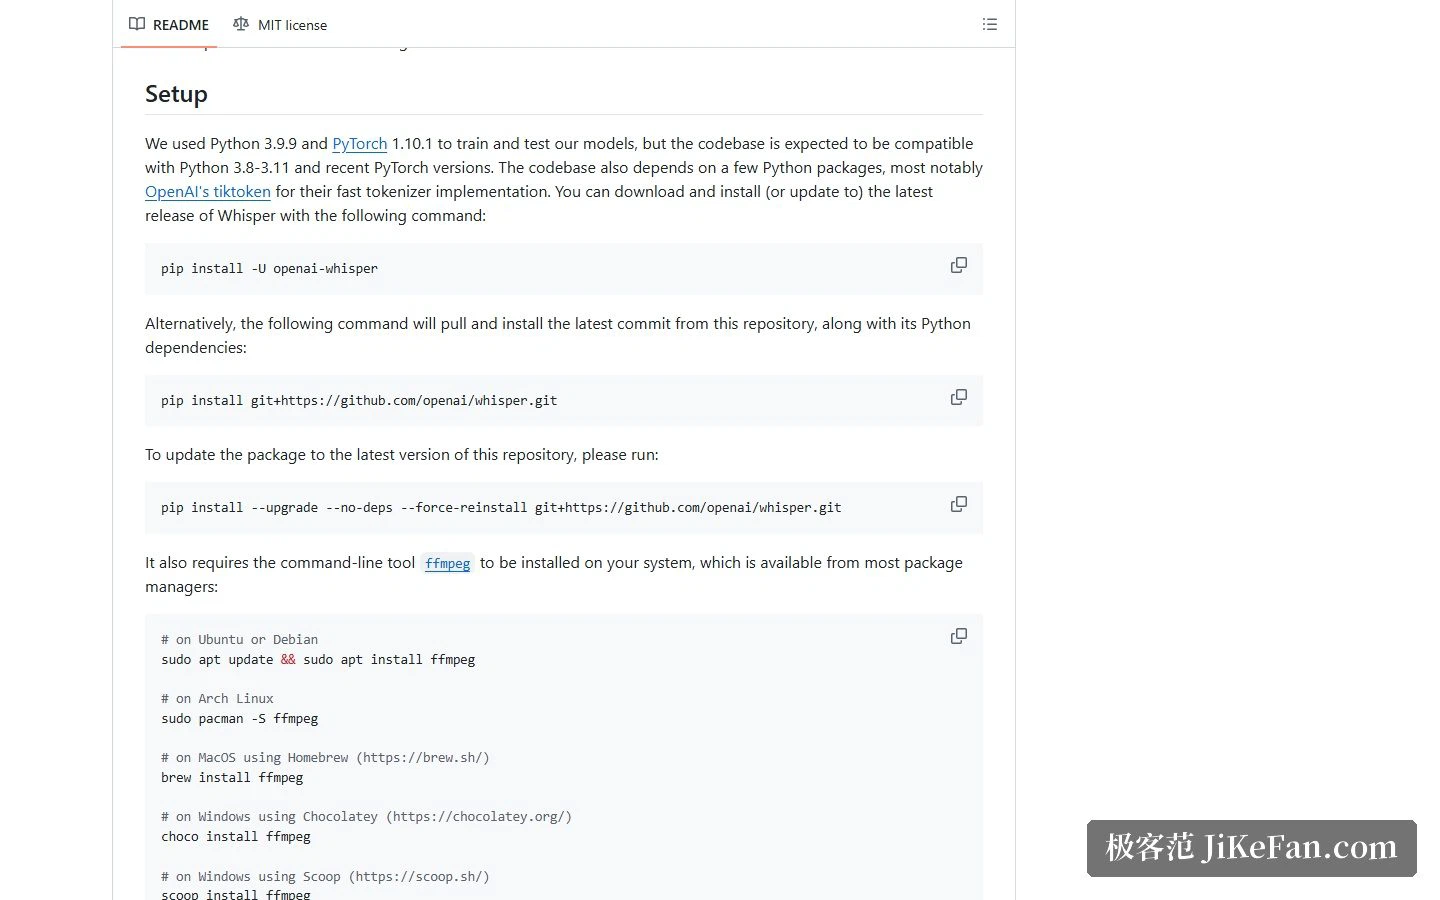
導入自体は pip の一行で済む。本当に気をつけるのはシステム側の依存で、Whisper は音声のデコードに ffmpeg というコマンドラインの道具を呼ぶ。公式は OS ごとの導入方法を並べていて、よく使われるパッケージ管理の仕組みはひととおり押さえられている。
もう一点。プラットフォームにビルド済みのトークナイザのパッケージが無い場合、pip の処理には Rust の環境が要ると公式は注意している。モジュールが見つからないというエラーが出たら、対応するパッケージを足せば解決する。対応版は Python 3.8 から 3.11、そして比較的新しい PyTorch となる。
二つの入口、コマンドラインと Python
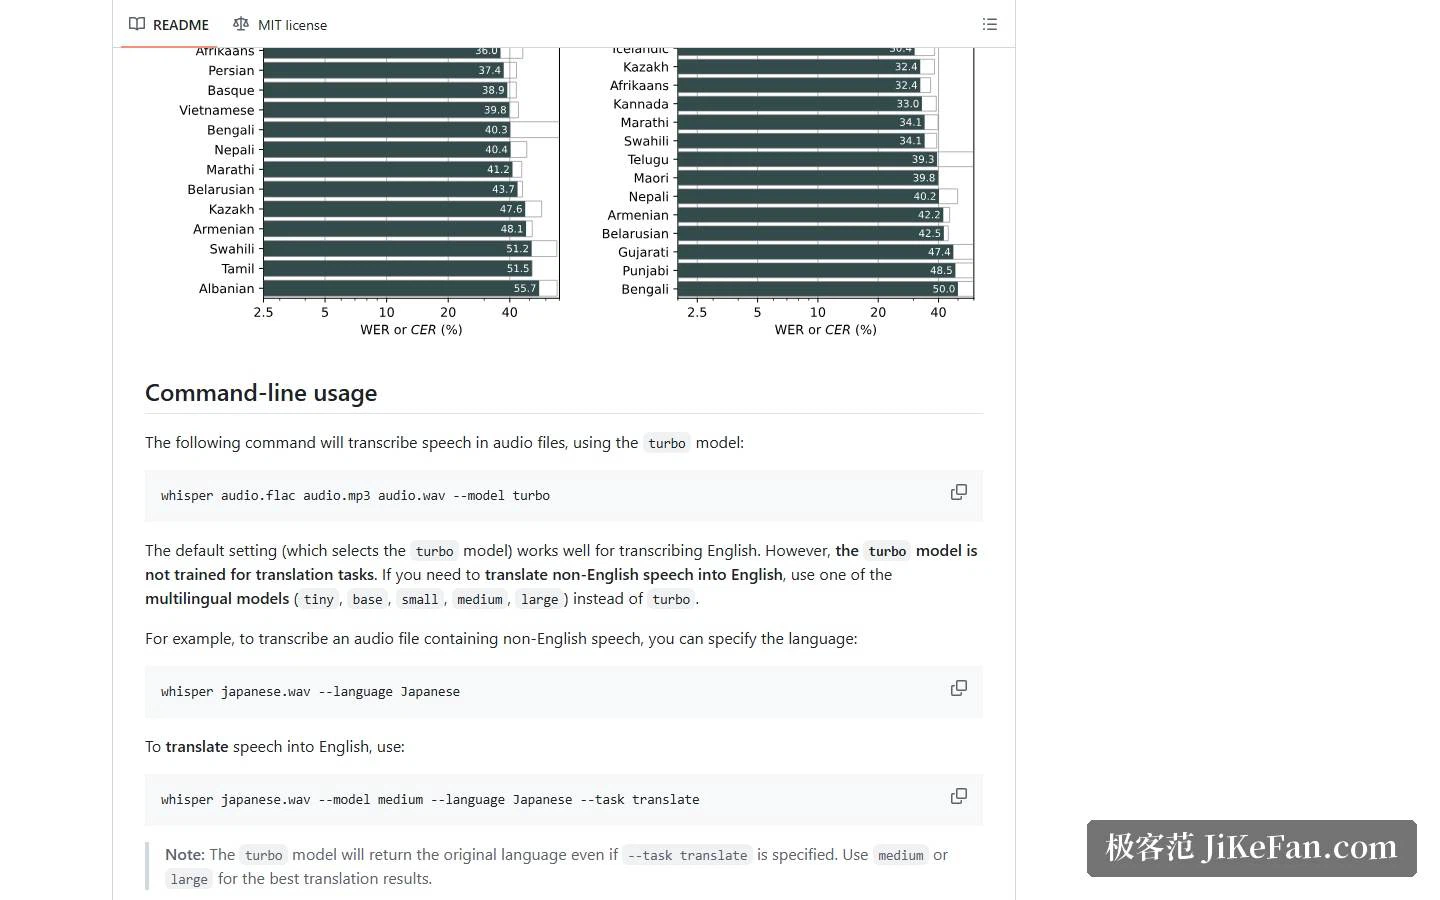
コマンドラインが最短の確認方法だ。音声ファイルを引数に置き、モデルの指定で大きさを選び、英語以外の音声なら言語の指定を加え、翻訳したいときは課題の指定を切り替える。
覚えておきたい制約がある。turbo は翻訳のために学習されていないと公式が明言している。翻訳を指定しても、返ってくるのは元の言語の内容だ。翻訳を使うなら tiny、base、small、medium、large の多言語モデルに戻す必要があり、公式は翻訳では medium か large が良いと勧めている。
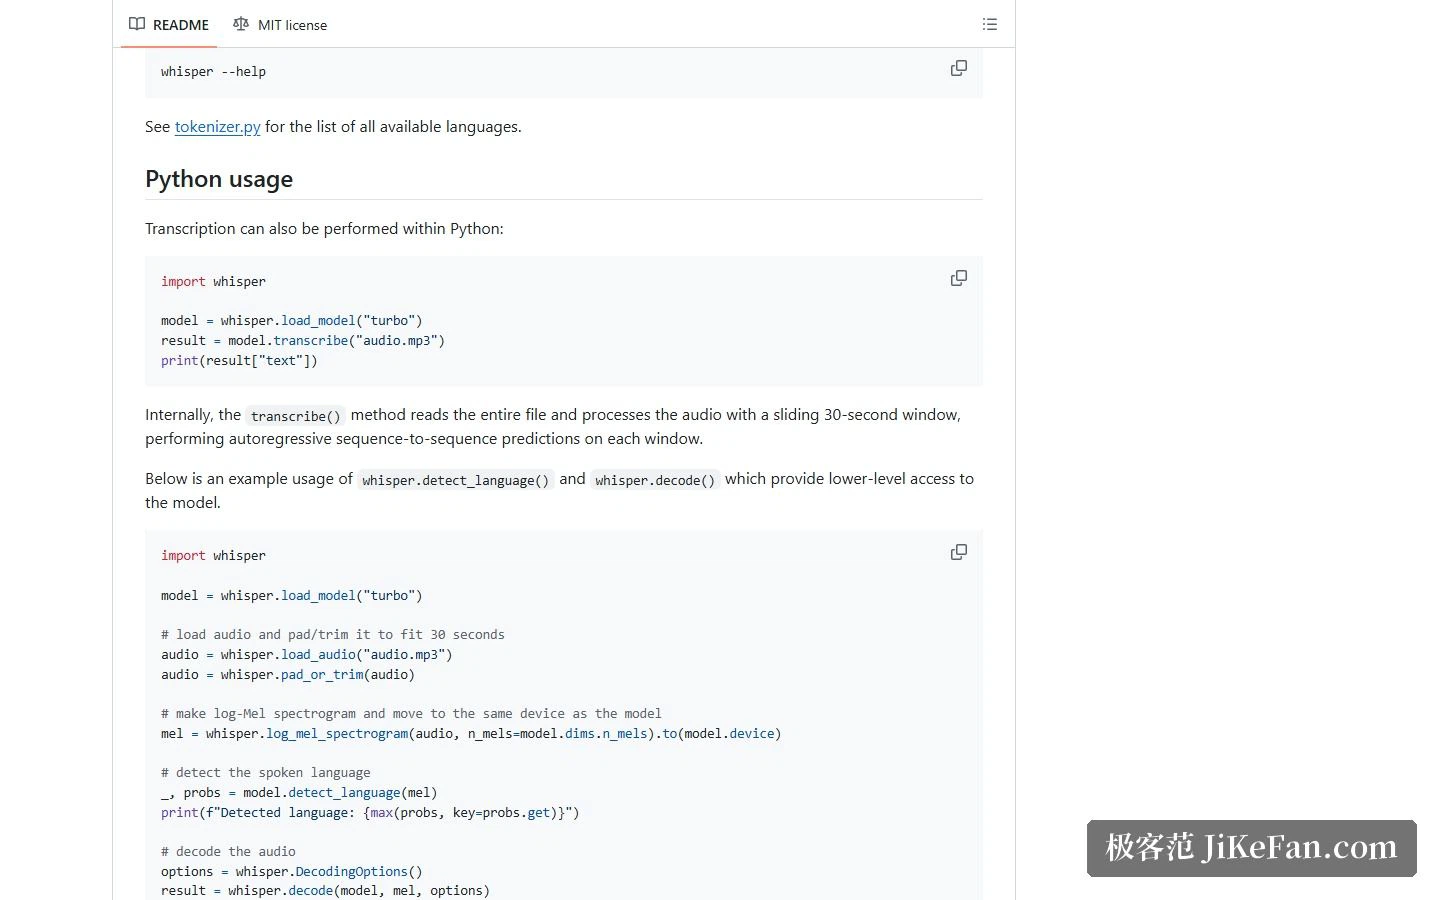
Python からの呼び出しも短い。モデルを読み込み、音声のパスを書き起こしのメソッドに渡し、結果からテキストの項目を取り出す。三手で足りる。より低い層のインターフェースも公開されていて、音声を自分で読み込み、対数メルスペクトログラムを計算し、言語判定やデコードを単独で呼び出せる。より複雑な処理に組み込むときに効く。
ライセンスは確かな利点になる
コードもモデルの重みも MIT ライセンスで配られ、商用の制限はごく少ない。音声認識の分野では当たり前ではない。多くのモデルは重みに別の、より厳しい条件を付けている。音声認識を自分の製品に組み込むなら、この一点で法務のやり取りがかなり減る。
どんな人に向くか
動画にまとめて字幕を付けたい、会議の録音を文字にしたい、自分のアプリにローカルの書き起こしを足したい。そういう要件なら入口の敷居は低い。導入に一行、実行に一行、六つの大きさは小さいほうから試して、足りなければ上げればいい。MIT ライセンスがあるので、組み込みが動いたあとに書類の話が戻ってくることもない。
万能ではない。翻訳は英語に向かう一方向だけ。即時性が要る状況では、まず自分のハードウェアで追いつくかを評価する必要がある。騒がしい環境での精度は録音の質にそのまま従う。オフラインの書き起こし道具として見るなら、期待は裏切られにくい。
コードが開かれ、許諾が緩いことが、多くのプロジェクトが Whisper を既定の選択にする理由だ。道具そのものの敷居はもう低い。残る差はたいてい、渡す音声がどれだけきれいかにある。