
GPT-SoVITS は一分の音声で声を調整し、五秒でゼロショット合成する
要約
オープンソースの音声合成 WebUI。五秒の人声があればゼロショットで合成でき、一分の音声データがあればより近い声質に調整できる。推論は中国語、英語、日本語、韓国語、広東語の五つをまたげる。
おすすめ- ソフト名
- GPT-SoVITS
- バージョン
- 20260917
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinuxmacOS
- 更新日時
- 2026-10-06 18:49
機械にある人の話し方を覚えさせる敷居は、この数年下がり続けている。GPT-SoVITS はその線を二つの数字まで押し下げた。五秒と一分だ。五秒は人声サンプルの下限で、これがあればゼロショットでそのまま音声を合成できる。一分は学習データの下限で、これで調整すると声質の近さが目に見えて上がる。プロジェクトはオープンソースで、リポジトリの見出しも率直だ。一分の音声データでも使える TTS モデルは作れる、と書いてある。
二つの道:学習しないか、少しだけ学習するか
公式は機能を二本の道に分けていて、それぞれ違う種類の需要に対応する。
ゼロショット TTS は手間のいらない道だ。五秒の人声サンプルを入れれば、その場で文字が音声になる。まず出来を見たい人、たまにしか使わない人に向く。学習待ちも、データセットの用意も要らない。
少数データ TTS は音の良い道だ。一分の学習データが、より高い類似度と自然な聞こえ方をもたらす。一分という敷居の意味は、取り除かれるもののほうにある。自分の音声モデルを訓練するのは、何時間も録音する専門仕事ではなく、スマートフォンで一段落録れれば試せる作業になった。
どの言語を話すか
公式に挙がる言語は英語、日本語、韓国語、広東語、中国語だ。もっと面白いのは言語をまたぐ推論のほうで、合成時に使う言語は学習データの言語と一致していなくてよい。ある言語で録ったサンプルを、理屈の上では別の言語を話させるのに使える。言語ごとにデータを用意し直す必要はない。
WebUI にデータ準備の道具が入っている
実際に声を複製したことのある人なら分かる。難しいのはモデルではなく、前段の下ごしらえだ。録音に背景音楽が混ざっていたらどうするか、長い音声をどう切るか、切ったあとの書き起こしを誰が書くか。GPT-SoVITS はその工程を WebUI の中に入れた。人声と伴奏の分離、学習セットの自動分割、多言語の音声認識によるラベル付け、そしてテキストの注記まで含む。
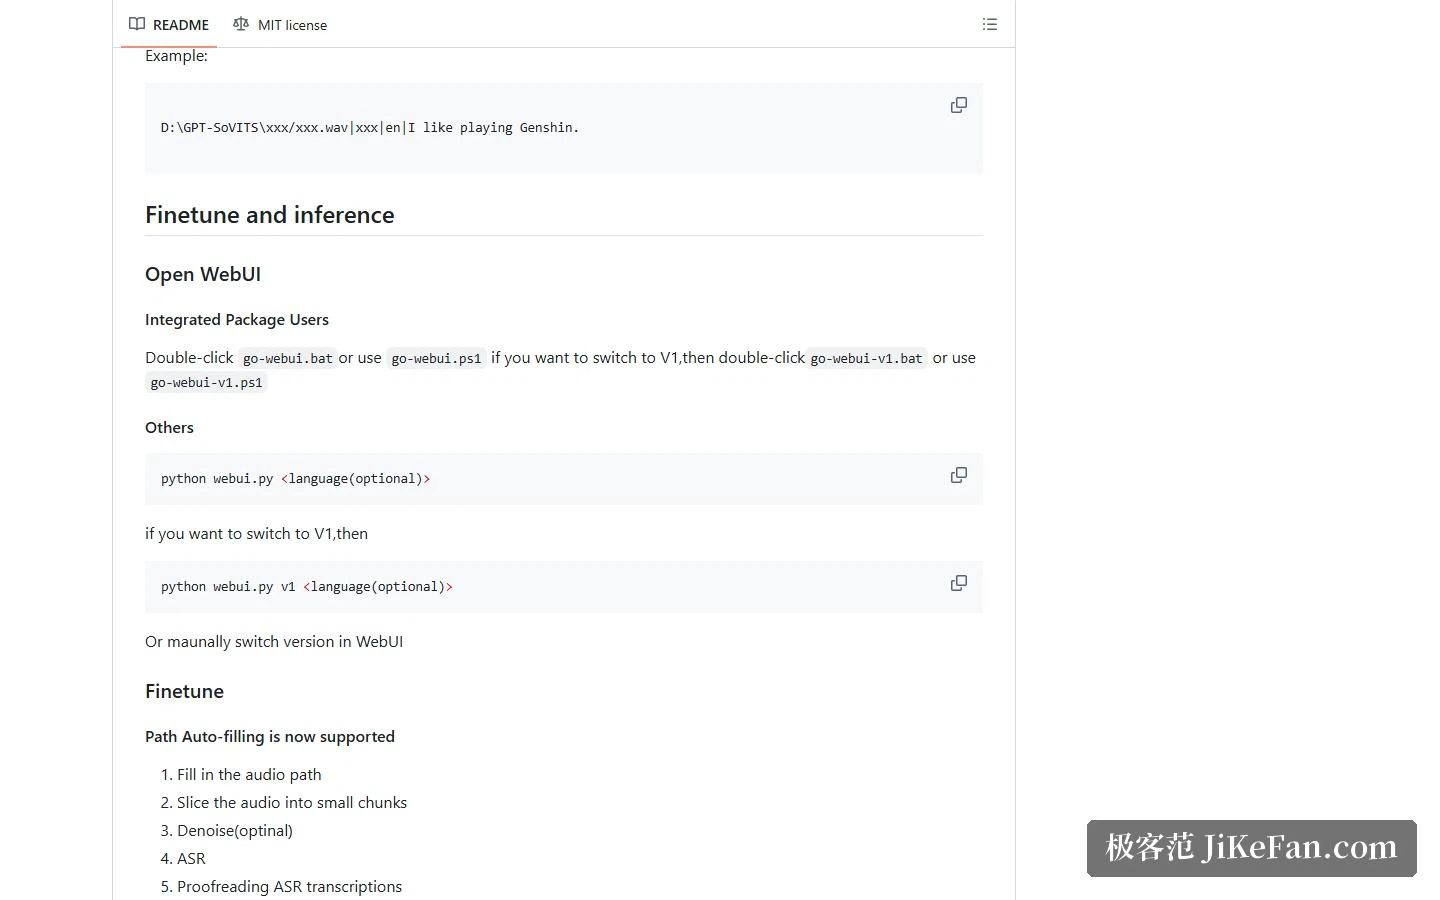
したがって実際の順序はこうなる。音声のパスを指定し、切り分け、必要ならノイズを落とし、音声認識を走らせ、書き起こしを直し、それから調整のページに移って学習させる。認識の部分には Fun-ASR、SenseVoice、FunASR などが組み込まれていて、初心者がこの流れを自分で組み立てる必要はない。
版が多く、どれを選ぶか
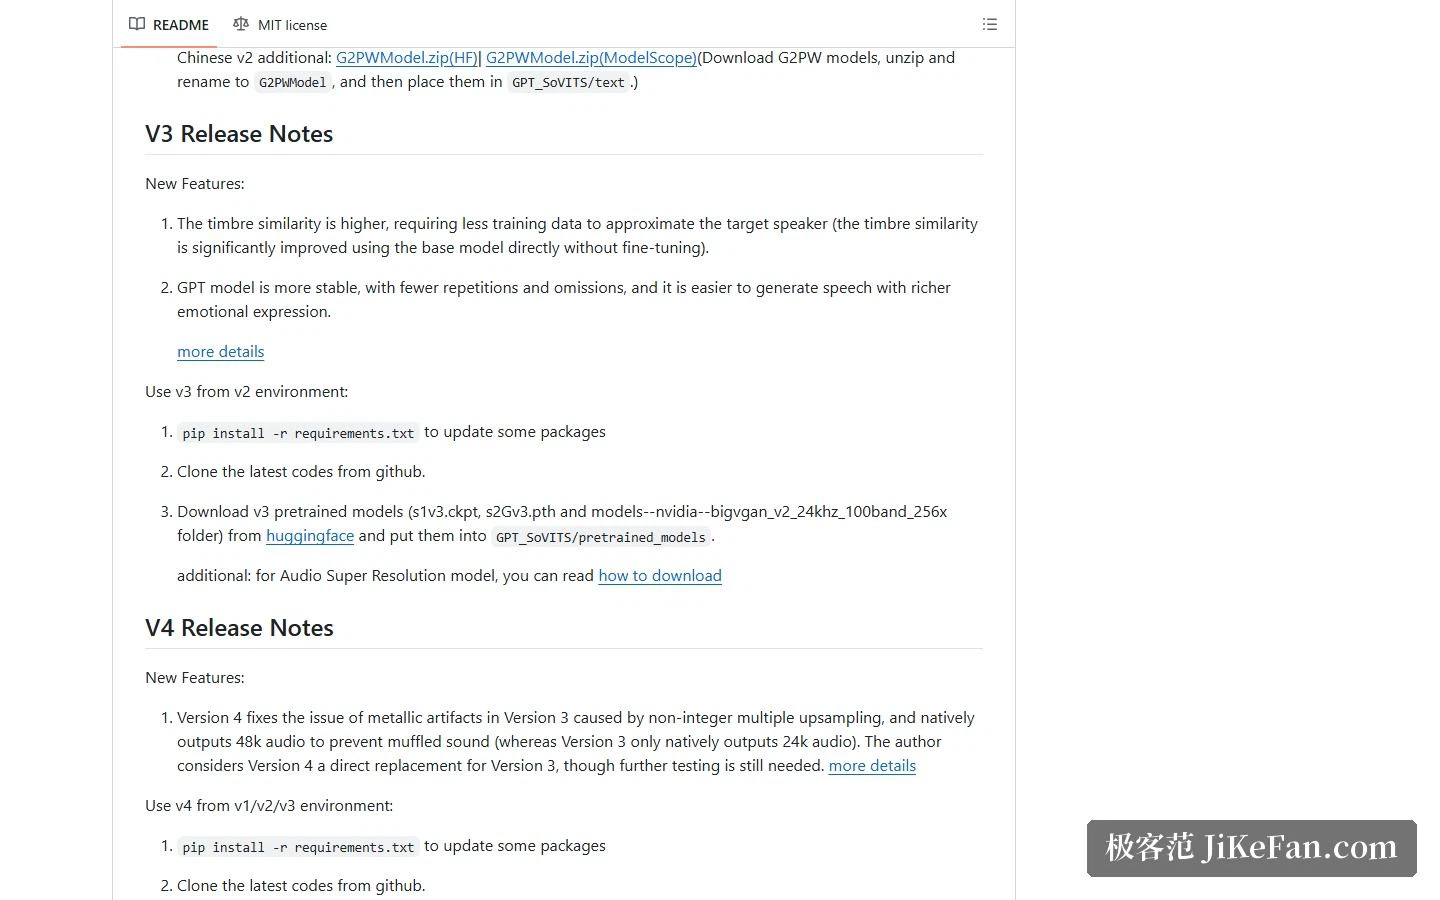
リポジトリには V1、V2、V2Pro、V3、V4 などの版があり、起動時の引数で切り替えられる。Windows の統合パッケージにも対応する起動スクリプトが付いている。覚えておきたい違いはいくつかある。V2 は事前学習モデルを二千時間から五千時間へ広げ、韓国語と広東語を加えた。V3 は調整なしでも声質の近さが明確に上がり、GPT の部分も安定して感情が豊かになった。V4 は V3 が整数倍でないアップサンプリングから生んでいた金属的な雑音を直し、48kHz をそのまま出力する。V3 は 24kHz だ。
導入は面倒か
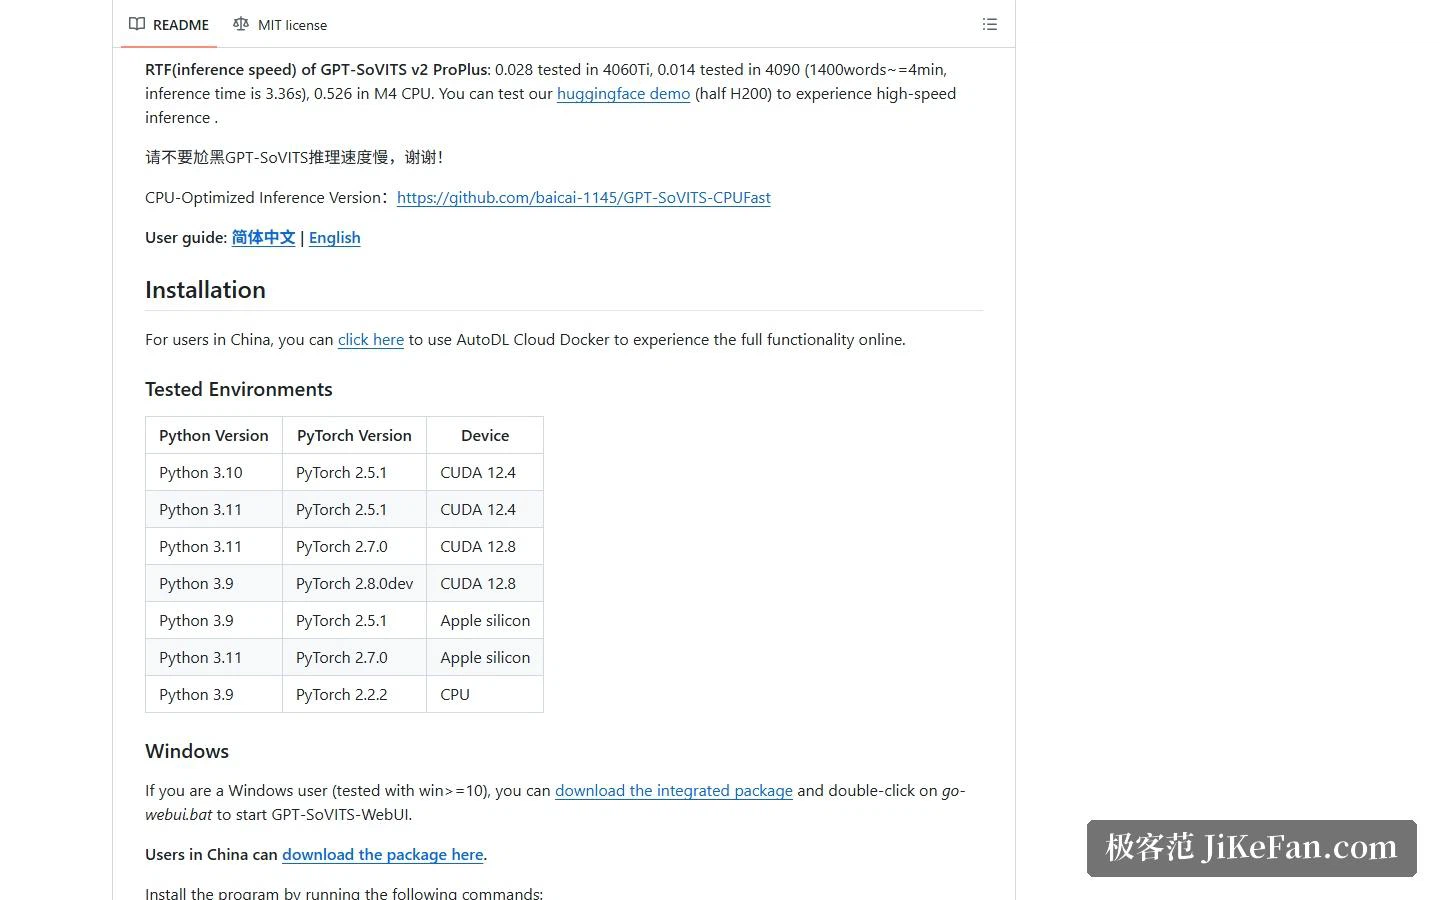
道はいくつか用意されている。いちばん楽なのは Windows の統合パッケージで、落として展開し、起動スクリプトをダブルクリックすれば WebUI が開く。コマンドラインで環境を管理したい人には、Windows 向けの PowerShell スクリプト、Linux と macOS 向けのシェルスクリプトがあり、どちらもデバイスの種類とモデルの取得元を指定できる。その下に手動インストールと Docker が続く。手動は依存関係と FFmpeg を自分でそろえる必要があり、Docker は軽量イメージに音声認識と人声分離のモデルが入っていないと公式が注意していて、別途ダウンロードが要る。
環境については、検証済みの組み合わせが Python 3.9 から 3.11、PyTorch 2.2 から 2.7 を覆い、単体のグラフィックカードで動かすデスクトップ構成から、CPU だけで動かす軽量構成まである。先に知っておきたい点が一つある。一部の環境では GPU で訓練したモデルの品質が他の機器より明らかに落ちるため、プロジェクトはそうした環境では当面 CPU 訓練に切り替えている。そのぶん遅い。
どんな人に向くか
自分用、あるいは特定の声質の音声モデルを作りたい、しかもデータは手元に置いておきたい。そういう目的にはこの位置づけがそのまま合う。必要なデータ量が少なく、道具立てがそろっていて、MIT ライセンスなので制約も少ない。
ただし、使えるグラフィックカードが要る。なければ CPU 推論の遅さを受け入れることになる。一部の環境では訓練の段階が目に見えて長引くので、そこは見込んでおいたほうがいい。それとは別に、声の複製の境目は技術ではなく権利の側にある。他人の声、とりわけ公人の声でコンテンツを作るのは人格権と声の権利に触れうる。道具に触る前に、権利の出どころをはっきりさせておきたい。
一分のデータで TTS モデルを訓練するなど、数年前なら想像もできなかった。道具が強くなるほど、線を守るのは使う側になる。できることと、してよいことは、いつでも別の問いだ。