
CosyVoice は 9 言語と中国語 18 方言をカバーし、ゼロショット複製もこなす
要約
オープンソースの音声合成モデル。最新世代は言語をまたぐゼロショット複製に対応し、9 つの外国語と十を超える中国語の方言と訛りを覆い、Apache 2.0 ライセンスで公開されている。
おすすめ- ソフト名
- CosyVoice
- バージョン
- 3
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinuxmacOS
- 更新日時
- 2026-10-06 19:49
オープンソースの音声合成モデルの多くは、同じ売り文句を掲げる。どれだけ人らしく聞こえるか、という点だ。CosyVoice は少し違う角度から、覆う範囲を前に出す。9 つの言語、中国語の 18 の方言と訛り、そして言語をまたぐゼロショット複製。リポジトリの説明は淡々としていて、多言語の大規模音声生成モデルであり、推論、学習、配備まで一式を提供すると書いてある。
コードは Apache 2.0 ライセンスで公開され、現在の世代は Fun-CosyVoice 3.0 だ。公式の説明では、大規模言語モデルの上に載った音声合成システムであり、内容の一貫性、話者の類似度、韻律の自然さの三点で CosyVoice 2.0 を上回る。
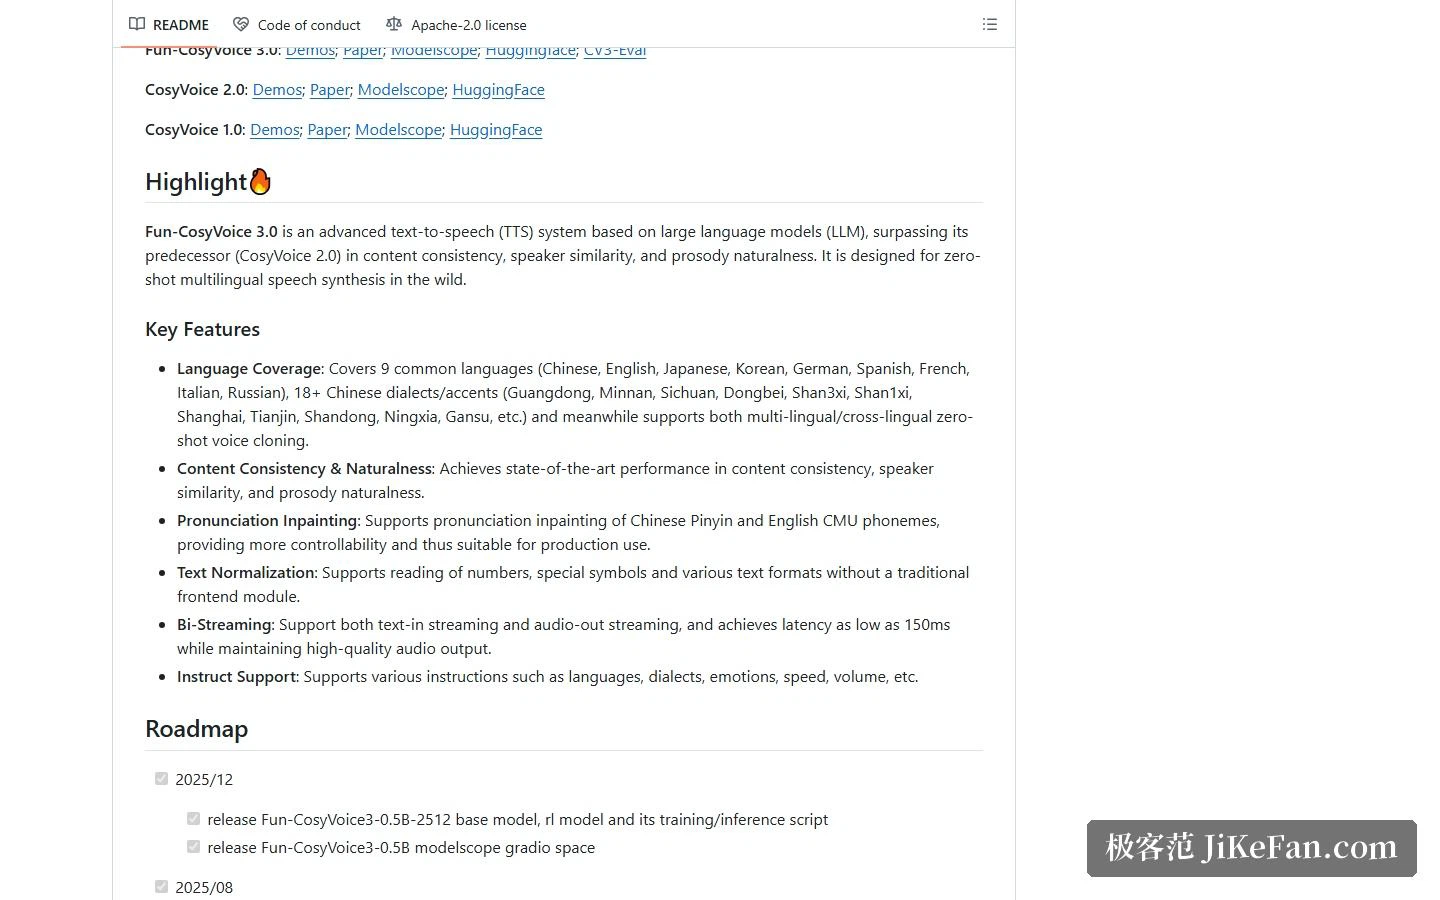
まず覆う範囲から:9 言語と中国語 18 方言
挙がっている 9 言語は、中国語、英語、日本語、韓国語、ドイツ語、スペイン語、フランス語、イタリア語、ロシア語。中国語で仕事をする人にとって重要なのは方言の行のほうだ。18 を超える中国語の方言と訛りがあり、公式の例には広東、閩南、四川、東北、陝西、山西、上海、天津、山東、寧夏、甘粛が並ぶ。
方言対応の難しさは、読めるかどうかではない。コーパスが乏しく、発音の仕組みが標準語と大きく違うことにある。これを主要な特徴として単独で立てているところに、中国語圏への投資がついでのものではなく意図的だったことが表れている。
ゼロショット複製と、指示で語り口を操る
声の複製について、公式は多言語と跨言語のゼロショットを同じ説明にまとめている。つまり、ある言語で録ったサンプルを、別の言語の合成に使える。言語ごとにデータを用意し直す必要はない。
もう一つの実用的な機能が指示による制御で、言語、方言、感情、話す速さ、音量をまとめて指定できる。音声コンテンツを作る側からすれば、当たるまで何度も作り直すよりはるかに見通しがいい。発音の補正も別項目として挙がっていて、中国語のピンインと英語の CMU 音素による介入に対応する。多音字や外国の固有名詞は手で直せる。
ストリーミング推論:遅延は最小でおよそ 150 ミリ秒
特徴の欄には、テキスト入力のストリーミングと音声出力のストリーミングを両方向で行い、遅延は最小 150 ミリ秒まで下がり、しかも音質を保つと書かれている。この数字が効くのはリアルタイムの対話だ。音声合成を問い合わせ対応のボットや音声アシスタントに組み込むなら、遅延は使えるかどうかの分かれ目になる。
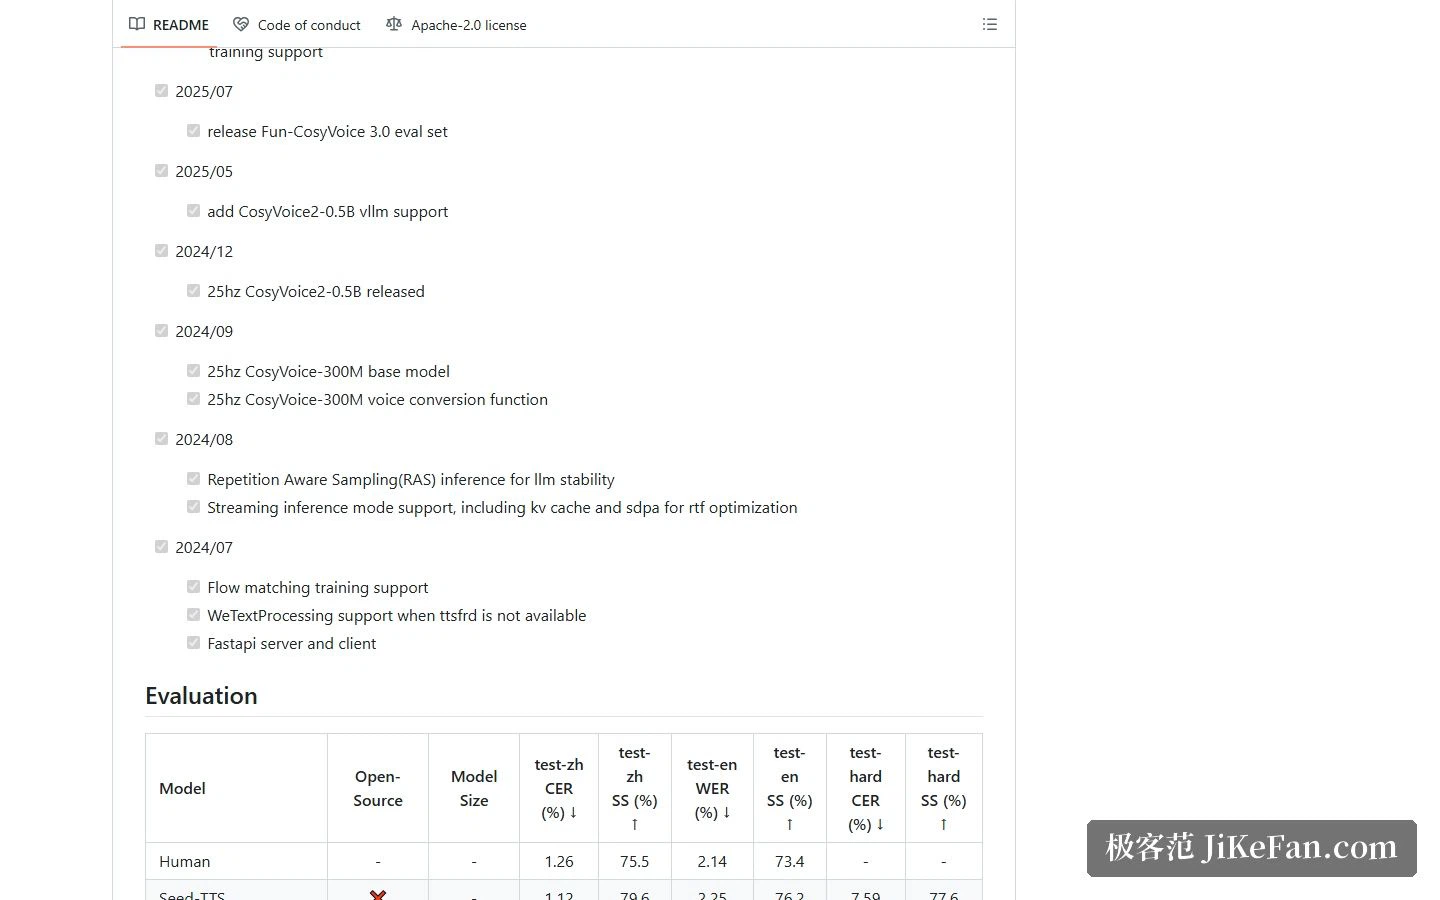
版とモデルをどう選ぶか
現時点で三代ある。CosyVoice 1.0、CosyVoice 2.0、Fun-CosyVoice 3.0 で、それぞれ論文とモデルの置き場が示されている。落とせる学習済みモデルは一つではない。三億パラメータ規模の CosyVoice-300M、その追加学習版 300M-SFT、指示版 300M-Instruct、さらに CosyVoice2-0.5B と最新の Fun-CosyVoice3-0.5B がある。
公式の文書は Fun-CosyVoice3-0.5B を名指しで薦めている。出来が良いからだ。指示による制御を重く見るなら Instruct の付く版を、まず流れを通したいだけなら三億の版を選ぶといい。大きさが小さく、メモリへの負担も軽い。
導入:Conda の環境ひとつとモデルの取得
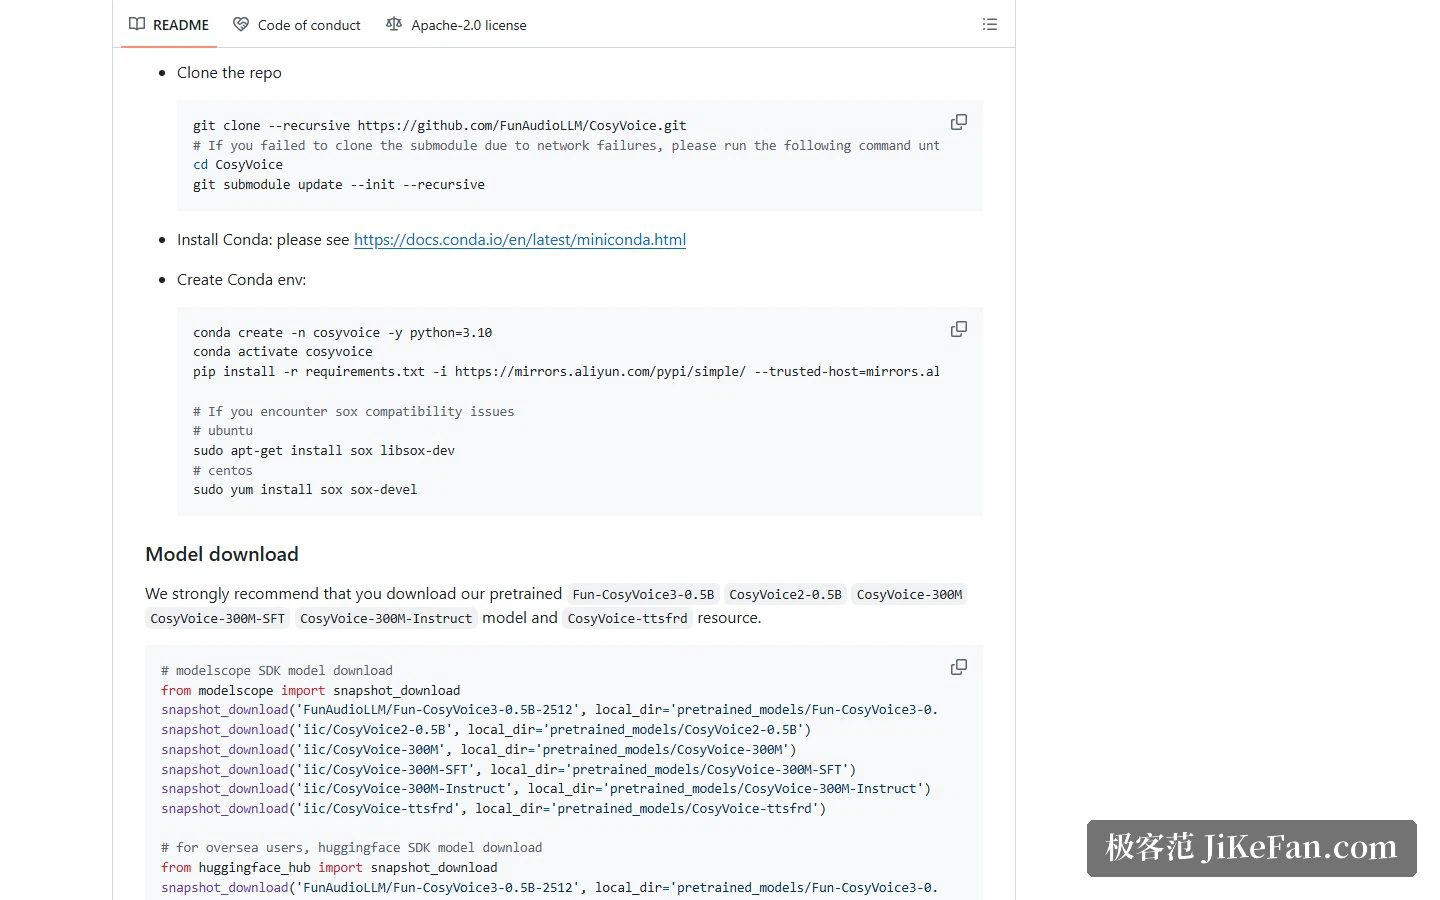
公式の手順は、リポジトリをサブモジュールごと複製し、Conda で Python 3.10 の環境を作って依存関係を入れ、最後に必要な学習済みモデルを取得するという流れだ。モデルは ModelScope か HuggingFace から取れ、中国国内の利用者は前者のほうが滑らかに進む。
見落としやすい点が一つある。テキストの正規化は既定で wetext を通る。別途 ttsfrd のリソースを展開して入れておくと、数字や記号の読み方が良くなる。公式もこの手順は必須ではなく飛ばせると明記している。
動かす、そしてもっと速くしたいとき
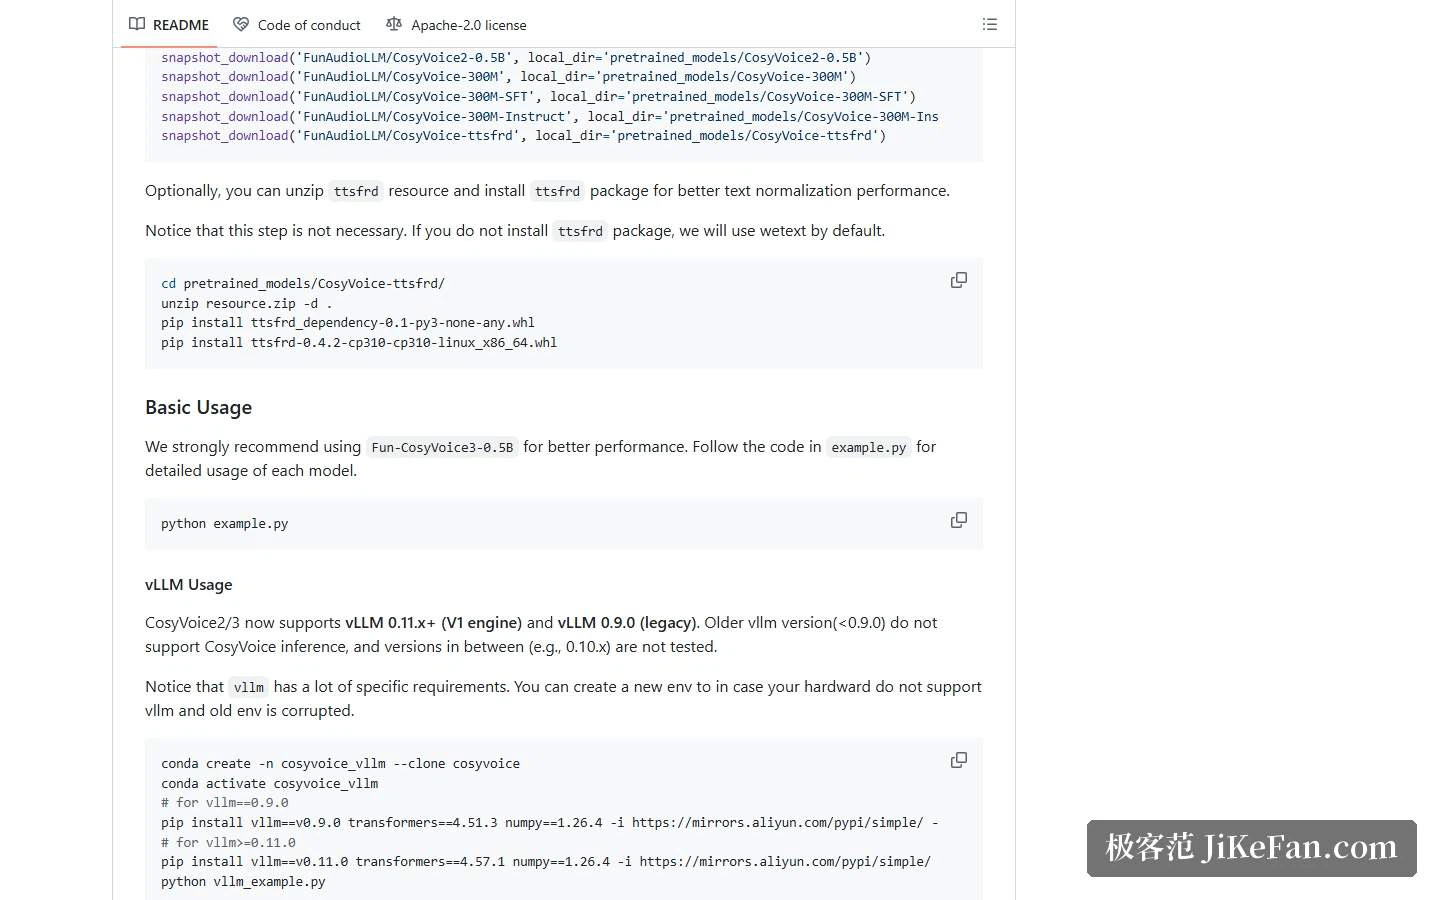
いちばん簡単な確認は公式のサンプルスクリプトを走らせること、あるいはウェブのデモを立ち上げてモデルのディレクトリとポートを指定し、ブラウザで試聴することだ。処理量や遅延が制約になるなら、CosyVoice 2 と 3 は vLLM による加速に対応する。ただし版に条件がある。公式は新しいエンジンの 0.11 以上と古い 0.9.0 に対応すると書き、0.9.0 より下では推論できない。その間の版は検証されていない。
どんな人に向くか
必要が中国語に寄っているなら、とくに方言や、制御できる語り口や発音の補正が要るなら、この組み合わせは汎用の英語中心 TTS より噛み合う。コードが開かれていて手元に置ける点も、データを社内網から出せない状況にも向いている。
先に確かめるべきことは二つ残る。一つはモデルの重みのライセンスだ。リポジトリのコードは Apache 2.0 だが、生成した結果を商用に回す前に、重みそのものの許諾条件をもう一度読んでおきたい。もう一つは声の複製の合法性で、他人の声、とりわけ公人の声でコンテンツを作るのは人格権と声の権利に触れうる。権利の出どころは想定ではなく書面に落としておくべきだ。
オープンな音声モデルはこの二年で大きく進み、覆う言語と方言はどんどん埋まってきた。技術の選択肢は増えたが、残った問いは人の側に戻る。機械に誰の声を使わせ、何を言わせるのか。