
-
Chatterfly: Fn halten, sprechen, fertigen Text bekommen
Ein Spracheingabeprogramm von Tencent, seit September 2026 in der Testphase: Fn halten, so sprechen wie im Gespraech, und danach einen geschriebenen Text erhalten, der zum Empfaenger passt.
-
RVC macht aus einer Stimme eine andere, mit zehn Minuten Trainingsaudio
Ein offenes Framework für Stimmklang-Umwandlung und Live-Stimmwechsel. Es verlangt mindestens zehn Minuten saubere Sprache zum Trainieren, erreicht 170 Millisekunden Ende-zu-Ende-Latenz und bringt eine Weboberfläche plus eine Live-Oberfläche mit.
-
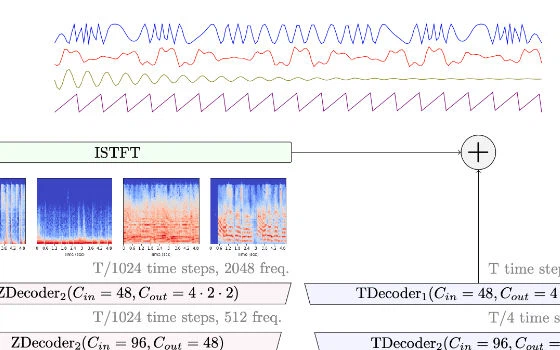
Demucs zerlegt einen Song per Kommandozeile in vier Spuren
Ein offenes Modell zur Quellentrennung, das einen gemischten Song in Schlagzeug, Bass, Gesang und die übrige Begleitung zerlegt. Ein Aufruf auf der Kommandozeile genügt, aus Python ist es ebenso nutzbar, der Code steht unter MIT.
-
Ultimate Vocal Remover trennt Stimme und Begleitung, ohne Vorbereitung
Ein Open-Source-Werkzeug, das einen Song mit Modellen zur Quellentrennung in Stimme und Begleitung zerlegt. Das offizielle Paket bringt Oberfläche, Python, PyTorch und die Abhängigkeiten mit, vorbereitet werden muss nichts.
-
WhisperX legt Wort-Zeitstempel und Sprecherlabels über Whisper
Ein Ablauf, der zwei Lücken von Whisper schließt: Zeitstempel enden auf Satzebene, und eine Stapelverarbeitung fehlt. WhisperX richtet zwangsweise aus, um Wortzeiten zu gewinnen, labelt Sprecher und nennt 70-fache Echtzeit auf large-v2.
-
Buzz lässt die Transkription auf dem eigenen Rechner, Whisper arbeitet darunter
Ein Desktop-Werkzeug, das Audio auf dem eigenen Rechner transkribiert und übersetzt, mit Whisper darunter. Es nimmt Mediendateien oder Links, schreibt live vom Mikrofon mit, trennt Sprecher und exportiert reinen Text sowie SRT und VTT.
-
Whisper gibt es in sechs Größen, und der Speicherbedarf entscheidet
Ein universelles Spracherkennungsmodell, das Transkription, Übersetzung ins Englische und Spracherkennung in einem Durchlauf erledigt. Sechs Größen reichen von rund 39 Millionen bis rund 1,55 Milliarden Parametern, Code und Gewichte stehen unter MIT.
-
IndexTTS läuft auf der eigenen Maschine, Emotion und Tempo als Parameter
Ein Zero-Shot-Sprachsynthesesystem für den lokalen Betrieb. Ein Referenzclip genügt zum Klonen, Emotion, Tempo und Aussprache bleiben Parameter, und für die Gewichte gilt eine Lizenz des Projekts statt einer allgemeinen Open-Source-Lizenz.
-
F5-TTS liefert MIT-Code und nicht-kommerzielle Gewichte, per pip installiert
Ein quelloffenes Projekt für Sprachsynthese auf Basis von Flow Matching, mit pip-Paket, Kommandozeilen-Inferenz und Gradio-Oberfläche. Der Code ist MIT, die vortrainierten Gewichte sind wegen der Trainingsdaten nicht kommerziell nutzbar.
-
CosyVoice deckt 9 Sprachen und 18 chinesische Dialekte ab, dazu Zero-Shot-Klonen
Ein quelloffenes Sprachsynthesemodell, dessen neueste Generation sprachübergreifendes Zero-Shot-Klonen beherrscht, 9 Fremdsprachen und über zehn chinesische Dialekte und Akzente abdeckt und unter der Apache-2.0-Lizenz steht.
-
GPT-SoVITS trainiert eine Stimmvorlage mit einer Minute Audio, fünf Sekunden für Zero-Shot
Eine quelloffene WebUI für Sprachsynthese. Fünf Sekunden einer menschlichen Stimme genügen für Zero-Shot-Ausgabe, eine Minute Trainingsmaterial reicht für eine nähere Stimmfarbe, und die Inferenz wechselt zwischen fünf Sprachen inklusive Mandarin, Englisch, Japanisch, Koreanisch und Kantonesisch.
-
Fish Audio baut eine Stimme aus zehn Sekunden auf, monatlich 8000 Credits gratis
Keine Kreditkarte bei der Anmeldung, 8000 Credits pro Monat im kostenlosen Tarif. Zehn Sekunden Referenzaudio genügen für eine brauchbare Stimme, und über 60 Emotionsmarken steuern beim Synthetisieren den Vortrag.
-
Haimian Music: ein Satz genügt, und der Song wird gesungen
Ein Musikwerkzeug, das nur im Browser läuft und mit einem einzigen Textfeld beginnt. Beschreibe den gewünschten Klang, und das Modell liefert einen gesungenen Track – oder du gibst eigene Zeilen ein und wählst Genre, Stimmung und Stimmfarbe.
-
第 1 / 1 页