
IndexTTS läuft auf der eigenen Maschine, Emotion und Tempo als Parameter
Zusammenfassung
Ein Zero-Shot-Sprachsynthesesystem für den lokalen Betrieb. Ein Referenzclip genügt zum Klonen, Emotion, Tempo und Aussprache bleiben Parameter, und für die Gewichte gilt eine Lizenz des Projekts statt einer allgemeinen Open-Source-Lizenz.
Empfehlen- Name
- IndexTTS
- Version
- 2.5
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinux
- Aktualisiert
- 2026-10-06 20:19
Ein Projekttitel, der wie ein Datenblatt klingt
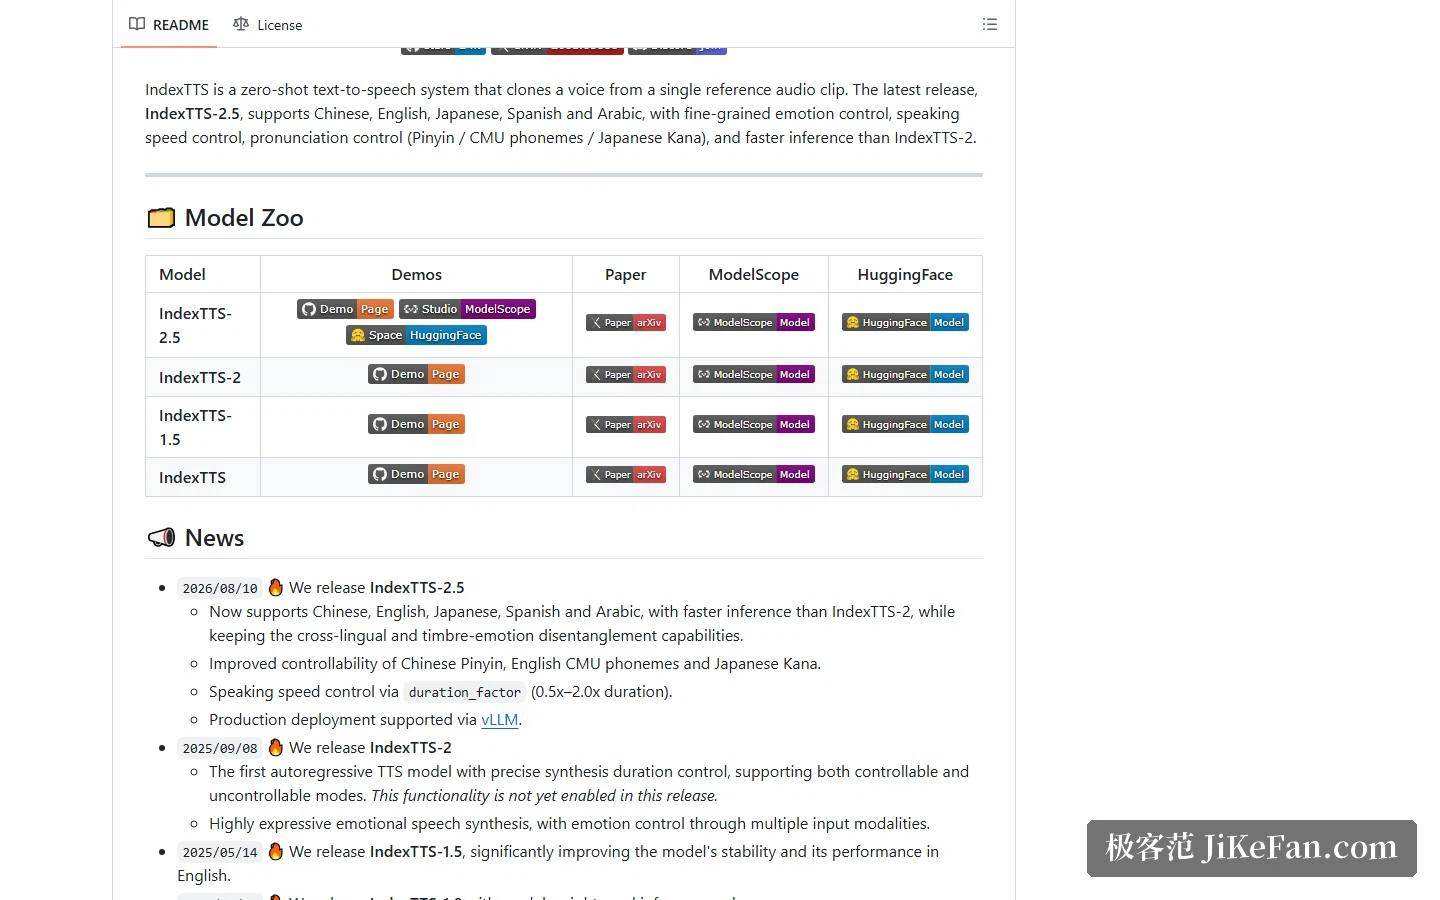
IndexTTS sagt in der ersten Zeile seines Repositoriums, was es sein will: ein industrielles, steuerbares und effizientes Zero-Shot-Sprachsynthesesystem. Drei Adjektive, drei Versprechen: produktionsreif, beeinflussbar, schnell genug. Der Einstieg zum Klonen ist genauso direkt. Ein Referenzclip einer Stimme genügt, ein Training dazwischen gibt es nicht.
Aktuell ist IndexTTS-2.5. Es deckt Mandarin, Englisch, Japanisch, Spanisch und Arabisch ab, und laut Projekt ist die Inferenz schneller als beim Vorgänger IndexTTS-2, bei gleicher Sprachübergreifung und derselben Trennung von Timbre und Emotion, die schon die frühere Version eingeführt hat.
Vier Releases, eine Linie
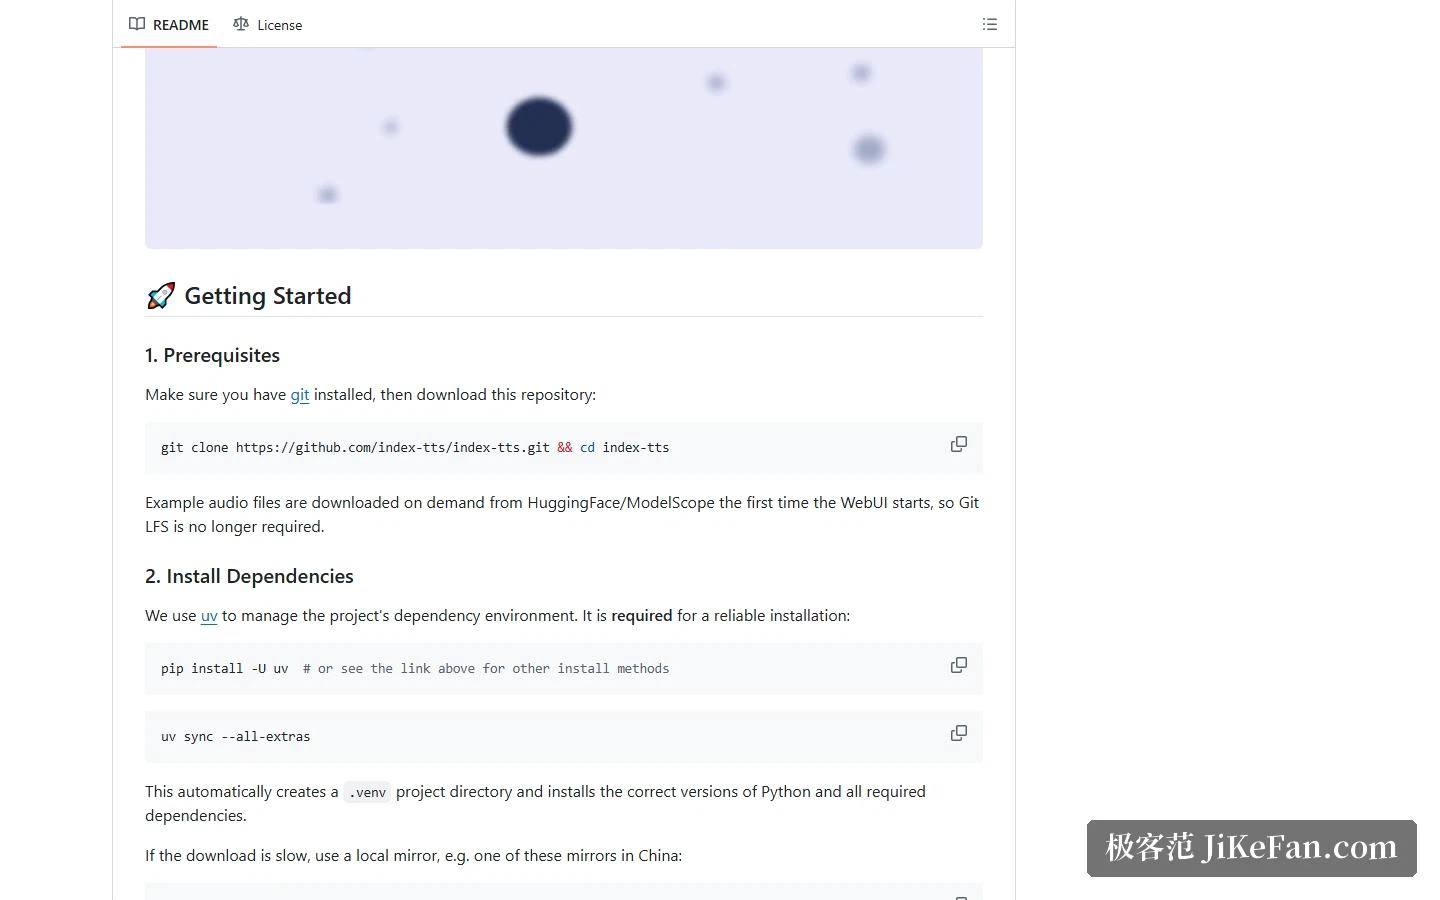
Das Änderungsprotokoll erzählt das ohne viel Schmuck. Am Anfang stand das Basis-IndexTTS. Version 1.5 legte den Schwerpunkt auf Stabilität und englische Ausgabe. Version 2 war das erste autoregressive Sprachmodell der Reihe mit präziser Kontrolle über die Synthesedauer, wobei derselbe Hinweis einräumt, dass die Funktion in diesem Release noch nicht aktiv war. Version 2.5 erweiterte den Sprachsatz auf fünf, verbesserte die Aussprachekontrolle für Pinyin und Phoneme und ergänzte die Tempo-Regelung sowie einen Weg zum Betrieb über vLLM.
Alle vier stehen in der Modellbibliothek nebeneinander, jede mit eigener Demo, Paper und Gewichts-Download. Welche man nimmt, hängt davon ab, welche Fähigkeiten der eigene Fall braucht, nicht davon, welche Zahl die größte ist.
Drei Stellschrauben
Hier hebt sich IndexTTS vom Durchschnitt ab. Allein die Emotion lässt sich auf drei Arten angeben. Man kann einen separaten Emotions-Referenzclip übergeben und seinen Einfluss mit emo_alpha skalieren; der Wert läuft von 0 bis 1 und steht standardmäßig auf voller Stärke. Stattdessen kann man einen Fließkommavektor der Länge acht übergeben, in fester Reihenfolge: Freude, Wut, Trauer, Angst, Ekel, Schwermut, Überraschung, Ruhe. Oder man beschreibt die Emotion einfach in einem Satz Text.
Das Tempo läuft über duration_factor, der Werte von der Hälfte bis zum Doppelten annimmt, standardmäßig im ursprünglichen Tempo. Oberhalb wird die Sprache langsamer, unterhalb schneller. Beim Vertonen von Video zahlt sich der Parameter aus, weil die Bildlänge feststeht und die Stimme hineinpassen muss.
Die Aussprache ist die dritte Stellschraube, mit drei Zielen: Pinyin für Mandarin, CMU-Phoneme für Englisch, Kana für Japanisch. Wenn ein Zeichen mehrere Lesungen hat oder ein fremder Eigenname falsch klingt, greift man von Hand ein, statt neu aufzunehmen.
Echtzeitfaktor auf einer einzelnen 4090
Der veröffentlichte Benchmark lief auf einer einzelnen 4090 mit aktiviertem KV-Cache. IndexTTS-2.5 erreicht einen Echtzeitfaktor von 0,2065 in bf16 und 0,2060 in fp32. Zum Vergleich: IndexTTS-2.0 lag bei 0,3257 in fp16 und 0,3748 in fp32. Kleiner ist hier besser, denn die Zahl sagt, wie viel Luft die Generierung gegenüber der Abspielgeschwindigkeit hat. Der Abstand zwischen den beiden Generationen ist damit direkt ablesbar.
Abhängigkeiten über uv
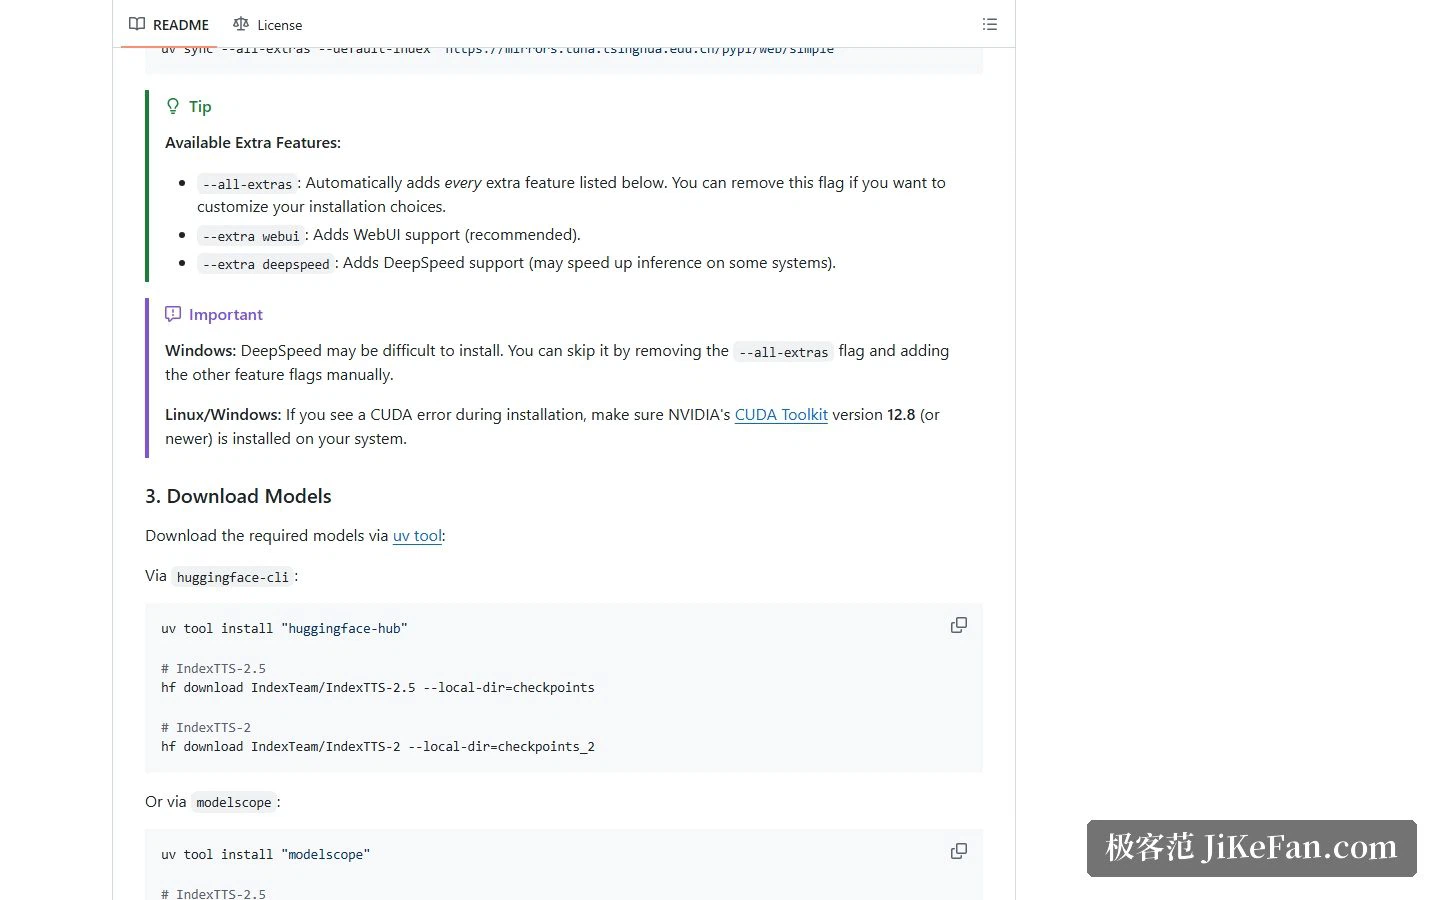
Die empfohlene Installation ist etwas ungewöhnlich. Zuerst uv per pip installieren, dann das ganze Projekt mit uv synchronisieren. Der Grund: uv legt die virtuelle Umgebung selbst an und fixiert sowohl die Python-Version als auch die Versionen der Abhängigkeiten, was die Doku als Voraussetzung für eine verlässliche Installation bezeichnet. Dieselbe Doku rät davon ab, die Umgebung von Hand zu aktivieren, weil genau so Abhängigkeitskonflikte entstehen.
Komponenten sind bei der Installation optional. Wer die Browser-Oberfläche will, nimmt den webui-Eintrag; wer die Beschleunigung will, den DeepSpeed-Eintrag. Zwei Hinweise hängen daran. DeepSpeed lässt sich unter Windows unter Umständen schlecht bauen; dann lässt man den Schalter weg, der alles auf einmal installiert, und wählt von Hand. Und wenn die Installation einen CUDA-Fehler wirft, sollte man prüfen, ob das CUDA-Toolkit in Version 12.8 oder neuer vorhanden ist.
Gewichte, Hardware-Check, erster Start
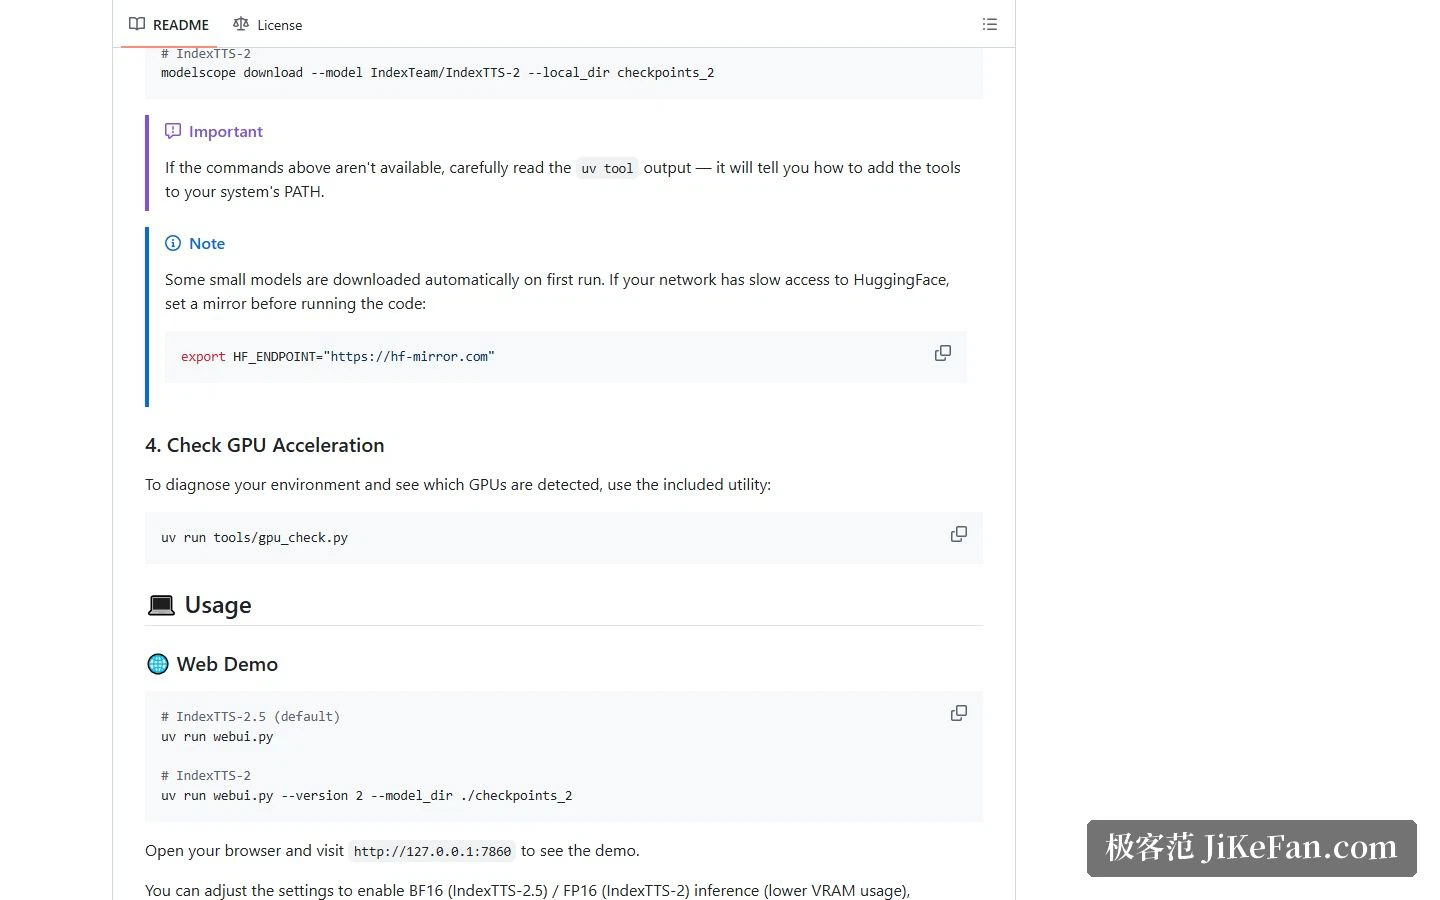
Die Gewichte sind ein eigener Download, geholt von HuggingFace oder ModelScope und in ein lokales Verzeichnis gelegt, aus dem das Programm sie lädt. Beispielaudio wird beim ersten Start der Weboberfläche bei Bedarf nachgeladen, weshalb Git LFS nicht mehr nötig ist, eine Hürde weniger bei unzuverlässigem Netz.
Vor dem Start das Skript zur GPU-Erkennung laufen lassen, damit klar ist, welche Karten die Umgebung sieht. Dann die Weboberfläche starten und die lokale Seite im Browser öffnen. Die Inferenz in halber Genauigkeit lässt sich auf dieser Seite umschalten; laut Projekt ist BF16 oder FP16 schneller, braucht weniger Grafikspeicher und verliert nur sehr wenig Qualität.
Die Lizenz gehört separat geprüft
Der Quellcode ist offen, die Lizenz aber weder MIT noch Apache, sondern die bilibili-Modellnutzungslizenz, und im Repo liegen eine chinesische und eine englische Fassung. Die praktische Folge: Der erlaubte Umfang wird von diesem Dokument bestimmt und nicht von einer allgemeinen Open-Source-Gewährung. Wer kommerzielle Nutzung oder Weitergabe plant, sollte es vorher lesen und prüfen, ob der eigene Fall im erlaubten Bereich liegt.
Für wen es passt
Wer synthetische Sprache in ein echtes Produkt bringen und dabei nachregeln will, findet hier eine hohe Dichte an Kontrolle: Emotion per Vektor oder Text, Tempo präzise skaliert, Aussprache Zeichen für Zeichen korrigiert, dazu ein Weg zum Betrieb über vLLM. Das ist keine Ausstattungsliste eines Spielzeugprojekts.
Der Einstieg kostet aber auch. Man braucht eine NVIDIA-Karte, das CUDA-Toolkit ab 12.8 und für die Abhängigkeiten die uv-Werkzeugkette. Und wie bei jedem Werkzeug zum Stimmklonen stellt sich die Frage der Zustimmung, wenn fremde Stimmen die Grundlage sind, bei Personen des öffentlichen Lebens besonders. Je feiner Tempo und Emotion justierbar sind, desto wichtiger ist es zu wissen, wo die Ausgabe eingesetzt werden soll.
Mehr Kontrolle bringt mehr Komplexität. Ab einer gewissen Parameterzahl entscheidet nicht mehr das Modell über die Qualität, sondern wie gut die Person davor den Inhalt versteht.