
Fish Audio baut eine Stimme aus zehn Sekunden auf, monatlich 8000 Credits gratis
Zusammenfassung
Keine Kreditkarte bei der Anmeldung, 8000 Credits pro Monat im kostenlosen Tarif. Zehn Sekunden Referenzaudio genügen für eine brauchbare Stimme, und über 60 Emotionsmarken steuern beim Synthetisieren den Vortrag.
Empfehlen- Name
- Fish Audio
- Version
- 20260917
- Preis
- Kostenlos
- Open Source
- Proprietär
- Betriebssystem
- Web
- Webseite
- https://fish.audio/
- Aktualisiert
- 2026-10-06 17:54
Zehn Sekunden einer Stimme genügen, um sie nachzubauen, und genügen, um sie 13 Sprachen sprechen zu lassen. Mit diesem Versprechen tritt Fish Audio an. Das Unternehmen bezeichnet sich als KI-Sprachplattform, mit Textausgabe, Stimmklon und Spracherkennung nebeneinander, alles auf der eigenen S2-Modellfamilie.
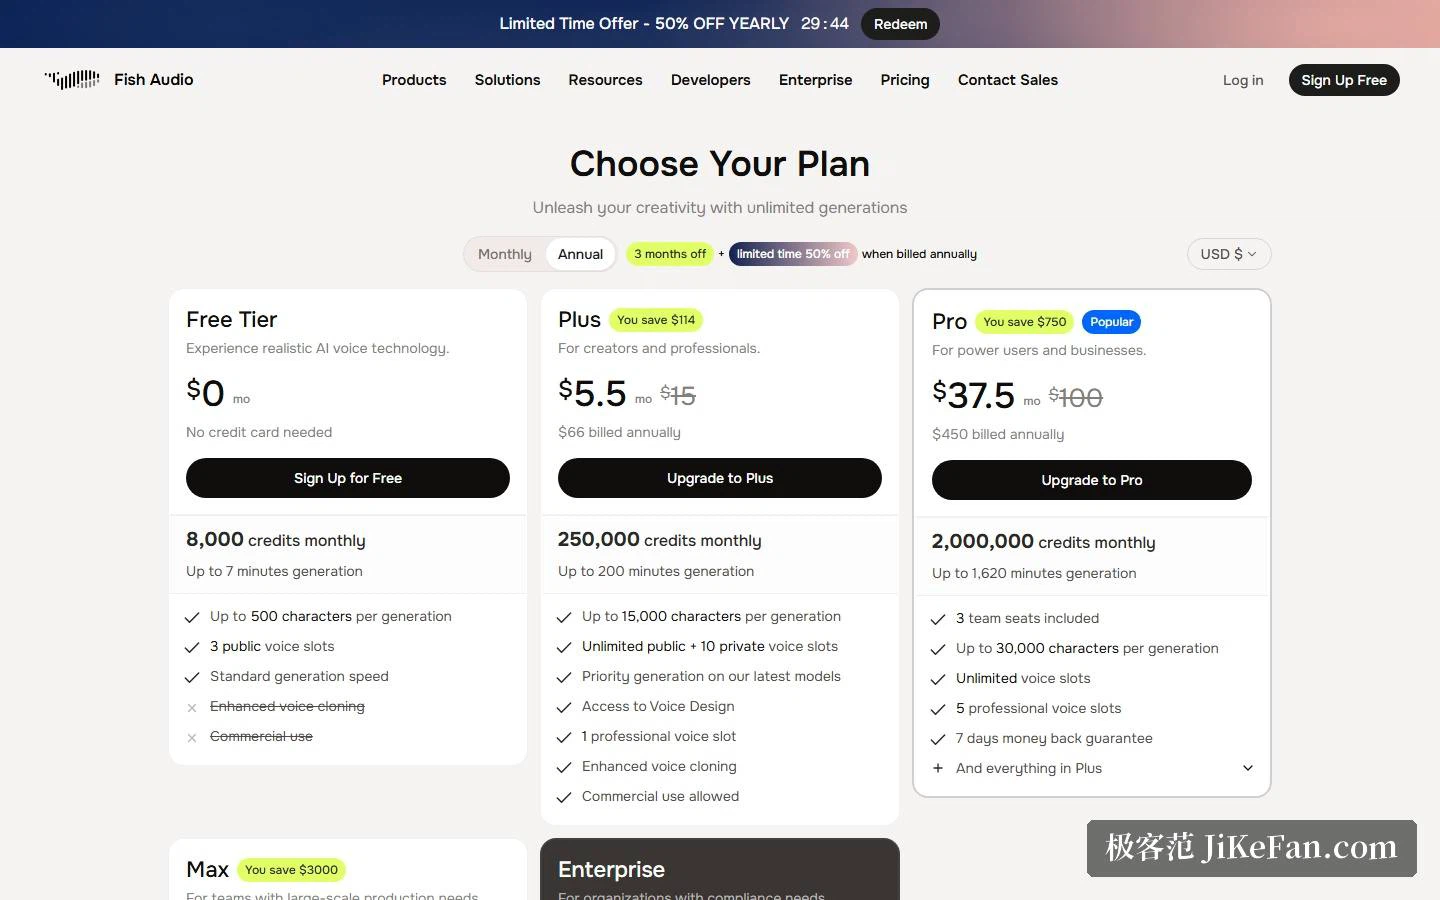
Wer erst schauen und dann zahlen will, findet die Antwort in der linken Spalte der Preisliste: Der kostenlose Tarif vergibt monatlich 8000 Credits, und bei der Anmeldung wird keine Karte verlangt.
Was das kostenlose Kontingent hergibt – und wo es endet
Erst umgerechnet wird das Guthaben greifbar. 8000 Credits entsprechen ungefähr 7 Minuten erzeugtem Audio; eine einzelne Anfrage ist auf 500 Zeichen begrenzt; die offizielle Umrechnung liegt bei etwa 600 bis 625 Credits pro Minute Ausgabe. Dazu kommen 3 öffentliche Stimmplätze und die Standardgeschwindigkeit bei der Erzeugung.
Zwei Zeilen auf dieser Seite verdienen einen zweiten Blick. Erweitertes Stimmklonen und kommerzielle Nutzung sind in der Spalte für den kostenlosen Tarif durchgestrichen, gehören also nicht zum Angebot. Die offiziellen Antworten sagen es auch in Worten: Was der kostenlose Tarif erzeugt, ist für persönliche, nicht kommerzielle Projekte gedacht, alles andere verlangt ein Upgrade. Wer die Tonspur in Inhalten einsetzen will, die Geld einbringen, sollte das früh einplanen und nicht erst beim Export merken.
Klonen aus zehn Sekunden Audio
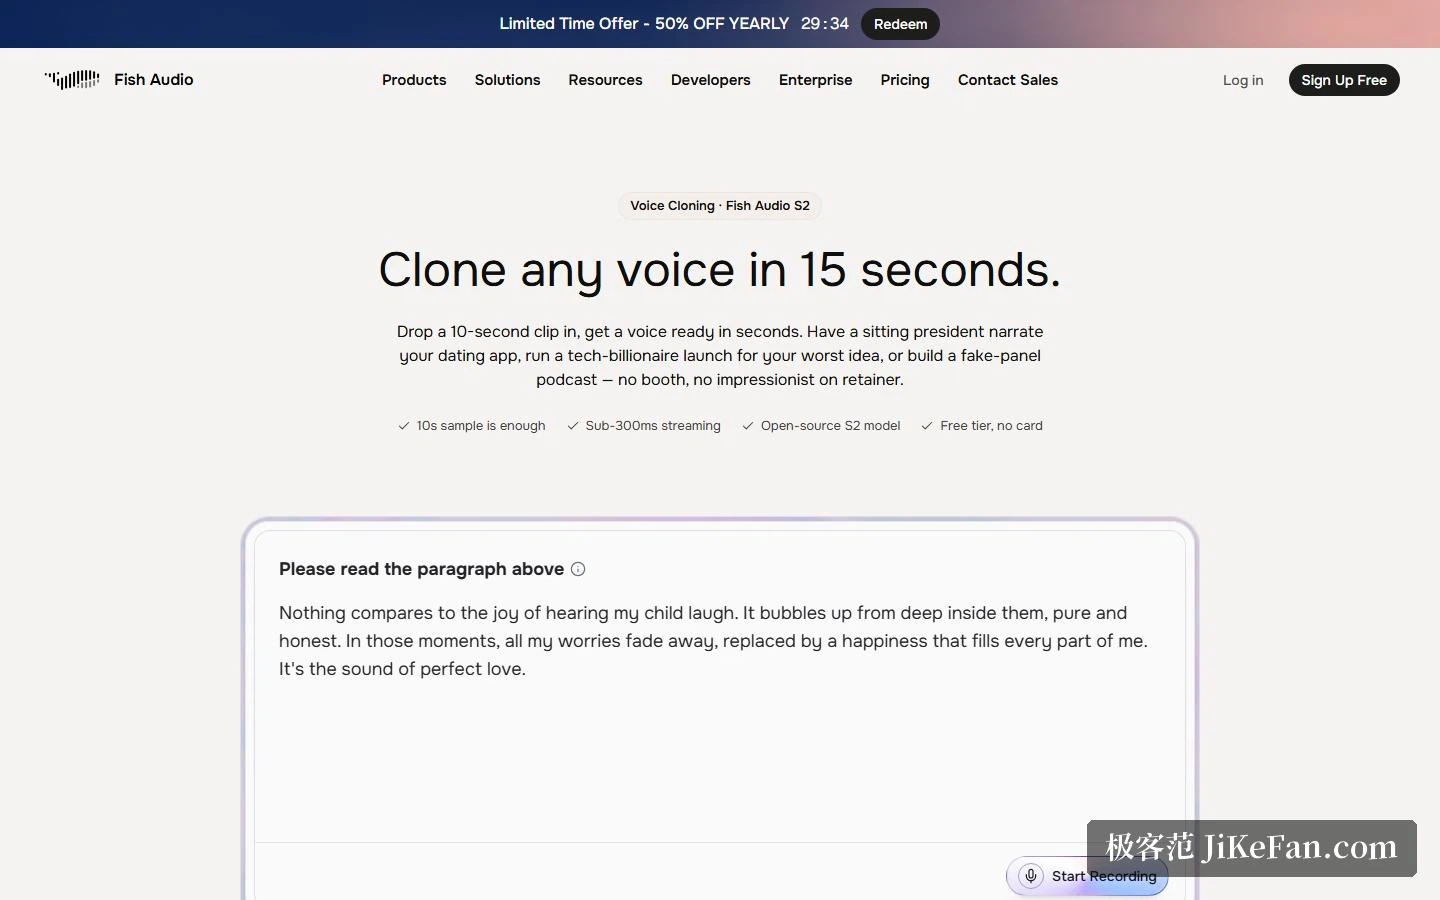
Das Klonen ist die Funktion, die das Produkt am stärksten bewirbt. Auf der Seite steht, zehn Sekunden reichten: eine kurze Referenzaufnahme hineinlegen, und binnen Sekunden kommt eine brauchbare Stimme zurück, ohne Warteschlange fürs Modelltraining. Drei Angaben stehen daneben. Die Latenz im Streaming bleibt unter 300 Millisekunden. Ein Klon funktioniert sprachübergreifend, und die offizielle Angabe lautet Zero-Shot-Abdeckung von 13 Sprachen, ohne eigenes Modell und ohne neue Aufnahme je Sprache.
Ein Punkt gehört getrennt erwähnt. Das S2-Modell selbst ist quelloffen, und das selbst gehostete Betreiben ist ein offiziell unterstützter Weg. Für datensensible Arbeit oder für alle, die das Ganze lokal laufen lassen wollen, ist das eine Option, die ein reiner Clouddienst nicht bietet.
Emotionsmarken: der synthetischen Stimme einen Ton geben
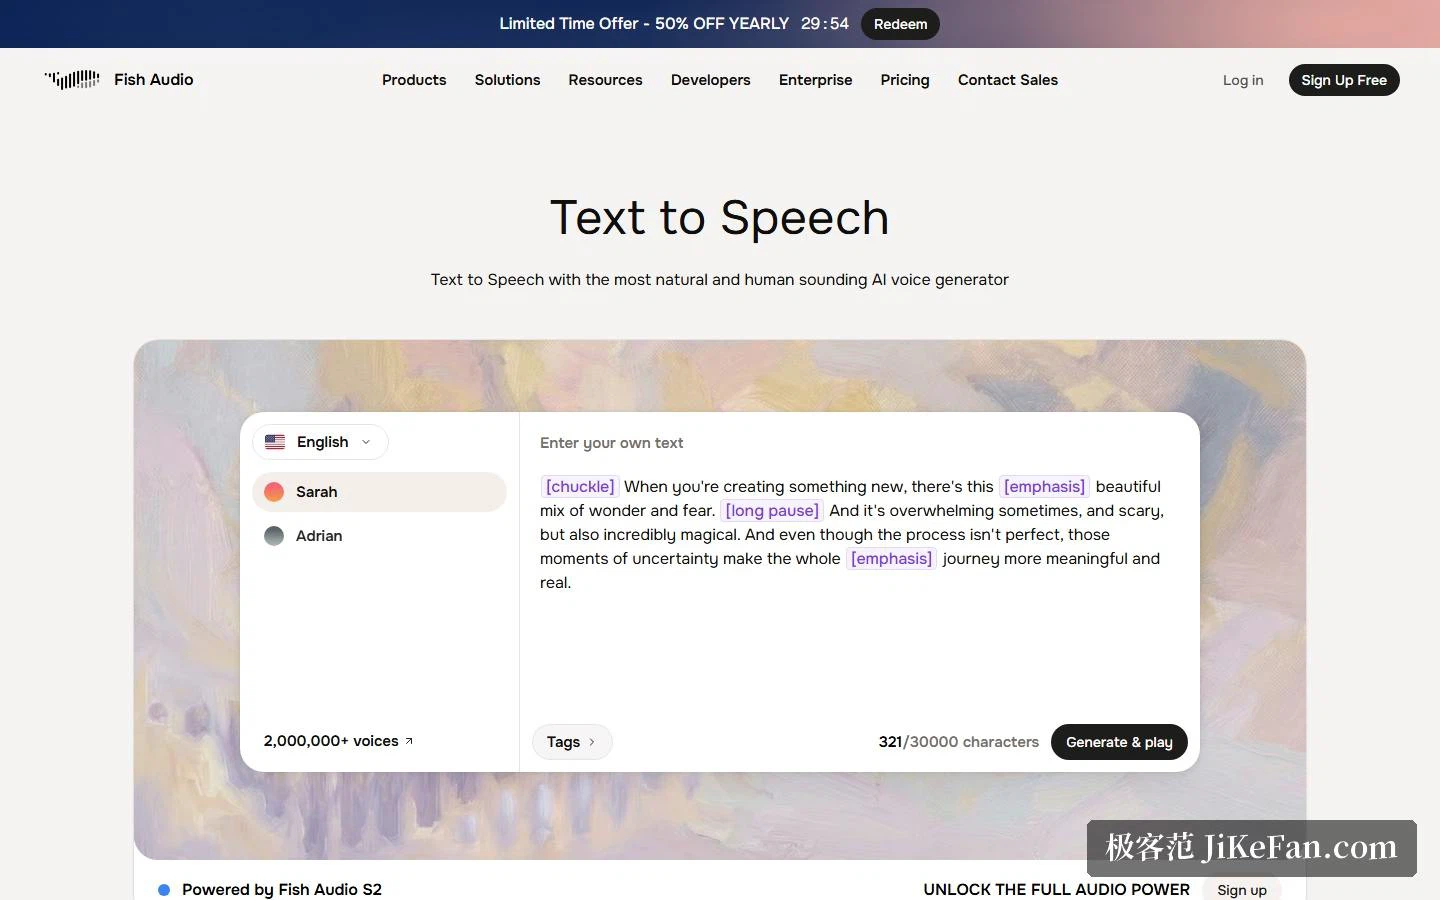
Wer schon einmal mit Sprachsynthese gearbeitet hat, kennt dieselbe Wand: Die Wörter kommen korrekt und völlig flach heraus. Fish Audio setzt die Regieanweisung in den Text selbst. Das Beispiel auf der Produktseite enthält [chuckle], [emphasis] und [long pause] direkt im Satz, und das Modell behandelt Lachen, Betonung und Pause entsprechend.
Der Satz an Marken umfasst mehr als 60 Einträge und zerfällt in zwei Gruppen, Emotions und Special. Die erste enthält Zustände wie [angry], [sad] und [whispering], die zweite körpernahe Reaktionen wie [laughing] und [sighing]. Für Off-Kommentar oder Figurenstimmen kostet es deutlich weniger, die Absicht ins Skript zu tippen, als sie in der Nachbearbeitung zu jagen.
2000000 Stimmen, 8 Sprachen
Wem das eigene Formen einer Stimmfarbe zu viel ist, greift in die Bibliothek. Die offizielle Zahl liegt über 2000000 Stimmen, filterbar nach Geschlecht, Alter, Tonhöhe, Energie, Emotion und Verwendungszweck, jede mit Hörprobe vor der Entscheidung. Auf der Syntheseseite nennt das Unternehmen 8 Sprachen: Englisch, Japanisch, Koreanisch, Chinesisch, Französisch, Deutsch, Arabisch und Spanisch.
Mehr als Synchronisation: der Rest des Werkzeugkastens
Textausgabe ist nur die Vorderseite. Die Produktlinie führt außerdem Spracherkennung, Stimmumwandlung, Stimmseparatierung, Audioübersetzung und Klangerzeugung. Bei der Transkription verspricht die Seite Live-Erkennung mit automatischer Satztrennung, Sprechermarken und Zeitstempeln, exportierbar als SRT, VTT oder JSON – und wer schon Untertitel gebaut hat, weiß, dass diese drei Formate den Unterschied machen zwischen allem neu tippen und eine Datei direkt in den Schnitt legen. Die Sprachabdeckung ist hier breiter als bei der Synthese: offiziell über 80.
Wie die Tarife gestaffelt sind
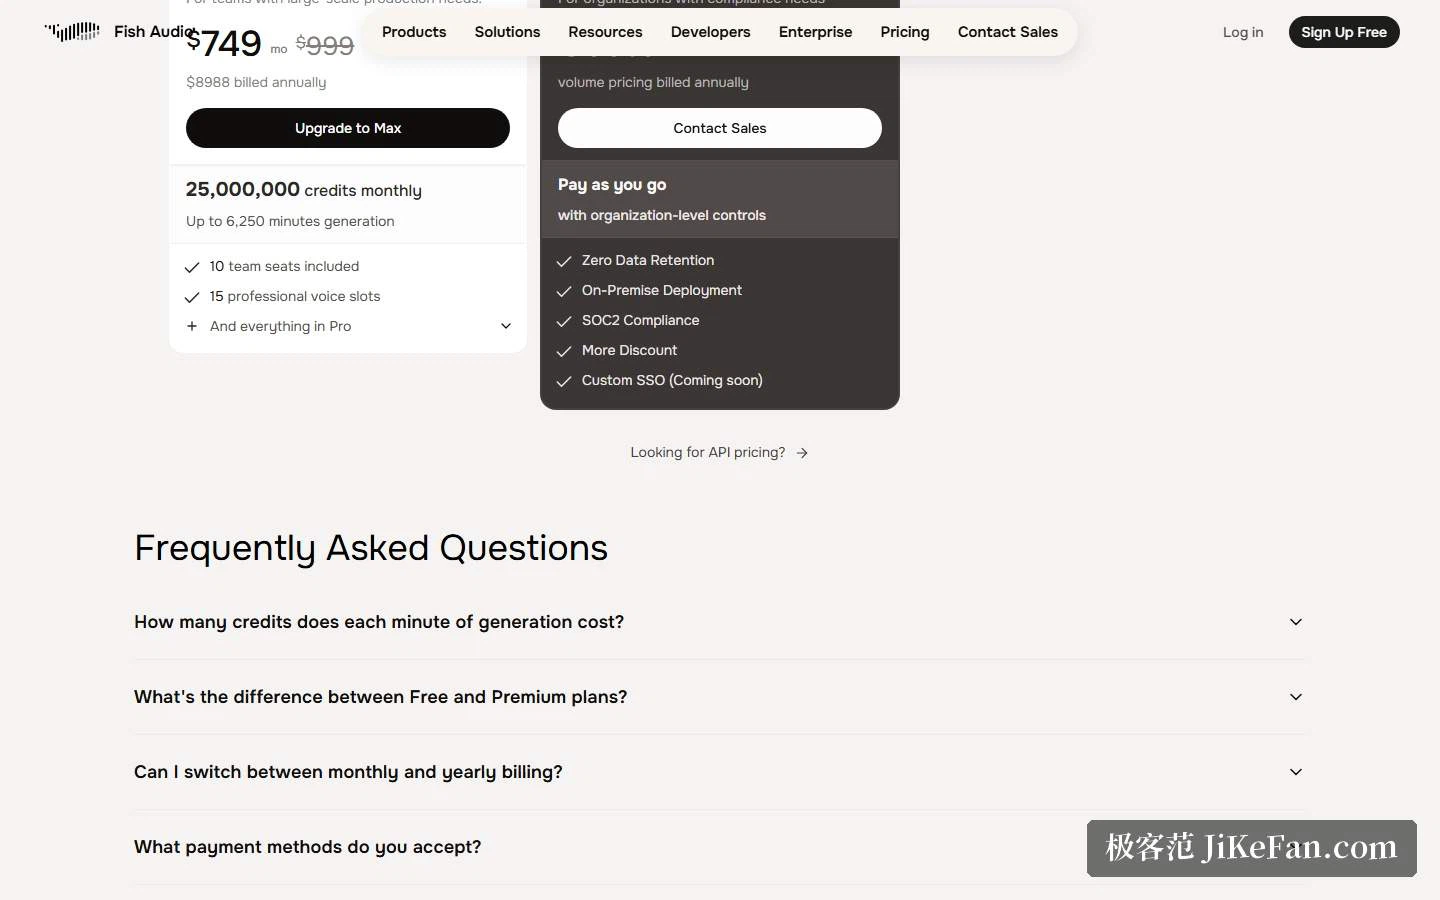
Über dem kostenlosen Tarif liegen drei Stufen. Plus kostet 66 Dollar im Jahr und liefert 250000 Credits, rund 200 Minuten erzeugtes Audio, eine Obergrenze von 15000 Zeichen pro Anfrage sowie Stimmdesign und eine kommerzielle Lizenz. Pro kostet 450 Dollar im Jahr für 2000000 Credits, etwa 1620 Minuten, 3 Teamplätze und 30000 Zeichen pro Anfrage. Darüber stehen Max und ein Enterprise-Tarif nach Anfrage, gerichtet an Organisationen mit Compliance-Anforderungen, mit Optionen wie null Datenaufbewahrung und Betrieb vor Ort.
Für wen es passt
Für Videosynchronisation, Hörbücher oder ein komplettes Stimmensemble für eine Spielfigurenriege ist der Einstieg kurz: anmelden, eine Stimme wählen oder ein Zehn-Sekunden-Muster hochladen, das Skript einfügen, Marken setzen, exportieren. Das kostenlose Kontingent reicht, um den ganzen Ablauf einmal zu durchlaufen, bevor man entscheidet, ob kommerzielle Lizenz und größere Kontingente das Geld wert sind.
Die Grenze, die man benennen sollte, ist der Klon selbst. Die technische Hürde ist niedrig, doch eine fremde Stimme in eigene Inhalte zu setzen berührt Persönlichkeits- und Stimmrechte, und Personen des öffentlichen Lebens sind der schärfste Fall; die offiziellen Antworten weisen ebenfalls darauf hin. Wer unsicher ist, beginnt mit einer Stimme, deren Rechte man hält, oder nutzt eine der lizenzierten Stimmen aus der Bibliothek.
Ein Werkzeug senkt die Hürde, das Urteil bleibt, wo es war. Zehn Sekunden genügen, um eine Stimme zu kopieren; schwer ist die Frage, ob diese Stimme überhaupt kopiert werden sollte und wofür sie dienen soll.