
RVC macht aus einer Stimme eine andere, mit zehn Minuten Trainingsaudio
Zusammenfassung
Ein offenes Framework für Stimmklang-Umwandlung und Live-Stimmwechsel. Es verlangt mindestens zehn Minuten saubere Sprache zum Trainieren, erreicht 170 Millisekunden Ende-zu-Ende-Latenz und bringt eine Weboberfläche plus eine Live-Oberfläche mit.
Empfehlen- Name
- RVC
- Version
- 2.3.260718
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinux
- Aktualisiert
- 2026-10-06 23:15
Eine andere Aufgabe als Sprachsynthese
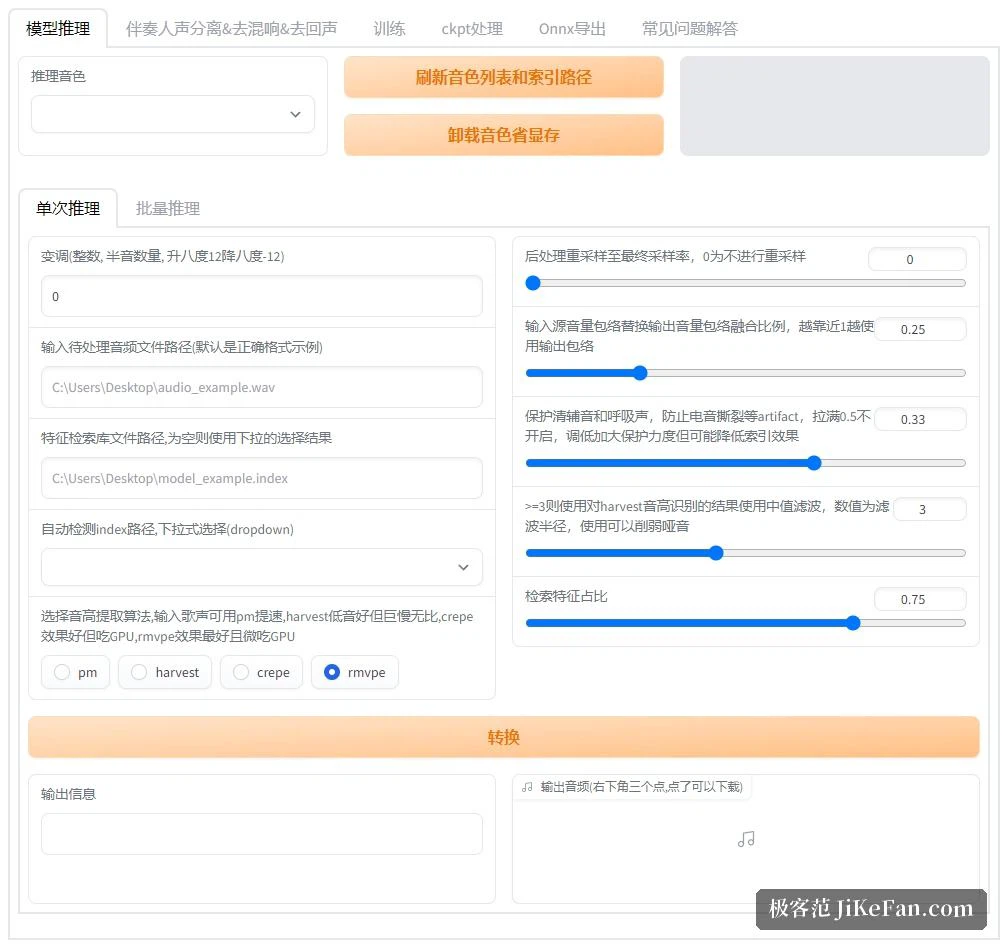
RVC steht für Retrieval-based-Voice-Conversion-WebUI, und das Projekt beschreibt sich als einfaches Framework für Stimmklang-Umwandlung und Stimmwechsel. Die Aufgabe unterscheidet sich von Sprachsynthese: es entsteht keine Sprache aus Text, sondern eine vorhandene Aufnahme bekommt einen anderen Stimmklang.
Solche Werkzeuge hatten früher eine hohe Schwelle. RVC drückt sie auf zwei Zahlen: mindestens 10 Minuten Sprachmaterial zum Trainieren, und 170 Millisekunden Ende-zu-Ende-Latenz beim Stimmwechsel in Echtzeit.
Eingabe ist die Stimme selbst, kein Skript. Man gibt eine Aufnahme hinein und bekommt denselben Inhalt im Klang eines Zielmodells zurück. Geändert wird, wer spricht, nicht was gesagt wird.
Die erste Eigenschaft in der Liste des Projekts ist eine top1-Retrieval-Stufe, die Merkmale der Quelle durch Merkmale aus dem Trainingssatz ersetzt, und damit Klangdurchsickern verhindert. Die gefundenen Merkmale stammen aus den Trainingsdaten selbst, weshalb die Ausgabe nahe an der Zielstimme bleibt und nicht Akzent und Aufnahmequalität der Quelle mitbringt.
Training mit zehn Minuten
Empfohlen werden mindestens 10 Minuten Sprache mit niedrigem Grundrauschen, wobei das Projekt anmerkt, dass auch eine kleine Datenmenge brauchbare Ergebnisse liefert. Diese Größenordnung heißt: kein Studio nötig, eine ruhige Aufnahme im Zimmer genügt im Wesentlichen.
Auch der Hardwarebedarf bleibt bescheiden. Laut Projekt ist das Training selbst auf einer verhältnismäßig schwachen Grafikkarte schnell. Das Grundmodell wurde auf dem offenen, hochwertigen VCTK-Korpus trainiert, knapp 50 Stunden davon, und das Projekt nennt keine urheberrechtlichen Bedenken. Eine ckpt-merge-Option im Reiter für Checkpoints erlaubt es, Modelle zu mischen und den Klang weiter zu verschieben.
Installation: drei Spuren für Abhängigkeiten
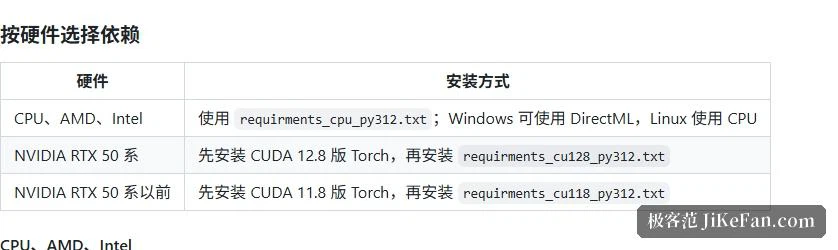
Dieser Zweig zielt auf 64-Bit-Python 3.12, auf der Ubuntu-Seite wird 24.04 empfohlen. Die Abhängigkeiten laufen in drei Spuren. CPU, AMD und Intel teilen sich eine Datei. Nvidia trennt nach Generation: die RTX 50 Reihe installiert zuerst den Torch-Build für CUDA 12.8, alles vor RTX 50 zuerst den Build für CUDA 11.8, danach folgt die passende Datei. Die Reihenfolge zählt, Torch vor den Abhängigkeiten. Ein Befehl gibt anschließend die Versionen von Torch und CUDA aus, damit die Umgebung vor dem Weitergehen bestätigt ist.
AMD und Intel nehmen die CPU-Spur: DirectML unter Windows, reine CPU unter Linux. Auf Nicht-Nvidia-Plattformen läuft es, der Abstand bei der Rechenleistung muss aber akzeptiert werden.
Modelle müssen am richtigen Ort liegen
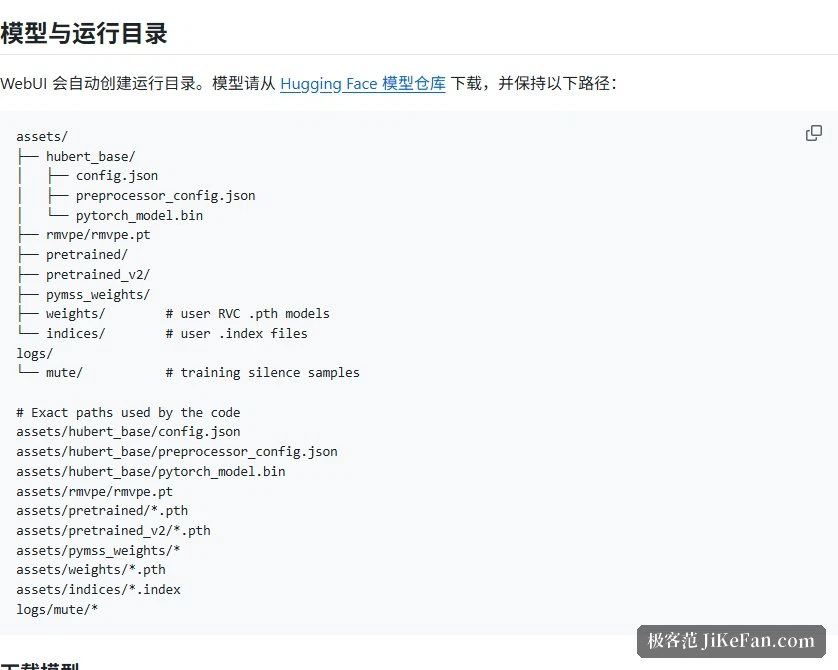
Die Weboberfläche legt ihr Arbeitsverzeichnis selbst an, die Modelle lädt und platziert man jedoch selbst. Verlangt wird eine feste Struktur: hubert_base für die Merkmalsextraktion, die rmvpe-Gewichte für die Tonhöhe, pretrained und pretrained_v2 fürs Training, pymss_weights für die Stimmertrennung, weights für eigene Modelle und indices für die Indexdateien.
Auch der Download läuft über ein Kommandozeilenwerkzeug, nach Zweck gruppiert. Eine Gruppe ist für Inferenz und Merkmalsextraktion nötig, eine weitere fürs Training von v1 und v2, eine dritte für die Stimmertrennung ist optional, und eine DirectML-Umgebung unter Windows braucht zusätzlich Tonhöhengewichte im onnx-Format. Unter Windows müssen die beiden FFmpeg-Programme von Hand ins Projektverzeichnis gelegt werden.
Echtzeit-Stimmwechsel und Latenz
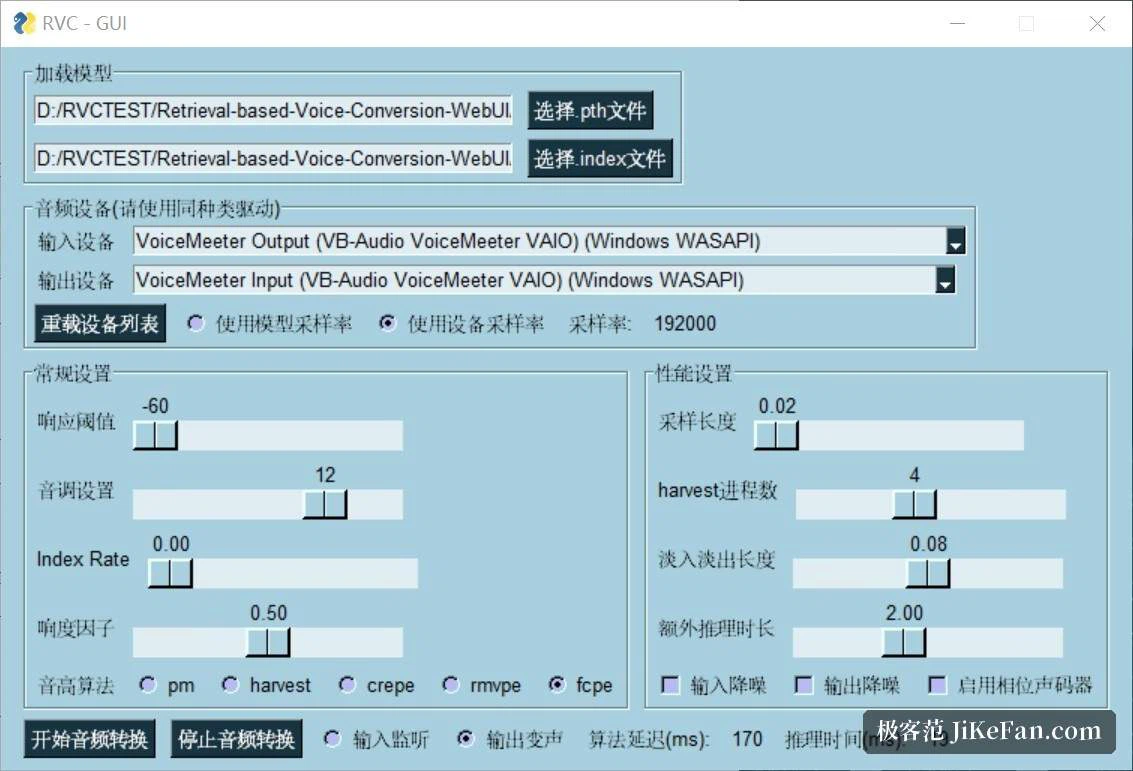
Zwei Einstiege sind vorhanden, die Weboberfläche und eine eigene Oberfläche für den Live-Wechsel. Die Latenz ist hier die Zahl, die zählt: das Projekt nennt 170 Millisekunden Ende zu Ende, und 90 Millisekunden mit ASIO-Ein- und Ausgabegeräten, räumt aber ein, dass dies stark von der Treiberunterstützung abhängt.
Die Tonhöhenanalyse ist ein Schlüssel zu dieser Größenordnung. Das Projekt nutzt den RMVPE-Algorithmus von der InterSpeech2023, beschrieben als Ende des Problems dumpfer Stimmen, dabei schnell und ressourcenschonend. Die Oberfläche erlaubt auch pm, harvest oder crepe.
Start und Lizenz
Der Start ist ein Befehl, der Standardport ist 7865. Ein Ubuntu-Server ohne grafische Oberfläche kann einen Schalter setzen, damit der Browser nicht automatisch geöffnet wird. Eigene Modelle gehören ins weights-Verzeichnis, Indizes ins indices-Verzeichnis.
Die Lizenz ist MIT, und das Grundmodell ruht auf dem offenen VCTK-Datensatz, der laut Projekt keine urheberrechtlichen Bedenken aufwirft. Eines bleibt eigene Verantwortung: Stimmkonvertierung arbeitet mit der Stimme eines anderen, wer das Ergebnis veröffentlicht, sollte die Erlaubnis vorher klären.