
GPT-SoVITS trainiert eine Stimmvorlage mit einer Minute Audio, fünf Sekunden für Zero-Shot
Zusammenfassung
Eine quelloffene WebUI für Sprachsynthese. Fünf Sekunden einer menschlichen Stimme genügen für Zero-Shot-Ausgabe, eine Minute Trainingsmaterial reicht für eine nähere Stimmfarbe, und die Inferenz wechselt zwischen fünf Sprachen inklusive Mandarin, Englisch, Japanisch, Koreanisch und Kantonesisch.
Empfehlen- Name
- GPT-SoVITS
- Version
- 20260917
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinuxmacOS
- Aktualisiert
- 2026-10-06 18:49
Einer Maschine beizubringen, in einer bestimmten Stimme zu sprechen, wird von Jahr zu Jahr billiger. GPT-SoVITS drückt den Preis auf zwei Zahlen: fünf Sekunden und eine Minute. Fünf Sekunden sind die Untergrenze für eine Stimmprobe und reichen, um im Zero-Shot-Betrieb Sprache zu erzeugen. Eine Minute ist die Untergrenze für Trainingsmaterial und reicht, damit ein Feintuning die Stimmfarbe sichtbar näher bringt. Das Projekt ist quelloffen, und die Überschrift des Repositors sagt es ohne Umschweife: eine Minute Audio genügt, um ein brauchbares TTS-Modell zu trainieren.
Zwei Wege: ohne Training, oder mit ein wenig Training
Das Team teilt die Fähigkeit in zwei Pfade, und jeder bedient eine andere Art von Bedarf.
Zero-Shot-TTS ist der reibungslose Pfad. Man gibt eine Probe von fünf Sekunden hinein, und Text wird sofort zu Sprache. Das passt zu allen, die erst prüfen wollen, ob das Ergebnis reicht, oder die nur gelegentlich eine Stimme brauchen. Keine Trainingswarteschlange, kein Datensatz zum Zusammensuchen.
Few-Shot-TTS ist der besser klingende Pfad. Eine Minute Trainingsmaterial erkauft eine höhere Ähnlichkeit und einen natürlicheren Vortrag. Die eigentliche Bedeutung dieser Schwelle liegt darin, was sie wegnimmt: Ein eigenes Stimmmodell zu trainieren ist keine Facharbeit mehr, die stundenlange Studioaufnahmen verlangt, sondern etwas, das man nach einem am Telefon gesprochenen Absatz versuchen kann.
Welche Sprachen es spricht
Die offizielle Liste nennt Englisch, Japanisch, Koreanisch, Kantonesisch und Chinesisch. Interessanter ist die sprachübergreifende Inferenz: Die Sprache bei der Synthese muss nicht zur Sprache des Trainingssatzes passen. Eine in einer Sprache aufgenommene Probe kann grundsätzlich eine andere Sprache sprechen, ohne eigenen Datensatz je Sprache.
Die WebUI bringt die Datenaufbereitung mit
Wer tatsächlich schon eine Stimme geklont hat, weiß, dass das Schwere selten das Modell ist. Es ist die Vorbereitung: was mit Hintergrundmusik geschieht, die in die Aufnahme blutet, wie eine lange Datei in Schnipsel zerlegt wird und wer danach die Transkripte schreibt. GPT-SoVITS legt diese Schritte in die WebUI – Trennung von Stimme und Begleitung, automatisches Zerteilen des Trainingssatzes, mehrsprachige Spracherkennung mit Beschriftung und Textannotation.
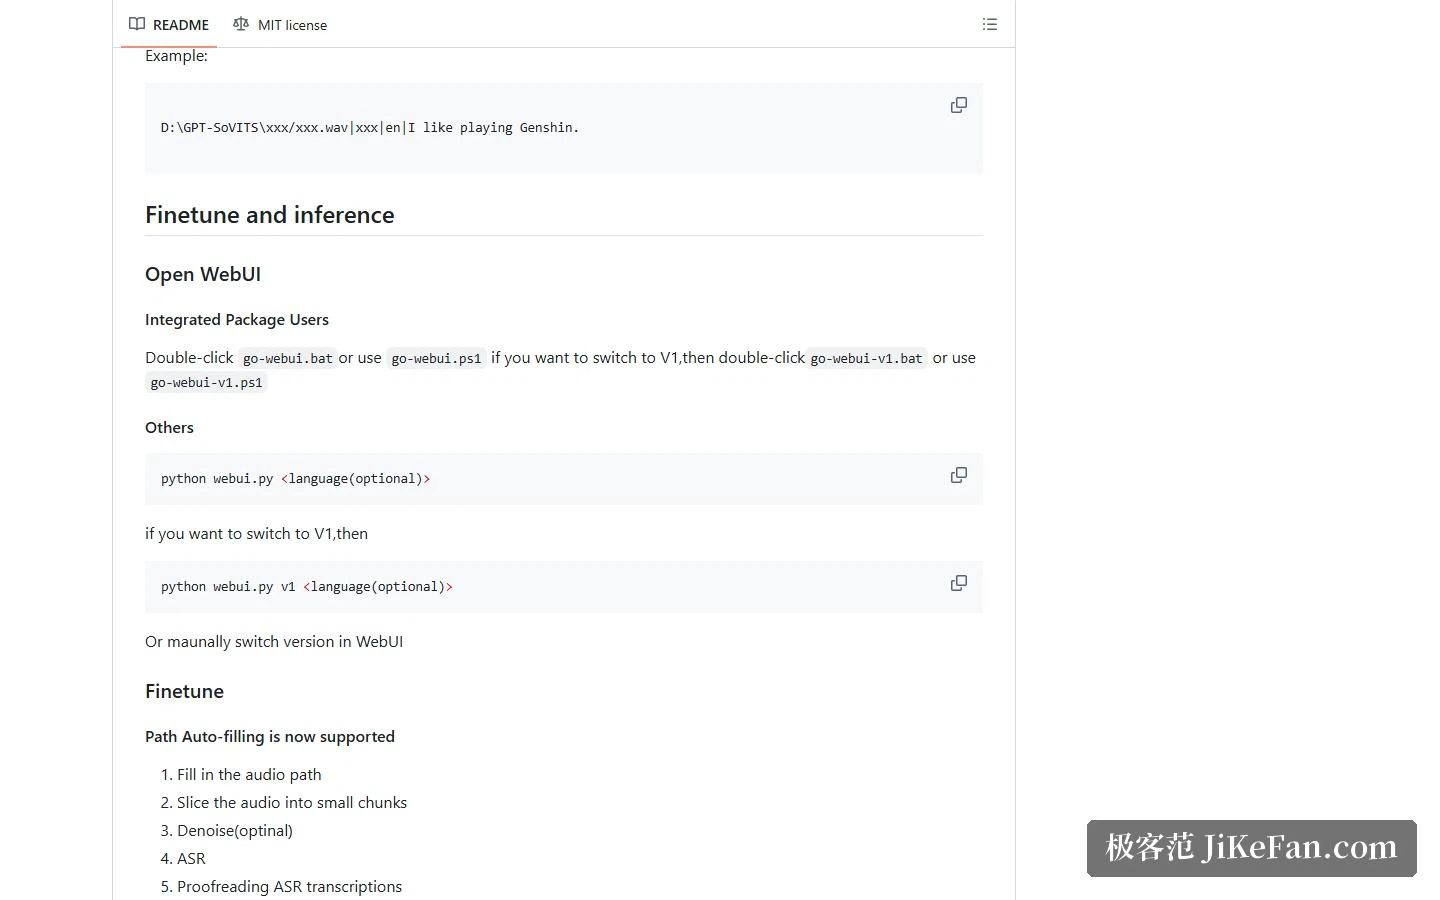
Die tatsächliche Reihenfolge lautet also: einen Audiopfad angeben, zerteilen, bei Bedarf entrauschen, Spracherkennung laufen lassen, das Transkript korrigieren, dann zum Reiter für das Feintuning wechseln und trainieren. Die Erkennung bündelt mehrere Motoren, darunter Fun-ASR, SenseVoice und FunASR, sodass Neulinge diese Kette nicht selbst zusammenbauen müssen.
Viele Versionen, welche nehmen
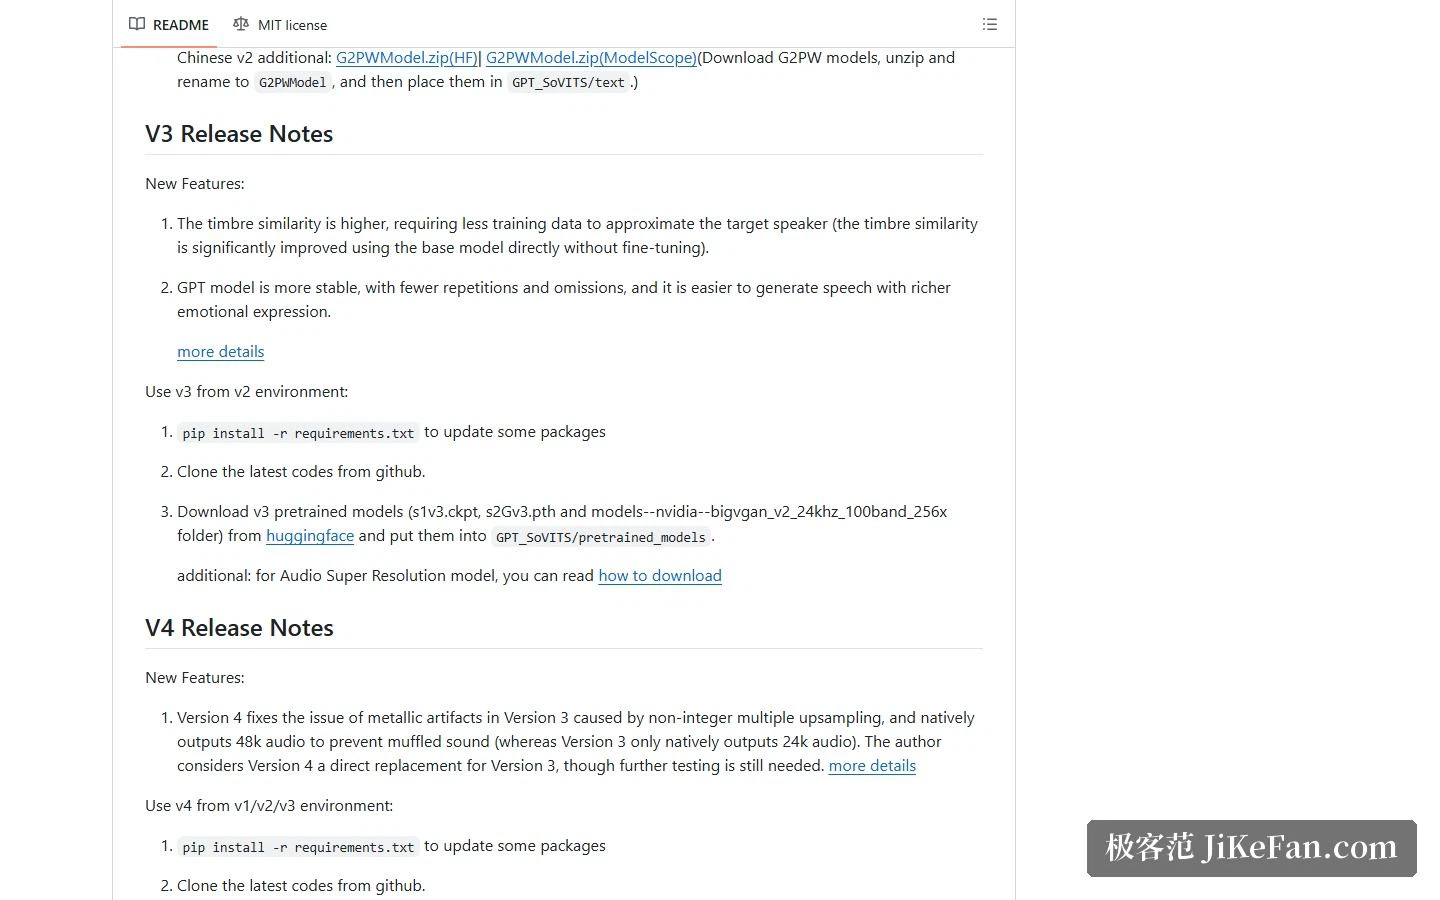
Das Repositor führt mehrere Fassungen – V1, V2, V2Pro, V3 und V4 –, umschaltbar über einen Startparameter, mit passenden Startskripten im Windows-Paket. Ein paar Unterschiede zählen. V2 erweiterte das vortrainierte Modell von 2000 auf 5000 Stunden Daten und ergänzte Koreanisch und Kantonesisch. V3 hob die Stimmähnlichkeit schon ohne Feintuning deutlich an und machte das GPT-Modul stabiler und emotional vielfältiger. V4 beseitigte das metallische Rauschen, das V3 durch nicht ganzzahliges Upsampling erzeugte, und gibt nativ 48kHz aus, wo V3 bei 24kHz arbeitet.
Wie mühsam ist die Installation
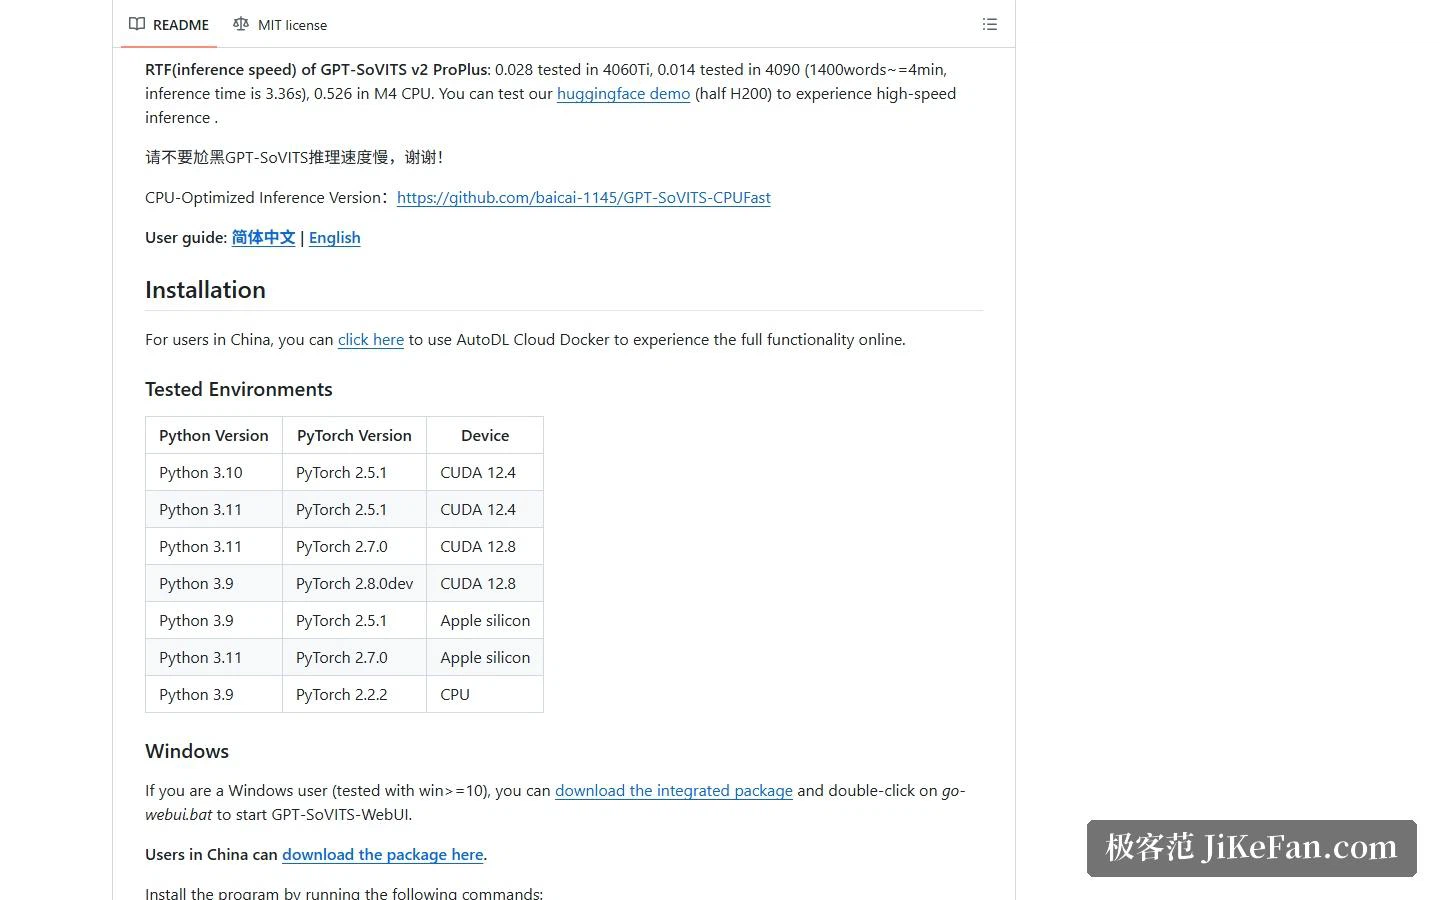
Es gibt mehrere Wege. Am einfachsten ist das Windows-Paket: herunterladen, entpacken, Startskript doppelklicken, und die WebUI öffnet sich. Wer die Umgebung lieber in einer Shell verwaltet, findet ein PowerShell-Skript für Windows und Shell-Skripte für Linux und macOS, beide mit Angabe von Gerätetyp und Modellquelle. Darunter liegen die manuelle Installation, bei der Abhängigkeiten und FFmpeg selbst zu richten sind, und Docker, wo die offiziellen Hinweise warnen, dass das schlanke Abbild ohne Spracherkennungs- und Stimmseparationsmodelle ausgeliefert wird und diese separat geladen werden müssen.
Zur Umgebung: Die getesteten Kombinationen decken Python 3.9 bis 3.11 und PyTorch 2.2 bis 2.7 ab, mit Desktop-Setups auf einer eigenen Karte und leichten Setups rein auf CPU. Eines sollte man vorher wissen: Auf manchen Plattformen fallen mit GPU trainierte Modelle erkennbar schlechter aus als auf anderer Hardware, weshalb das Projekt dort vorläufig auf CPU-Training zurückfällt – was spürbar langsamer ist.
Für wen es passt
Wenn das Ziel ein Stimmmodell für die eigene Stimme oder für eine bestimmte Klangfarbe ist und die Daten auf dem eigenen Rechner bleiben sollen, passt die Ausrichtung: geringer Datenbedarf, vollständige Werkzeugkette und eine MIT-Lizenz, die wenige Einschränkungen lässt.
Allerdings braucht es eine brauchbare Grafikkarte oder die Geduld für CPU-Inferenz. Auf manchen Plattformen dauert die Trainingsphase sichtbar länger, und das sollte man vorher einrechnen. Davon getrennt liegt die eigentliche Grenze des Stimmklonens nicht in der Technik, sondern im Recht: Eine fremde Stimme zu nutzen, erst recht die einer Person des öffentlichen Lebens, berührt Persönlichkeits- und Stimmrechte. Woher die Rechte kommen, klärt man besser, bevor man das Werkzeug anfasst.
Ein TTS-Modell mit einer Minute Daten zu trainieren, hätte vor wenigen Jahren unmöglich geklungen. Je stärker das Werkzeug, desto mehr muss der Nutzer selbst die Linie halten – dürfen und sollen bleiben zwei verschiedene Fragen.