
F5-TTS liefert MIT-Code und nicht-kommerzielle Gewichte, per pip installiert
Zusammenfassung
Ein quelloffenes Projekt für Sprachsynthese auf Basis von Flow Matching, mit pip-Paket, Kommandozeilen-Inferenz und Gradio-Oberfläche. Der Code ist MIT, die vortrainierten Gewichte sind wegen der Trainingsdaten nicht kommerziell nutzbar.
Empfehlen- Name
- F5-TTS
- Version
- 1.1.22
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinuxmacOS
- Webseite
- https://github.com/SWivid/F5-TTS
- Aktualisiert
- 2026-10-06 20:44
F5-TTS ist die offizielle Umsetzung eines Papiers, und das Papier trägt einen verspielten Titel: ein Märchenerzähler, der mit Flow Matching flüssige und getreue Sprache vortäuscht. Der Name ist leicht, der technische Weg nicht. Synthetisiert wird über Flow Matching, auf einem Rückgrat aus einem Diffusion Transformer zusammen mit ConvNeXt V2.
Das Projekt ist quelloffen, hat mehr als zwanzig Fassungen veröffentlicht, und das Repositor führt das Grundmodell neben dem Code für Inferenz, Training und Auslieferung.
Drei Stichworte: Flow Matching, ConvNeXt V2, Sway Sampling
Die Projektnotizen stellen drei Punkte nebeneinander. Der erste ist F5-TTS selbst, das einen Diffusion Transformer mit ConvNeXt V2 verbindet und laut den Autoren schneller zu trainieren und zu inferieren ist. Der zweite ist E2 TTS, eine Nachbildung auf Basis eines Flat-UNet-Transformers. Der dritte ist Sway Sampling, eine Strategie zur Abtastung der Flow-Schritte während der Inferenz, die laut den Autoren die Qualität sichtbar hebt.
Für Nutzer setzen die ersten beiden die Obergrenze dessen, was das Modell kann, und der dritte bestimmt, was ein gegebenes Modell tatsächlich liefert. Sway Sampling ist der interessante Punkt, weil es zur Inferenzzeit greift und kein Neutraining braucht – vermutlich der Grund für die eigene Zeile.
Installation: eine pip-Zeile, oder gleich Docker
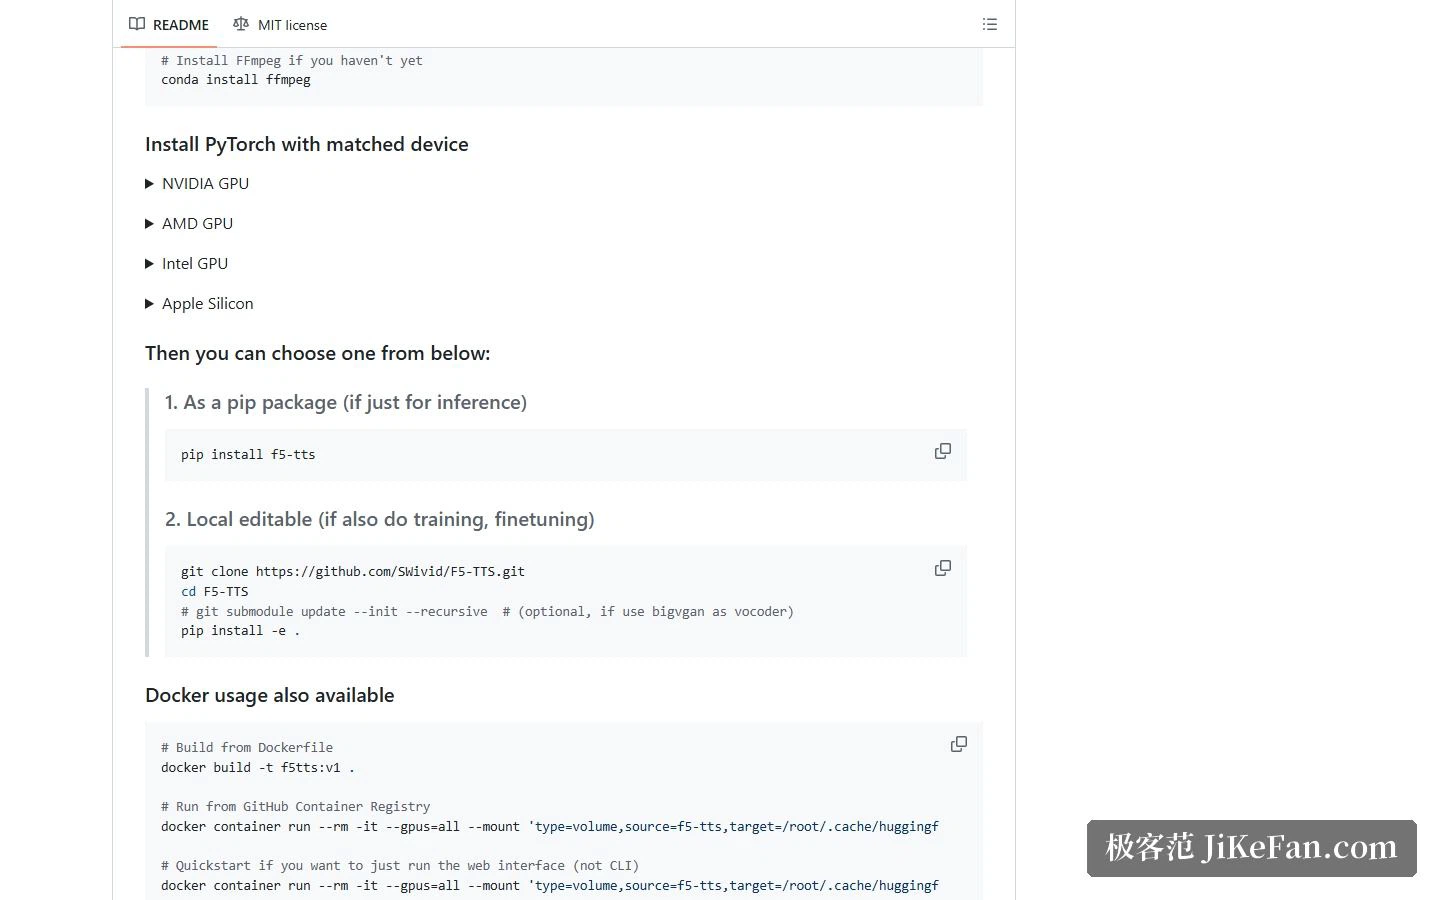
Die Installation teilt sich nach Absicht. Wer nur inferieren will, kommt mit dem pip-Paket aus. Wer trainieren oder feinabstimmen will, klont das Repositor und installiert editierbar. Vor dem Ziehen von PyTorch passt man die Version an die Hardware an; die Hinweise nennen getrennte Befehle für NVIDIA, AMD, Intel und Apple Silicon.
Docker ist der zweite Weg: entweder aus dem Dockerfile im Repositor bauen oder das offizielle Abbild ziehen und starten, und die Hinweise enthalten einen Kurzbefehl, der nichts als die Weboberfläche hochfährt.
Drei Arten der Nutzung: Terminal, Webseite, gesprochener Dialog
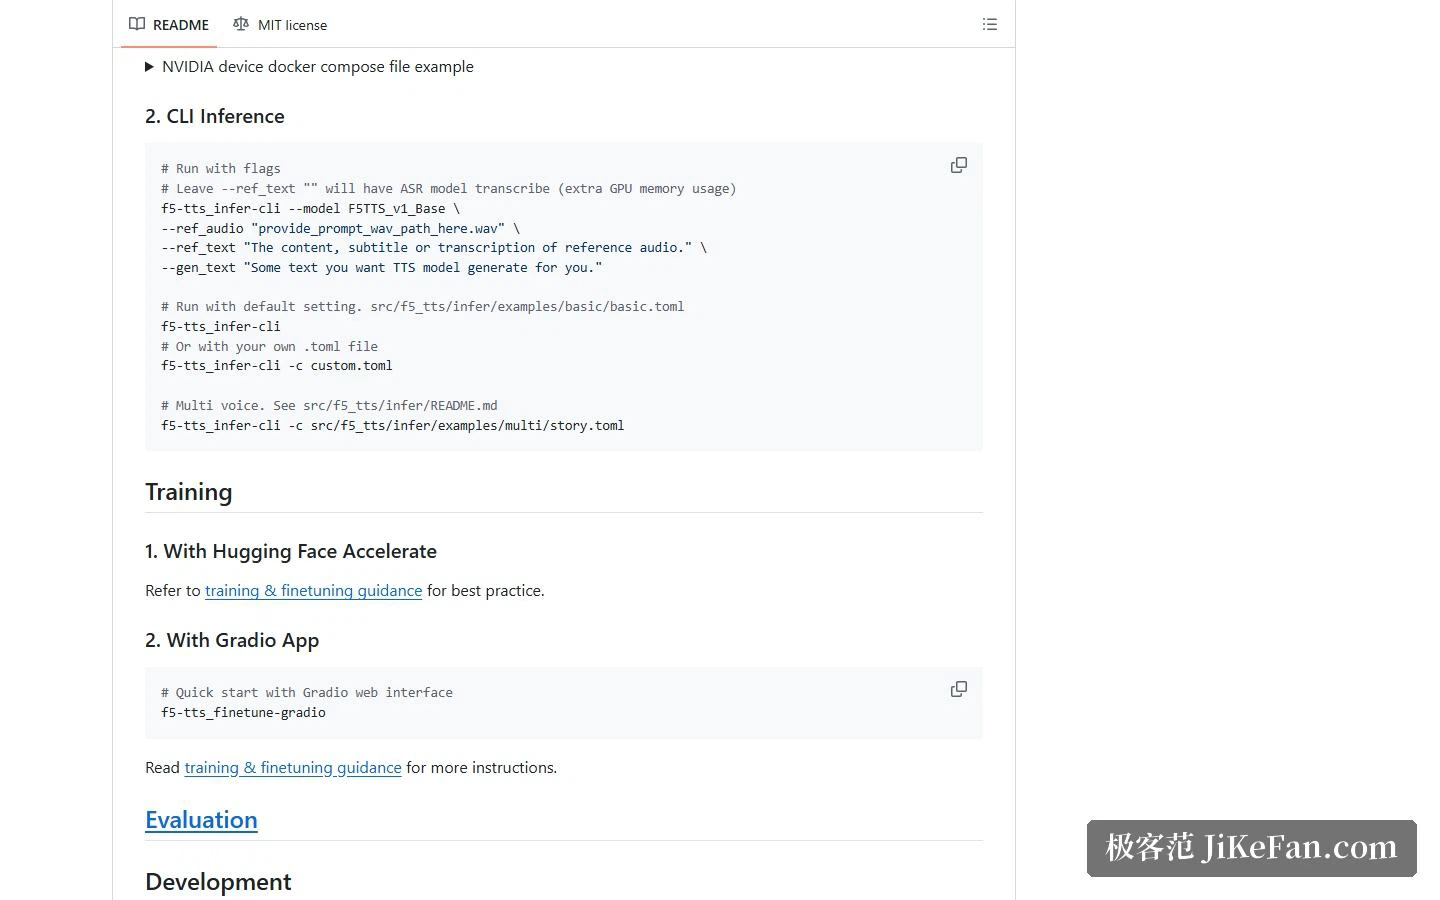
Die Parameter der Kommandozeile sind gut nachzuvollziehen: eine Referenzaudiodatei, das Transkript dazu und der Text, der gesprochen werden soll – und das Modell liest den Zieltext in der Referenzstimme. Ein Detail ist erwähnenswert: Das Referenztranskript darf leer bleiben, dann transkribiert ein Spracherkennungsmodell automatisch, zum Preis von etwas zusätzlichem Speicher.
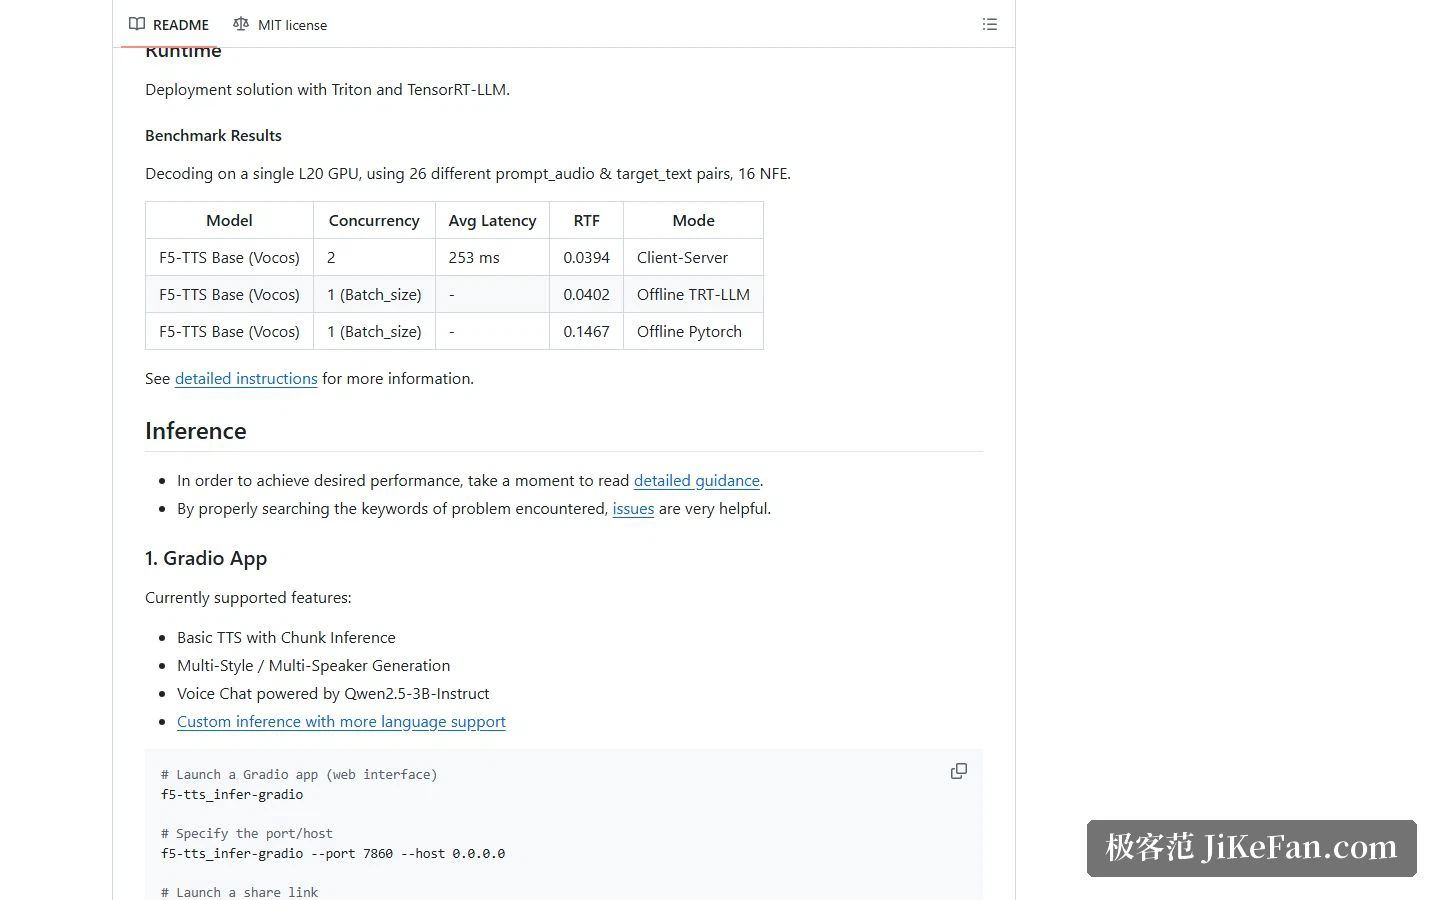
Wem das Terminal zuwider ist, startet die Gradio-Oberfläche. Die dort gelisteten Funktionen reichen über einfache Synthese hinaus bis zu mehreren Stilen und mehreren Sprechern, dazu ein gesprochener Dialogmodus, angetrieben von einem instruktionsabgestimmten Sprachmodell mit drei Milliarden Parametern. Die Seite macht also nicht nur Text zu Audio, sie kann auch eine Runde Konversation in Sprache führen.
Die Messwerte, auf einer einzelnen L20 erhoben
Der Abschnitt zur Auslieferung enthält einen Benchmark: eine L20-Karte, 26 Paare aus Referenzaudio und Zieltext, 16 Inferenzschritte. F5-TTS Base erreicht im Client-Server-Betrieb mit Nebenläufigkeit 2 im Mittel 253 Millisekunden Latenz bei einem Echtzeitfaktor von etwa 0,0394; offline über TensorRT-LLM sind es 0,0402, offline mit PyTorch 0,1467. Je niedriger der Faktor, desto weiter läuft die Erzeugung der Wiedergabe voraus, und die Spanne zwischen diesen drei Zahlen zeigt, wie viel die Wahl der Auslieferung ausmacht.
Training und Feintuning
Auch das Training teilt sich in zwei Wege. Der eine läuft über Hugging Face Accelerate und passt zu gewöhnlichem Training und Feintuning. Der andere ist eine Gradio-Seite, und die Hinweise nennen einen Startbefehl für eine eigene Feintuning-Oberfläche, sodass kein Code nötig ist. Wer das Modell nur in eine bestimmte Stimmfarbe biegen will, spart sich auf dem zweiten Weg viel Arbeit.
Die Lizenz: MIT-Code, nicht-kommerzielle Gewichte
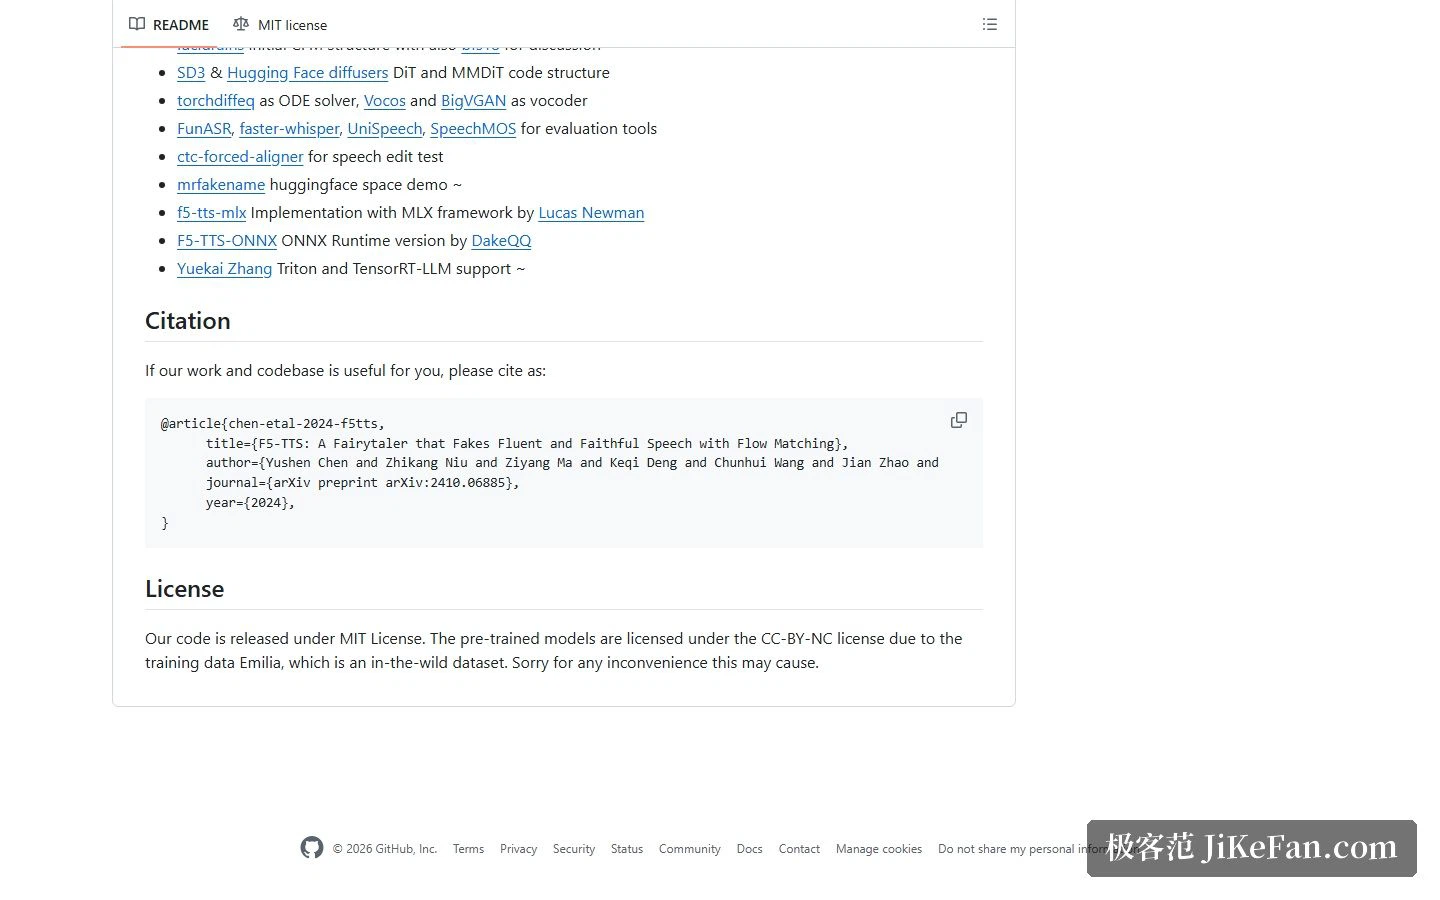
Dieser Teil verdient genaues Lesen. Der Lizenzabschnitt stellt klar, dass der Code unter MIT steht, die vortrainierten Modelle aber anders lizenziert sind: Weil die Trainingsdaten, Emilia, in freier Wildbahn gesammelt wurden, kommen die Gewichte unter einer nicht-kommerziellen Creative-Commons-Lizenz. Die Autoren entschuldigen sich im selben Absatz dafür.
Man darf also auf dem Code aufbauen, aber die offiziellen Gewichte direkt in ein kommerzielles Projekt zu heben, stößt an eine Lizenzwand. Wer das umgehen will, trainiert üblicherweise selbst auf einem freizügiger lizenzierten Datensatz, was zusätzliche Rechenzeit und Datenvorbereitung kostet.
Für wen es passt
Wer als Forscher oder Entwickler auf einem klar strukturierten, aktiv weiterentwickelten Open-Source-Projekt für Sprachsynthese experimentieren will, findet hier solide Codequalität und vollständige Dokumentation: mehrere Installationswege, Auslieferungsoptionen mit Triton und TensorRT-LLM und fertige Einstiege für Inferenz wie Training.
Wer dagegen einfach einen kommerziell nutzbaren Weg zur Sprachsynthese sucht, muss zuerst die Lizenzfrage lösen oder die Kosten eines eigenen Trainings abwägen. Unabhängig vom Modell lohnt es sich außerdem, die Erlaubnis fürs Stimmklonen vorab zu klären – Inhalte mit fremder Stimme zu bauen, erst recht mit der einer Person des öffentlichen Lebens, berührt Persönlichkeits- und Stimmrechte.
Ein offenes Projekt legt die Fähigkeit auf den Tisch und die Einschränkung in den Lizenzabschnitt. Zwei Minuten Lektüre vor dem Start kosten meist weniger als eine Nacharbeit danach.