
Whisper gibt es in sechs Größen, und der Speicherbedarf entscheidet
Zusammenfassung
Ein universelles Spracherkennungsmodell, das Transkription, Übersetzung ins Englische und Spracherkennung in einem Durchlauf erledigt. Sechs Größen reichen von rund 39 Millionen bis rund 1,55 Milliarden Parametern, Code und Gewichte stehen unter MIT.
Empfehlen- Name
- Whisper
- Version
- 15.5
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinuxmacOS
- Webseite
- https://github.com/openai/whisper
- Aktualisiert
- 2026-10-06 16:03
Ein Modell statt einer Kette
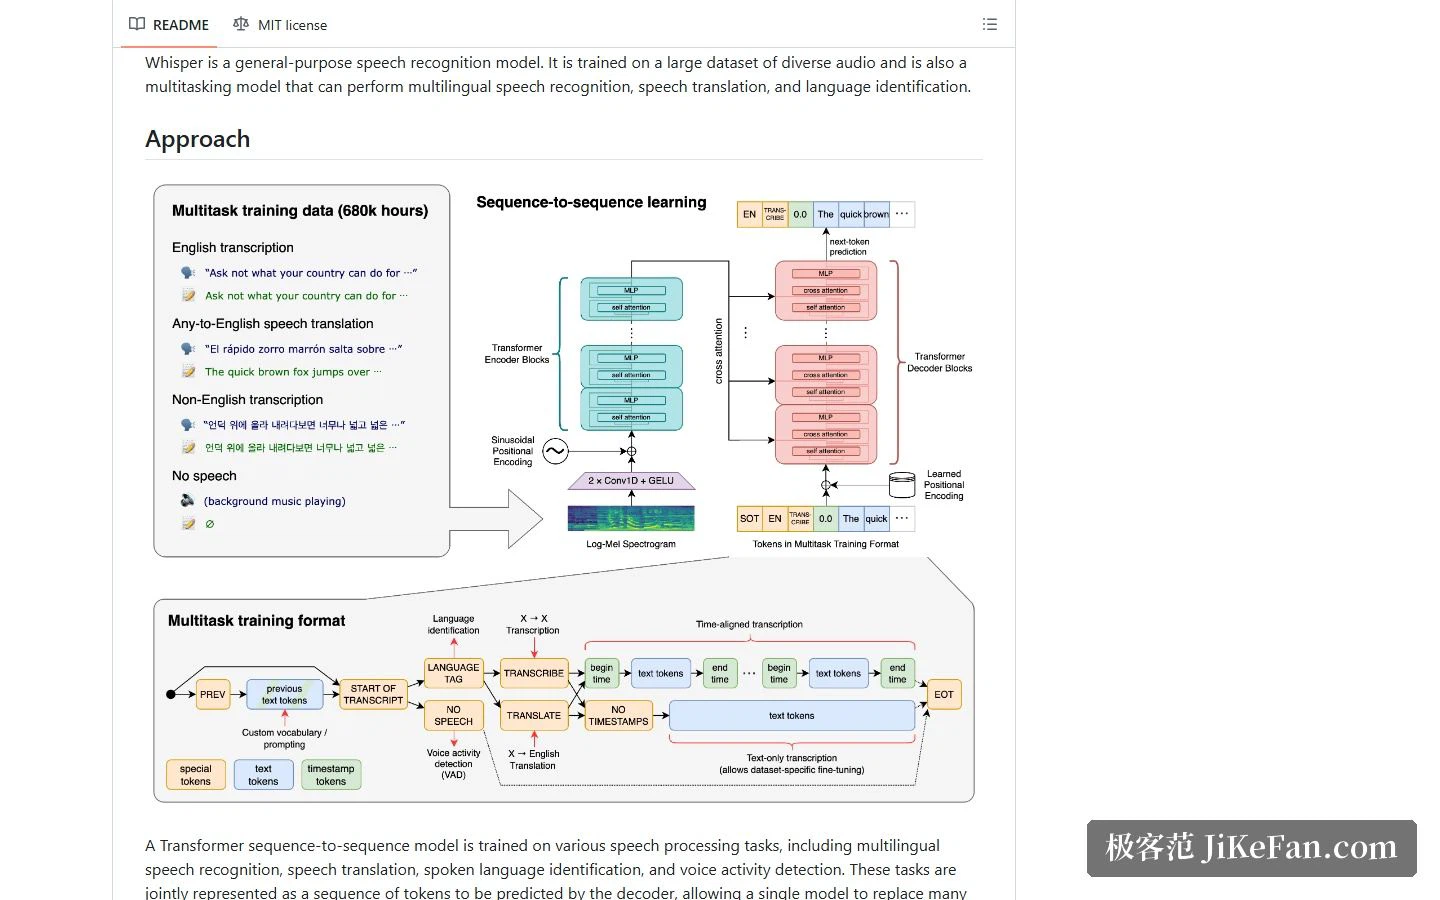
Whisper gehört zu den Projekten, die eine ganze Kette durch ein einziges Modell ersetzen. Herkömmliche Sprachverarbeitung läuft in mehreren Stufen: erst die Sprache erkennen, dann transkribieren, bei Bedarf ein separates Übersetzungsmodell anhängen, und die Erkennung von Sprachaktivität steht oft als eigener Schritt daneben. Whisper fasst diese Aufgaben zu einer Tokenfolge zusammen, die der Decoder vorhersagt und die in einem einzigen Encoder-Decoder-Transformer gemeinsam gelernt wird.
Das Repo nennt für das Training über mehrere Aufgaben einen Umfang von 680 000 Stunden, gesammelt aus vielen Sprachen und sehr unterschiedlichen Aufnahmebedingungen. Das Ziel ist schlicht formuliert: ein universelles Spracherkennungsmodell.
Vier Fähigkeiten, eine Übersetzungsrichtung
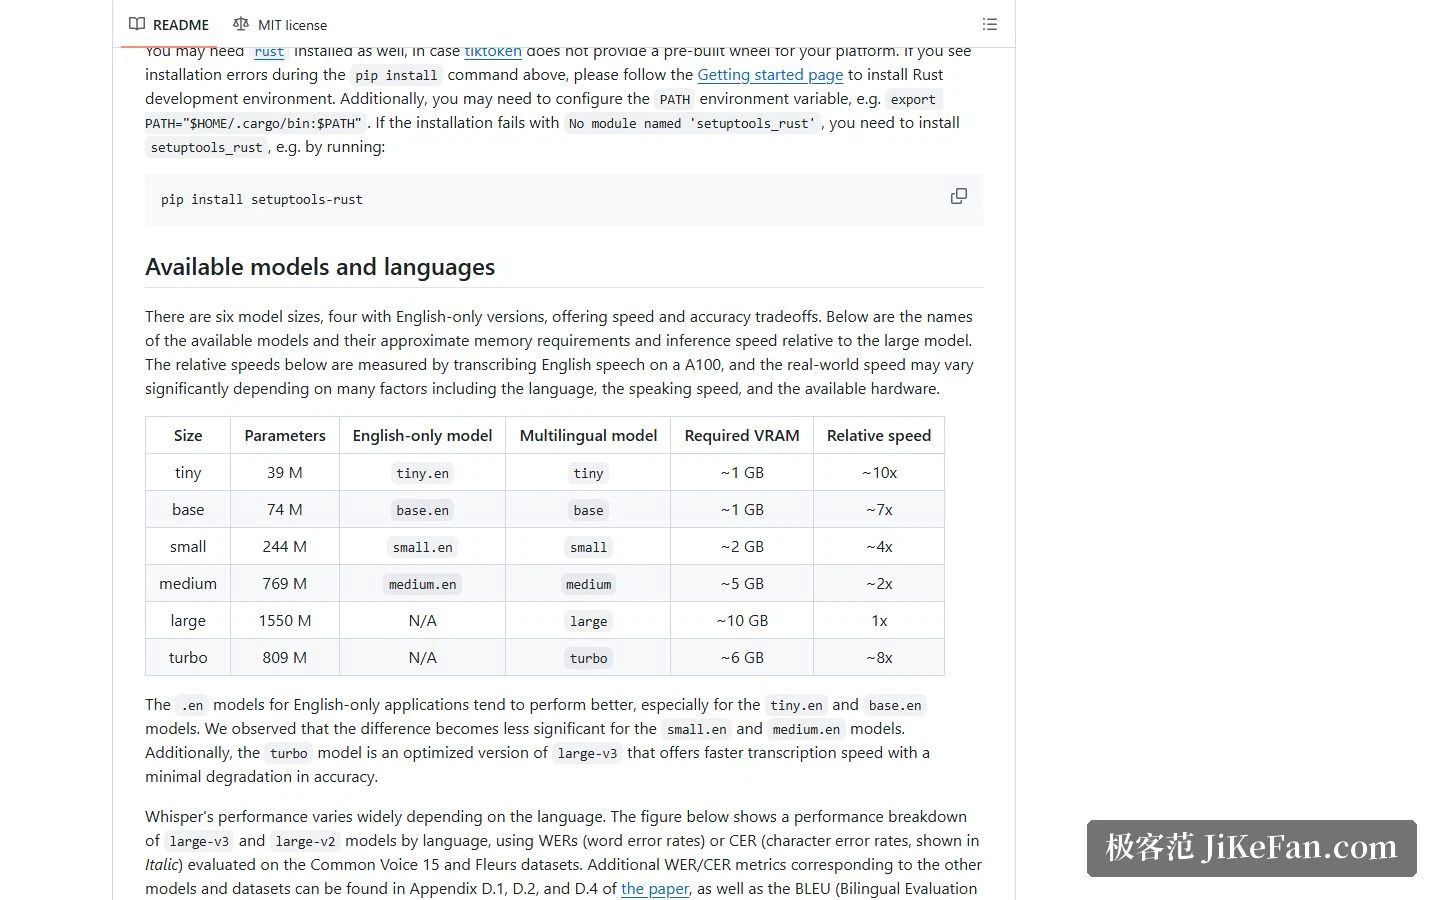
Die offizielle Liste hat vier Einträge: mehrsprachige Transkription, Sprachübersetzung, Erkennung der gesprochenen Sprache und Erkennung von Sprachaktivität. Übersetzung heißt hier, nicht-englische Sprache direkt in englischen Text zu verwandeln. Es ist keine Übersetzung zwischen beliebigen Sprachpaaren, und dieser Unterschied zählt, bevor man einen Ablauf darum herum plant. Der Weg bleibt also einbahnig, und das sollte man wissen, bevor man ihn einplant.
Lange Aufnahmen in 30-Sekunden-Fenstern
Langes Audio läuft über ein gleitendes Fenster. Die Doku erklärt, dass der Transkriptionsaufruf die ganze Datei einliest und dann in 30-Sekunden-Fenstern autoregressiv vorhersagt. Eine einstündige Aufnahme wird damit zu mehr als hundert Fenstern, die nacheinander durchlaufen, ohne dass man vorher selbst schneiden muss.
Sechs Größen zur Auswahl
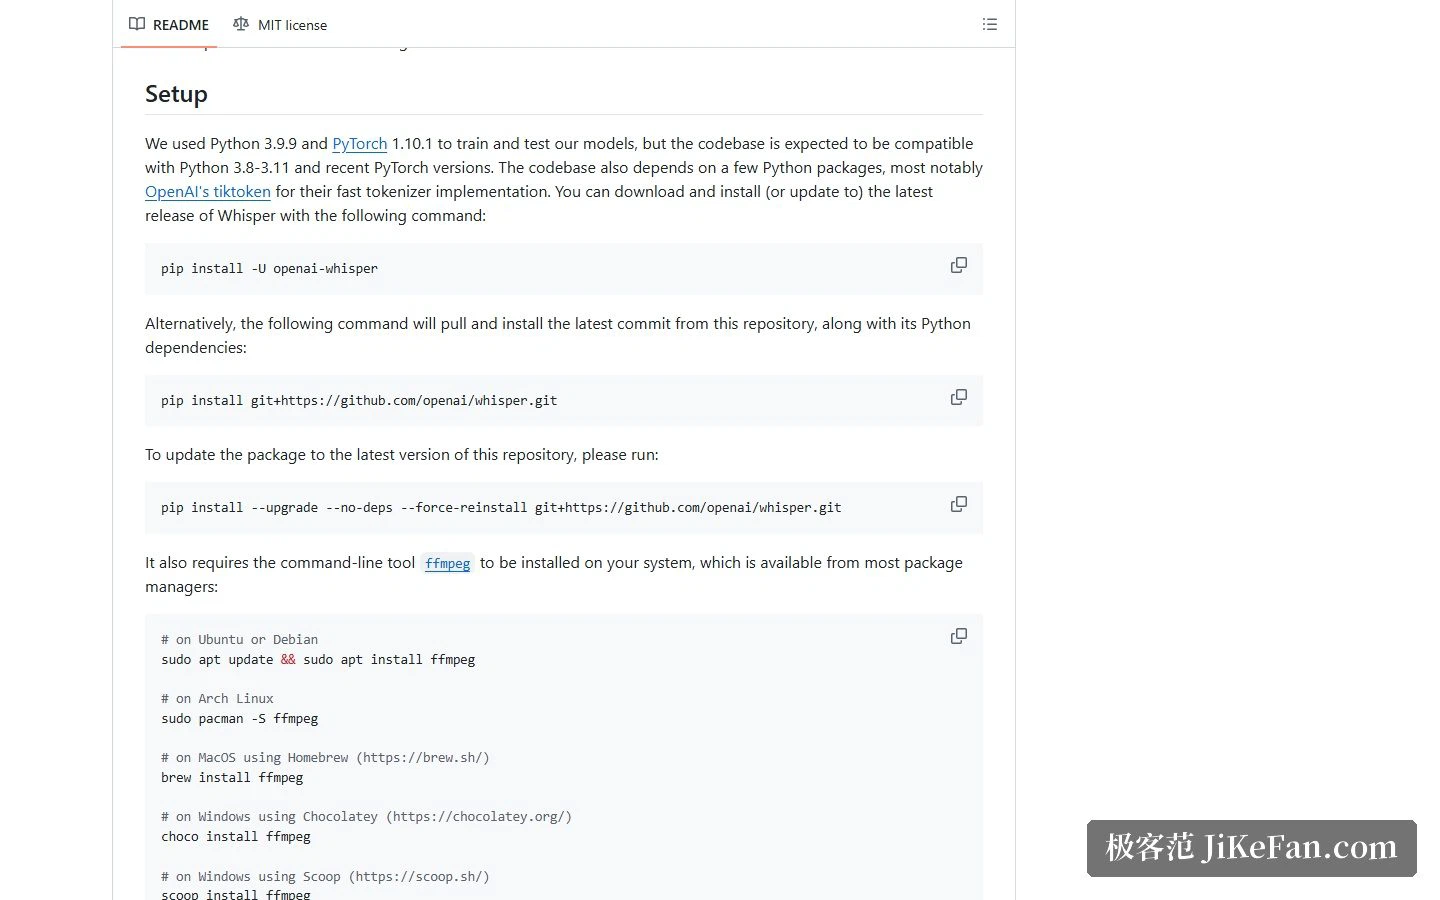
Diese Tabelle liest man am besten zuerst. Sechs Größen gibt es, von tiny mit rund 39 Millionen Parametern bis large mit rund 1,55 Milliarden, und der Speicherbedarf steigt von etwa 1 GB auf etwa 10 GB. Die Spalte mit der relativen Geschwindigkeit bezieht sich auf large: tiny liegt bei etwa dem 10-Fachen, turbo bei etwa dem 8-Fachen. Geschwindigkeit und Umfang bilden eine ziemlich glatte Abwägungskurve.
Bei knappem Speicher kommen tiny und base mit etwa 1 GB aus, was auch auf einem gewöhnlichen Notebook machbar ist. Mehr Genauigkeit heißt dann medium und large. Der turbo-Eintrag verdient einen eigenen Satz: das Projekt beschreibt ihn als optimierte Fassung von large-v3, die einen sehr kleinen Genauigkeitsverlust gegen eine deutlich schnellere Transkription tauscht, also den Kompromiss darstellt.
Vier der Größen, tiny, base, small und medium, gibt es zusätzlich als reine Englisch-Fassung. Laut Projekt schneiden diese bei rein englischen Aufgaben oft besser ab, wobei der Abstand mit steigender Parameterzahl kleiner wird.
Installation: pip plus ffmpeg
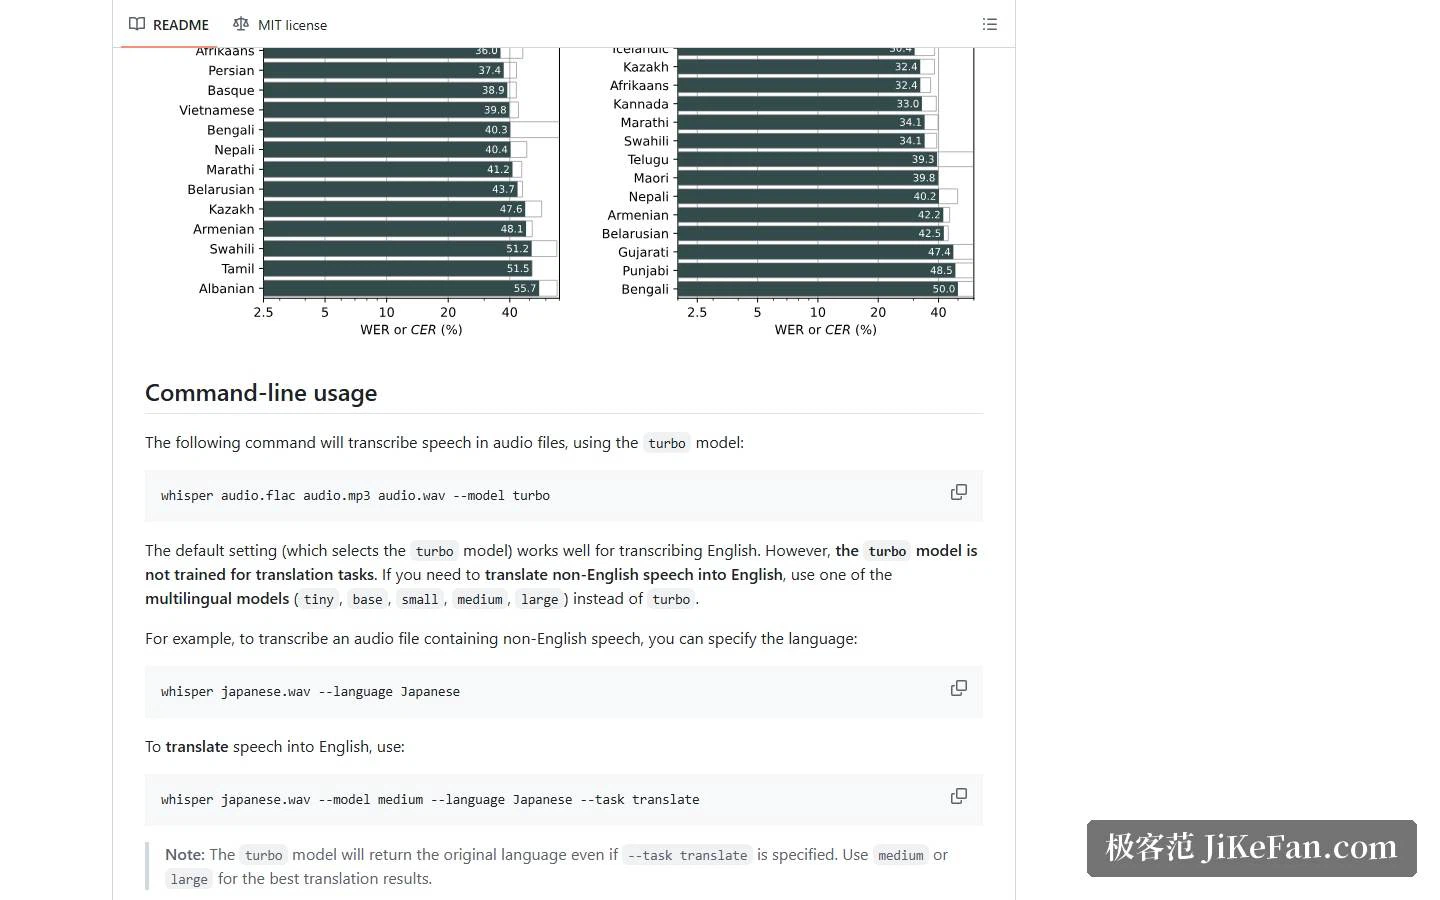
Die Installation selbst ist ein pip-Befehl. Worauf es wirklich ankommt, ist die Systemabhängigkeit: Whisper ruft das Kommandozeilenwerkzeug ffmpeg zum Dekodieren von Audio auf. Das Projekt listet Installationswege je Betriebssystem, die gängigen Paketmanager sind abgedeckt.
Noch ein Punkt. Das Projekt warnt, dass der pip-Lauf eine Rust-Umgebung braucht, wenn die Plattform kein vorgebautes Tokenizer-Paket hat; nennt die Fehlermeldung ein fehlendes Modul, löst das passende Paket das Problem. Bei den Versionen unterstützt die Codebasis Python 3.8 bis 3.11 und halbwegs aktuelle PyTorch-Versionen.
Zwei Zugänge: Shell und Python
Die Kommandozeile ist der schnellste Test. Audiodatei als Argument, die Größe über die Modelloption benannt, bei nicht-englischem Audio die Sprachoption dazu, und für Übersetzung wird die Aufgabenoption umgestellt.
Eine Grenze sollte man sich merken: das Projekt sagt klar, dass turbo nie für Übersetzung trainiert wurde. Auch mit gesetzter Übersetzungsaufgabe kommt die Originalsprache zurück. Dafür nimmt man tiny, base, small, medium oder large, und für bessere Ergebnisse empfiehlt das Projekt medium oder large.
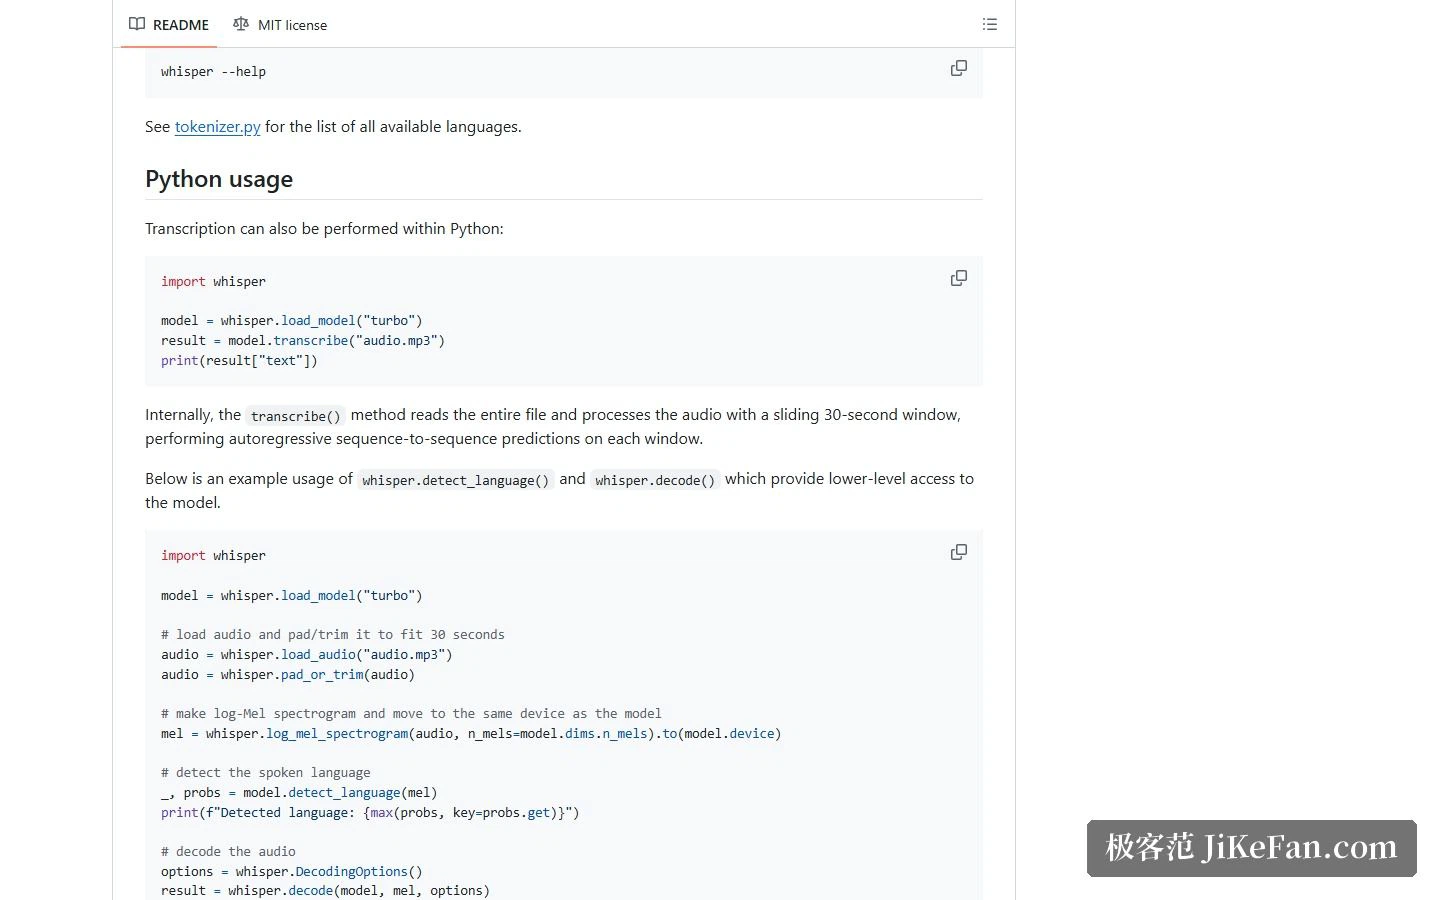
Der Python-Aufruf ist genauso kurz. Modell laden, den Audiopfad an die Transkriptionsmethode geben, das Textfeld aus dem Ergebnis lesen. Zusätzlich liegt eine tiefere Schnittstelle offen, mit der man Audio selbst lädt, das Log-Mel-Spektrogramm berechnet und Sprachbestimmung oder Decoding einzeln aufruft, wenn der Fall in eine größere Verarbeitung eingebettet werden soll.
Die Lizenz ist ein echter Vorteil
Code und Gewichte erscheinen beide unter MIT, mit sehr wenigen kommerziellen Einschränkungen. Das ist in der Spracherkennung nicht die Regel, wo viele Modelle eine eigene, strengere Vereinbarung an ihre Gewichte hängen. Wer Transkription ins eigene Produkt einbauen will, spart sich damit einiges an juristischem Hin und Her.
Für wen es passt
Wer Videos im Bündel untertiteln, Besprechungsaufnahmen in Text verwandeln oder der eigenen Anwendung eine lokale Transkription geben will, kommt günstig herein: ein Befehl zum Installieren, einer zum Starten, und sechs Größen zum Ausprobieren von unten nach oben. Mit der MIT-Lizenz kommt die Papierarbeit nicht zurück, sobald die Einbindung läuft.
Allumfassend ist es nicht. Übersetzung läuft nur in Richtung Englisch. Fälle mit Echtzeitanspruch brauchen zuerst eine Einschätzung der Hardware. Und die Genauigkeit in lauten Räumen folgt direkt der Qualität der Aufnahme. Als verlässliches Werkzeug für Offline-Transkription halten die Erwartungen.
Offener Code mit freizügiger Lizenz ist der Grund, warum so viele Projekte Whisper als Vorgabe nehmen. Das Werkzeug selbst ist keine Hürde mehr; der verbleibende Unterschied ist meist, wie sauber das Audio hineingeht.