
-
Harpa AI im Test: Video zusammenfassen, Mail beantworten, Abrechnung nach Millionen Tokens
Ein Kürzel holt mehrere Frontiermodelle auf jede Seite, und die Maschine darunter macht daraus seitenbewusste Befehle, Mailentwürfe und geplante Automation. Abgerechnet wird in Tokens, die Stufe entscheidet also, wie viel Arbeit man abgeben kann.
-
Sider im Test: eine Seitenleiste, drei Aufgaben, dazu eine Cloud-Maschine
Chat liest, was gerade offen ist, Hand läuft über mehrere Seiten und erledigt den Auftrag, Code schreibt eine Seite in Alltagssprache um. Alle drei teilen sich eine Leiste, und die teureren Stufen legen eine kleine Cloud-Maschine dazu, damit der Auftrag auch nach dem Zuklappen weiterläuft.
-
Monica im Test: ein Assistent in der Seitenleiste, die der Browser schon hat
Weder eine neue App noch ein neuer Tab wird verlangt. Der Assistent ist eine Leiste über der Seite, die man gerade liest: Text markieren, und er erklärt, übersetzt oder fasst zusammen, wobei das Modell dahinter aus einem Menü kommt. Interessant wird es bei der Abrechnung.
-
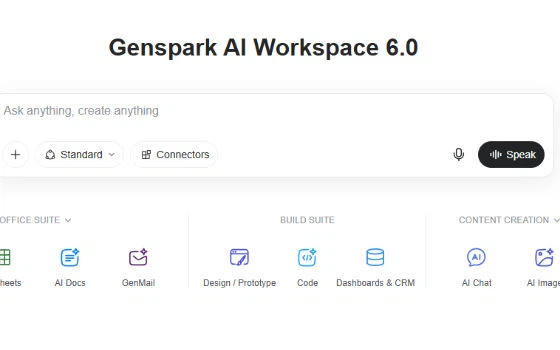
Genspark im Test: eine Werkbank für Folien, Tabellen und Mail
Ein Eingabefeld in der Mitte, ein Ring von Anwendungen drumherum, darunter vier Schichten: Gedächtnis, Agentenmotor, drei Werkzeugsuiten und eine Zusammenarbeitsebene. Die Breite ist real, die Tiefe muss man selbst prüfen.
-
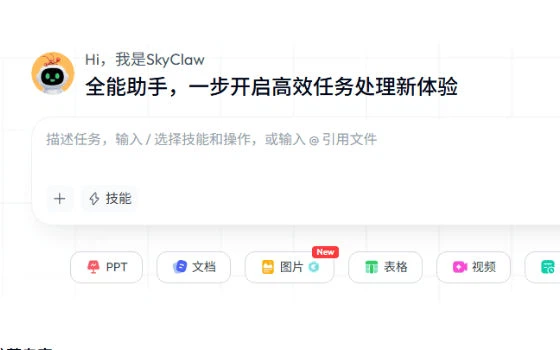
Tiangong ist aus einem Suchfeld eine Werkbank für Aufgaben geworden
Die Suche ist heute ein Eingang unter mehreren: Ein Allround-Assistent nimmt eine beschriebene Aufgabe an, wählt selbst Skills oder Experten, lässt sich zeitlich planen und in einen Chatkanal einhängen, damit die Arbeit unbeaufsichtigt läuft.
-
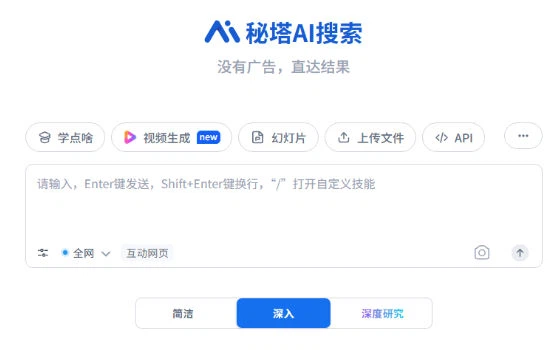
Metaso antwortet mit einer belegten Gliederung statt mit einer Linkliste
Keine Werbung, direkt zum Ergebnis: eine von drei Tiefen wählen, über Netz, Dokumentbibliothek, Wissenschaft, Bilder, Video oder Podcasts suchen, und die Antwort kommt in Abschnitte gegliedert, mit Quellenmarke an jeder Aussage.
-
NotebookLM antwortet nur aus den eigenen Quellen und macht daraus einen Podcast
PDFs, Websites, Videos oder Audio hochladen, und jede Antwort bleibt in diesem Material, mit einem Beleg im Text, der zurück zur Stelle führt. Dieselben Quellen lassen sich zu Lernleitfaden, Briefing, Mindmap oder einer Diskussion zweier Moderatoren umbauen.
-
LocalAI: Kerne nach Bedarf geholt, ein Modell auch ohne Karte
Ein Programm und ein passender Endpunkt: richtet man den Client darauf, bleibt der Code unberührt und das Modell kommt nach Hause. Kerne kommen erst, wenn ein Modell sie braucht, jede Fähigkeit hat einen Weg über den Prozessor.
-
vLLM: Modelle bedienen, indem man Grafikspeicher wie Speicher verwaltet
Die Ablage der Schlüssel und Werte in Blöcke zu schneiden statt sie ganz zu reservieren hebt die Speichernutzung von drei oder vier Zehnteln auf über neun - dieselbe Karte bedient dann zwei- bis viermal so viele Anfragen.
-
Msty: lokale und gehostete Modelle in einem einzigen Fenster
Zwei Rechenkerne in einem Fenster bringen ein offenes Modell mit einem Klick zum Laufen, mehr als 12 gehostete Anbieter lassen sich mit eigenem Schlüssel anbinden, und ein Gespräch darf mittendrin das Modell wechseln - oder sich in mehrere Scheiben teilen.
-
AnythingLLM: eine private Werkbank, die auf dem Schreibtisch bleibt
Zieht man PDFs, Textverarbeitung und Tabellen in einen Arbeitsbereich, steht ein Assistent bereit, der alles gelesen hat, was man besitzt - mit Beleg unter jeder Antwort, und Modell, Vektorspeicher und Ablage bleiben ab Werk auf der Maschine.
-
llama.cpp: die Maschine, die ein Modell allein auf dem Prozessor trägt
In schlichtem C ohne Abhängigkeiten geschrieben, hat es das Dateiformat gesetzt, mit dem quantisierte Modelle klein genug für gewöhnliche Notebooks wurden - und es ist die Schicht, auf der mehrere bekannte Fensterprogramme still aufsetzen.
-
GPT4All: ein lokales Modell auch ohne Grafikkarte
Keine eigene Karte, kein Konto, keine Befehlszeile: ein quantisiertes offenes Modell läuft auf einem gewöhnlichen Prozessor, und ein Ordner mit eigenen Unterlagen wird zu einer Sammlung, die man befragen kann, ohne dass etwas das Gerät verlässt.
-
Jan: ein lokaler Assistent mit lesbarem Quelltext
Gesprächsfenster, Modellverwaltung und lokaler Dienst stehen Zeile für Zeile unter einer großzügigen offenen Lizenz, sodass das Gespräch auch mit gezogenem Kabel weiterläuft und niemand das Versprechen zur Privatheit glauben muss.
-
LM Studio: lokale Modelle so bequem wie ein gehosteter Assistent
Kein Terminal, keine Parameter zum Vertippen: ein Fenster listet Modelle nach Größe und danach, ob sie auf die Karte passen, ein Klick lädt sie, und das Gesprächsfeld verhält sich wie bei gehosteten Assistenten, ohne dass Daten das Gerät verlassen.
-
第 1 / 3 页