
CosyVoice deckt 9 Sprachen und 18 chinesische Dialekte ab, dazu Zero-Shot-Klonen
Zusammenfassung
Ein quelloffenes Sprachsynthesemodell, dessen neueste Generation sprachübergreifendes Zero-Shot-Klonen beherrscht, 9 Fremdsprachen und über zehn chinesische Dialekte und Akzente abdeckt und unter der Apache-2.0-Lizenz steht.
Empfehlen- Name
- CosyVoice
- Version
- 3
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinuxmacOS
- Aktualisiert
- 2026-10-06 19:49
Die meisten offenen Sprachmodelle verkaufen dieselbe Idee: Wie menschlich klingt es. CosyVoice setzt einen anderen Akzent und stellt die Abdeckung nach vorn – 9 Sprachen, 18 chinesische Dialekte und Akzente, dazu sprachübergreifendes Zero-Shot-Klonen. Das Repositor beschreibt sich schlicht als mehrsprachiges großes Sprachgenerierungsmodell mit einem vollständigen Stapel aus Inferenz, Training und Auslieferung.
Der Code steht unter der Apache-2.0-Lizenz, und die aktuelle Generation heißt Fun-CosyVoice 3.0. Offiziell ist es ein Sprachsynthesessystem auf Basis eines großen Sprachmodells, das gegenüber CosyVoice 2.0 in drei Punkten zulegt: inhaltliche Konsistenz, Sprecherähnlichkeit und prosodische Natürlichkeit.
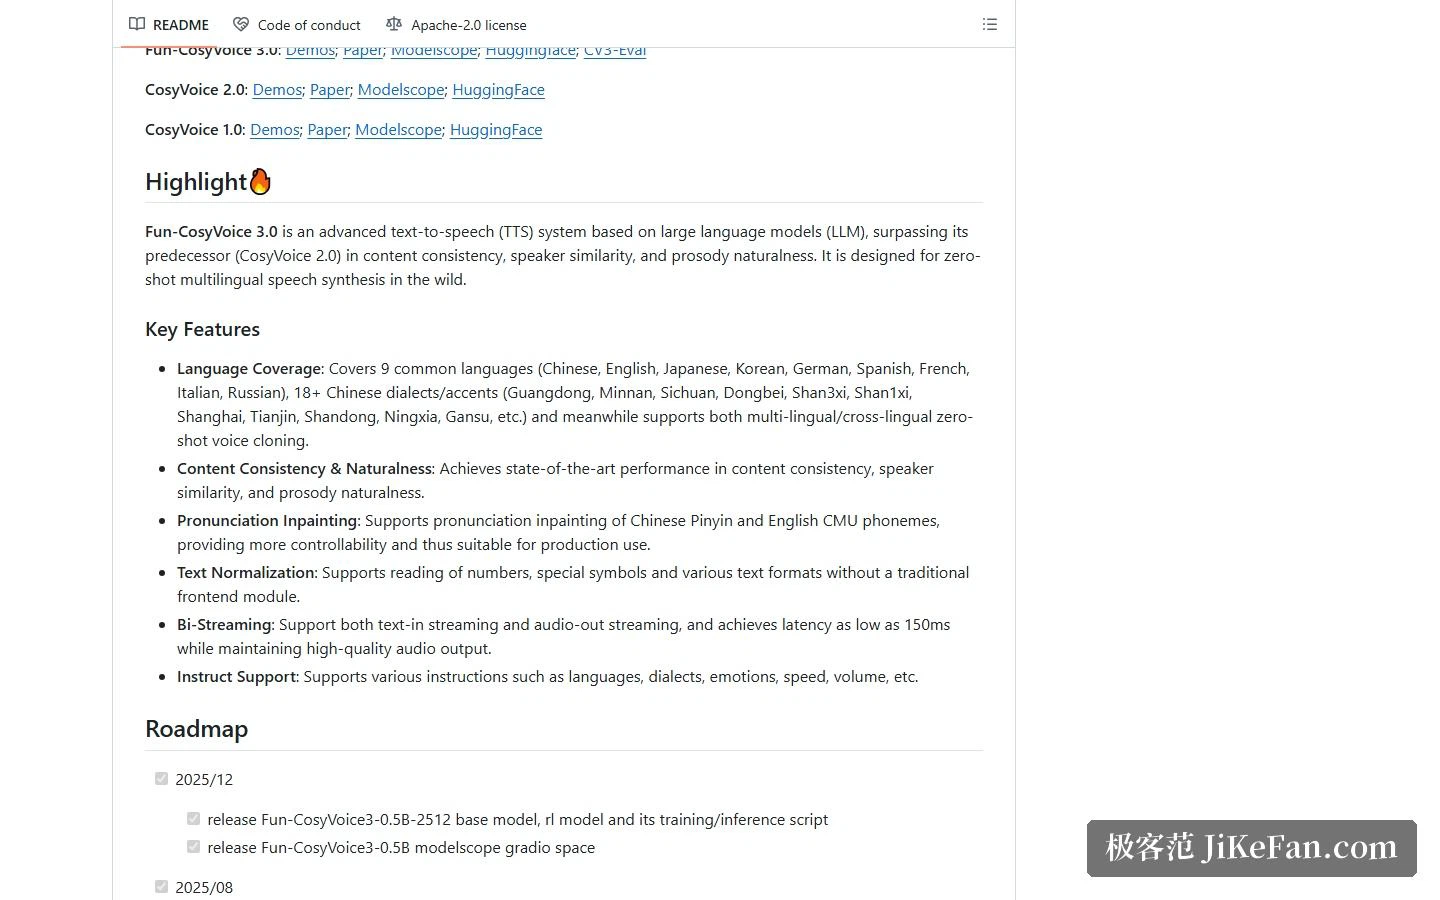
Zuerst die Abdeckung: 9 Sprachen, 18 chinesische Dialekte
Die neun genannten Sprachen sind Chinesisch, Englisch, Japanisch, Koreanisch, Deutsch, Spanisch, Französisch, Italienisch und Russisch. Wer im Chinesischen arbeitet, schaut eher auf die Dialektzeile: mehr als 18 chinesische Dialekte und Akzente, wobei die offiziellen Beispiele Guangdong, Minnan, Sichuan, den Nordosten, Shaanxi, Shanxi, Shanghai, Tianjin, Shandong, Ningxia und Gansu nennen.
Schwierig am Dialekt ist nicht, ob ein Modell die Wörter aussprechen kann. Schwierig sind die knappen Korpora und ein Lautsystem, das deutlich vom Standardmandarin abweicht. Dialekte als Kernmerkmal zu führen, spricht dafür, dass die Investition in chinesisches Material gewollt war und nicht nebenbei entstand.
Zero-Shot-Klonen und Tonführung per Instruktion
Zum Klonen packt die offizielle Beschreibung mehrsprachig und sprachübergreifend in denselben Satz: Eine in einer Sprache aufgenommene Probe kann die Synthese in einer anderen Sprache treiben, ohne neuen Datensatz je Sprache.
Die zweite praktische Funktion ist die Instruktionssteuerung: Sprache, Dialekt, Emotion, Tempo und Lautstärke lassen sich vorab angeben. Für alle, die gesprochene Inhalte produzieren, ist das weit kontrollierbarer, als so lange neu zu erzeugen, bis etwas passt. Auch die Aussprachekorrektur ist separat aufgeführt, mit Eingriff über chinesisches Pinyin und englische CMU-Phoneme, sodass ein mehrdeutiges Schriftzeichen oder ein fremder Eigenname von Hand zu richten ist.
Streaming-Inferenz: Latenz bis hinunter zu etwa 150 Millisekunden
Die Merkmalsliste verspricht bidirektionales Streaming – Text hinein, Audio hinaus – mit einer Latenz von nur 150 Millisekunden bei gleichbleibender Audioqualität. Diese Zahl entscheidet über Echtzeitgespräche. Wenn die Synthese in einen Support-Bot oder einen Sprachassistenten soll, ist die Latenz die Linie zwischen brauchbar und unbrauchbar.
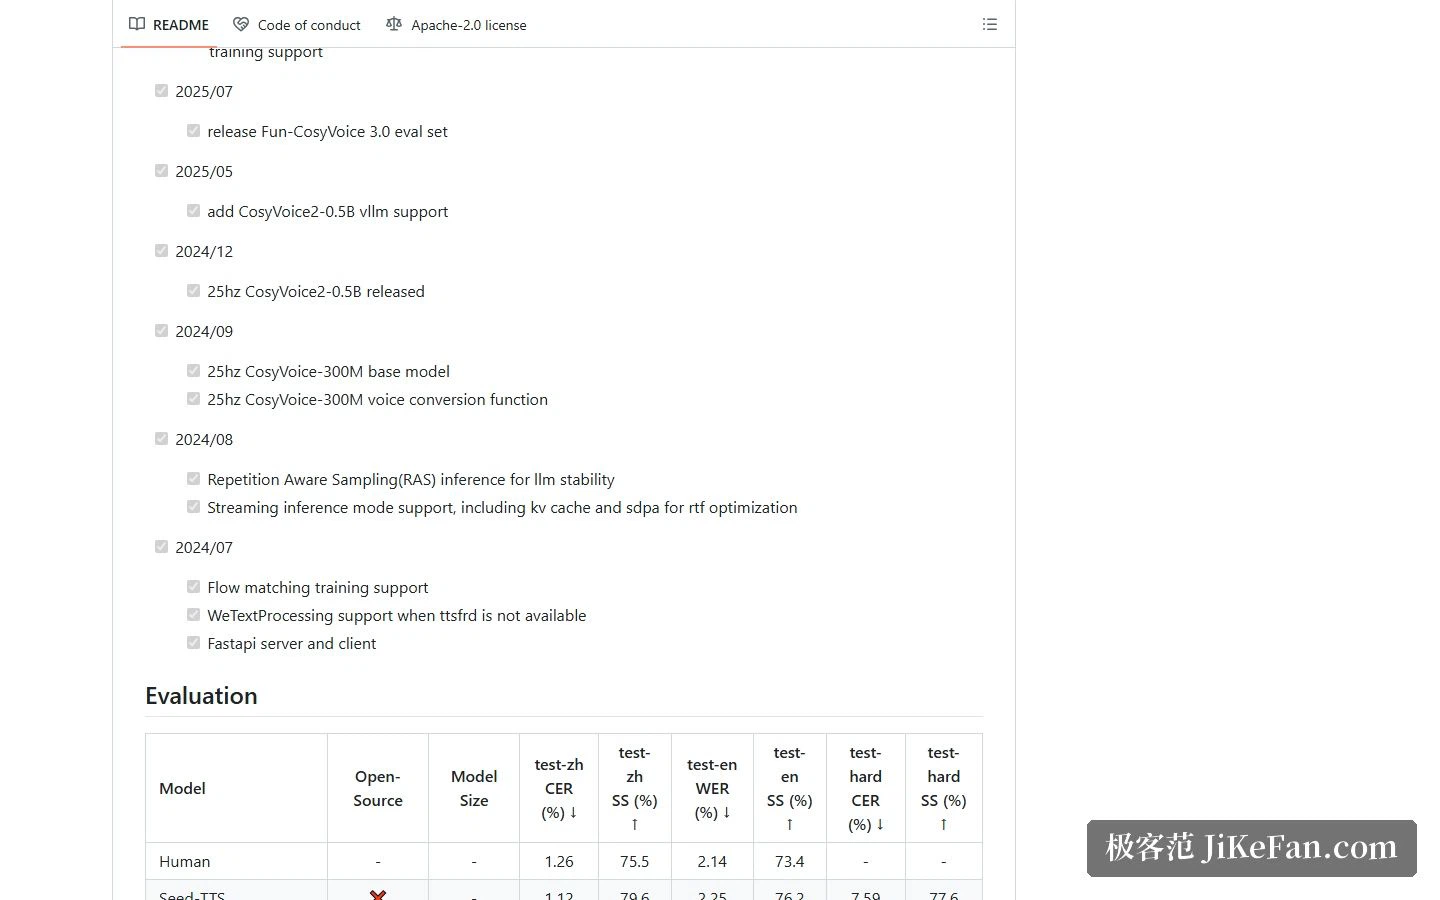
Welche Version, welches Modell
Bisher gibt es drei Generationen: CosyVoice 1.0, CosyVoice 2.0 und Fun-CosyVoice 3.0, jeweils mit einem Papier und einem Modelleintrag. Herunterladbar ist mehr als ein Prüfpunkt: CosyVoice-300M mit rund dreihundert Millionen Parametern, daneben die feinabgestimmte Variante 300M-SFT und die Instruktionsvariante 300M-Instruct, darüber CosyVoice2-0.5B und das neueste Fun-CosyVoice3-0.5B.
Die Dokumentation empfiehlt ausdrücklich Fun-CosyVoice3-0.5B, begründet mit der besseren Leistung. Wenn die Arbeit auf Instruktionssteuerung liegt, nimmt man einen Bau mit Instruct im Namen; geht es nur darum, die Kette zum Laufen zu bringen, ist die Dreihundert-Millionen-Fassung kleiner und belastet den Speicher deutlich weniger.
Installation: eine Conda-Umgebung und ein Modelldownload
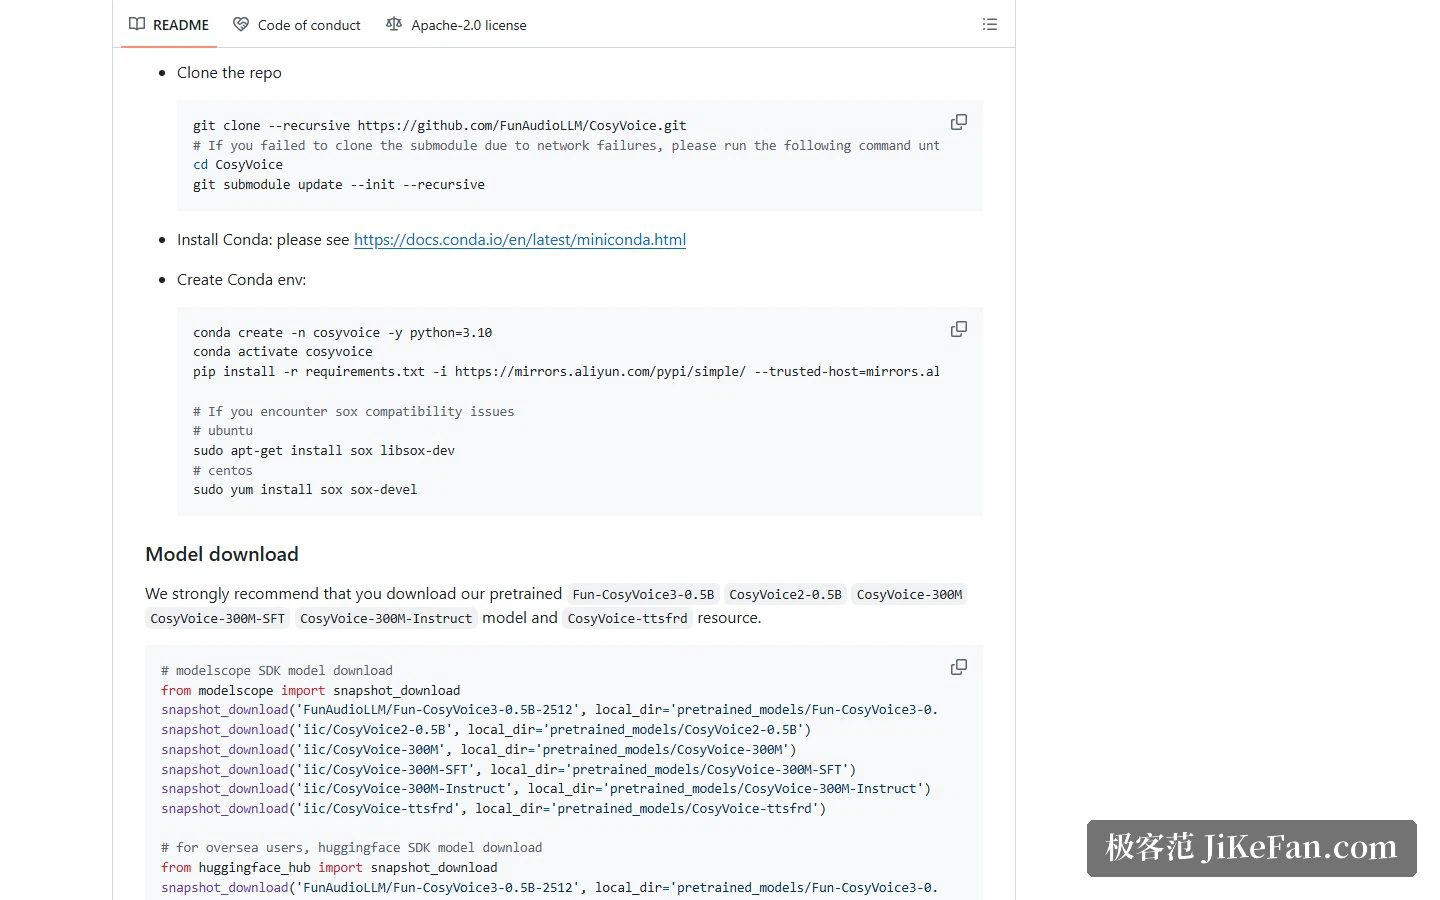
Der offizielle Weg: Repositor samt Untermodulen klonen, mit Conda eine Python-3.10-Umgebung bauen, Abhängigkeiten installieren, dann das passende vortrainierte Modell ziehen. Prüfpunkte kommen von ModelScope oder HuggingFace, wobei Nutzer in China mit dem ersten reibungsloser fahren.
Ein Detail lohnt den Blick. Die Textnormalisierung läuft standardmäßig über wetext; wer zusätzlich das ttsfrd-Ressourcenpaket entpackt und installiert, bekommt Zahlen und Symbole besser vorgelesen. Die Dokumentation stellt klar, dass dieser Schritt optional ist und übersprungen werden kann.
Zum Laufen bringen, und wenn es schneller sein muss
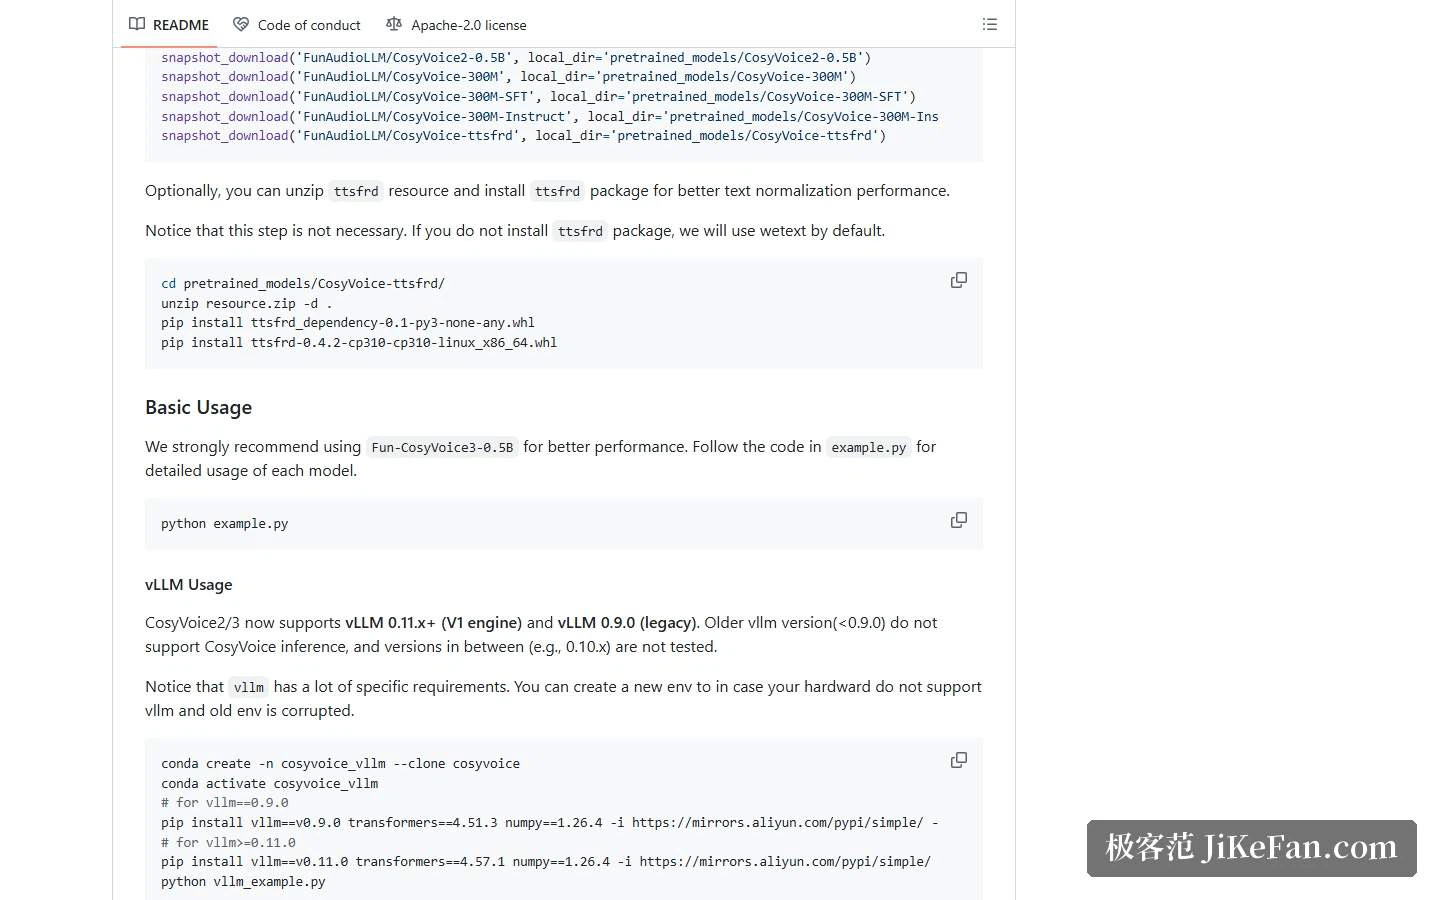
Am schnellsten prüft man es mit den offiziellen Beispielskripten oder startet die Web-Demo, gibt Modellverzeichnis und Port an und hört im Browser zu. Wird Durchsatz oder Latenz zum Engpass, unterstützen CosyVoice 2 und 3 die Beschleunigung über vLLM, mit einem Versionsvorbehalt: Die Dokumentation unterstützt die neuere Engine ab 0.11 und die ältere 0.9.0, Fassungen unter 0.9.0 können gar nicht inferieren, und alles dazwischen ist nicht geprüft.
Für wen es passt
Wenn der Bedarf im Chinesischen liegt – besonders Dialekte, steuerbarer Ton und Aussprachekorrekturen –, passt diese Kombination besser als ein allgemeines, englischfirstiges TTS. Dazu offener Code und lokaler Betrieb, und es eignet sich auch für alle, deren Daten das interne Netz nicht verlassen dürfen.
Zwei Dinge bleiben vorab zu klären. Erstens die Lizenz der Modellgewichte: Der Code im Repositor ist Apache 2.0, doch bevor erzeugtes Audio kommerziell genutzt wird, sollte man die Freigabebedingungen der Gewichte selbst nachlesen. Zweitens die Rechtmäßigkeit. Inhalte mit fremder Stimme zu produzieren, erst recht mit der einer Person des öffentlichen Lebens, berührt Persönlichkeits- und Stimmrechte, und die Herkunft dieser Rechte gehört auf Papier statt in eine Annahme.
Offene Sprachmodelle haben in zwei Jahren große Sprünge gemacht, und die Liste der Sprachen und Dialekte füllt sich weiter. Die technischen Möglichkeiten sind gewachsen; geblieben ist eine Frage an den, der das Werkzeug hält – wessen Stimme die Maschine nutzen soll, und was sie sagen soll.