
WhisperX legt Wort-Zeitstempel und Sprecherlabels über Whisper
Zusammenfassung
Ein Ablauf, der zwei Lücken von Whisper schließt: Zeitstempel enden auf Satzebene, und eine Stapelverarbeitung fehlt. WhisperX richtet zwangsweise aus, um Wortzeiten zu gewinnen, labelt Sprecher und nennt 70-fache Echtzeit auf large-v2.
Empfehlen- Name
- WhisperX
- Version
- 3.8.7
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinuxmacOS
- Webseite
- https://github.com/m-bain/whisperX
- Aktualisiert
- 2026-10-06 19:53
Zwei Dinge, die Whisper auslässt
WhisperX existiert wegen einer sehr konkreten Beschwerde. Whisper transkribiert genau, aber seine Zeitstempel enden auf Satzebene. Wer Untertitel baut, merkt schnell, dass Text und Bild auseinanderlaufen, ein paar Sekunden Versatz sind der Normalfall. Und eine Stapelverarbeitung bringt Whisper selbst nicht mit.
Die Reparatur besteht aus zwei zusätzlichen Stufen. Zuerst wird das Transkript zwangsweise am Audio ausgerichtet, was die Zeitstempel bis auf einzelne Wörter herunterzieht. Dann wird das Audio nach Sprecher getrennt, und jede Zeile bekommt eine Marke, wer sie gesagt hat. Das Projekt fasst das zu einem Ablauf zusammen und bietet dafür eine Kommandozeile und eine Python-Schnittstelle.
Ein Ablauf in vier Stufen
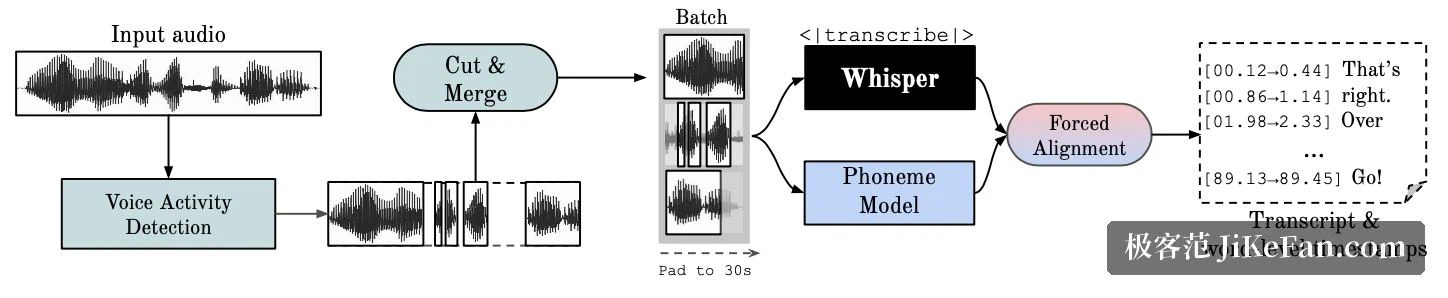
Das Diagramm im Repo teilt den Lauf in vier Schritte. Zuerst kommt die Erkennung von Sprachaktivität, die stille Strecken herausfiltert. Dann erzeugt das Transkriptionsmodell den Text im Stapel. Ein Modell zur Erkennung auf Phonemebene führt die erzwungene Ausrichtung durch und liefert Zeitstempel pro Wort. Zuletzt trennt ein Modell für Sprechertrennung die Stimmen.
Die Eckdaten stehen in der Projektbeschreibung. Stapel-Inferenz auf dem Modell large-v2 erreicht das 70-Fache der Echtzeit. Der Transkriptions-Backend ist faster-whisper, und large-v2 braucht bei einer Beam-Größe von 5 weniger als 8 GB Grafikspeicher. Die Wort-Zeitstempel kommen aus der erzwungenen Ausrichtung mit wav2vec2. Die Sprechertrennung kommt von pyannote-audio und gibt Sprecherkennungen aus. Das Paper hinter dem Ablauf erschien auf der INTERSPEECH 2023, zum Thema zeitgenauer Transkription langer Audiodateien.
Die vorgeschaltete Sprachaktivität hat einen erwähnenswerten Nebeneffekt. Laut Projekt senkt sie Halluzinationen, ohne Erkennungsgenauigkeit zu verlieren, und sie macht die Stapelverarbeitung leichter, was eine der Voraussetzungen für die erreichte Geschwindigkeit ist.
Installation: eine pip-Zeile
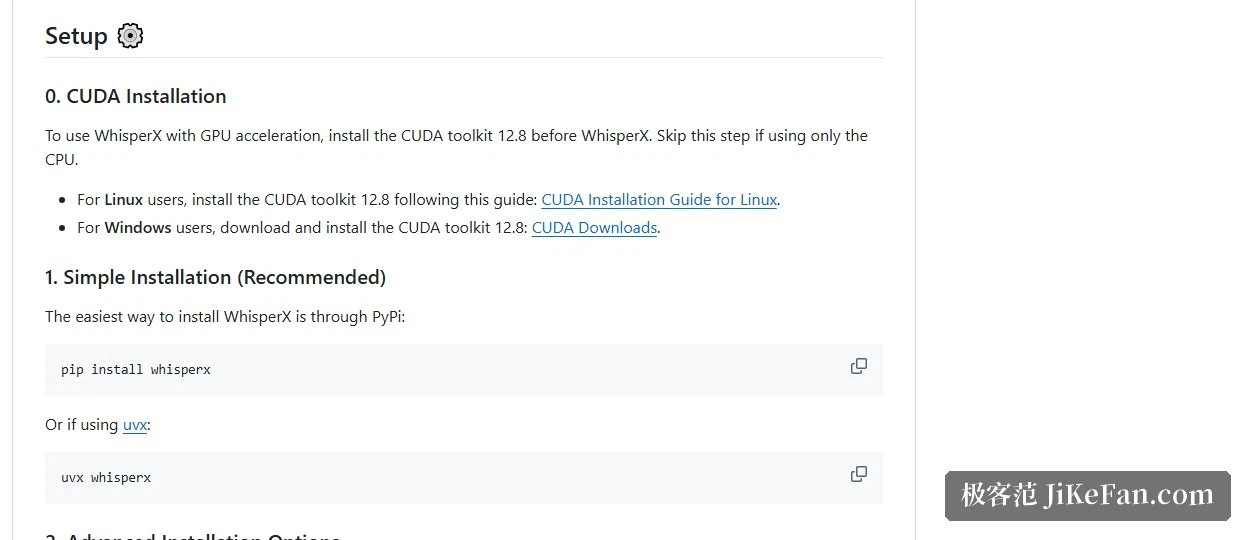
Die empfohlene Installation ist kurz: ein pip-Befehl. Auf einer Maschine, die uv schon hat, lässt sich das Werkzeug per uvx starten, ohne es vorher in eine Umgebung zu installieren. GPU-Beschleunigung setzt CUDA 12.8 voraus. Wer nur die CPU nutzt, überspringt diesen Schritt.
Die Sprechertrennung verlangt mehr. Ein Zugangstoken von Hugging Face muss auf der Kommandozeile mitgegeben werden, und die Nutzungsbedingungen sind vorher auf der Modellseite zu akzeptieren. Transkription und Ausrichtung laufen ohne Netz; bei der Trennung kommen Modell-Download und Freigabe ins Spiel.
Die Kommandozeile in der Praxis
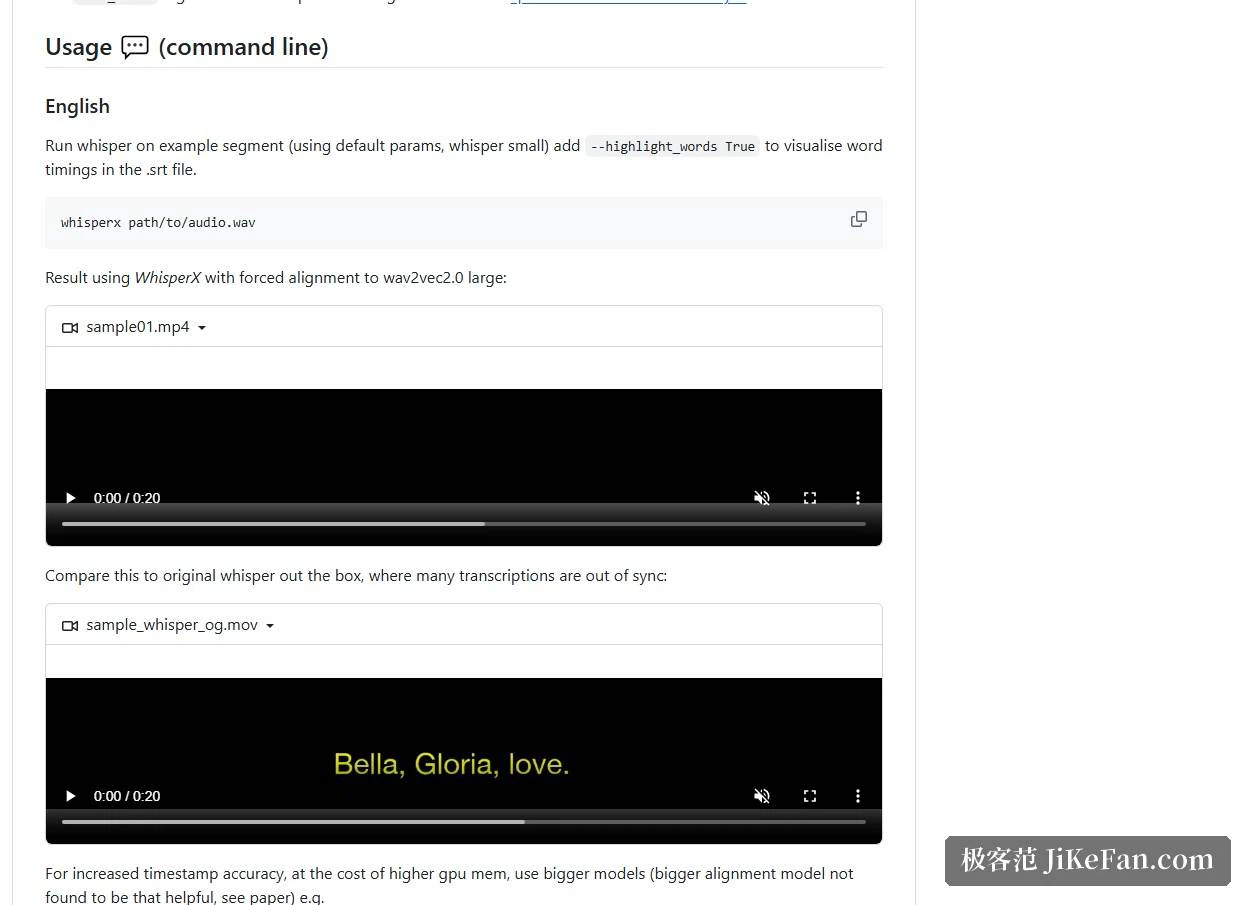
Der einfache Aufruf nimmt einen Audiopfad und läuft mit einem kleineren Modell und Voreinstellungen. Genauere Zeitstempel bedeuten ein größeres Modell plus ein ausdrücklich genanntes Ausrichtungsmodell, bezahlt mit Grafikspeicher. Audio mit mehreren Sprechern nimmt den Schalter für die Trennung, und die Hervorhebung pro Wort lässt sich einschalten, damit sich jeder Zeitpunkt einzeln prüfen lässt.
Eine Grafikkarte ist nicht nötig. Zwei Schalter verlegen die Arbeit auf die CPU, was laut Projekt auch den Lauf auf einem Mac abdeckt. Ein Vorbehalt: das Phonemmodell für die Wortausrichtung wird je Sprache bereitgestellt. Englisch, Französisch, Deutsch, Spanisch und Italienisch haben fertige Vorgaben, für andere Sprachen muss ein passendes Modell gefunden und geprüft werden.
faster-whisper für sich allein
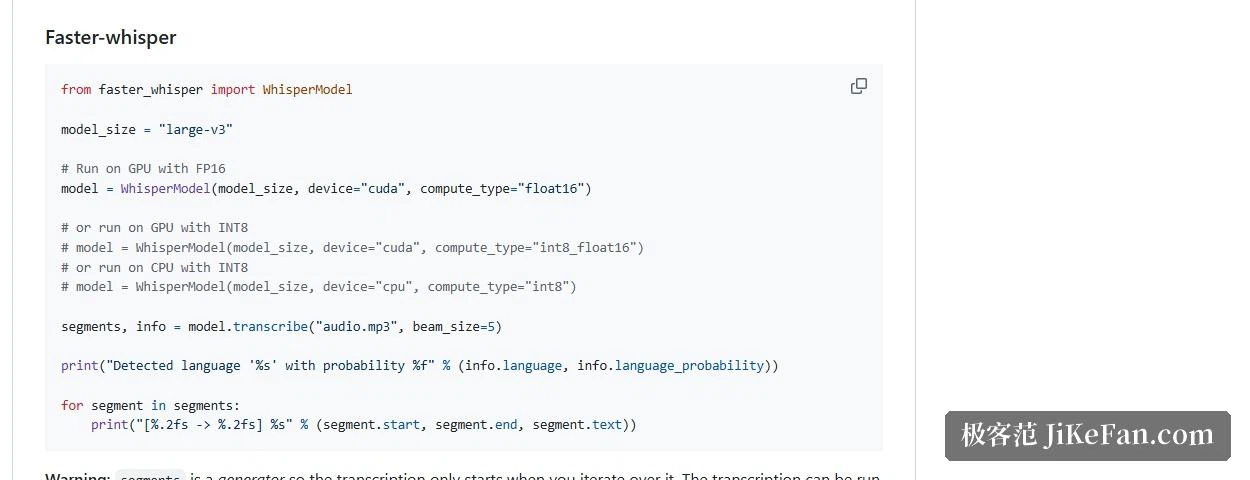
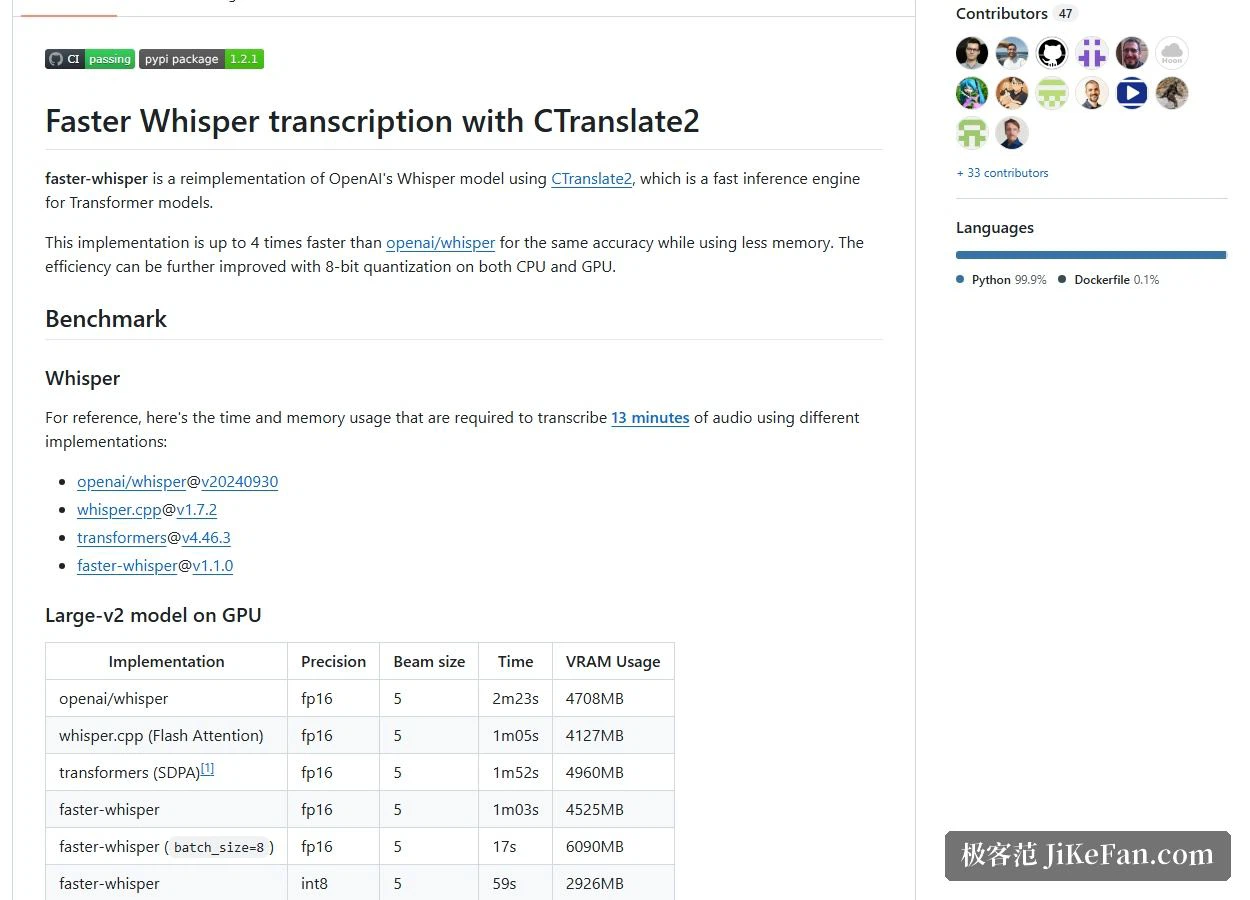
Die Transkriptionsstufe gehört faster-whisper, einer eigenständigen Open-Source-Umsetzung, die Whisper auf der Inferenz-Engine CTranslate2 neu geschrieben hat. Das Projekt beschreibt sie als bis zu 4 Mal schneller als das Original bei gleicher Genauigkeit, mit geringerem Speicherbedarf, und 8-Bit-Quantisierung auf CPU wie GPU legt noch eine Stufe drauf.
Wer nur transkribieren will, ohne Wortausrichtung und Sprechertrennung, fährt damit leichter. Die Installation ist wieder ein pip-Befehl, und bei Systemabhängigkeiten ist es umgänglicher: anders als das Original verlangt es kein FFmpeg im System, weil die Audiodekodierung über PyAV läuft, das die FFmpeg-Bibliotheken im eigenen Paket mitbringt. Verlangt wird Python 3.9 oder neuer.
Die veröffentlichten Messwerte
Es gibt einen reproduzierbaren Vergleich: 13 Minuten Audio, eine RTX 3070 Ti mit 8 GB, das Modell large-v2, fp16, Beam-Größe 5.
Das Original brauchte 2 Minuten 23 Sekunden bei 4708 MB. whisper.cpp mit Flash Attention kam auf 1:05 bei 4127 MB. Einfaches faster-whisper lag bei 1:03 und 4525 MB. Mit Stapelgröße 8 kam faster-whisper auf 17 Sekunden bei 6090 MB. In int8 waren es 59 Sekunden bei 2926 MB, und int8 mit Stapelgröße 8 schaffte 16 Sekunden bei 4500 MB.
Die Zeile, die man ansehen sollte, ist die mit dem Stapel. Bei gleicher fp16-Genauigkeit braucht der Lauf Stück für Stück 1:03, im Stapel nur 17 Sekunden. Ist der Speicher knapp, drückt int8 den Bedarf auf 2926 MB. Auch für die CPU gibt es Zahlen: ein kleines Modell auf einem Desktop-Prozessor mit acht Threads braucht im Original 6 Minuten 58 Sekunden, gegenüber 51 Sekunden für faster-whisper mit int8-Stapel.
Das Projekt mahnt außerdem an, beim Vergleich die Parameter gleichzuhalten: dieselbe Beam-Größe, vergleichbare Genauigkeit, dieselbe Threadzahl auf der CPU. Sonst sind die Zahlen nicht vergleichbar. Das Original steht nämlich auf Beam-Größe 1, faster-whisper auf 5.
Aufruf aus Python
Im eigenen Skript sind es wenige Zeilen: Modellgröße, Gerät und Rechengenauigkeit nennen, dann transcribe aufrufen. Ein Detail sollte man behalten: das Ergebnis ist ein Generator. Die eigentliche Berechnung passiert erst beim Durchlaufen, also in eine Liste wandeln oder in einer Schleife abholen, sonst sieht es aus, als wäre nichts gelaufen. Stapelverarbeitung ist eine eigene Schnittstelle: Modell einwickeln und eine Stapelgröße angeben. Wort-Zeitstempel kommen über einen Schalter, danach treffen Start und Ende Wort für Wort ein. Zum Filtern langer Stille den VAD-Filter einschalten; voreingestellt fliegt alles über 2 Sekunden heraus, und diese Schwelle lässt sich ändern.
Grenzen, die man vorher kennen sollte
Die Wortausrichtung ist nicht allumfassend. Das Projekt nennt die Fälle klar. Abgekürzte Jahreszahlen und Beträge mit Währungssymbol lassen sich nicht verorten, sie bekommen also keinen Zeitstempel. Überlappende Sprache behandeln Whisper und WhisperX beide schlecht. Die Sprechertrennung selbst ist weit von perfekt entfernt. Und Ausrichtungsmodelle gibt es je Sprache, ein Sprachwechsel bedeutet also ein Modellwechsel.
BSD und MIT
WhisperX ist Open Source unter BSD, faster-whisper unter MIT, und beide legen eine Lizenzdatei ins Wurzelverzeichnis. Freizügige Bedingungen heißen, dass die Einbindung in einen Untertitelablauf oder ein Weiterbauen kaum auf Genehmigungshürden trifft.
Für wen es passt
Wenn das Ziel ist, langes Audio in direkt nutzbare Untertiteldateien zu verwandeln, liegt der Wert in genau diesem Ablauf: Zeitstempel bis aufs Wort, getrennte Sprecher bei Material mit mehreren Personen, und sowohl Kommandozeile als auch Python-Schnittstelle, um in einen bestehenden Prozess zu passen. Bei 70-Facher Echtzeit auf large-v2 spürt Material im Stundenbereich den Unterschied deutlich.
Es will keine Desktop-Anwendung sein, die man installiert und vergisst. Die Umgebung richtet man selbst ein, Modelle und Sprachen wählt man selbst, und für die meisten ist die eigentliche Hürde nicht der Befehl, sondern die Abwägung zwischen Karte und Modellgröße. Wer nur Wörter aus einer Aufnahme herausholen will und keine Wort-Zeitstempel braucht, ist mit faster-whisper allein entspannter dran.