
六種尺寸、一條取捨曲線:Whisper 該按顯示記憶體挑哪一級
摘要
一條指令裝好就能跑的離線轉寫工具。同一個模型包辦多語轉寫、翻成英文與語種判斷,官方給出六個尺寸,從約 3900 萬參數一路到約 15.5 億,程式碼與權重皆為 MIT。
- 軟體名稱
- Whisper
- 版本
- 15.5
- 收費
- 免費
- 開源
- 開源
- 作業系統
- WindowsLinuxmacOS
- 更新時間
- 2026-10-06 16:03
一個模型取代一整條流程
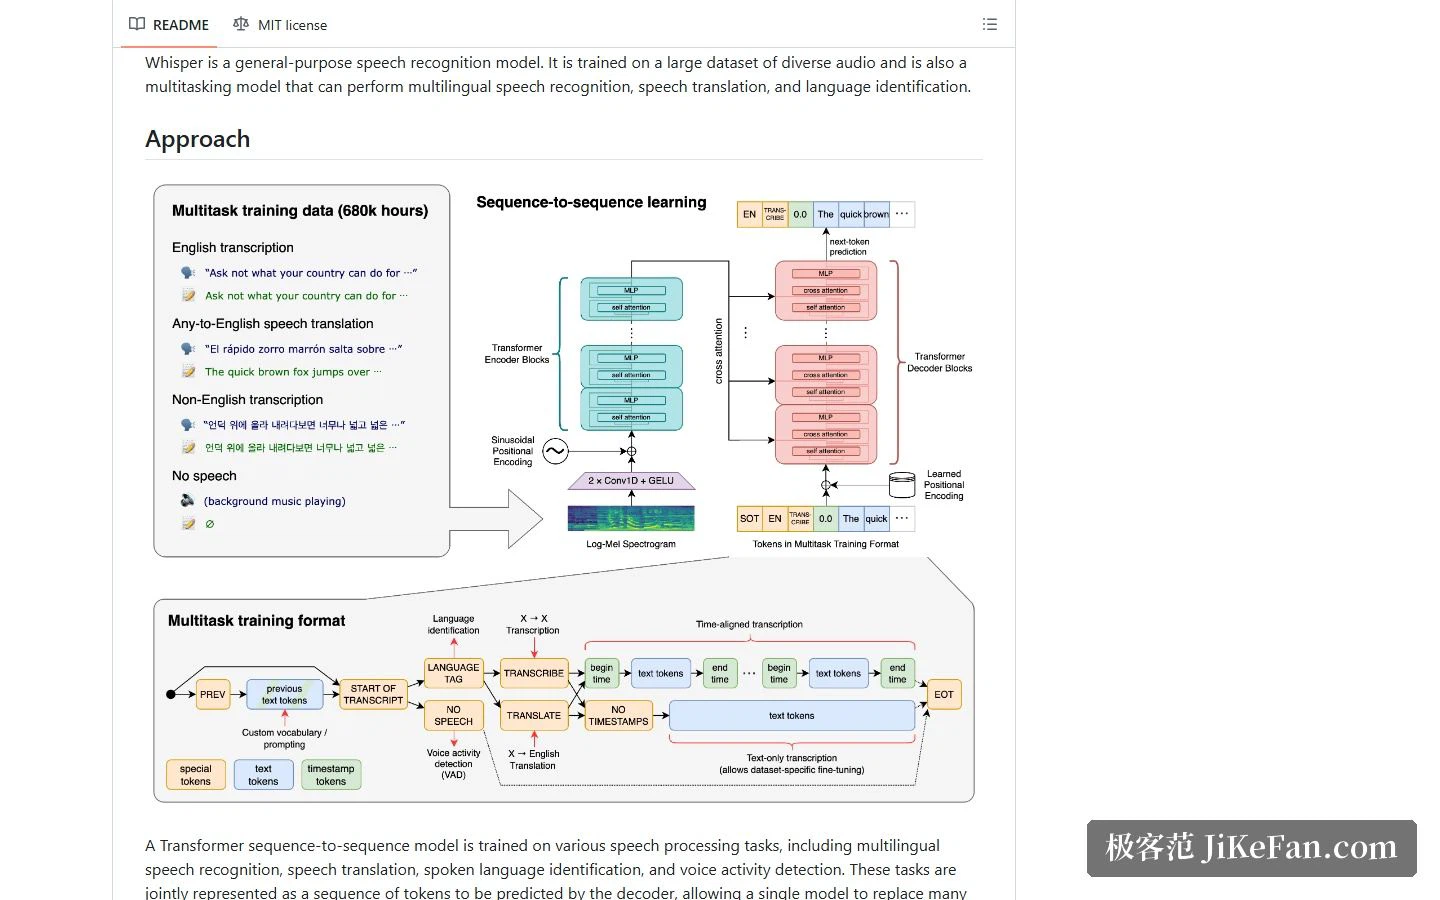
Whisper 屬於那種用單一模型換掉整條流程的專案。傳統的語音處理要分好幾段走:先判斷語種,再辨識,需要翻譯時另外接一個翻譯模型,語音活動偵測往往又是獨立的一環。Whisper 把這些任務收攏成解碼器要預測的標記序列,在同一個 Transformer 編碼解碼結構裡一起學出來。
官方在專案裡標出的多任務訓練資料規模是 68 萬小時,素材涵蓋多種語言與各種錄音條件。定位寫得很直白:通用的語音辨識模型。
四項能力,翻譯只有一個方向
官方把能力列成四項:多語語音辨識、語音翻譯、口語語種辨識、語音活動偵測。這裡的翻譯指的是把非英語語音直接轉成英文文字,不是任意兩個語種互譯。動手規劃流程之前,這個區別要先弄清楚。
長錄音交給 30 秒的視窗
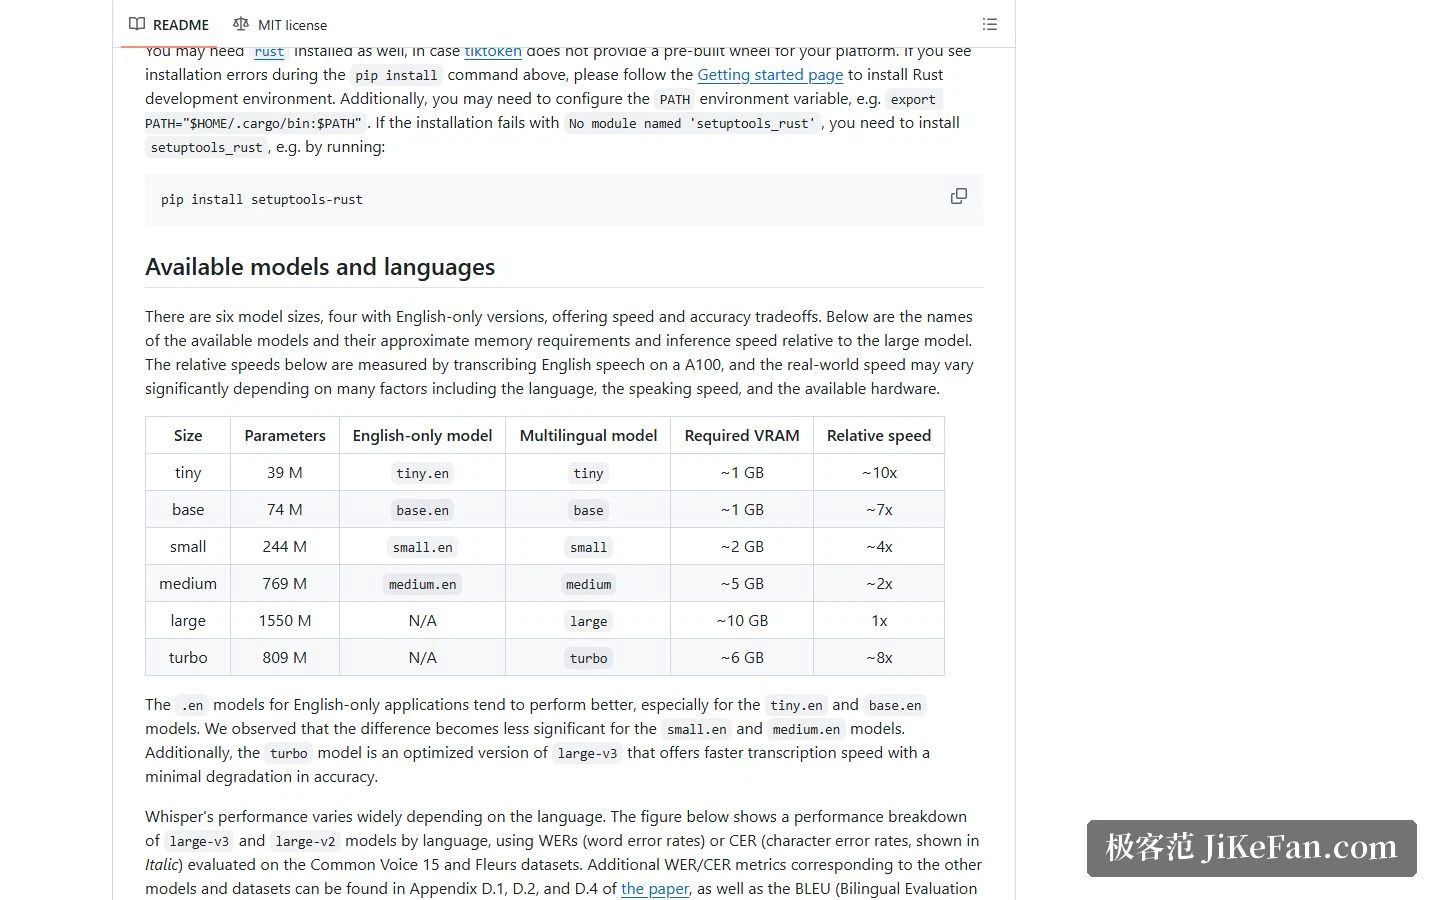
長音訊靠滑動視窗處理。說明指出轉寫方法會把整個檔案讀進來,然後以 30 秒為一個視窗逐段做自迴歸預測。換句話說,一小時的錄音會切成一百多個視窗連續處理,不需要自己先切片。
六個尺寸怎麼挑
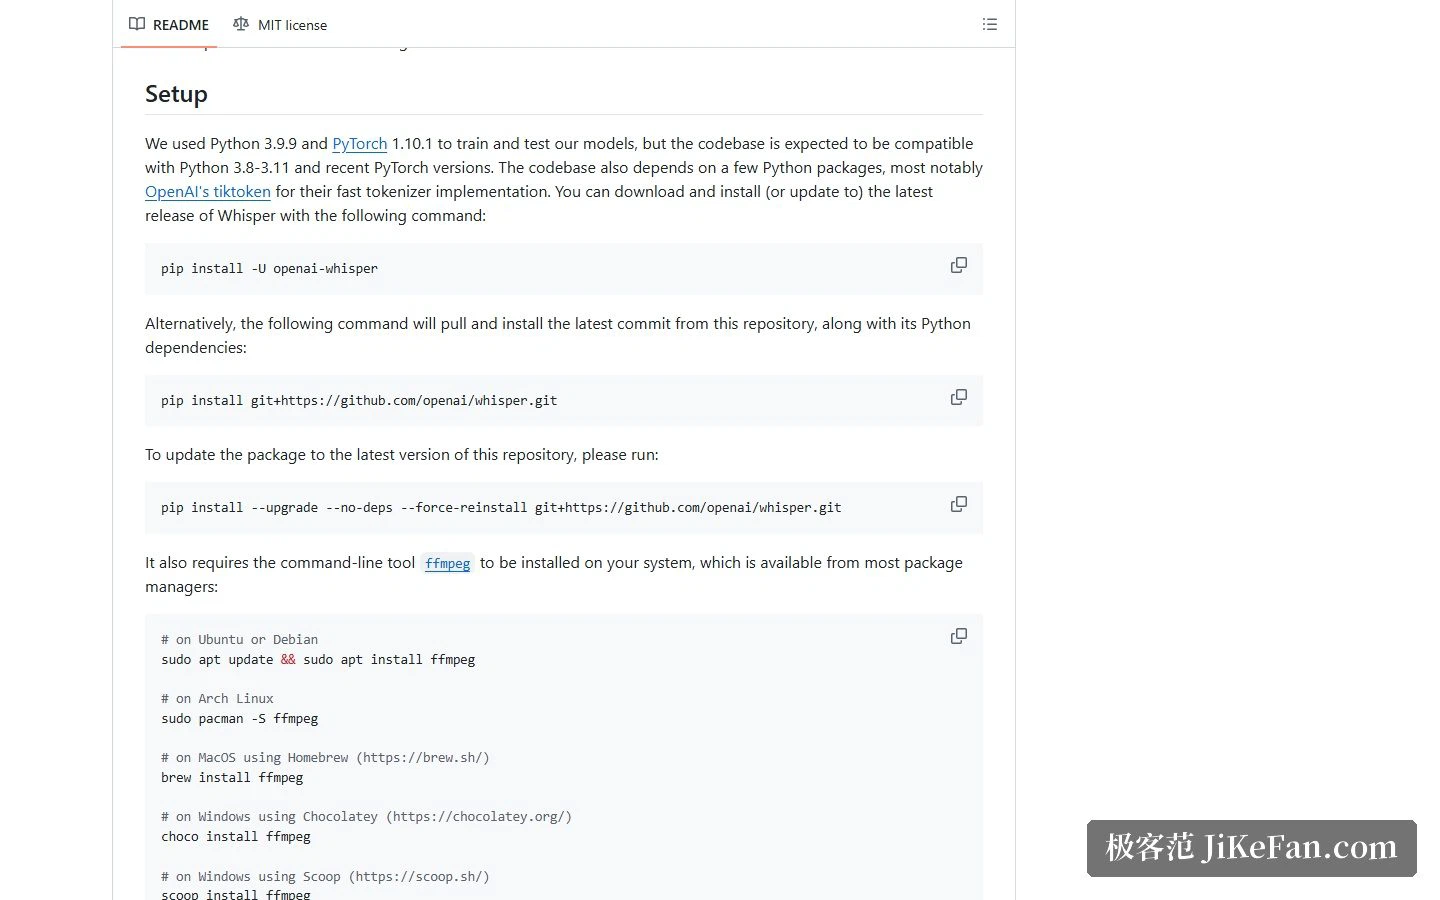
這是最該先看的一張表。官方提供六個尺寸,參數從 tiny 的約 3900 萬一路到 large 的約 15.5 億,顯示記憶體需求從約 1GB 爬到約 10GB。相對速度那一欄以 large 為基準,tiny 大約是它的十倍,turbo 大約八倍。速度與體積之間基本上是一條平順的取捨曲線。
顯示記憶體吃緊的時候,tiny 和 base 都只要約 1GB,跑在普通筆電上也不算勉強;要更好的準確率就得往 medium 與 large 走。中間的 turbo 值得單獨一提:官方說它是 large-v3 的優化版本,用極小的準確率損失換來明顯更快的轉寫速度,算是折中選擇。
另外,tiny、base、small、medium 這四個尺寸還另外提供僅英文版本。官方觀察到,純英文任務下這些版本往往表現更好,不過尺寸越大,這個差距越不明顯。
安裝:pip 加一個 ffmpeg
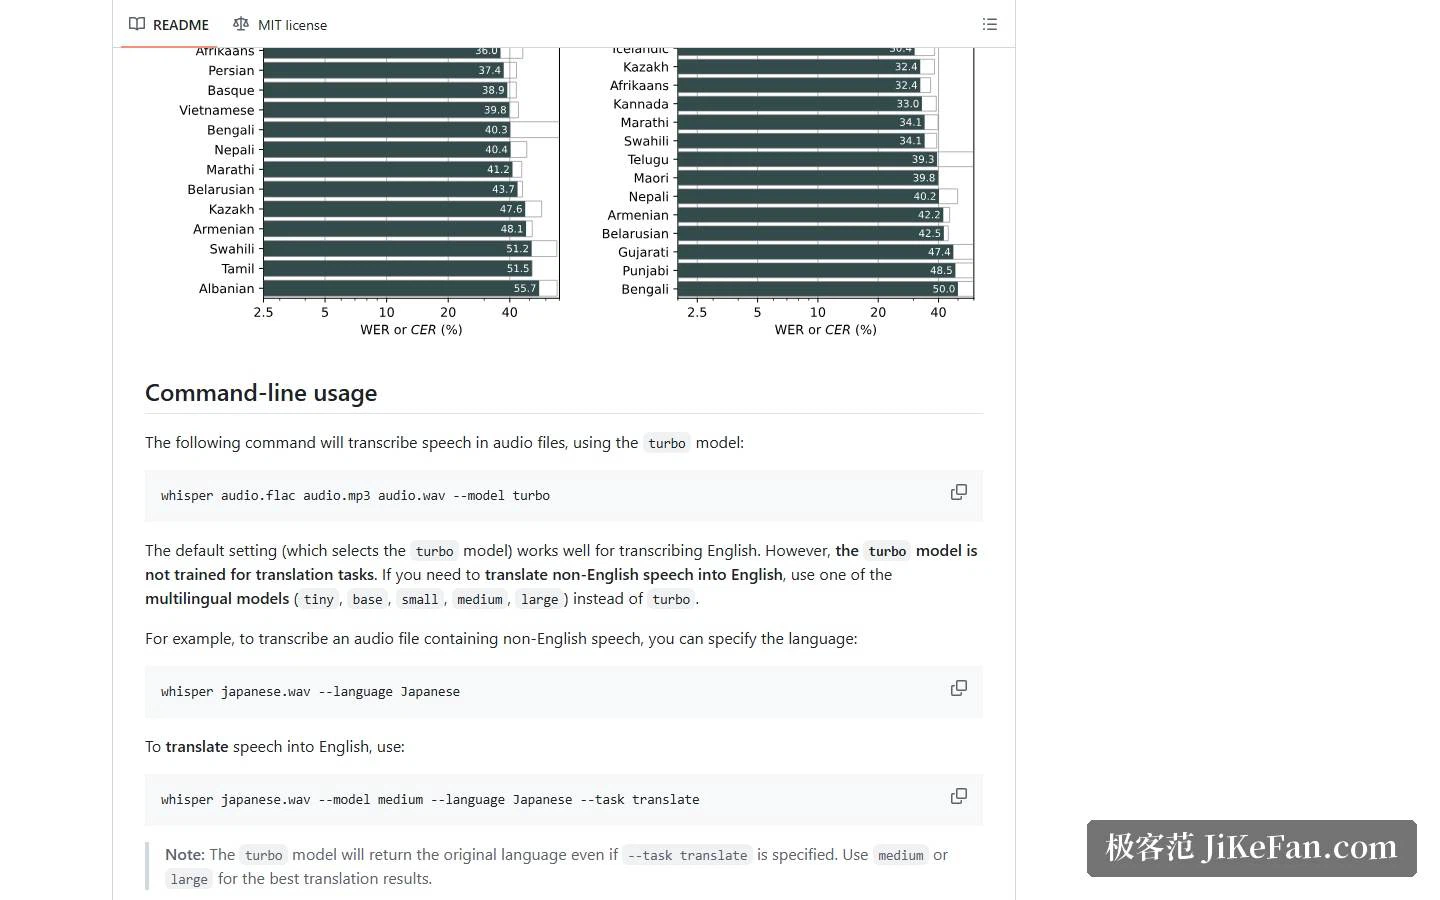
安裝本身只要一條 pip 指令,真正要留意的是系統相依:Whisper 靠 ffmpeg 這個命令列工具解碼音訊。官方按不同系統列出安裝方式,常見的套件管理器都涵蓋了。
還有一處要注意。官方提醒,如果平台沒有現成的分詞器預編譯套件,pip 安裝過程會需要 Rust 環境;錯誤訊息裡出現找不到某個模組時,補裝對應的套件就能解決。版本方面,程式庫相容 Python 3.8 到 3.11,以及較新的 PyTorch。
兩種用法:命令列與 Python
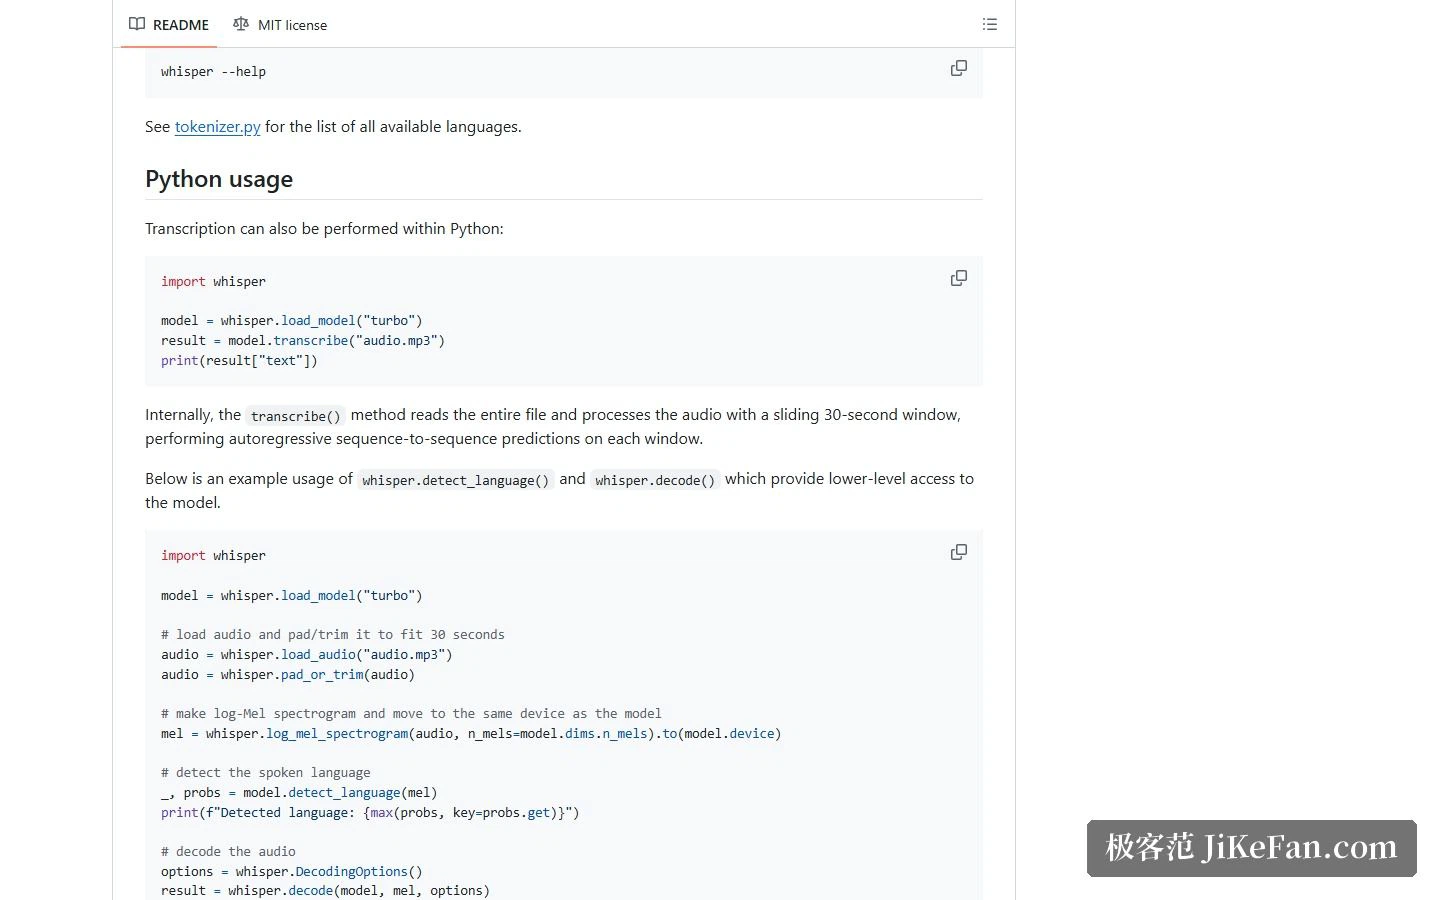
命令列是最快的驗證方式。把音訊檔接在指令後面,用模型選項指定尺寸,音訊不是英語時加上語言選項,要翻譯就把任務選項切過去。
有一個限制值得記住:官方明確說明 turbo 沒有為翻譯任務訓練過。即使指定了翻譯,它仍然回傳原語言的內容。要用翻譯功能得換回 tiny、base、small、medium 或 large 這些多語模型,官方建議翻譯場景用 medium 或 large 效果更好。
Python 裡的呼叫同樣簡短。載入模型、把音訊路徑交給轉寫方法、從結果取出文字欄位,三步就夠。官方還開放更底層的介面,可以自己載入音訊、算出對數梅爾頻譜圖、單獨呼叫語種偵測或解碼,方便嵌進更複雜的流程。
授權是這個專案實實在在的優勢
程式碼與模型權重都以 MIT 授權釋出,商用限制很少。這在語音辨識這類專案裡並不常見,不少模型的權重會附上另一份更嚴格的條款。如果你要把語音辨識放進自己的產品,這一條能省下不少法務往來。
適合哪些人
如果要替影片批次上字幕、把會議錄音整理成文字,或給自己的應用加一個本機轉寫功能,Whisper 的入手成本很低:一條指令裝好、一條指令跑起來,六個尺寸可以先從小的試,效果不夠再往上換。加上 MIT 授權,落地時不必為授權反覆確認。
它也不是萬能。翻譯只支援轉成英文這一個方向;即時性要求高的場景,得先評估硬體跟不跟得上;吵雜環境下的準確率與錄音品質直接相關。把它當成可靠的離線轉寫工具,預期會比較穩。
開源加上寬鬆授權,是 Whisper 被大量專案當成預設選擇的原因。工具本身的門檻已經很低,剩下的差別往往在於餵給它的音訊有多乾淨。