
Firecrawl レビュー:雑然としたページをエージェントの餌に変える層
要約
検索、取得、操作が一つのインターフェースにまとまり、返ってくるのは整った Markdown、雛形どおりの JSON、あるいはスクリーンショット。プロキシも bot 対策も描画もサービスの仕事で、そこが一番面倒な部分だ。
おすすめ- ソフト名
- Firecrawl
- バージョン
- v2.11
- オープンソース
- オープンソース
- OS
- WebLinuxmacOSWindows
- 更新日時
- 2026-10-06 06:29
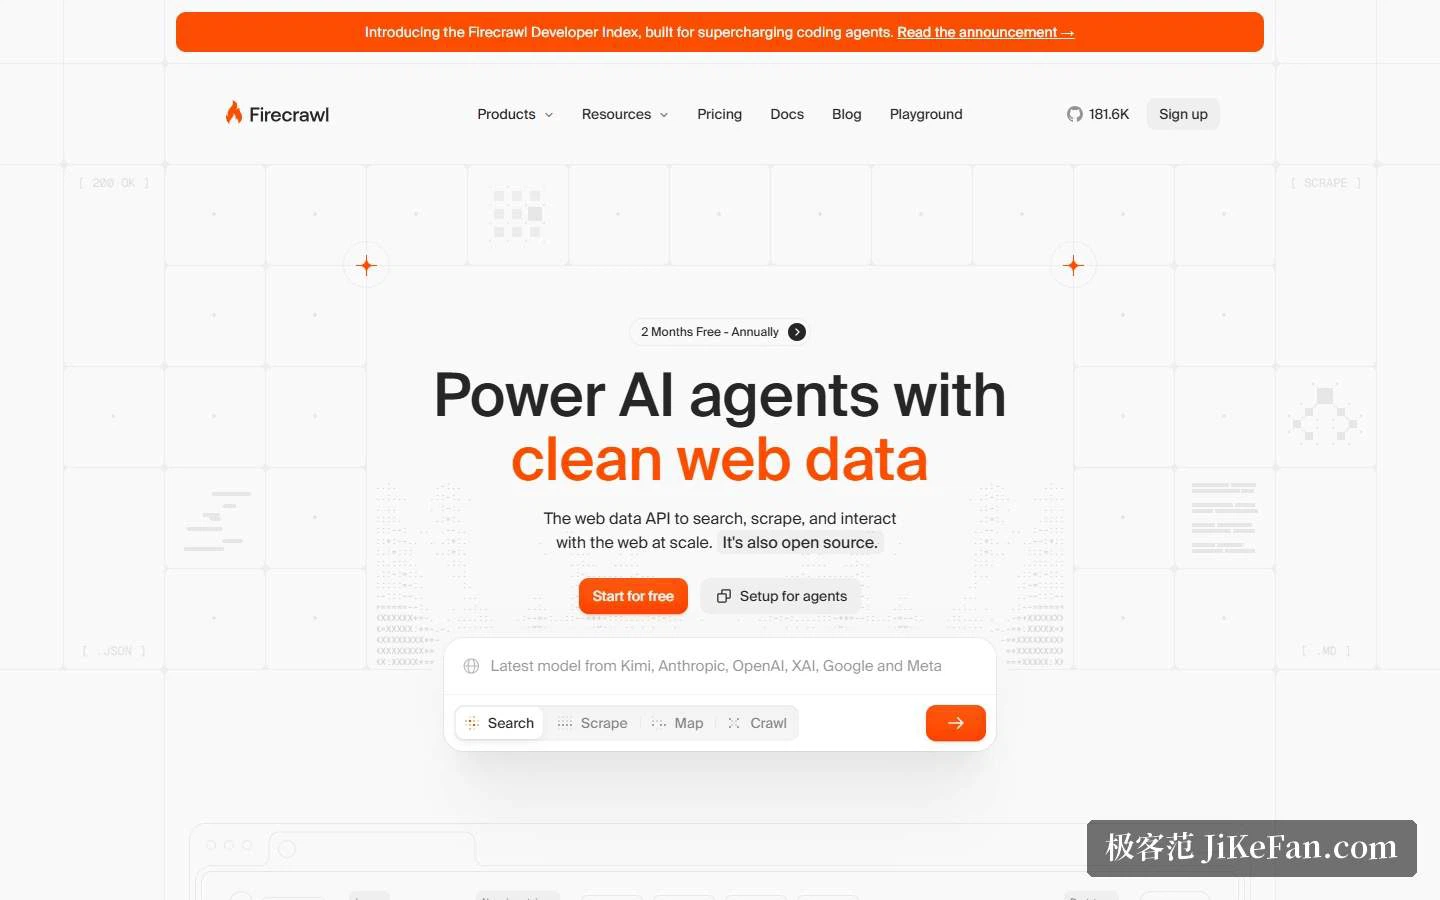
ウェブページをエージェントに食わせたことがある人なら、どこが面倒か知っている。狙った先は妨害してくるし、中身はスクリプトが走ったあとに現れ、本文はナビゲーションと広告に絡まっている。この製品はまさにその層を切る。自らをウェブデータのインターフェースと名乗り、URL を一つ送れば整った Markdown か構造化 JSON が返る。面倒な部分はサーバー側の仕事だ。トップページの標語は目的をはっきり書いていて、しかもオープンソースでもある。リポジトリが十八万を超えるスターを集めた理由もそこにある。
三つの仕事:検索、取得、操作
中核は三つに分かれる。Search はウェブを検索し、結果ページの全文まで一緒に持ち帰る。まず見つけて、それから読むという型に向く。Scrape は任意の URL を Markdown、JSON、スクリーンショットに変える。構造化出力では JSON の雛形を渡せば、指定した項目の形で返ってくる。Interact は三つの中で最も新しく、最も分かりにくい。ページを取得してもセッションを終えず、自然言語やコードでクリックし、フォームを埋め、動的な内容を取り、さらに奥へ進める。公式の例は、ある商店のトップページを取得し、その中で商品を検索し、結果を開いて価格を読むという流れだ。三つをつなぐ価値は、多くの収集作業で本当に難しいのが第三の段階にあることだ。静的な HTML を取ってきただけでは足りないことが多い。
一枚では終わらない:サイト全体、一括、ローカルファイル
中核の端点の周りにも能力の輪がある。Map は一つのサイト下の全 URL を見つけ、Crawl は再帰的にサイト全体を取得し、一括取得は何十万もの URL を非同期で扱う。解析も公開ページに限らない。ローカルの PDF、DOCX、XLSX、HTML も Markdown や構造化 JSON に変換できる。ほかに、欲しいものを説明すれば自分で集める自律モード、結果を非同期で届ける webhook、操作の流れに使うホスト型のブラウザセッションを提供するブラウザサンドボックスがある。取得前の動作にも口が用意されていて、クリック、スクロール、入力、待機、キー押下を流れに組み込める。
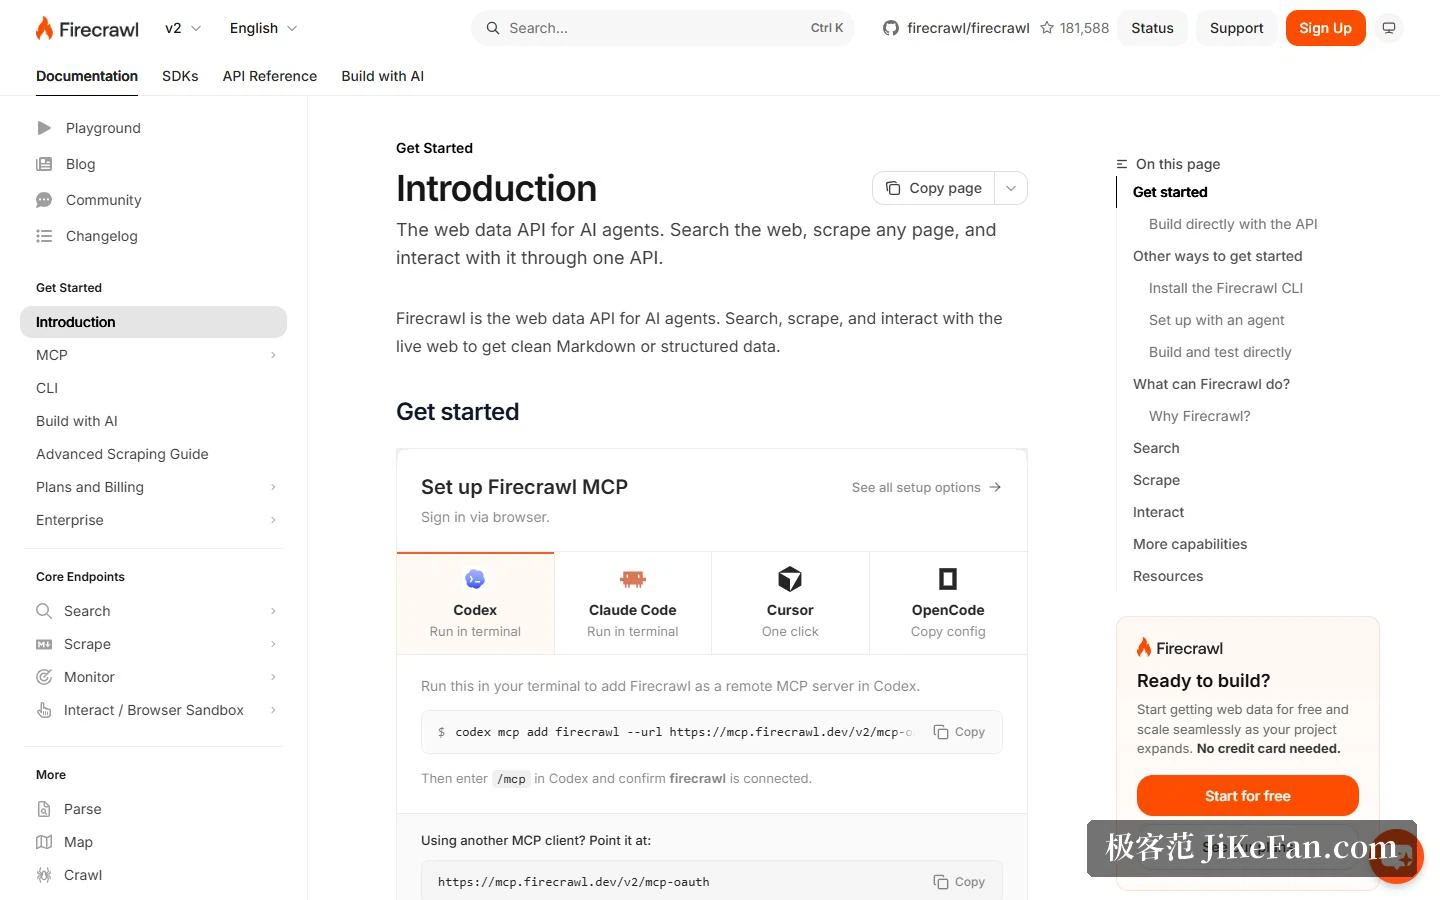
接続方法は充実している。モデルコンテキストプロトコルのサーバーとして動くので、コマンド一本でコーディングエージェントにつながる。コマンドラインツールもあり、導入と同時に検出したコーディングエージェントへスキルを差し込む。SDK は Python、Node、コマンドラインを覆い、連携の一覧には定番の検索フレームワーク二つと複数のモデル事業者が並ぶ。ドキュメントは「鍵なしで試す」ことを推奨の道として書いている。最初のリクエストに鍵は要らず、付ければレート制限が緩むだけだ。
無料枠と課金の数え方
枠の規則は異例に読みやすい。毎月 1,000 クレジット、およそ千ページ分で、クレジットカードは要らない。その上に四つの段があり、企業向けは個別相談、年払いなら二か月分が付く。単位は能力ごとに変わる。取得、サイト全体の巡回、URL の発見、監視は一ページにつき一クレジット。検索は十件の結果につき二クレジット。ページ操作はブラウザ一分につき二クレジット。繰り越しも違う。上位二段は未使用分を翌月に回せるが、下位は回せない。公式の質疑には境界が二つ足されている。何も返らなかった取得は課金されず、エラー状態を返したページもこちらには届く。五ドルの追加購入は段によって 1,000、2,000、2,500、5,000 クレジットに変わり、上の段ほど同じ金額で多く買える。
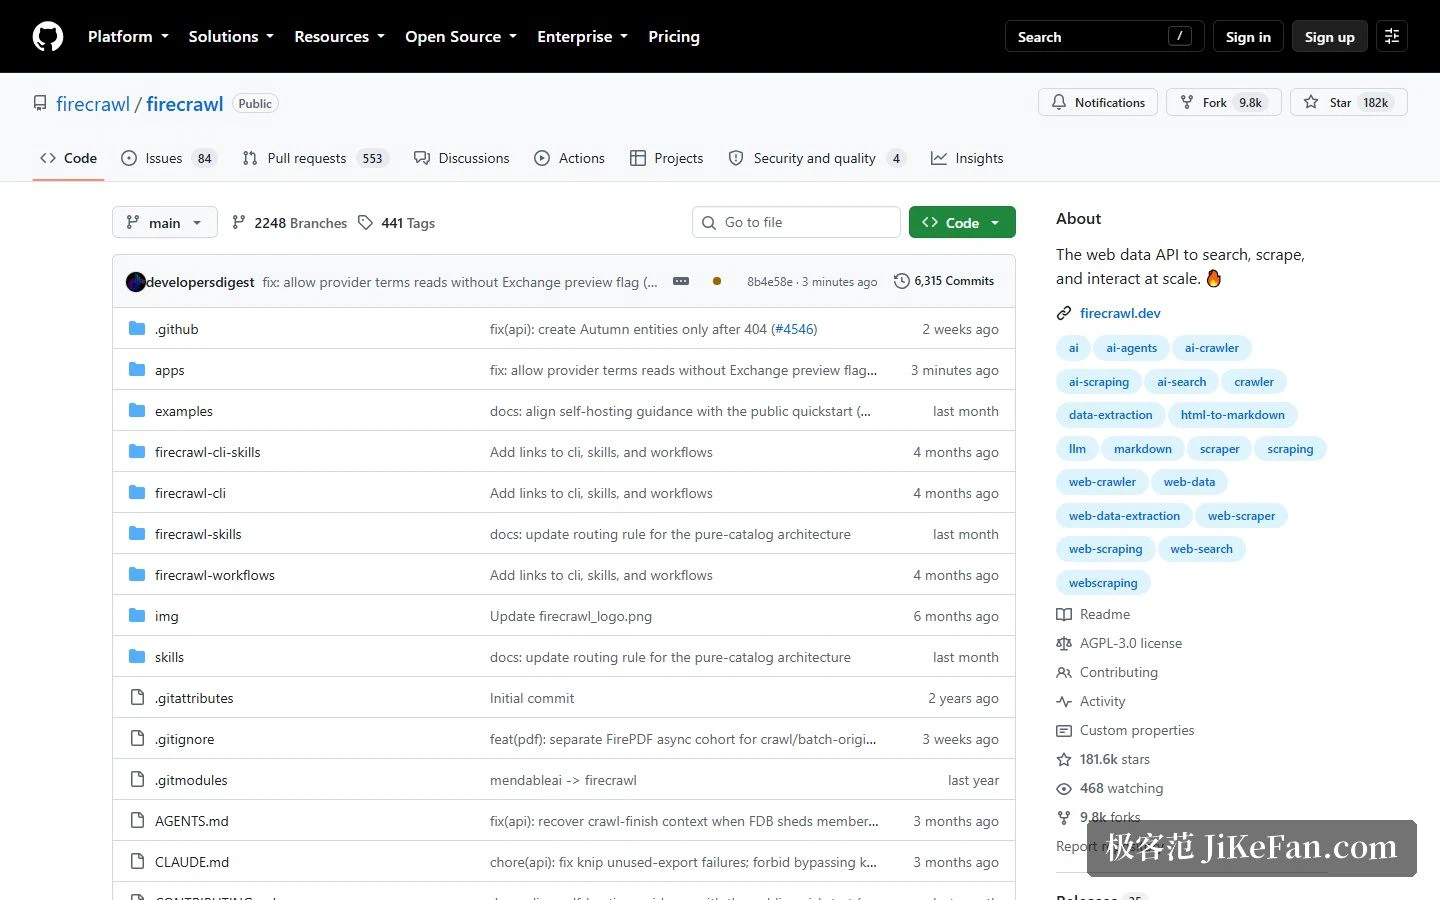
注意したいのはライセンスの形だ。プロジェクトは主に AGPL-3.0 で、改変版を公開サービスとして動かすなら変更の公開が要る。SDK と一部の画面部品は MIT なので、ホスト版のインターフェースを呼ぶ分には制約が緩い。ホスト版にはself-hosted にはない能力もあり、リポジトリとドキュメントの機能一覧で見比べられる。コンプライアンスについては、robots.txt を既定で尊重し、対象サイトの規約を守る責任は利用者にあると明記されている。商用の収集の前に一字ずつ読む価値がある一文だ。
誰に向くのか
三つの場面がきれいにはまる。エージェントの検索と道具の層を作るチーム。ページを確実に扱いやすい形式へ変える必要があり、取得と bot 対策の基盤を自前で持ちたくない。データ管線と見込み客の補完を行うチーム。一括取得と構造化の雛形で、雑然としたページをそのまま保存できる項目に対応づけられる。そして開発期に試す個人や小さなチーム。無料枠で流れを最後まで通せ、プロトコルサーバーもコマンドラインツールも数分でつながる。
天秤にかけるべきは二点。第一にライセンス。AGPL-3.0 は改変版をサービスとして売ることに制約を課す。ホスト版を呼ぶだけなら影響はないが、自前で立てて外に出すなら義務を先に整理する必要がある。第二に自前運用とクラウドの取捨。自前はデータと費用を握れるが、bot 対策の強さとページ網羅率という重い部分を自分で背負う。クラウドはそれを引き受ける代わりに、従量課金とリクエストの第三者委託を受け入れることになる。リポジトリの数字は約 181.6k スター、9.8k フォーク、35 リリース、173 人のコントリビューター、現行版 v2.11.0、主な言語は TypeScript で Python と Rust が続き、ページ網羅率 96 パーセント、P95 遅延 3.4 秒。いずれも提供元の数字なので、自分の対象サイトで一度測る価値は残る。
取得ツールの価値は「取れるか」ではない。「取れたものがそのまま下流に流せるか」だ。この層をきれいにできるものだけが、実際に人手を減らせる。