
Hailuo AI: einen Absatz vorlesen, und die eigene Stimme ist kopiert
Zusammenfassung
Ein Absatz als Vorlage genügt, und der eigene Timbre ist nachgebaut; ein Satz Beschreibung erzeugt eine Stimme, die es vorher nicht gab. Daneben stehen Sprachausgabe mit Steuerzeichen, Stimmentnahme, Musik und ein Gespräch, das unterbrochen werden darf.
- Name
- Hailuo AI
- Version
- 0.1.794
- Open Source
- Proprietär
- Betriebssystem
- WebiOSAndroid
- Webseite
- https://hailuoai.com
- Aktualisiert
- 2026-10-06 18:32
Diese Plattform betreibt die menschliche Stimme als Hauptgeschäft und nicht als Anhängsel eines Chatfensters. Ein Absatz Vorlesetext genügt, und der eigene Timbre ist kopiert. Ein Satz Beschreibung erzeugt eine Stimme, die es vorher nicht gab. Dazu kommt ein gesprochenes Gespräch in Echtzeit, das man mitten im Satz unterbrechen darf. Im Folgenden geht es ausschließlich um die Stimmseite, denn über Clip und Bild ist anderswo schon reichlich geschrieben worden.
Eine Sache stiftet leicht Verwirrung. Wer heute die Hauptseite öffnet, sieht oben den Kurzfilm-Bereich mit erzeugten Clips und kuratierten Beispielen, während die Stimmwerkzeuge in eine eigene Werkbank gewandert sind, deren Navigation Stimmbibliothek, Sprachausgabe, Musikerzeugung, Stimmdesign, Stimmklon und Stimmentnahme auflistet. Das ist die heutige Form: eine Sammlung multimodaler Werkzeuge, in der Film, Bild, Stimme und Musik je ein Stück belegen, und die Stimme ist die dickste der vier Schichten.
Stand September 2026 läuft die Plattform im Netz und auf Telefonen, iOS und Android nebeneinander. Am Rechner öffnet man schlicht einen Browser, denn die Desktop-Fassung ist die Web-Anwendung und sonst nichts. Klon und Design, die beiden Funktionen, die das Produkt interessant machen, sind der Teil, den kaum jemand ausprobiert hat.
Einen Absatz vorlesen, und die eigene Stimme kommt zurück
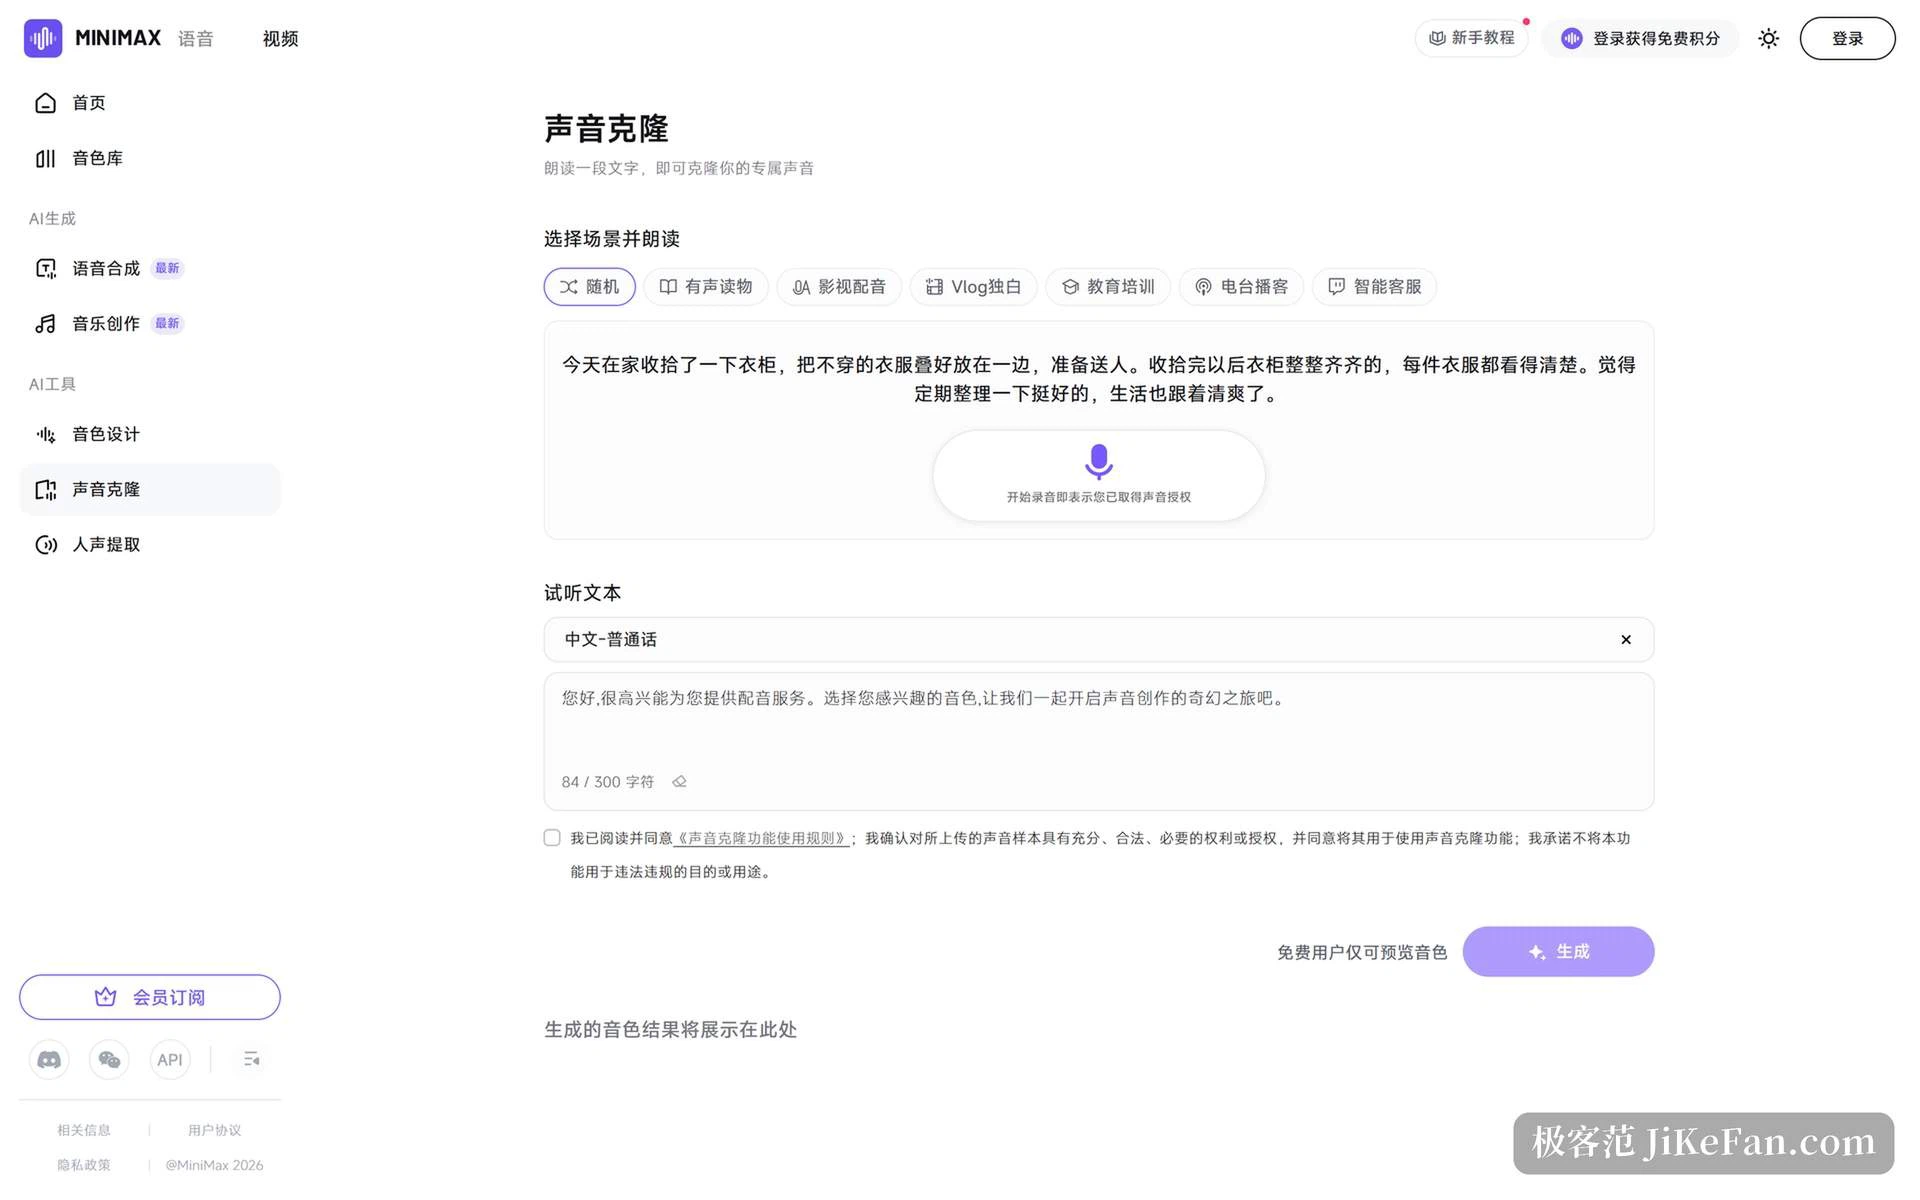
Der Klonvorgang ist kürzer als erwartet. Auf der Klonseite erklärt eine einzige Zeile oben das Ganze: einen Text vorlesen, und die eigene Stimme ist kopiert. Darunter liegt eine Reihe von Anlässen — zufällig, Hörbuch, Synchronisation, Tagesvlog, Aus- und Weiterbildung, Radiopodcast, Kundenbetreuung — man wählt den, der sich angenehm lesen lässt; daneben steht der Probelesetext, auf Hochchinesisch gesprochen, und in der unteren rechten Ecke zählt ein Zeichenzähler live mit.
Der Aufwand an Material ist bescheiden: zehn Sekunden bis fünf Minuten Audio aufnehmen oder hochladen, eine Datei von höchstens 50 MB. Zwei optionale Schalter verbessern die Ähnlichkeit — Akzentoptimierung und das Entfernen von Hintergrundgeräuschen aus der Probe —, was jedem entgegenkommt, der in einem gewöhnlichen Zimmer und nicht im Studio aufnimmt.
Ein Vorbehalt gehört früh gesagt, bevor ein Abend draufgeht: Der Klon ist eine Mitgliederfunktion. Ein freies Konto hört das Ergebnis als Vorschau, zum Speichern für den echten Einsatz braucht es ein Abonnement, und die kleine Zeile neben dem Knopf sagt das sehr deutlich. Für Vorschauen gibt es ein eigenes Kontingent: fünf kostenlose Anhörproben pro Tag, geteilt zwischen Klonseite und Designseite, sodass eine Probe auf einer der beiden Seiten eines der fünf verbraucht. Danach kostet jeder weitere Versuch Guthaben.
Das Abonnement ist vergleichsweise großzügig: bis zu hundert Klonplätze und eine Erzeugungsgrenze von zwanzig Stunden Audio. Für ein Hörbuch oder eine laufende Serie reicht das, dass man nicht jede Woche eine alte Stimme löscht, um Platz zu schaffen.
Sprachausgabe: ein Zeichen im Satz ändert den Vortrag
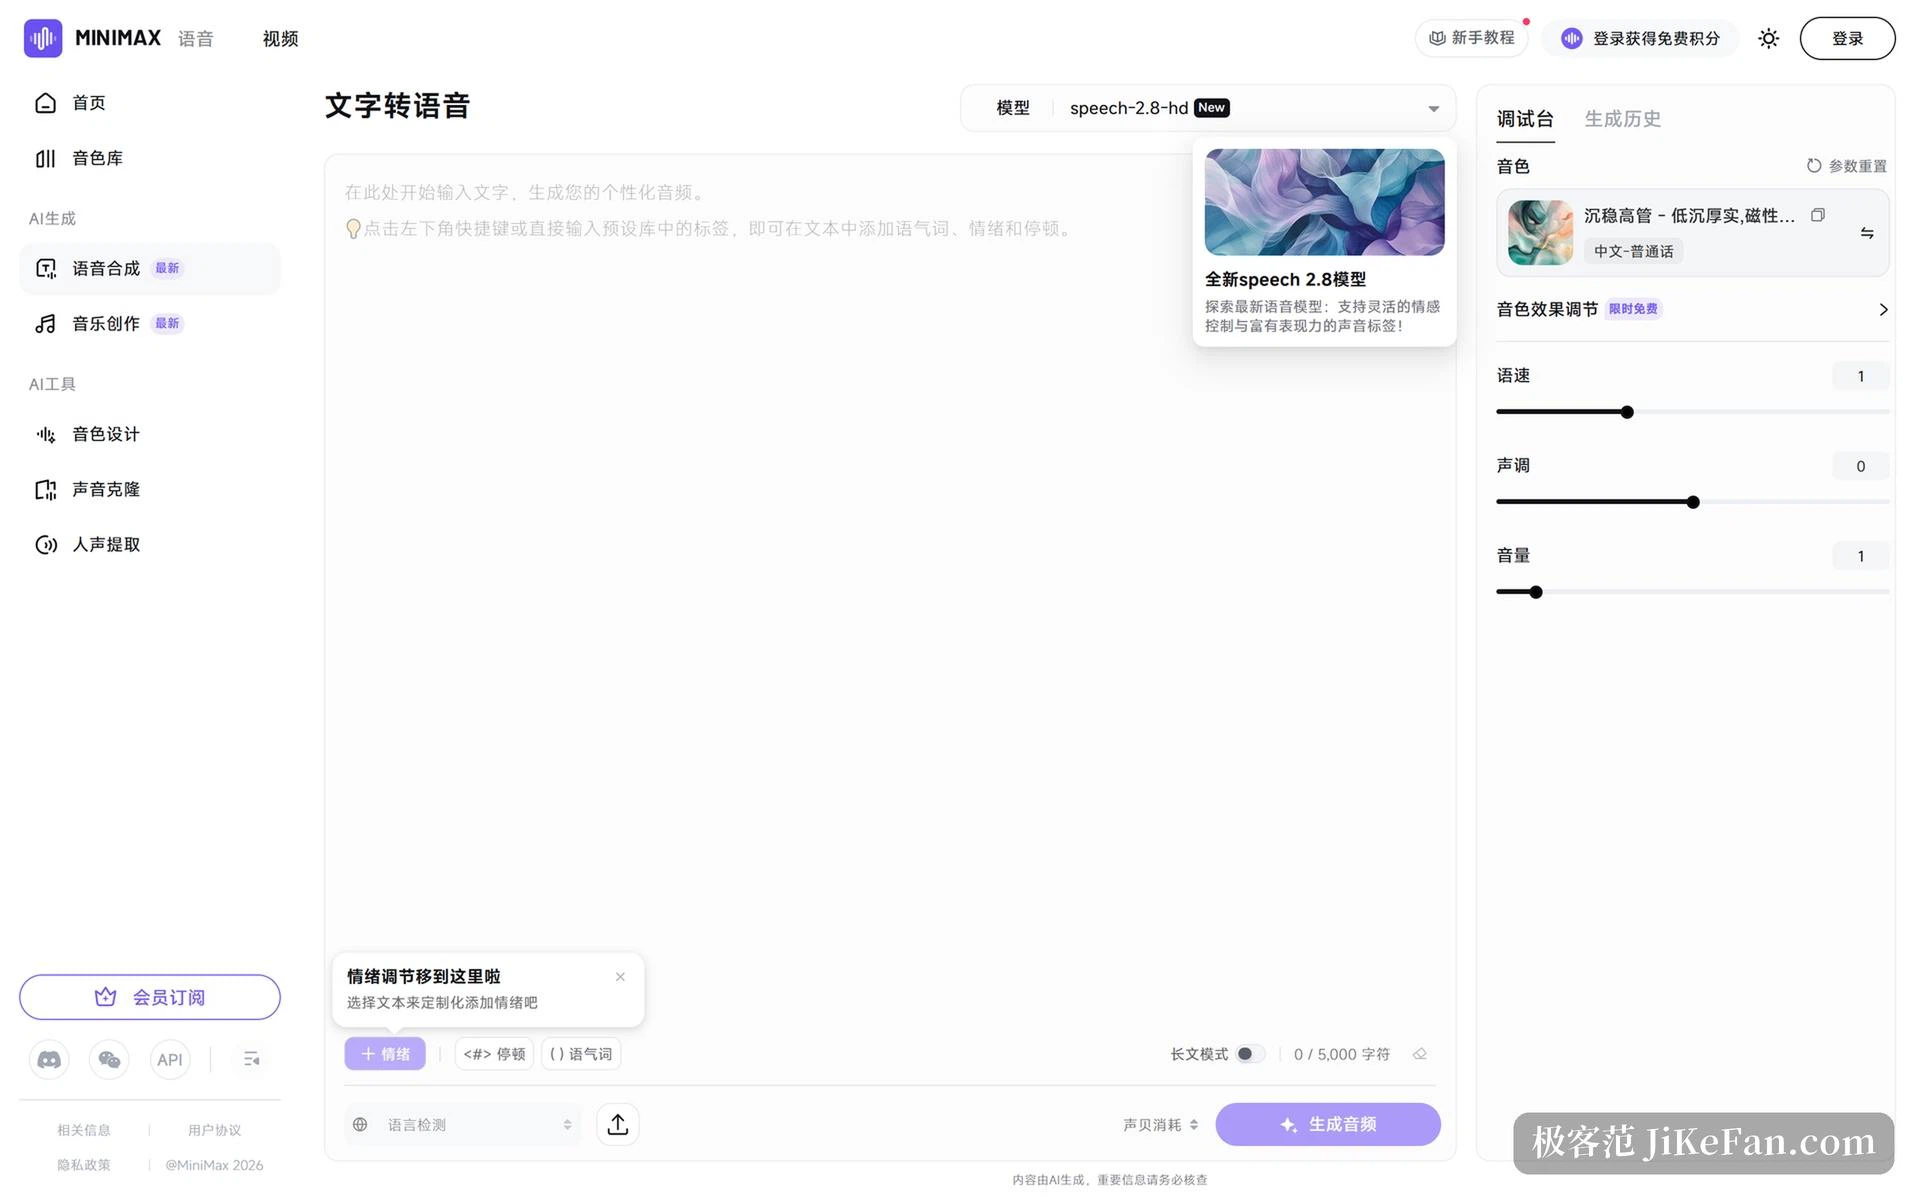
Der Klon beantwortet, ob es wie man selbst klingt. Die Ausgabe beantwortet, ob es richtig klingt. Die aktuelle Fassung setzt standardmäßig auf das Sprachmodell in hoher Auflösung, und unten links im Eingabefeld liegen Marken, die man direkt in den Text tippt: Emotion, Pause, Füllwort. Inline geschrieben — eine Emotion vor dem Teilsatz, eine Pause dort, wo ein Fragezeichen stehen würde — kommen sie als Hebungen und Senkungen aus dem fertigen Audio zurück. Das ist ein anderer Weg, als in Auswahllisten nach einer voreingestellten Stimmung zu suchen.
Rechts steht ein Mischpult: Tempo, Tonhöhe und Lautstärke auf drei Reglern, dazu eine Steuerung für den Klangeffekt, sodass man eine Stimme tauscht, neu justiert und schnell beim gewünschten Gefühl landet. Die Bibliothek ist breit genug zum Stöbern statt zum Suchen — Nachrichtensprecherin, ruhige Führungskraft und weitere Bürostimmen neben Flüstern zur Schlafenszeit, Horrornarration, Feilschen eines Kobolds und Science-Fiction für Inhalt und Unterhaltung, jeweils mit Sprache und Einsatzzweck beschriftet.
Langer Text ist eine echte Stärke. Ein einzelner Durchlauf fasst fünftausend Zeichen im hohen Modus und zehntausend im schnellen; wer den Langtextmodus einschaltet, kommt in einem Zug auf bis zu zweihunderttausend Zeichen. Damit liegt ein ganzer Roman oder ein komplettes Kurspaket im normalen Gebrauch, statt zerstückelt und wieder zusammengesetzt zu werden. Der Preis ist Wartezeit, und die untere rechte Ecke schätzt den Guthabenverbrauch live, damit die Zahl hinterher nicht überrascht.
Ohne Klon: eine Stimme aus einem Satz formen
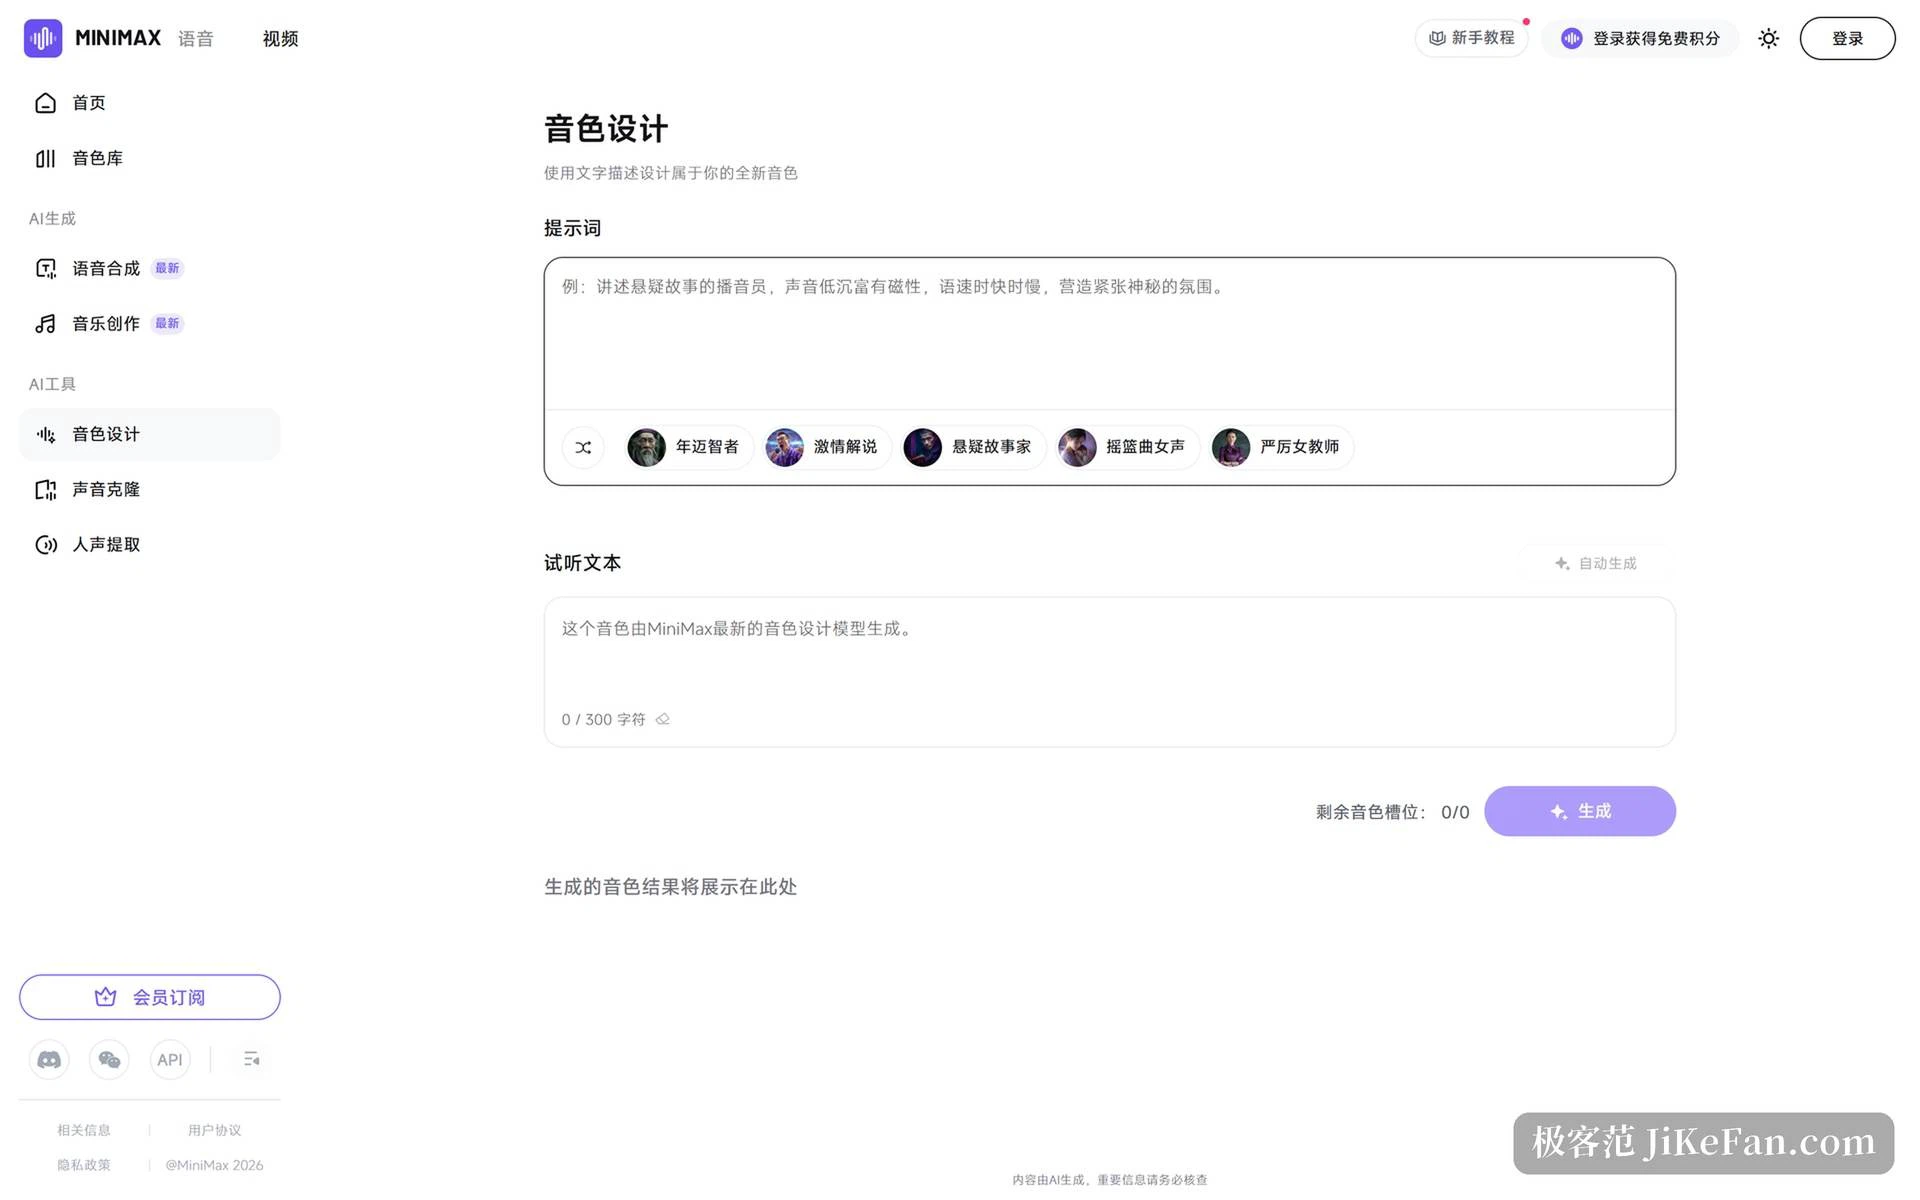
Stimmdesign ist der andere Weg und der, den ich vorziehe. Es verlangt überhaupt kein Audio — eine Beschreibung erledigt die Arbeit. Das Beispiel auf der Seite ist ungewöhnlich konkret: eine Podcastseite, die eine Spannungsgeschichte erzählt, die Stimme tief und klangvoll, das Tempo mal schneller, mal langsamer, um Spannung und Rätsel aufzubauen. Anders gesagt: aufschreiben, welche Eigenschaften die Stimme haben soll, und es baut eine passende.
Wenn Formulieren lästig ist, decken Voreinstellungen die typischen Richtungen ab: greiser Weiser, leidenschaftlicher Kommentator, Spannungserzähler, weibliche Wiegenliedstimme, strenge Lehrerin — genug für Erzählen, Kommentieren und das Herunterkommen am Abend. Der Probelesetext darf eigener sein oder spontan erzeugt werden; standardmäßig landet er auf dem Satz, die Stimme stamme vom neuesten Designmodell.
Dasselbe Tageskontingent gilt auch hier, fünf freie Proben geteilt mit der Klonseite, und unten rechts steht, wie viele Plätze frei bleiben. Geklonte und gestaltete Stimmen belegen jeweils einen, die hundert Sitze teilen sich also beide Funktionen — gut, das vor einem großen Vorhaben auseinanderzuhalten.
Stimmentnahme und Musik: die zwei kleinen Werkzeuge daneben
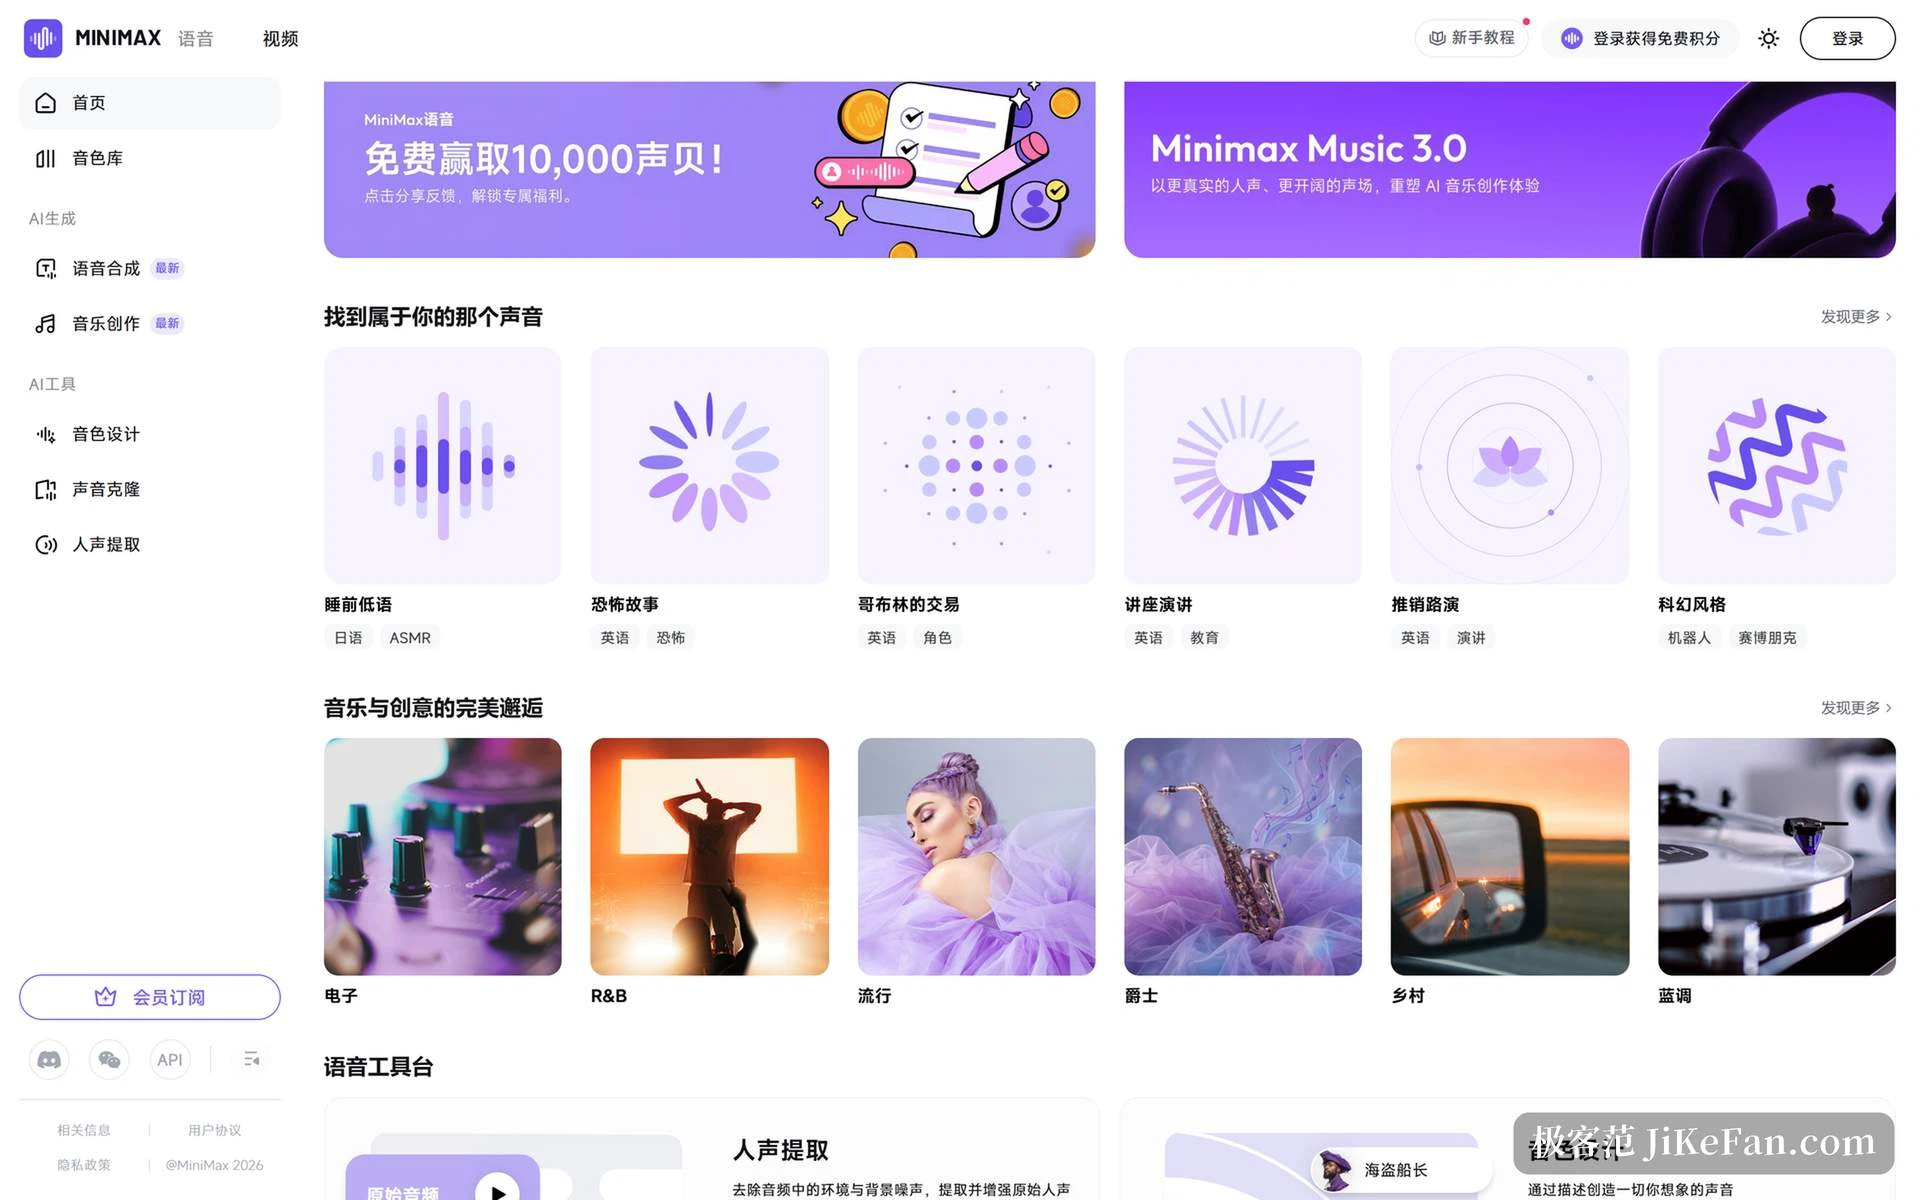
Die Werkbank enthält außerdem zwei Alltagshelfer. Die Stimmentnahme drückt Umgebungs- und Hintergrundgeräusche herunter, zieht die ursprüngliche Stimme sauber heraus und hebt sie an — nützlich für Podcastaufnahmen, eine Coverversion oder Interviewmaterial — im Rahmen von fünfhundert Megabyte und dreihundert Sekunden pro Datei. Die Musikerzeugung deckt einige Richtungen ab: elektronisch, Rhythm and Blues, Pop, Jazz, Country, Blues, gedacht für einen kurzen Clip oder eine Präsentation, die eine Tonspur braucht, die nicht schon alle im Raum verwendet haben.
Und es gibt ein Gespräch in Echtzeit. Die Oberfläche zeigt Einstellungen für Unterbrechung durch Sprache und einen Eröffnungssatz, dazu Statusmeldungen zu Mikrofonberechtigung und Verbindungsaufbau. Mitten im Satz dazwischenreden zu dürfen, statt die Antwort abzuwarten, ist das Detail, das entscheidet, ob das als Gespräch funktioniert oder nur als Vorlesen eines Skripts.
Die technischen Eckdaten
Entwickler ist MiniMax. Die Plattformen sind Web, iOS und Android, wobei die Webseite zwei getrennte Builds ausliefert — Hauptseite und Stimmwerkbank —, was zwei unabhängige Buildnummern erklärt, falls man danach sucht; das sind zwei Anwendungen auf getrennten Ausgabelinien und keine Versionsverwirrung, die Telefon-Apps laufen ohnehin auf eigenen Spuren. Klonmaterial umfasst zehn Sekunden bis fünf Minuten bei höchstens 50 MB pro Datei. Frei sind fünf Vorschauproben pro Tag, geteilt zwischen Klon und Design.
Wie weit die freie Stufe reicht
Die Abrechnungseinheit ist das Guthaben. Ein neues Konto startet mit zehntausend davon, was die Dokumentation mit mehr als zwölf Minuten erzeugtem Audio gleichsetzt — genug, um jede Funktion einmal anzuklicken und ein paar kurze Texte zu versuchen. Danach lassen sich Guthabenpakete nach Bedarf kaufen, ohne sich auf eine Stufe festzulegen, oder man abonniert und öffnet Klonplätze und Erzeugungsgrenze zugleich.
Die Lizenzbedingungen verdienen einen eigenen Blick. Private Nutzung — Beiträge in sozialen Netzen, ein gemeinnütziges Treffen — darf das erzeugte Audio kostenlos verwenden, sofern die offizielle Kennzeichnung oder ein Hinweis auf die Quelle enthalten ist. Kommerzielle Nutzung, also monetarisierte Inhalte oder ein Kundenprojekt, verlangt die Standardmitgliedschaft oder höher. Die Linie ist klar genug gezogen, dass man besser vor der Produktion prüft, auf welcher Seite man steht, statt danach.
Einen Absatz lesen, um die eigene Stimme zu kopieren, einen Satz schreiben, um eine andere zu erfinden. Bemerkenswert ist nicht, wie überzeugend beides klingt, sondern dass beide Wege die Eintrittsschwelle auf null Erfahrung in Audiobearbeitung gesenkt haben.