
Elicit führt die Literaturrecherche durch und liefert Belege mit Zitaten bis zur Satzebene
Zusammenfassung
138 Millionen Artikel und 545 000 klinische Studien durchsuchen, dann baut der Agent daraus einen Bericht, eine Tabelle oder einen Foliensatz, in dem jede Aussage ein Zitat bis zum Satz trägt.
Empfehlen- Name
- Elicit
- Version
- 1.38
- Preis
- Kostenlos
- Open Source
- Proprietär
- Betriebssystem
- Web
- Webseite
- https://elicit.com/
- Aktualisiert
- 2026-10-06 10:22
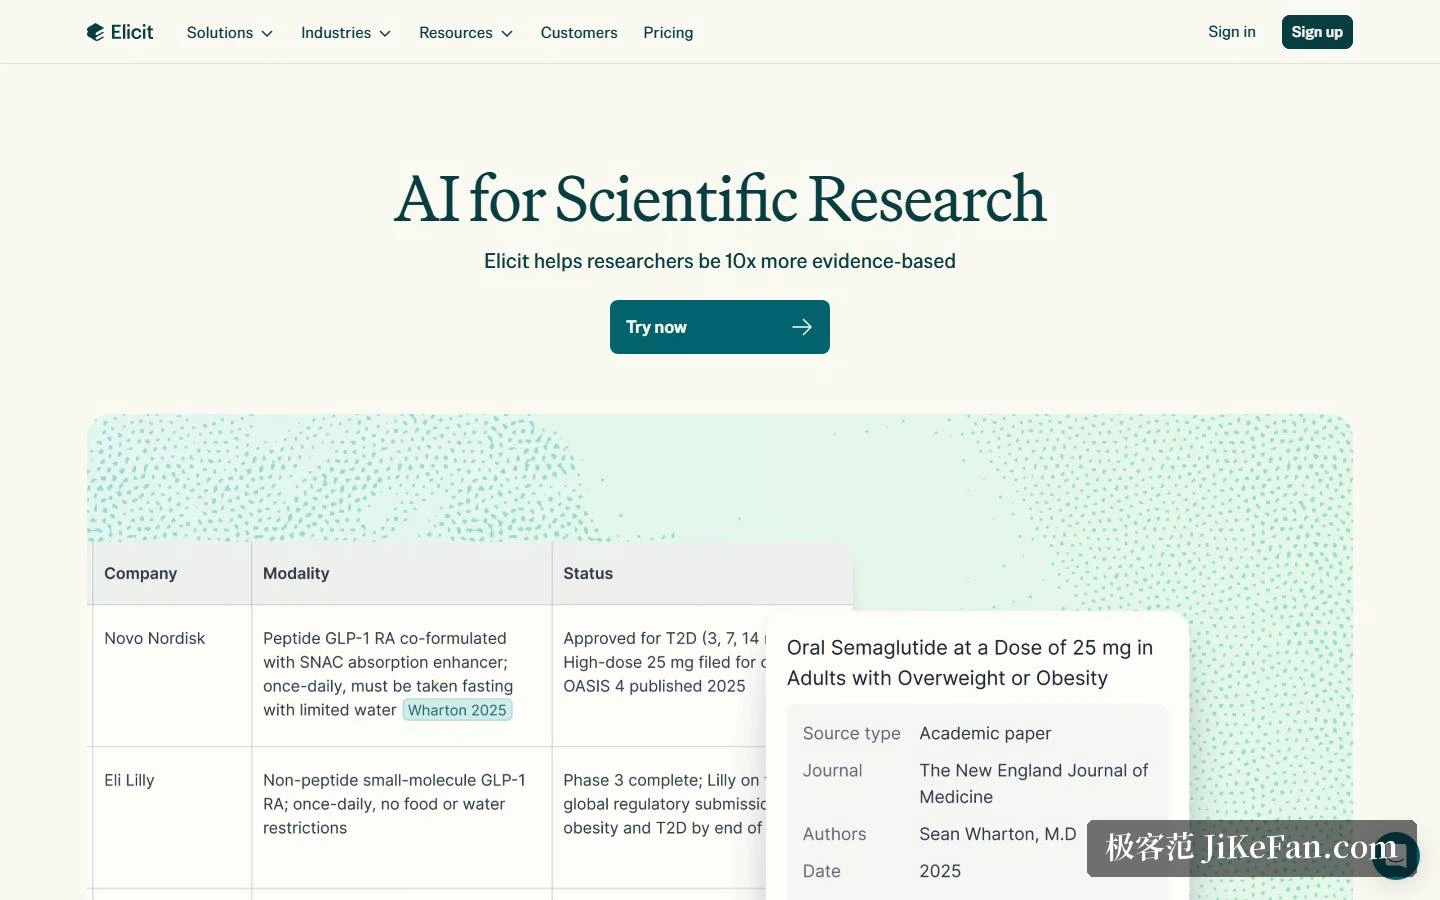
Die Startseite beginnt mit einer Serifenzeile: KI für wissenschaftliche Forschung. Die Unterzeile verspricht, Forschende zehnmal evidenzbasierter arbeiten zu lassen. Unter der Navigation steht eine Beispieltabelle aus der Arzneimittelforschung – Unternehmen, Molekültyp, Zulassungsstatus – und an jeder Zelle hängt ein Literaturnachweis. In der Fußzeile steht der Urheberrechtsvermerk, und die Seite nennt über 5 Millionen Forschende, die darauf vertrauen.
Ein Agent, der Belege sammelt und das Ergebnis baut
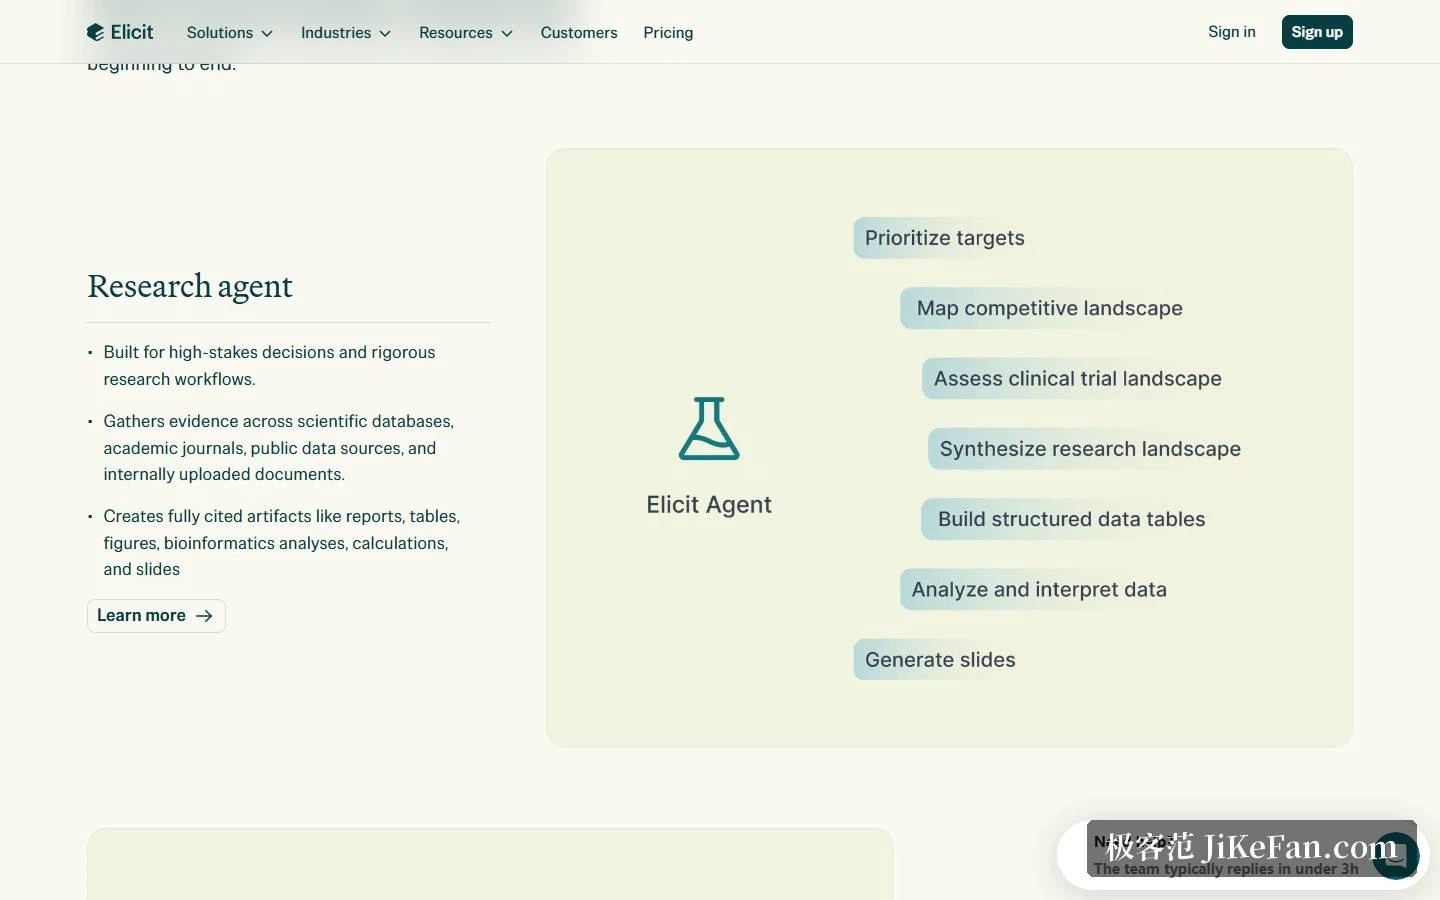
Der Rechercheagent ist auf Entscheidungen mit hohem Einsatz und strenge Abläufe zugeschnitten. Er sammelt Belege aus wissenschaftlichen Datenbanken, Fachzeitschriften, öffentlichen Datenquellen und selbst hochgeladenen Dokumenten und baut daraus Ergebnisse mit durchgehenden Zitaten: Berichte, Tabellen, Abbildungen, bioinformatische Analysen, Berechnungen und Foliensätze. Im Beispiel reichen die Aufgabenmarken von der Zielpriorisierung über Wettbewerbs- und Studienlandschaft bis zur Foliengenerierung.
Umfang, Genauigkeit und die Zusage der Transparenz
Die Suchzahlen stehen klar da: über 138 Millionen Fachartikel und 545 000 klinische Studien, semantisch durchsucht, damit man nicht jedes Stichwort erraten muss; der eigene Blog verzeichnet einen Sieg über fünf andere Retrievalsysteme in einem biomedizinischen Frage-Antwort-Benchmark. Drei Unterschiede werden genannt. Umfang: bis zu 1,000 relevante Artikel und bis zu 20,000 Datenpunkte in einem Durchgang. Genauigkeit: ein validierter Prozess hinter der Extraktion. Transparenz: jede KI-Aussage trägt ein Zitat bis zur Satzebene aus der Originalquelle.
Der langsamste Teil einer systematischen Übersicht
Screening und Datenextraktion lassen sich automatisieren, und Forschende berichten von bis zu 80% Zeitersparnis. Über 994 Cochrane-Übersichten nennt die veröffentlichte Auswertung 95% Trefferquote bei der Suche, 97% beim Abstract-Screening, 99% beim Volltext-Screening und 96% bei der Extraktion. Die Fallbeispiele sind konkreter: Die Übersicht eines Normungsgremiums zog 1,502 von 1,511 Datenpunkten korrekt heraus, 99.4% Genauigkeit bei elfmal so viel Evidenz, während ein Biotechnologieunternehmen Daten aus 1,600 Arbeiten zehnmal schneller gewann. Bibliothek und Benachrichtigungen machen aus einer Suche eine stehende Sammlung und ein waches Auge.
Der Preis folgt der Nutzung
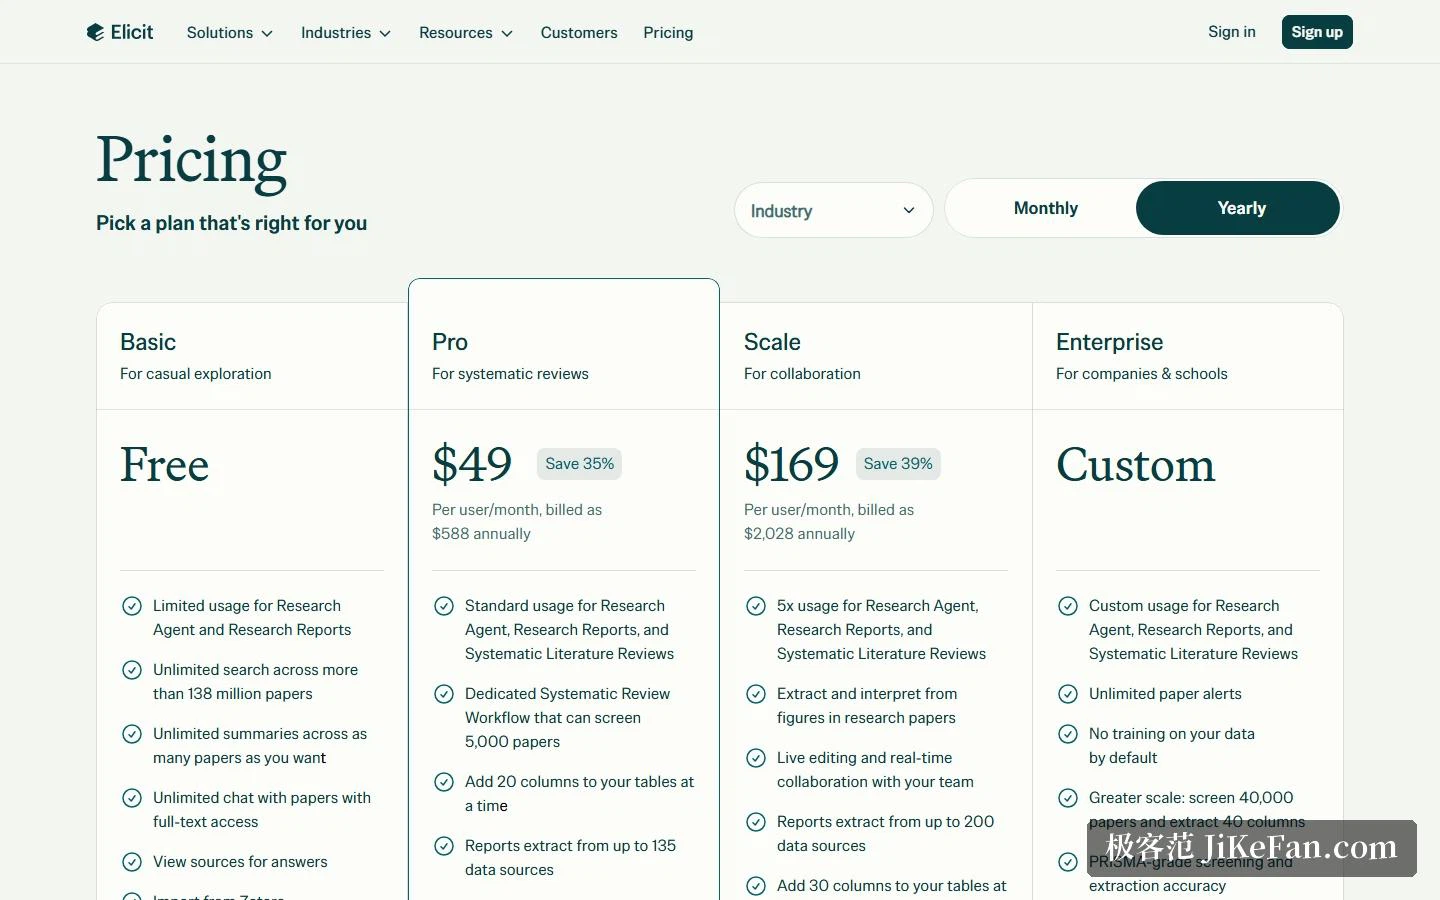
Vier Stufen. Basic ist kostenlos: begrenzte Nutzung von Agent und Berichten, unbegrenzte Suche im Gesamtbestand, unbegrenzte Zusammenfassungen, unbegrenzter Dialog mit Artikeln, für die man Volltextzugriff hat, Quellenansicht und Import aus einem Literaturverwalter. Pro kostet 49 je Nutzer und Monat, jährlich 588 bei 35% Ersparnis, und ergänzt einen Workflow für systematische Übersichten mit 5,000 gescreenten Arbeiten, Tabellen mit 20 Spalten, 135 Datenquellen und API-Zugang. Scale liegt bei 169 im Monat mit Echtzeit-Zusammenarbeit und 200 Datenquellen. Enterprise wird individuell angeboten, trainiert standardmäßig nicht mit Kundendaten und unterstützt Single Sign-on und SAML.
Für wen es passt
Drei Gruppen. Forschende, die Literatur- und systematische Übersichten schreiben, für die Screening, Extraktion und die PRISMA-2020-Berichterstattung eine offizielle Position haben. Fachleute aus der Industrie, die Belege in Berichte und Folien verwandeln müssen, mit Branchenseiten für Pharmazie, Medizintechnik, Politik und Konsumgüter. Und Vielleser, die ein Feld dauerhaft beobachten wollen, mit der Bibliothek zum Wiederverwenden und Benachrichtigungen zum Abonnieren.
Zwei ehrliche Hinweise. Erstens antwortet die Seite auf reines Skript-Abrufen mit 403, während normales Browsen funktioniert; die Fakten hier stammen von den offiziellen Seiten und der Preistabelle. Zweitens sind die meisten Leistungszahlen eigene Benchmarks und Kundenfälle – die 99.4% Extraktionsgenauigkeit eingeschlossen –, also mit Quellenangabe zitieren und anschließend an der eigenen Aufgabe in kleinem Maßstab prüfen.
Wo die kostenlose Stufe nicht mehr reicht
Liest man die vier Stufen zusammen, zeigt sich, wo das Produkt seinen Wert sieht. Suche, Zusammenfassungen und der Dialog mit frei zugänglichen Artikeln sind selbst im freien Plan unbegrenzt – der Bestand ist der Lockvogel. Abgerechnet wird der Teil, der ein Ergebnis herstellt: der Agent, die Berichte, das Screening Tausender Arbeiten, die breiten Tabellen, die Datenquellen. Die freie Stufe reicht also, um ein Feld zu erkunden, nicht um eine Übersicht fertigzustellen – eine faire Linie für alle, die abwägen, ob das Werkzeug seinen Platz verdient.
Und zur Zitatgenauigkeit ein klarer Punkt: Ein Link auf Satzebene zeigt, dass eine Aussage zurückverfolgbar ist, nicht dass die Studie dahinter gut war. Design, Verzerrung und Relevanz zu beurteilen bleibt Sache der Prüfenden – weshalb die Transparenzzusage auf Überprüfbarkeit zielt und nicht auf Richtigkeit.
Wenn Zitate bis zum Satz reichen, sieht eine KI-geschriebene Übersicht endlich so aus, als ließe sie sich Zeile für Zeile prüfen.