
ElevenLabs im Test: Sprachsynthese und Stimmklon, beginnend mit zehn freien Minuten
Zusammenfassung
ElevenLabs öffnet über 11000 Stimmen, synthetisiert Sprache in mehr als 29 Sprachen, antwortet mit Flash v2.5 in rund 75 Millisekunden und klont eine Stimme aus ein bis fünf Minuten Material. Die kostenlose Stufe gibt 10000 Zeichen im Monat, ohne gewerbliche Lizenz.
Empfehlen- Name
- ElevenLabs
- Version
- 2.5
- Open Source
- Proprietär
- Betriebssystem
- Web
- Webseite
- https://elevenlabs.io/
- Aktualisiert
- 2026-10-06 17:54
Wer Podcasts, Hörbücher oder Videokommentare macht, landet irgendwann bei derselben Rechnung: selbst sprechen oder jemanden engagieren, beides ist nicht billig. Kommt eine mehrsprachige Fassung dazu, vervielfacht sich der Aufwand erneut. Genau diese Stelle zielt ElevenLabs an — Text hineingeben, eine brauchbare menschliche Stimme zurückbekommen und eine bestimmte Stimme kopieren, um sie wiederverwenden zu können.
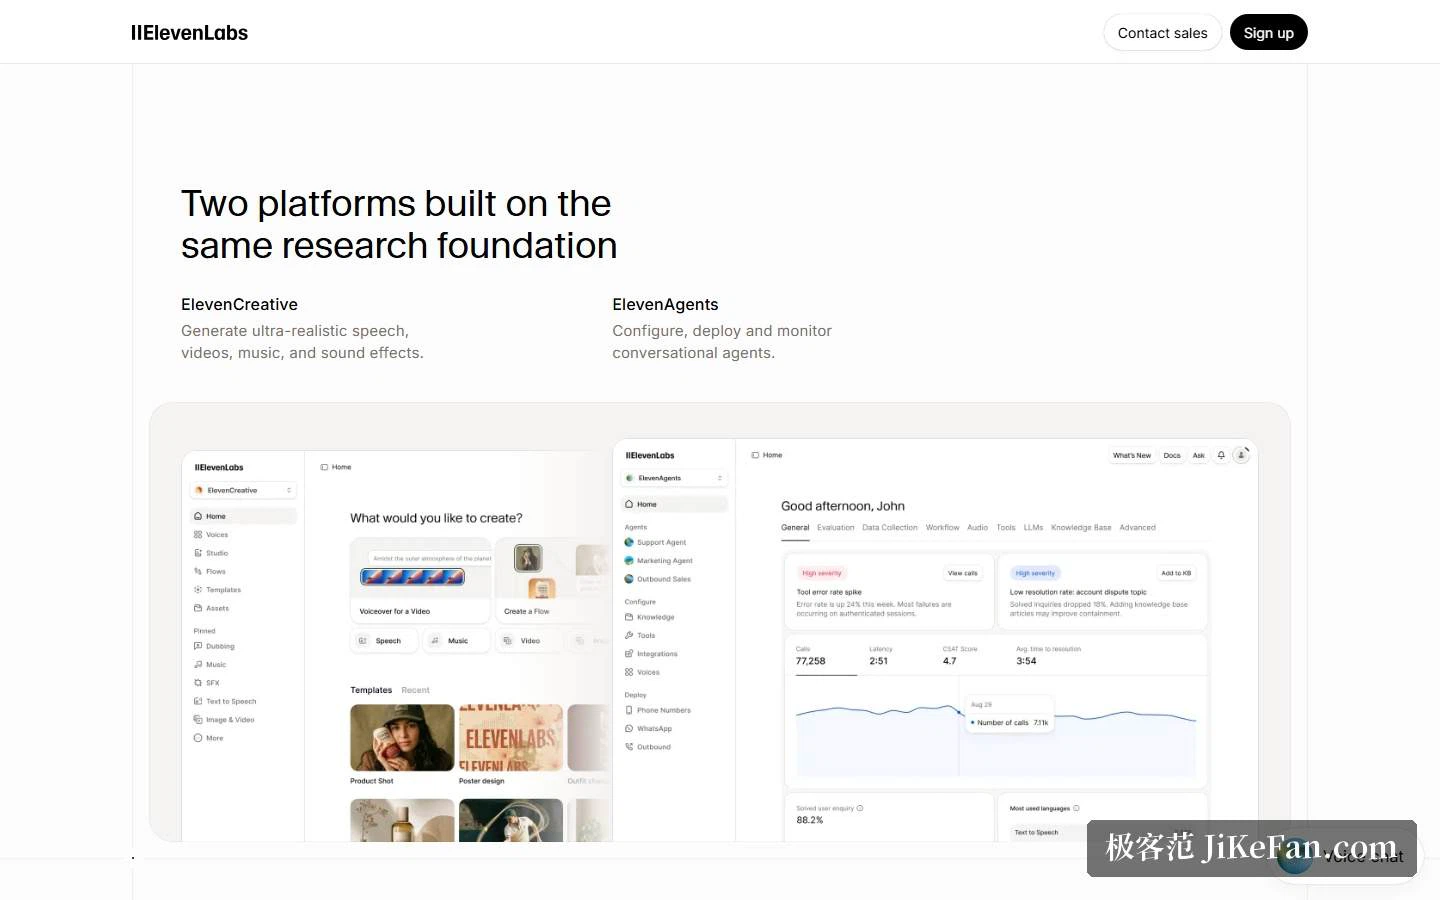
Die offizielle Seite teilt das Produkt in drei Linien: ElevenCreative für die Inhaltsarbeit mit Sprache, Musik, Klangeffekten, Bild und Video; ElevenAgents für dialogfähige Agenten über mehr als 70 Sprachen; und ElevenAPI, die dieselben Fähigkeiten für Entwickler öffnet. Alle drei teilen dieselben Modelle im Unterbau, nur der Einstieg unterscheidet sich.
Eine Inhaltskette, die die arbeitsreichen Schritte abdeckt
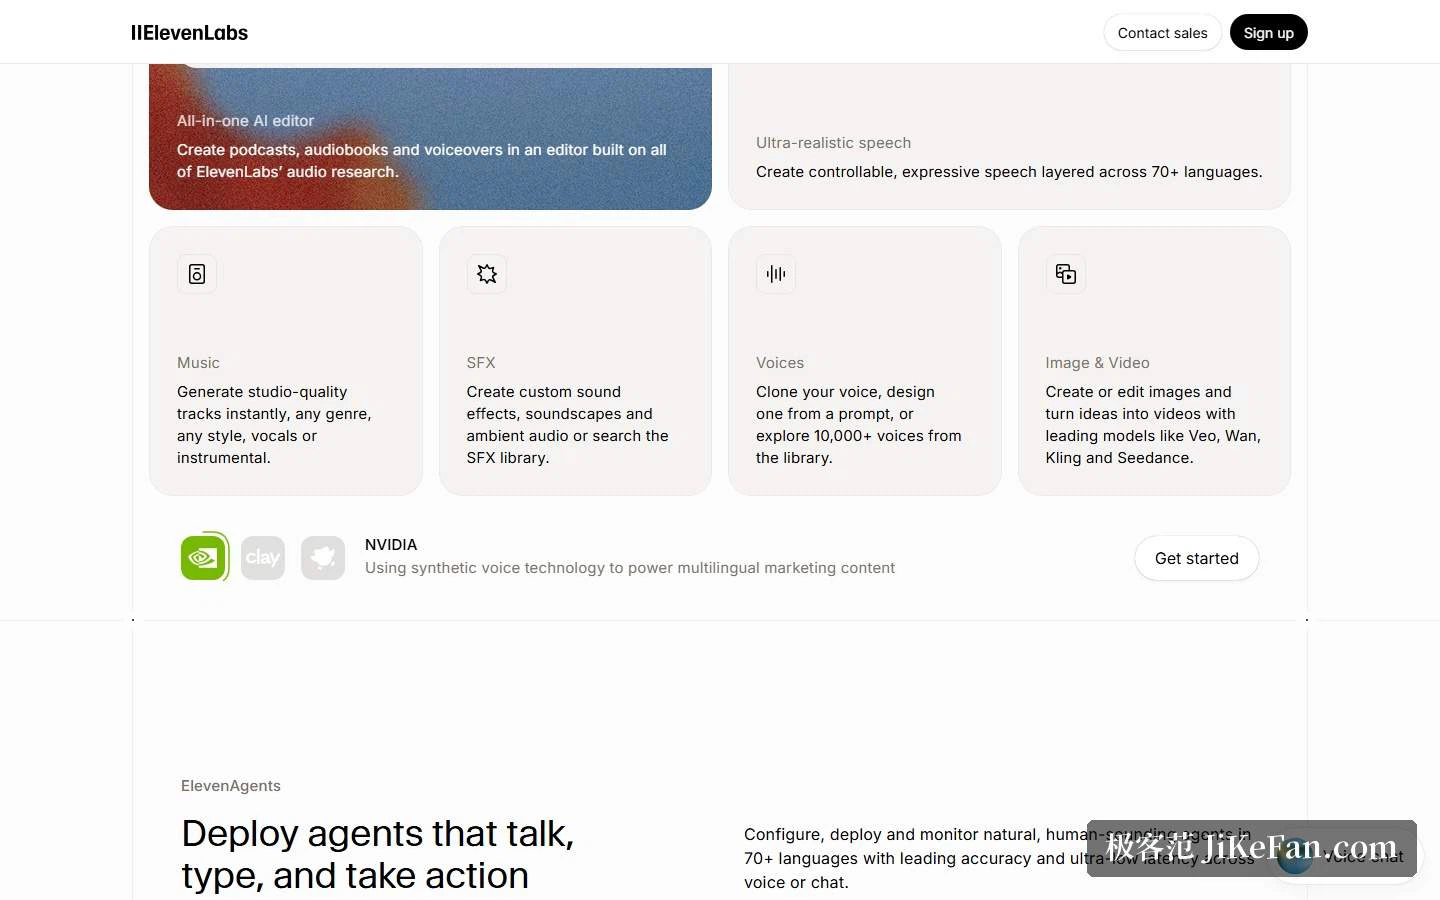
Aufgefächert umfasst ElevenCreative Text zu Sprache, Spracherkennung, Klangerzeugung, Musikerzeugung, Stimmdesign und Synchronisation, dazu Bild und Video. Die Beschreibung ist nüchtern: Vom Podcast über das Hörbuch bis zum Kommentar lässt sich alles in einem Editor erledigen, ohne zwischen Kabine, Schnittprogramm und Materialbörse zu pendeln.
Modellwahl: Latenz und Qualität sind zwei Wege
Die Seite zur Sprachsynthese liefert eine wirklich nützliche Gegenüberstellung: Jedes Modell bedient mehr als 29 Sprachen, der Unterschied liegt darin, welches Ende einem wichtiger ist.
Multilingual v2 deckt 29 Sprachen ab, ohne angegebene Latenz, und passt zu Kommentar, Hörbuch und Postproduktion. Flash v2.5 deckt 32 Sprachen bei etwa 75 Millisekunden ab und ist für Echtzeitfälle gebaut, in denen Tempo zählt. Turbo v2.5 liegt bei etwa 250 bis 300 Millisekunden, balanciert Qualität und Tempo und kostet pro Zeichen 50 Prozent weniger.
Was heißt 75 Millisekunden? Im Gespräch merkt man es deutlich, sobald eine Sprachantwort in die hunderte Millisekunden rutscht: Die andere Seite wartet. Genau dafür gibt es Flash v2.5. Geht es um eine fertige Tonspur, sind ein paar hundert Millisekunden mehr für bessere Textur bei Turbo v2.5 oder Multilingual v2 besser angelegt.
Stimmbibliothek und Klonen
Laut Seite stehen über 11000 Stimmen zur Verfügung. Reicht das nicht, gibt es zwei weitere Wege: Voice Design erzeugt aus einer schriftlichen Beschreibung des Klangbilds eine völlig neue KI-Stimme, das Klonen macht aus vorhandenem Material ein Klangbild, das sich immer wieder aufrufen lässt.
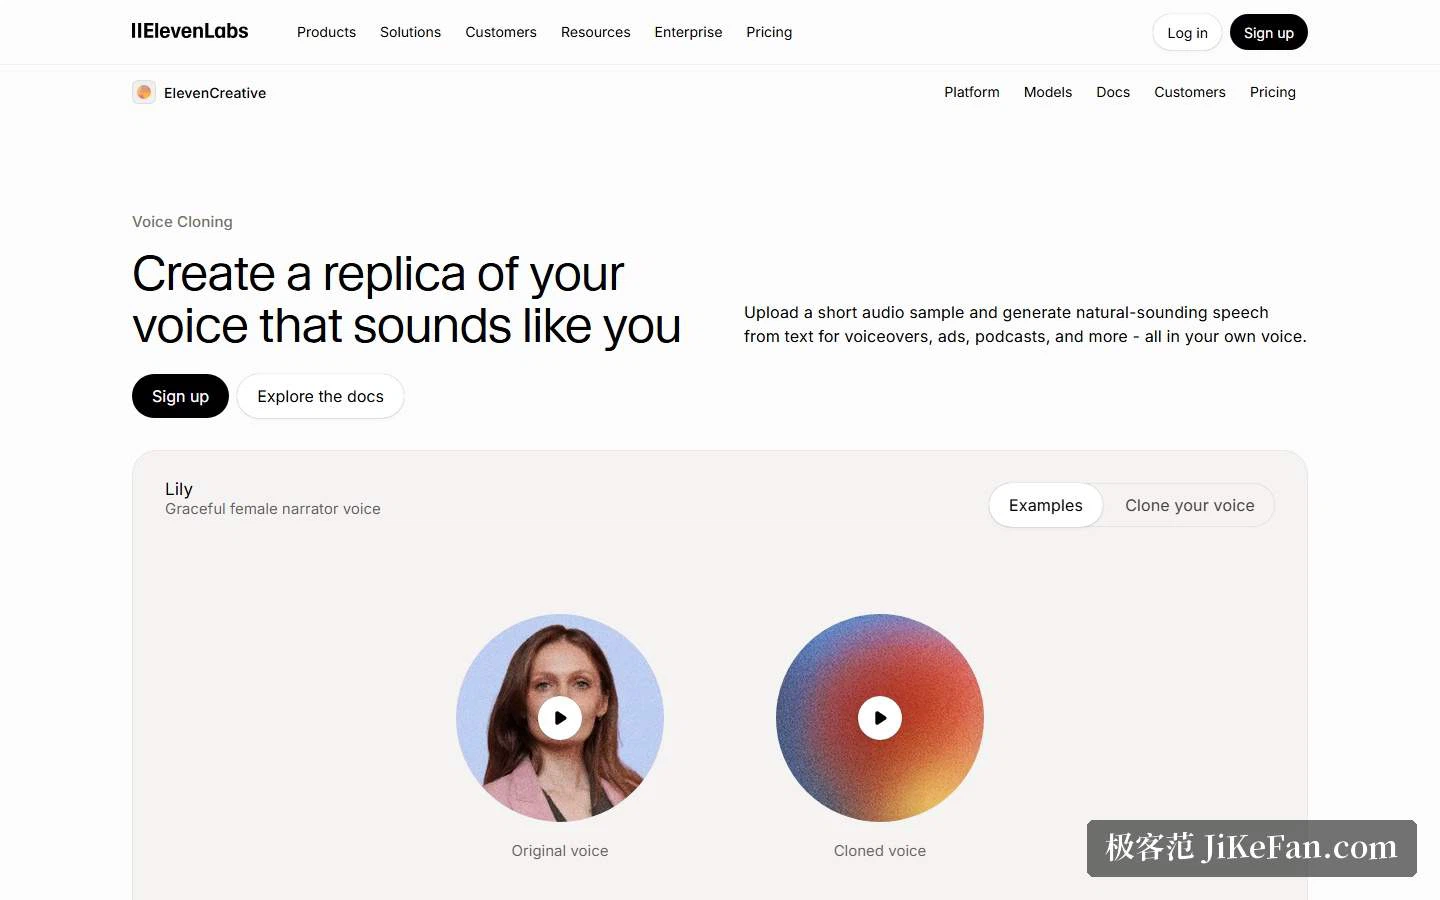
Das Klonen kommt in zwei Stufen. Sofortiges Klonen gibt es ab Starter, professionelles Klonen ab Creator, und letzteres braucht laut Seite eine bis fünf Minuten Audiomaterial. Je mehr Material, desto näher das Ergebnis an der echten Person — ein Kompromiss, der der Intuition folgt.
Synchronisation und Erkennung: die gern übersehene Hälfte
Wer das Ganze nur als Text zu Sprache begreift, verliert die zweite Hälfte. Das Synchronisationsmodell Dubbing v2 deckt mehr als 90 Sprachen und Akzente ab, und die offiziellen Notizen betonen, dass es auf dem Originalton statt auf einem Transkript konditioniert: Tonfall, Emotion und Rhythmus der Quelle wandern mit in die Zielsprache, nicht nur die wörtliche Bedeutung. Für Teams, die Kurse, Interviews oder Werbefilme mehrsprachig brauchen, spart dieser Schritt die gesamten Kosten einer Neusynchronisation.
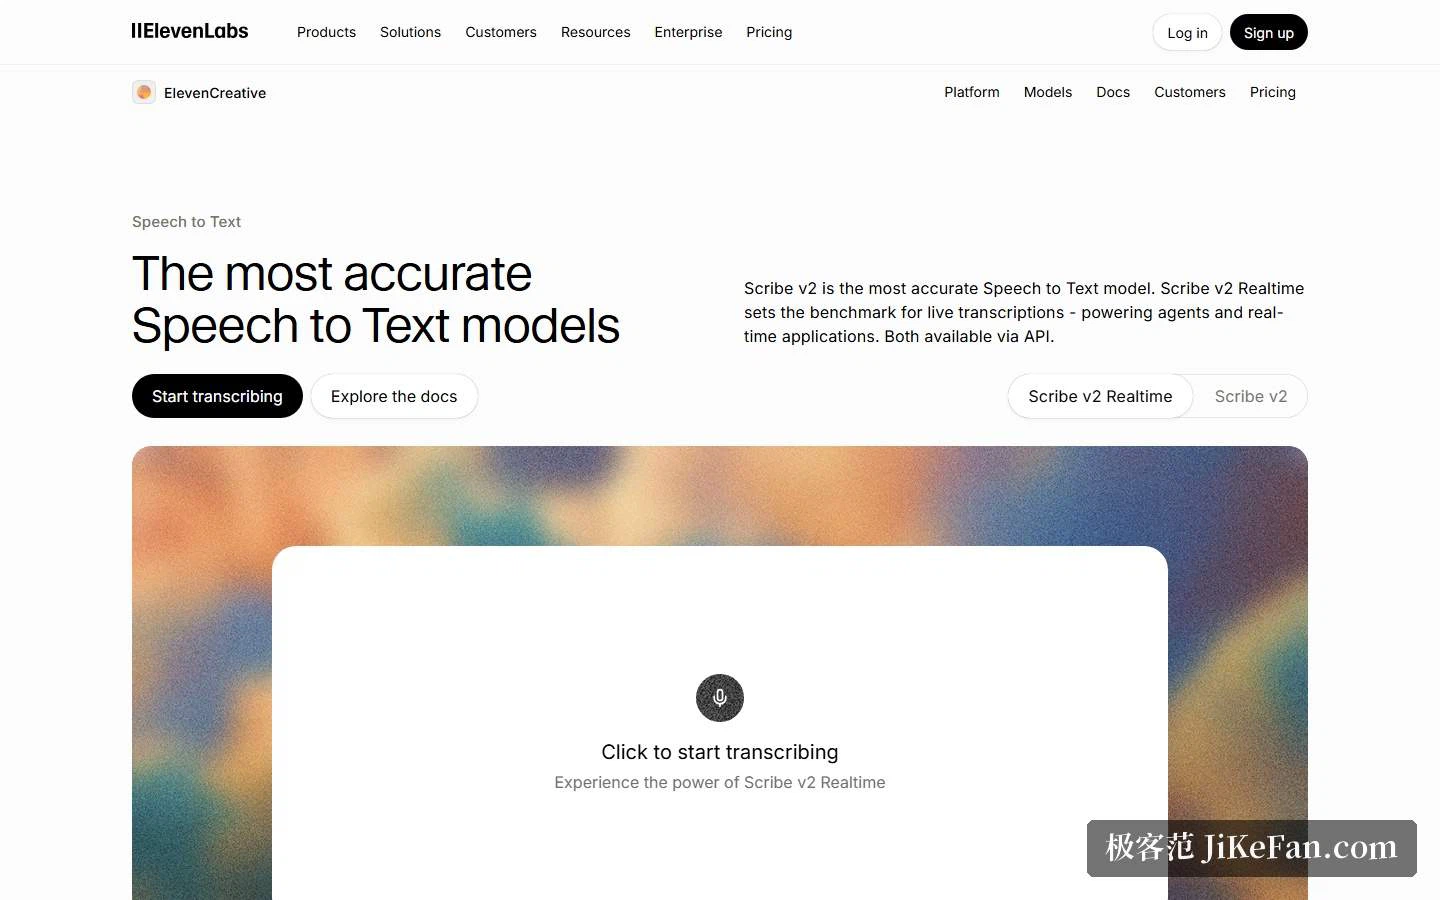
Bei der Erkennung transkribiert Scribe v2 Realtime mit unter 150 Millisekunden Latenz über mehr als 90 Sprachen. Die Position ist klar: Agenten und Besprechungen, die sofort verstehen müssen, statt einer Offline-Transkription, die eine Datei hochlädt und Minuten später ein Ergebnis abholt.
Dialogfähige Agenten: erst echt, wenn sie bestehende Systeme erreichen
ElevenAgents verdient einen eigenen Absatz. Laut Seite sprechen Agenten per Stimme oder Chat mit Kunden, über mehr als 70 Sprachen, mit Erkennung und Wechsel der Sprache in Echtzeit. Wichtiger ist die Kanalliste: Telefon, Chat, E-Mail und WhatsApp werden unterstützt, und Agenten lassen sich mit CRM, Helpdesk, Kalender, Zahlungs- und Telefoniediensten verbinden. Kurz: Die üblichen Systeme für Zahlung, Nachrichten und Support sind im Rahmen.
Für Support- und Betriebsteams hängt die Brauchbarkeit oft weniger am Modell als daran, ob sich das Werkzeug in bestehende Ticket- und Zahlungswege einfügt. Die Seite nennt außerdem, dass sich das Verhalten vor dem Einsatz in simulierten Gesprächen prüfen lässt und sich Compliance-Leitplanken nach einer SOP setzen lassen — zwei Punkte, die für die Freigabe vor dem Start mehr zählen als für die Demo.
Preis: erst die kostenlosen zehn Minuten im Monat
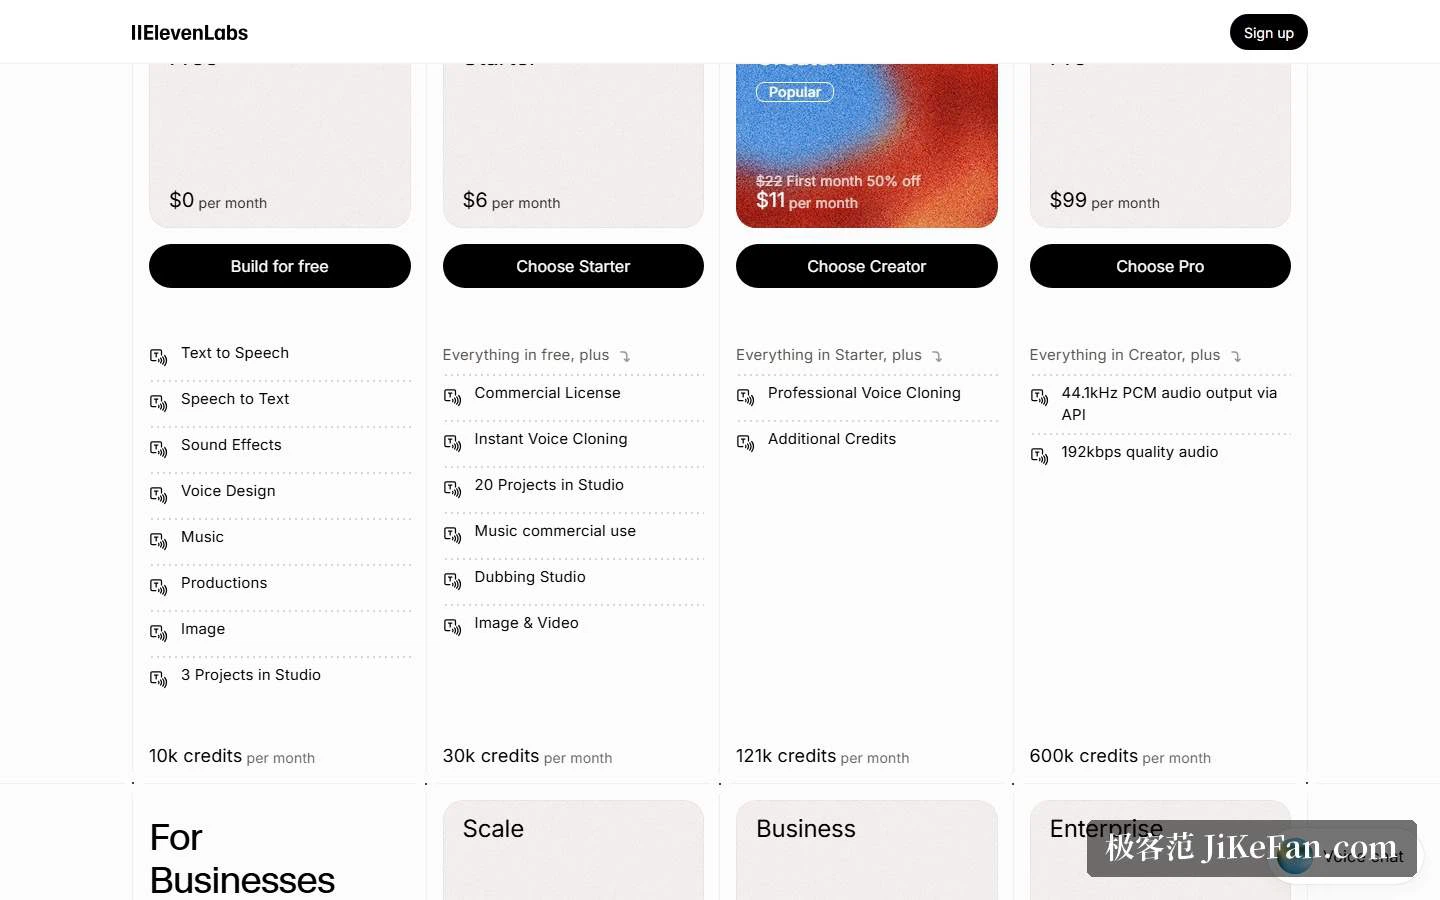
Die kostenlose Stufe gibt 10000 Zeichen im Monat, was die Seite selbst auf etwa 10 Minuten Audio umrechnet — genug, um ein Klangbild und eine Sprache zu prüfen, aber schnell aufgebraucht, sobald echte Inhalte entstehen.
Starter kostet 6 Dollar für 30000 Zeichen und bringt die gewerbliche Lizenz, sofortiges Klonen und ein Synchronstudio. Creator kostet 22 Dollar, im ersten Monat zum halben Preis, für 121 000 Zeichen, professionelles Klonen und nachkaufbare Credits. Pro kostet 99 Dollar für 600000 Zeichen, mit 44.1 kHz PCM und 192kbps Audio. Scale kostet 299 Dollar für 1,8 Millionen Zeichen, drei professionelle Klone und drei Arbeitsbereichsplätze. Business kostet 990 Dollar für 6 Millionen Zeichen, zehn professionelle Klone und latenzarme Sprachsynthese nach Minuten abgerechnet.
Ein Detail geht leicht unter: Die gewerbliche Lizenz beginnt erst bei Starter. Ob Audio aus der kostenlosen Stufe kommerziell genutzt werden darf, sollte man vorher klären — zwei Minuten Lesen sind dafür gut angelegt.
Für wen es passt
Wenn im Ergebnis viel Stimme steckt — Podcast, Hörbuch, Kurskommentar, Produktvideo — oder derselbe Inhalt in mehreren Sprachfassungen gebraucht wird, ist der Gewinn konkret: Statt Kabine zu buchen und Sprecher zu organisieren, baut man eine erste Fassung und entscheidet dann, welche Passagen eine echte Nachaufnahme verdienen.
Manches sollte man vorher klären. Klonen betrifft das Klangbild einer echten Person, also vor dem Nachbauen einer fremden Stimme die Erlaubnis prüfen — das ist eine Rechtsfrage und eine Plattformregel zugleich. Und wo starker emotionaler Ausdruck oder der lokale Klang eines bestimmten Akzents nötig ist, bleibt erzeugtes Audio ein brauchbarer Entwurf, und eine menschliche Nachaufnahme kann nötig bleiben.
Ein Sprachwerkzeug ändert nicht, ob Synchronisation möglich ist, sondern die Rechnung, wie viele Sprachfassungen man macht. Sobald die Grenzkosten der zweiten und der zehnten Sprache gegen null gehen, öffnet sich die Reichweite der Inhalte erst wirklich.