
CogVideoX lokal betreiben: Code und 2B-Gewichte unter Apache 2.0
Zusammenfassung
CogVideoX ist die Open-Source-Fassung des Modells hinter QingYing. Fünf Checkpoints reichen von 720 mal 480 bis 1360 mal 768, der Speicherbedarf fällt mit INT8 von 18GB auf 3.6GB, und die 2B-Gewichte teilen die Apache-2.0-Lizenz des Codes.
Empfehlen- Name
- CogVideoX
- Version
- 2
- Preis
- Kostenlos
- Open Source
- Open Source
- Betriebssystem
- WindowsLinuxmacOS
- Webseite
- https://github.com/zai-org/CogVideo
- Aktualisiert
- 2026-10-06 18:37
Wer QingYing von Zhipu benutzt hat, weiß vielleicht nicht, dass das Modell dahinter quelloffen ist. Das offizielle Repository sagt es in der Modellbeschreibung deutlich: CogVideoX ist die Open-Source-Fassung des Videogenerierungsmodells, das aus QingYing stammt. Anders gesagt: Für die Fähigkeit, für die man im Browser in einer Warteschlange steht, gibt es eine Entsprechung, die man auf die eigene Maschine holen und laufen lassen kann.
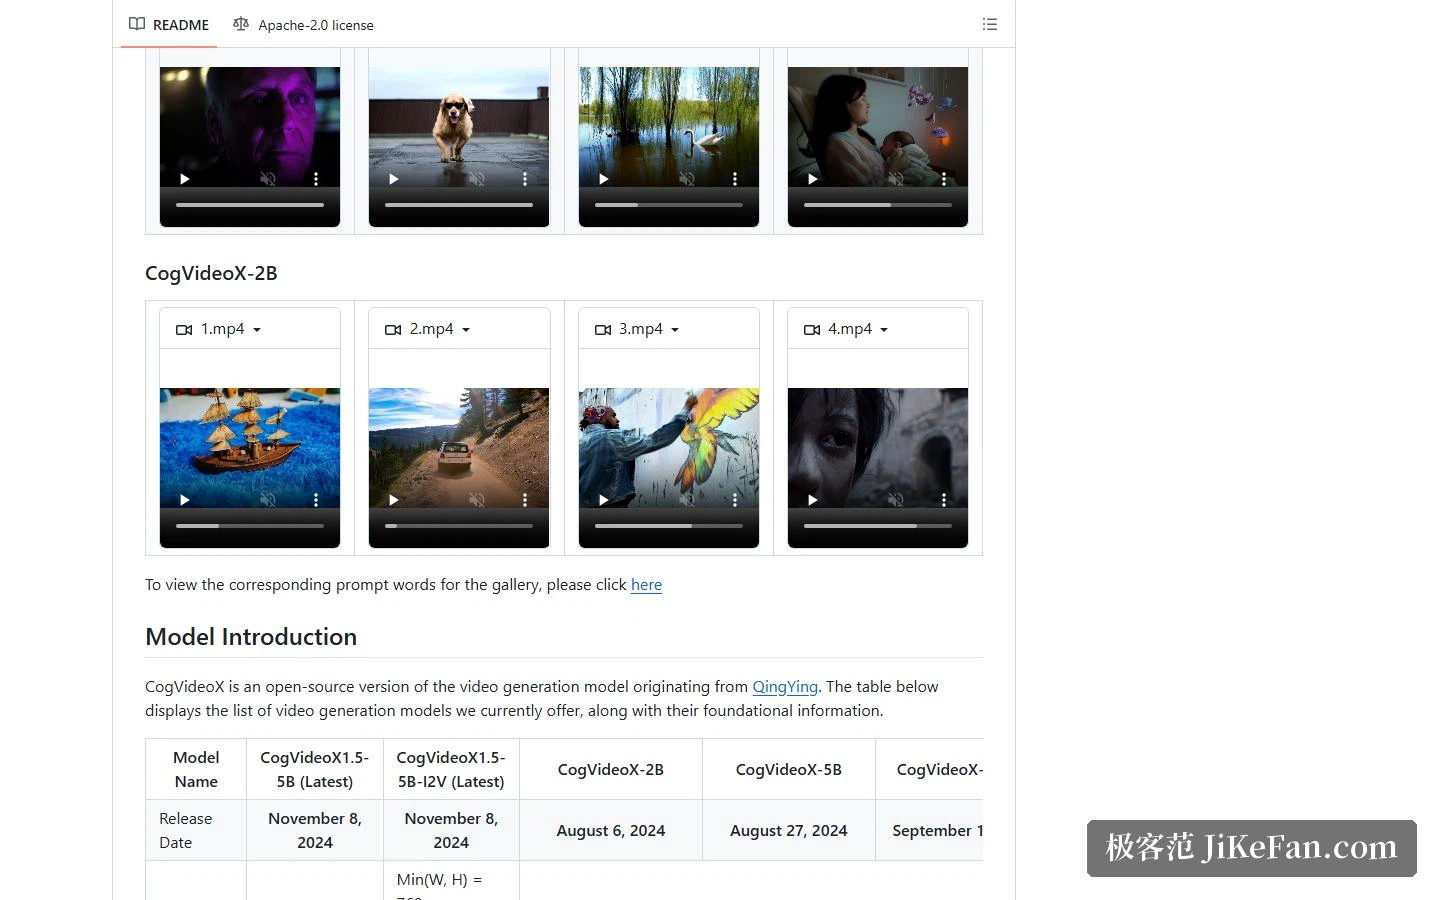
Beides ist nicht dasselbe, und die Seite stellt das Verhältnis oben klar: Für das größere kommerzielle Generierungsmodell geht man zu QingYing und der API-Plattform; dieses Repository bietet die passende Open-Source-Fassung. Die kommerzielle bedient die große Online-Generierung, die quelloffene legt Gewichte und Code in die eigene Hand.
Fünf Checkpoints, und die Werte unterscheiden sich
Die Modelltabelle listet alles, was derzeit angeboten wird: CogVideoX1.5-5B, CogVideoX1.5-5B-I2V, CogVideoX-2B, CogVideoX-5B und CogVideoX-5B-I2V. Das Kürzel I2V steht für Bild zu Video, der Rest für Text zu Video. Der Rhythmus der Veröffentlichungen zeigt die Entwicklung: CogVideoX-2B am 6. August 2024, das 5B am 27. August, das offene Bild-zu-Video-Modell 5B-I2V am 19. September und das Update auf 1.5 am 8. November.
Die Werte trennen die Stufen klar. CogVideoX-2B gibt 720 mal 480 bei 8 Bildern pro Sekunde über 6 Sekunden aus. CogVideoX1.5-5B erreicht 1360 mal 768 bei 16 Bildern pro Sekunde, über 5 oder 10 Sekunden. CogVideoX1.5-5B-I2V hat eine lockerere Regel: Die kürzere Seite nimmt den kleineren Wert aus Breite und Höhe bei 768, die längere liegt zwischen 768 und 1360 und muss durch 16 teilbar sein, und jede Auflösung in diesem Bereich funktioniert. Von 720 mal 480 über 1360 mal 768 bis zu den flexiblen Bild-zu-Video-Verhältnissen sind die gängigen Ausgabeformate weitgehend abgedeckt.
Speicher und Tempo: läuft es auf der eigenen Maschine
Die offiziellen Angaben nennen drei Speicherwerte, alle für CogVideoX-2B: SAT mit FP16 belegt 18GB; unter diffusers mit FP16 liegt die Untergrenze bei 4GB; mit INT8-Quantisierung über torchao geht es auf mindestens 3.6GB herunter. Dieselbe Notiz warnt, dass INT8 kleinere Karten bedienen soll und die Inferenz langsamer macht — umsonst ist das nicht.
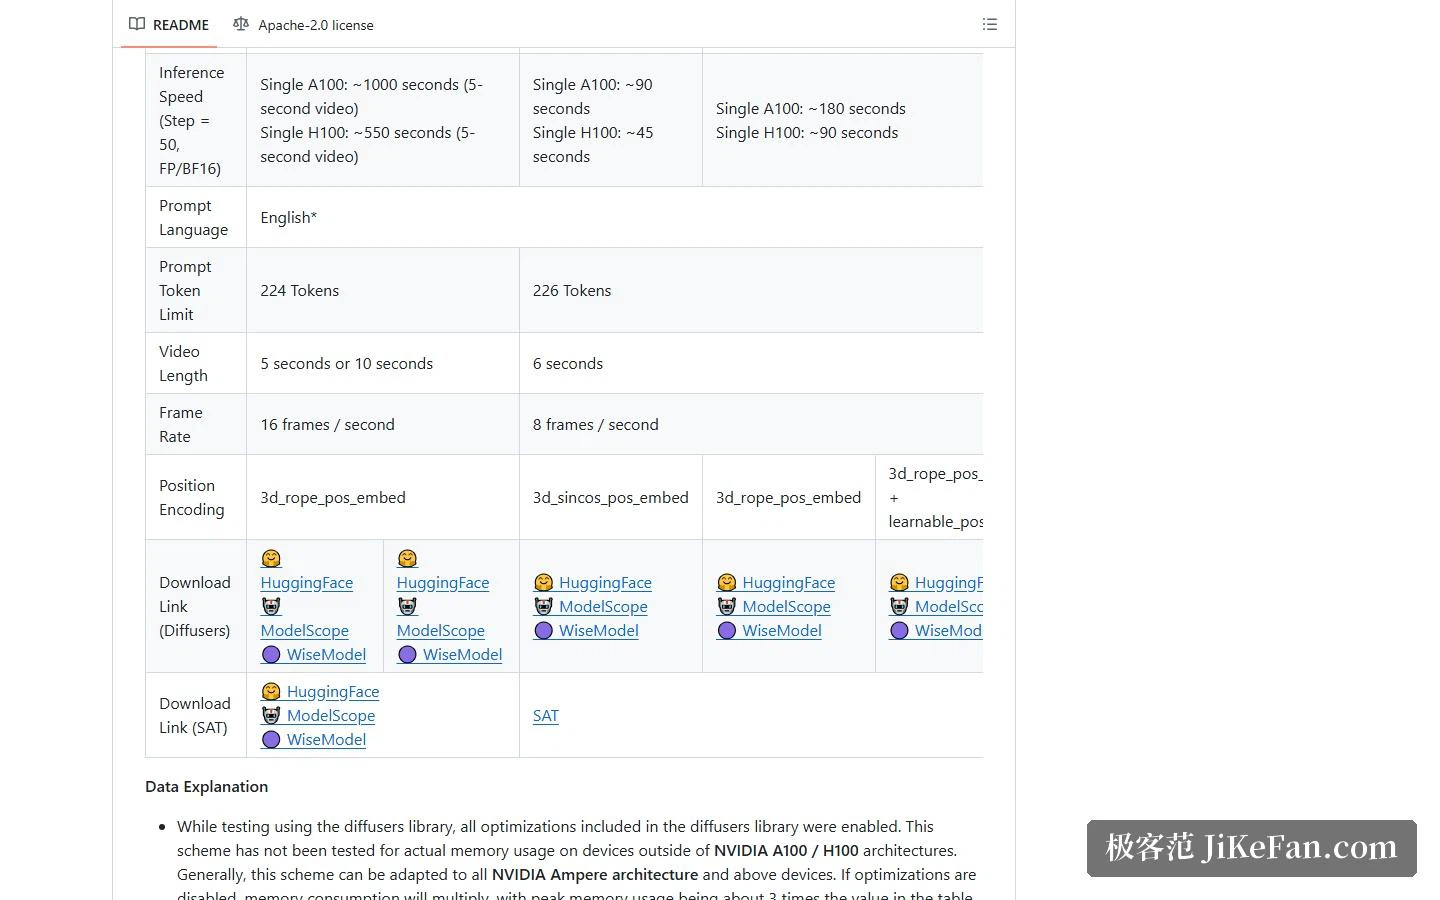
Beim Tempo gelten 50 Schritte bei FP16- oder BF16-Genauigkeit als Messbedingung. CogVideoX-5B braucht etwa 180 Sekunden auf einer einzelnen A100 und etwa 90 Sekunden auf einer H100. Das neuere CogVideoX1.5-5B, das hochauflösende Videos über 5 oder 10 Sekunden liefern muss, braucht unter gleichen Bedingungen etwa 550 Sekunden für einen Clip von 5 Sekunden auf einer H100: mehr Fähigkeit, zum Preis einer deutlich längeren Wartezeit. Die Notiz ergänzt, dass diese Tests alle Optimierungen der diffusers-Bibliothek aktiviert hatten und außerhalb von A100 und H100 kein realer Speicherbedarf geprüft wurde; ohne Optimierungen liegt die Spitze etwa beim Dreifachen der tabellierten Werte.
Zwei Dinge vor dem Start
Erstens die Python-Version. Beide Inferenzwege, SAT und diffusers, nennen dieselbe Bedingung: Python zwischen 3.10 und 3.12, 3.10 und 3.12 eingeschlossen. Das Repository führt zwei Codebasen; SAT enthält Inferenz- und Fine-Tuning-Code für die SAT-Gewichte, die diffusers-Variante beschreibt die gängigen Parameter ausführlicher und eignet sich für einen ersten Lauf vor jeder Änderung.
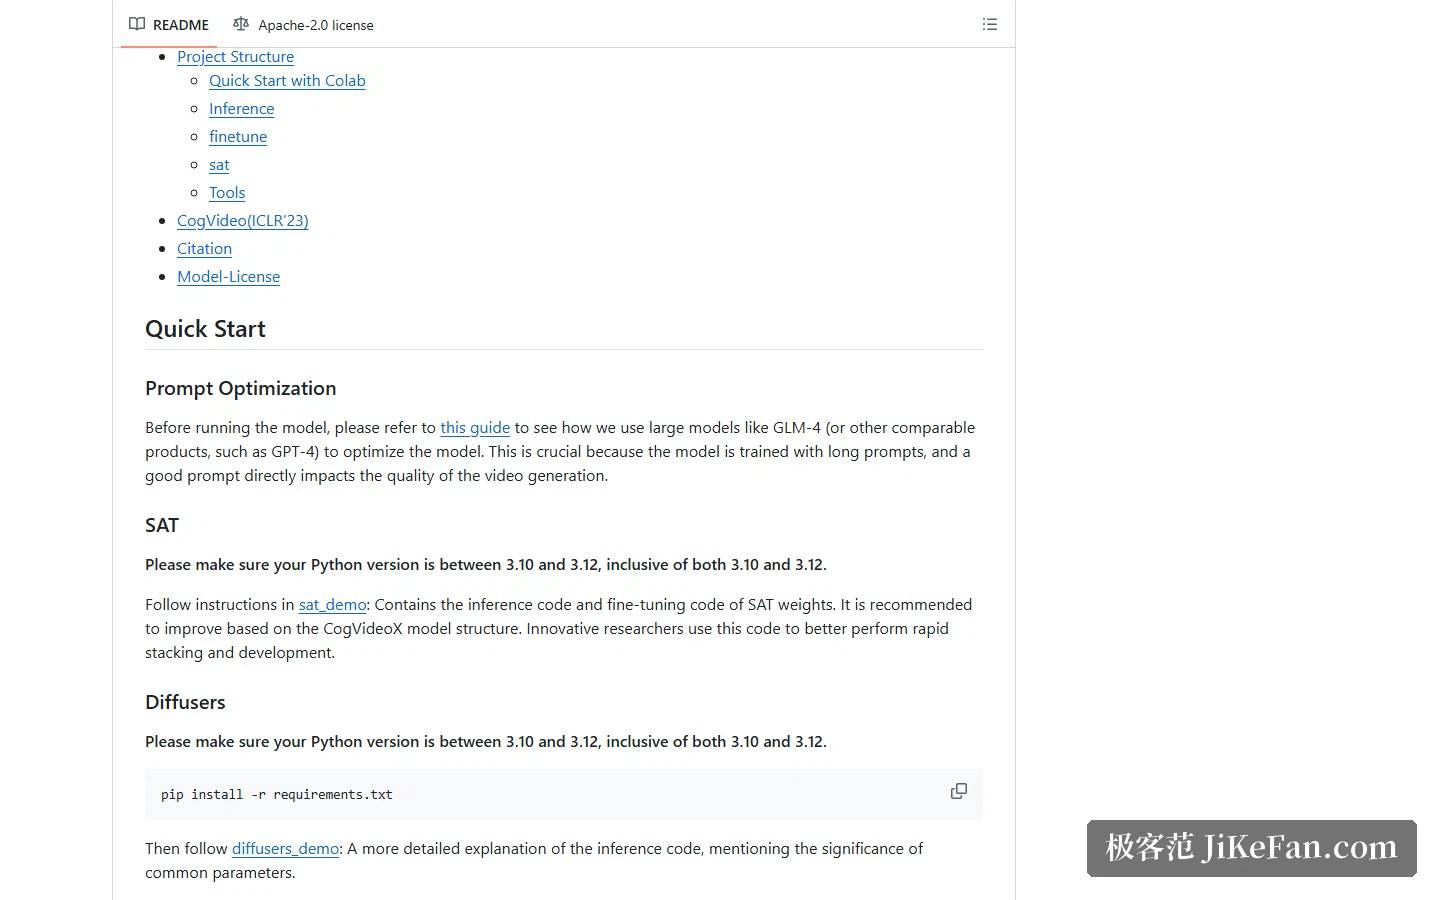
Zweitens die Sprache der Prompts. Das Modell nimmt nur englische Eingaben, andere Sprachen müssen zuerst übersetzt werden. Der Abschnitt zur Prompt-Optimierung empfiehlt, die Eingabe mit GLM-4 oder einem vergleichbaren großen Modell zu dem langen Text auszuarbeiten, den das Modell erwartet — es wurde auf langen Prompts trainiert, und die Qualität des Prompts schlägt direkt aufs Ergebnis durch. Das Repository nennt als Obergrenze 224 bis 226 Token.
Lizenzen: Code und Gewichte sind zwei Fragen
Der Code steht unter Apache 2.0, daran gibt es nichts zu deuteln. Die Modelle muss man einzeln prüfen: CogVideoX-2B samt Transformer- und VAE-Modulen ist ebenfalls Apache 2.0; CogVideoX-5B, also das Transformer-Modul mit I2V und T2V, trägt eine eigene CogVideoX LICENSE. Wenn Lizenzfreiheit in Ihrem Fall zählt, ist die Grenze bei 2B klarer; wer 5B einsetzen will, sollte diese Lizenz vorher bis zum Ende lesen.
Was im Repository liegt
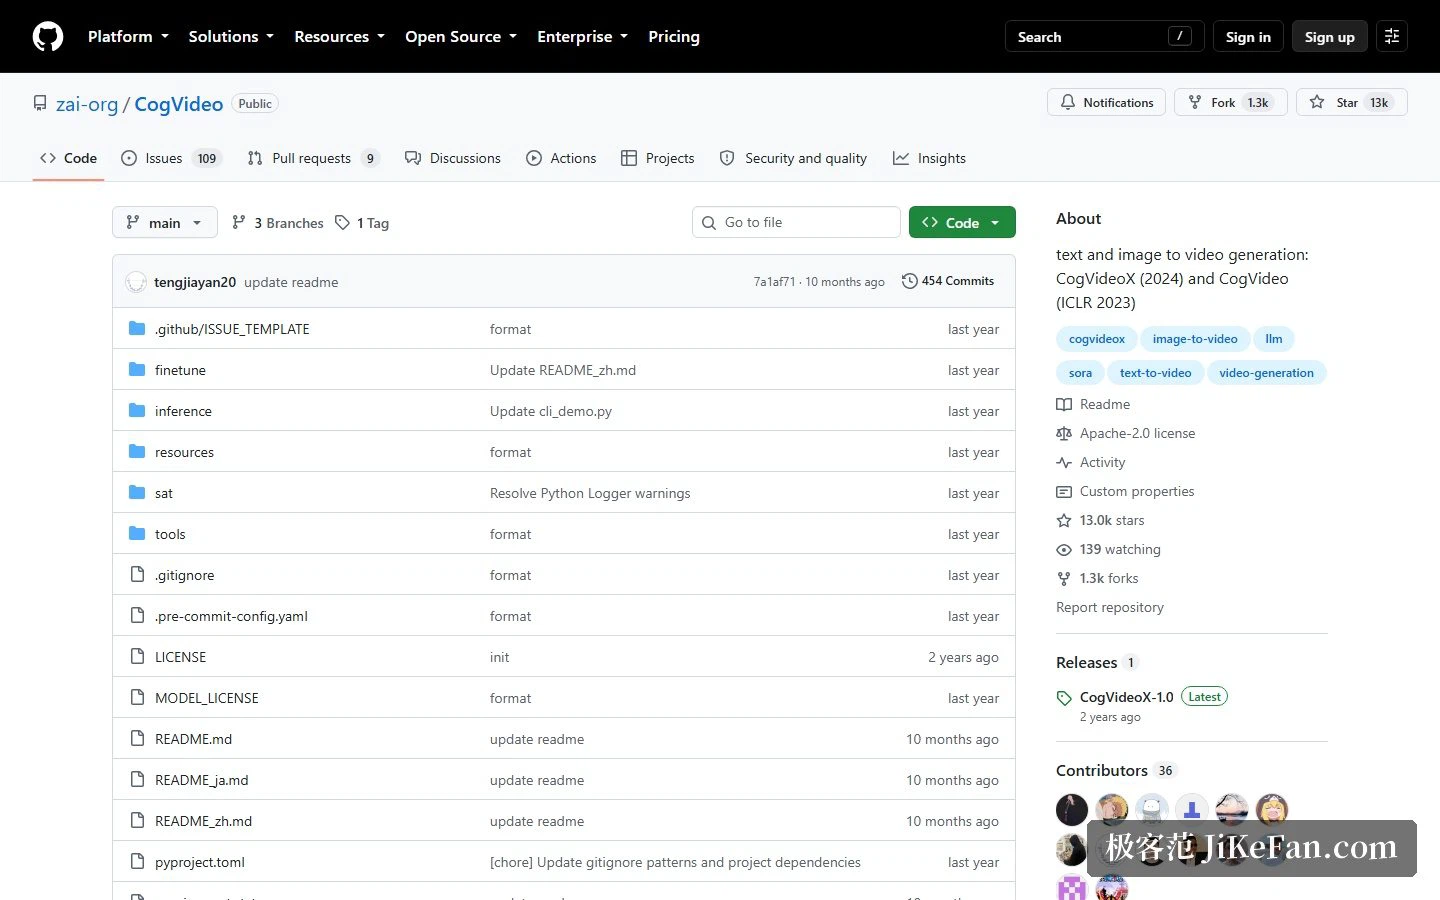
Die oberste Ebene ist schlicht: sat und inference enthalten die beiden Inferenz-Codebasen, finetune das Fine-Tuning, resources die Materialien, tools die Hilfsskripte. Die Lizenzierung ist auf zwei Dateien verteilt, LICENSE für den Code und MODEL_LICENSE für die Gewichte. Das Repository steht derzeit bei 13k Sternen und 1.3k Forks, die eingetragene Version ist CogVideoX-1.0.
Das vergangene Jahr an Updates
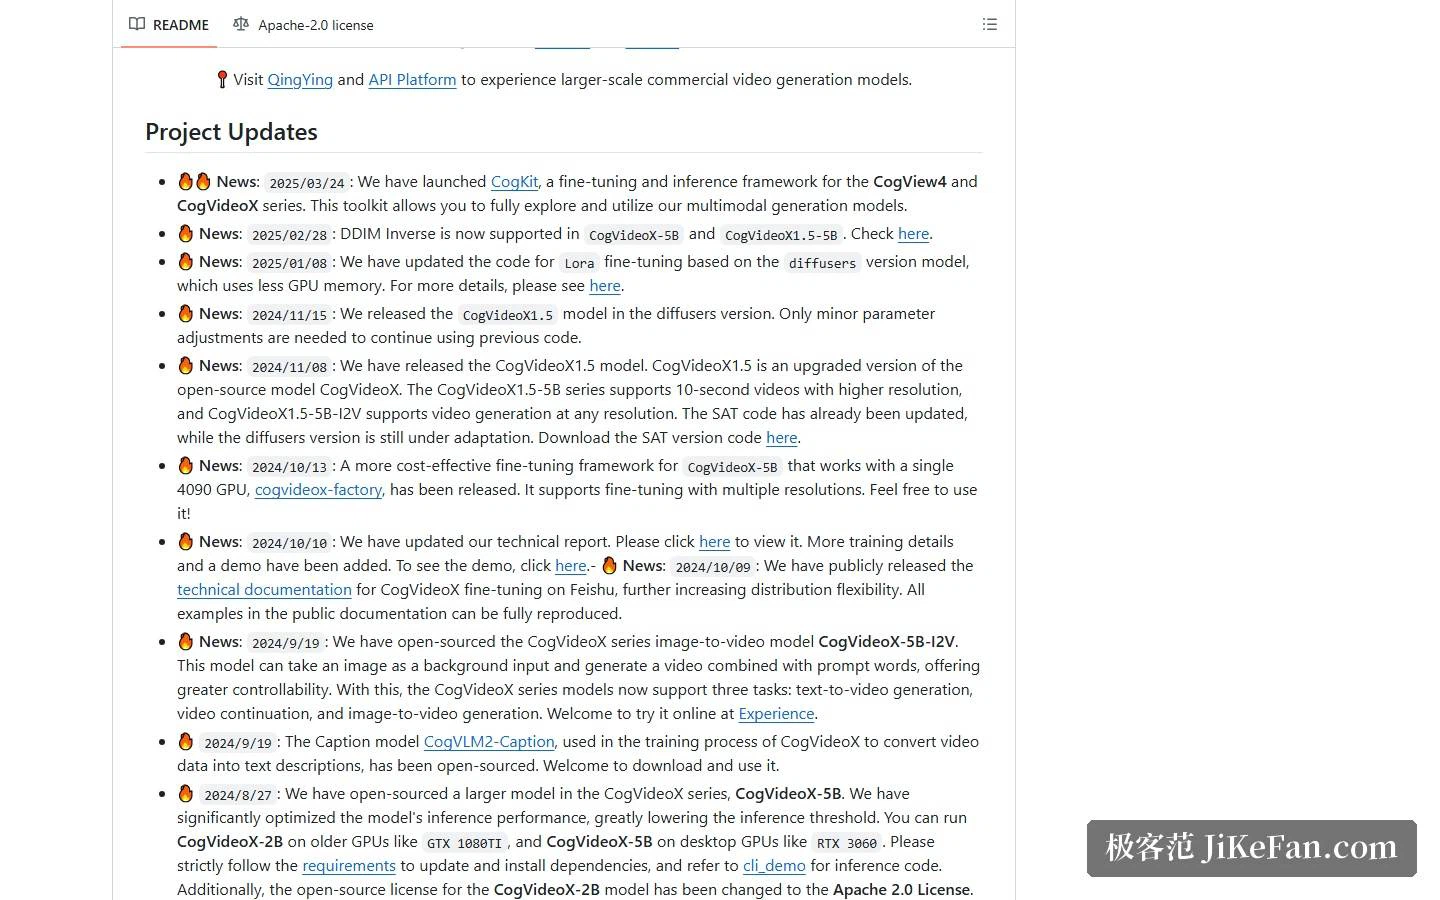
Auch das Änderungsprotokoll zeigt, wie lebendig die Linie ist. März 2025 brachte CogKit, ein Framework für Fine-Tuning und Inferenz der Reihen CogView4 und CogVideoX; Februar ergänzte DDIM-Inverse-Unterstützung für CogVideoX-5B und CogVideoX1.5-5B; Januar aktualisierte den diffusers-basierten LoRA-Fine-Tuning-Code. Weiter zurück erlaubte das im Oktober 2024 veröffentlichte Framework, CogVideoX-5B auf einer einzelnen 4090 zu fine-tunen, und die Notiz ergänzt, dass CogVideoX-2B auf älteren Karten wie der GTX 1080Ti läuft, während 5B einer Desktop-Klasse wie der RTX 3060 entspricht.
Für wen es passt
Wer Videogenerierung in den eigenen Ablauf holen will, ohne sich von Warteschlange, Kontingent oder Inhaltsregeln eines Dienstes leiten zu lassen, bekommt mit CogVideoX einen kontrollierbaren lokalen Weg: offene Gewichte, offener Code, und eine Speichergrenze, die sich auf 3.6GB drücken lässt. Es passt zu Leuten mit GPU und der Geduld, an der Umgebung zu arbeiten — Python-Version, Abhängigkeiten, Quantisierungsgenauigkeit und Prompt-Sprache muss man selbst prüfen.
Umgekehrt ist ein Online-Dienst weniger Mühe, wenn man nur gelegentlich einen Clip erzeugt oder sich nicht mit Umgebungen und Abhängigkeiten beschäftigen will. Lokaler Betrieb spart die Einschränkungen und kostet Zeit plus eine Karte, die das trägt.
Eines sollte man vorher wissen: Das Modell frisst nur englische Prompts. Wer auf Chinesisch denkt, muss den Schritt lösen, eine Idee in eine lange Beschreibung zu übersetzen, die das Modell versteht — und die Qualität dieses Schritts wiegt meist schwerer als der Wechsel auf einen größeren Checkpoint.
Der eigentliche Wert eines offenen Modells ist nicht, jede Fähigkeit eines Online-Dienstes nachzubauen. Er liegt darin, die Generierung zurück auf die eigene Maschine zu holen. Erst prüfen, ob Karte und Umgebung das tragen, dann über Ergebnisse reden.