
Baidu Comate: ein KI-Codierassistent, der im Editor wohnt
Zusammenfassung
Baidu Comate ist ein KI-Codierassistent auf Basis des Sprachmodells von Baidu, als Plugin für gängige IDEs: Vervollständigung, Generierung aus Kommentaren, Unit-Tests, Refactoring-Hinweise, Codeerklärung und technische Fragen.
Empfehlen- Name
- Baidu Comate
- Version
- 20240514
- Preis
- Kostenpflichtig
- Open Source
- Proprietär
- Aktualisiert
- 2026-10-06 08:39
Ein Assistent als Plugin, kein Ziel
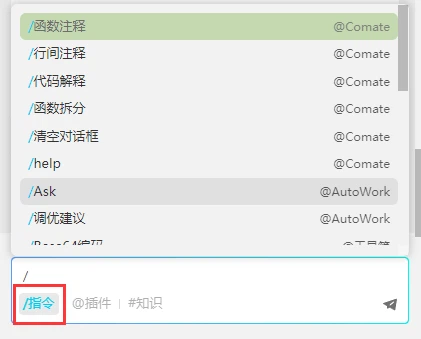
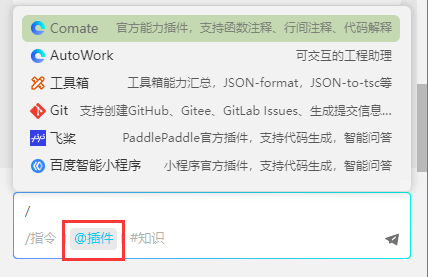
Baidu Comate ist ein KI-Codierassistent auf Basis des eigenen Sprachmodells von Baidu, trainiert sowohl auf öffentlichem Open-Source-Code als auch auf den über Jahre gesammelten Daten des Unternehmens über reale Entwicklungsarbeit. Die entscheidende Entscheidung liegt in der Art der Auslieferung: als Plugin für die integrierten Entwicklungsumgebungen, die ohnehin benutzt werden — Visual Studio Code, IntelliJ IDEA, PyCharm, GoLand, WebStorm, CLion, PhpStorm, Android Studio und weitere — statt als eigene Anwendung mit eigenem Editor.
Diese Wahl ist nicht kosmetisch. Ein Codierassistent ist nur nützlich, wenn er den Kontext sieht, in dem der Code entsteht, und ein eigener Editor muss alles von vorn erzählt bekommen. In der bestehenden Umgebung zu leben bedeutet, dass der Assistent offene Dateien, Projektstruktur und Cursorposition geschenkt bekommt und der Entwickler seine Tastenkürzel, seine Debug-Einrichtung und seine Gewohnheiten behält.
Vervollständigung und Generierung sind zwei Versprechen
Ein solches Werkzeug kann zwei Dinge, die oft verwechselt werden. Vervollständigung schlägt das nächste Token vor, den Rest einer Zeile, den Körper eines gerade geöffneten Blocks: Sie setzt fort, was man schon schreibt, und ihr Wert kommt daher, dass sie die nahe Zukunft richtig errät. Generierung erzeugt eine ganze Funktion aus einer Beschreibung, und ihr Wert kommt daher, dass sie die Absicht richtig versteht.
Beides beruht auf demselben Mechanismus, Vorhersage über ein Kontextfenster, und beides teilt denselben Fehler: Das Modell ist flüssig über Dinge, die es nicht gibt. Eine Vervollständigung, die einen Methodennamen auf einer halb erinnerten Bibliothek erfindet, ist schlechter als keine, weil sie beim Lesen Aufmerksamkeit kostet und beim Testen Zeit. Die Gewohnheit, die solche Werkzeuge lohnend macht, ist nicht, mehr Vorschläge anzunehmen, sondern sie zu lesen.
Erst den Kommentar schreiben
Code aus einem Kommentar zu erzeugen klingt nach einem Kunststück und ist womöglich die disziplinierteste Art, ein solches Modell zu benutzen. Ein Kommentar, der sagt, was eine Funktion tun soll, was sie bekommt und was sie zurückgibt, ist eine Spezifikation im Kleinen; ihn zuerst zu schreiben erzwingt das Nachdenken, das sonst übersprungen wird, und der erzeugte Körper wird ein Entwurf, den man gegen den Satz darüber prüfen kann.
Ein zweiter Vorteil ist leicht zu übersehen: Die Spezifikation überlebt. Spätere Leser bekommen den Satz, der die Absicht erklärt, nicht nur den Code, der sie zufällig umsetzt. Ob der Körper von einem Menschen geschrieben oder von einem Modell vorgeschlagen wurde, ist weit weniger wichtig, als ob der Satz darüber stimmt.
Unit-Tests sind das bestmögliche Ziel
Von allem, was diese Werkzeugklasse produziert, sind Tests am besten verteidigbar. Der Grund ist strukturell und nicht technisch: Ein Test ist ausführbar und hat ein Urteil. Eine vorgeschlagene Funktion kann plausibel und falsch sein, und einen Monat lang merkt es niemand; ein vorgeschlagener Test läuft grün oder nicht, und in beiden Fällen hat man in Sekunden etwas gelernt.
Tests für eine einzelne Funktion oder im Stapel über ein Modul erzeugen zu können, verändert die Ökonomie einer Aufgabe, die chronisch übersprungen wird. Tests fallen unter Termindruck zuerst weg, weil sie mühsam sind und ihre Abwesenheit erst viel später sichtbar wird. Ein Werkzeug, das einen ersten Entwurf liefert — die offensichtlichen Fälle, die Grenzen, ein oder zwei absichtlich unbequeme Eingaben —, verwandelt eine Stunde Mühsal in zehn Minuten Prüfung und Ergänzung. Der Prüfteil ist nicht optional: Erzeugte Tests prüfen oft, was der Code tut, statt was er tun soll, und das ist die Beschreibung des Fehlers, sobald der Fehler existiert.
Refactoring-Vorschläge und das Äquivalenzproblem
Das Werkzeug erkennt, was die Branche schlechten Geruch nennt — Funktionen, die zu lang geworden sind, verschachtelte Bedingungen, die sich flach legen ließen — und schlägt eine Umstrukturierung vor, etwa die Aufteilung einer langen Funktion in mehrere mit klaren Namen. Als Art, die Form eines Problems zu sehen, ist das wirklich nützlich: Eine lange Funktion ist gerade deshalb schwer zu lesen, weil ihre Teile keine Namen haben.
Das Risiko sollte man klar benennen. Ein Refactoring ist nur dann korrekt, wenn das Verhalten unverändert bleibt, und ein Modell kann das nicht garantieren. Es kann Code produzieren, der sich wunderbar liest und einen Randfall subtil verändert, besonders bei der Fehlerbehandlung, bei Nullwerten und in der Reihenfolge von Seiteneffekten. Deshalb ist die Kombination, die funktioniert, Refactoring plus Tests: Mit einer Suite, die laut scheitert, ist eine Umstrukturierung ein in Sekunden prüfbarer Vorschlag; ohne sie ist sie ein als Aufräumen getarnter Neuschrieb.
Code lesen ist die andere Hälfte der Arbeit
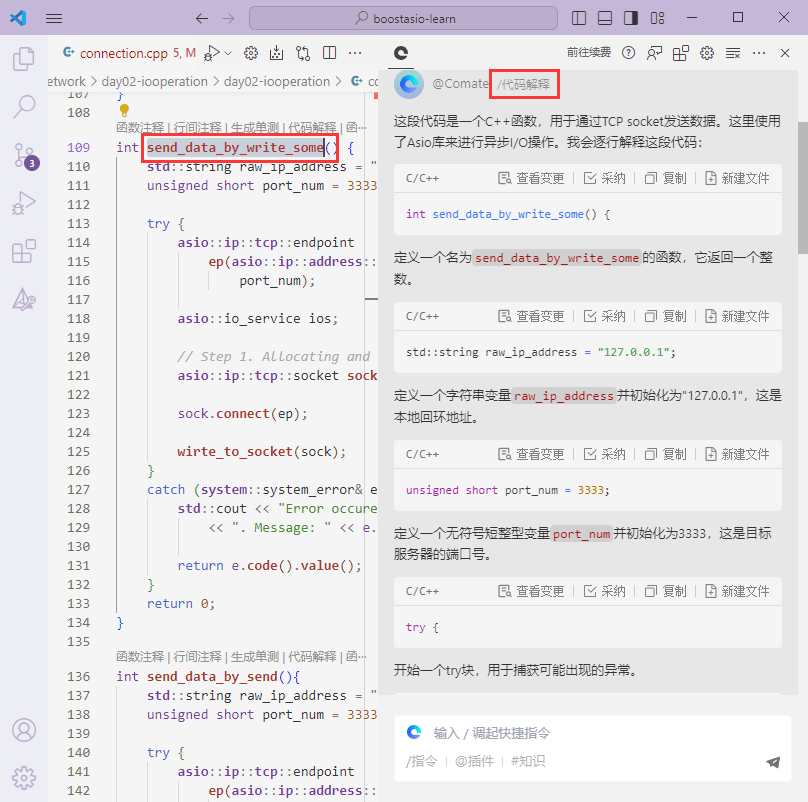
Eine Funktion zu erklären, ganz oder als Auswahl, adressiert einen leicht unterschätzten Kostenpunkt: fremden Code zu verstehen, oder eigenen von vor einem halben Jahr. Die Erklärung ist nicht die Wahrheit über das Programm — sie ist eine Hypothese darüber, und das Programm ist die Wahrheit —, aber eine in gewöhnlicher Sprache geschriebene Hypothese ist genau das, was man braucht, bevor man entscheidet, wo man hinschaut.
Die technische Frage-Antwort funktioniert genauso. Eine Frage zu einer Fehlermeldung oder einer Schnittstelle liefert sofort Lesbares, was eine Verbesserung gegenüber der älteren Schleife aus Suchen, vier Tabs öffnen und Antwort zusammenbauen ist. Die Vorsicht bleibt: Antworten über das Verhalten einer Bibliothek sind die Sorte Antwort, die am selbstsichersten falsch ist, und die Dokumentation bleibt die Instanz.
Sprachbreite ist eine praktische Frage
Unterstützung für weit über hundert Sprachen — im Backend von C, C++, Java, Python, Go, PHP bis Rust, im Frontend von HTML, JavaScript, CSS bis zu den verschiedenen Stil- und Vorlagendialekten, im mobilen Bereich bis Objective-C, Kotlin und Swift — ist keine Werbezeile. Die meisten echten Projekte sind nicht einsprachig: Ein Repository enthält die Anwendung, die Build-Skripte, die Konfiguration, die Datenbankmigrationen und die Dokumentation in vier oder fünf verschiedenen Syntaxen. Ein Assistent, der nur eine davon spricht, ist ein Assistent, der ständig verschwindet.
Die ehrliche Einschränkung: Breite und Tiefe stehen in Konkurrenz. Am stärksten ist die Leistung in den verbreitetsten Sprachen, einfach weil dort die Trainingsdaten am dichtesten sind, und Vorschläge in einem seltenen Dialekt sollte man mit mehr Misstrauen lesen als Vorschläge in Java.
Wohin es passt und was es nicht repariert
Das Werkzeug adressiert die mechanischen Teile des Software-Schreibens: einen ersten Entwurf herstellen, Boilerplate füllen, die Tests schreiben, die niemand schreiben will, Unbekanntes erklären. Es entscheidet nicht, was das Programm tun soll, und es trägt keine Verantwortung für das, was es produziert. Zwei Folgen. Alles Ausgegebene muss geprüft werden, als hätte es ein Fremder geschrieben, denn das hat es; und Code, der von einem Modell kommt, verdient eine Frage, die Code von Kollegen selten bekommt — woher kommt das, und welche Lizenz trägt es. Diese Frage zählt in jeder Organisation, der Herkunft wichtig ist, und sie ist das eine, was ein Assistent nicht für einen beantworten kann.