
-
Ornith 從 9B 到 397B,訓練題目由模型自己出
由 DeepReinforce 推出的 Ornith,把出題、搭鷹架與寫解法都交給模型自己完成,規模涵蓋 9B 到 397B 三檔,以 MIT 授權釋出,支援 256K 上下文與本機部署。
-
不想把對話交給雲端?Octop 把 AI 助手搬回自己機器
騰訊雲開源的自架 AI 助手平台,對話、工作區與金鑰全留在本機,能接進飛書、釘釘等九個訊息平台,一個進程同時扮演控制台與執行環境。
-
Agent 環境不必自己拼:DeepSeek Harness 桌面版能直接開工
DeepSeek 開源的 Agent 執行環境,桌面版把 Node.js 與 Python 一起打包進來,預設四種工作模式、外掛管理頁與軌跡視圖,裝好就能用。
-
模型自己挑、程式碼不出內網:開源助手的三條路
一個開放的外掛,裝進你本來就在用的編輯器,接哪一家模型由你決定:雲端、本機,或公司內網自己架的那一套,設定就寫在一個你手上的檔案裡。
-
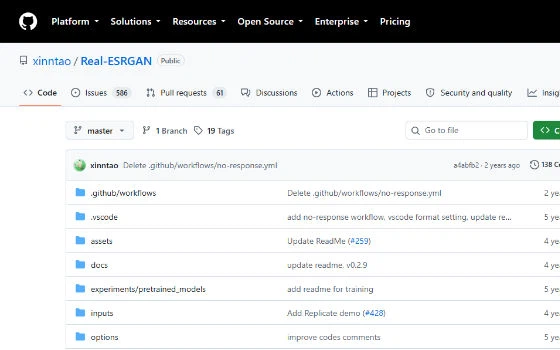
Real-ESRGAN:整排放大工具底下那個演算法
它是一個應用,也是一篇論文與其官方實作:訓練資料全用合成方式產生,授權寬鬆到整排圖形介面產品都把它包進外殼。三條使用路徑,代價各不相同。
-
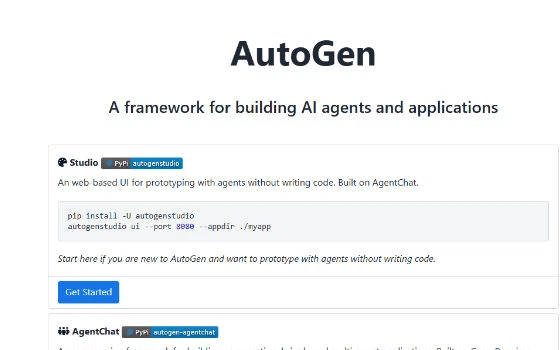
AutoGen 現況:分層清楚的多代理框架,但已停止加新功能
四層按使用深度切開:無程式碼介面、對話層、事件驅動核心與擴充套件。框架已進入維護模式,所以真正該問的是:要從它起步,還是只把它繼續跑下去。
-
OpenClaw:39 萬人給星的自架助理,記憶留在你的硬碟上
一個住進你本來就在用的聊天軟體、把記憶全留在自己硬碟上的助理。專案由非營利基金會持有,沒有付費等級,一個閘道行程就把 29 個頻道接進編碼代理。
-
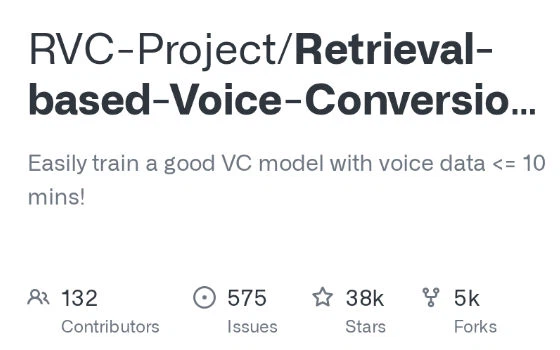
十分鐘語音就能訓練出另一個音色:RVC 的即時變聲與延遲數字
開源的音色轉換與即時變聲框架。官方建議至少準備十分鐘低底噪語音來訓練,端到端延遲可做到 170 毫秒,並同時提供網頁介面與獨立的即時變聲介面。
-
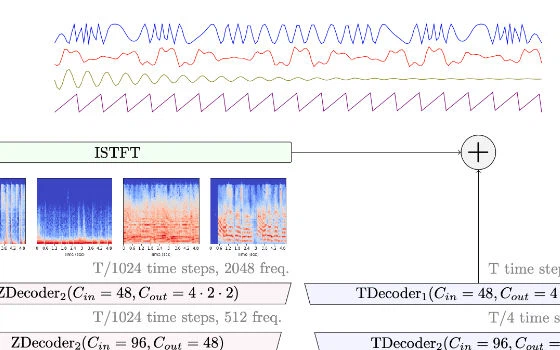
一行指令拆出四條音軌:Demucs 這個開源分離模型
把混好的歌曲拆成鼓、貝斯、人聲與其餘伴奏的開源分離模型。以命令列一行執行,也能從 Python 直接呼叫,程式碼採 MIT 授權。
-
一首歌拆成人聲與伴奏:Ultimate Vocal Remover 裝好就能用
用音源分離模型把歌曲拆成人聲與伴奏的開源工具。官方安裝包把介面、Python、PyTorch 與相依套件一起打包,事前不必準備任何前置條件。
-
把時間戳細到每個詞、還標出是誰在說:WhisperX 補的那兩步
衝著 Whisper 的兩個缺口而來:時間戳只到句子一級,而且本身不支援批次處理。WhisperX 用強制對齊把時間戳細到每個詞,再標出說話者,large-v2 上號稱 70 倍實時。
-
轉寫留在自己的電腦上:Buzz 這款桌面工具實際能做的事
把轉寫從網頁搬回本機的桌面程式,底層是 Whisper。可以吃影音檔與線上連結、用麥克風即時轉寫、分辨不同說話者,結果能輸出純文字與 SRT、VTT 字幕。
-
六種尺寸、一條取捨曲線:Whisper 該按顯示記憶體挑哪一級
一條指令裝好就能跑的離線轉寫工具。同一個模型包辦多語轉寫、翻成英文與語種判斷,官方給出六個尺寸,從約 3900 萬參數一路到約 15.5 億,程式碼與權重皆為 MIT。
-
參數能調到多細:IndexTTS 在本機跑零樣本語音合成
一套裝在自己機器上執行的零樣本語音合成系統。只要一段參考音訊就能複製嗓音,情緒、語速與發音都做成可調參數,權重則走專案自訂的許可協議,而不是通用開源授權。
-
拿到 MIT 的程式碼,卻拿到非商用的權重:F5-TTS 該怎麼讀授權
以流匹配做語音合成的開源專案,提供 pip 套件、命令列推論與 Gradio 網頁介面。程式碼是 MIT,預訓練權重卻因訓練資料的限制只能非商用。
-
第 1 / 4 页