
HeyGen は「誰であるか」と「どう見えるか」を分け、同じアバターを 175 の言語へ
要約
ウェブカメラで 15 秒撮るだけで、背景を変えても服を変えても言語を変えても崩れない演者が手に入る。効いているのは顔の出来ではなく、フレームをまたいで持ち上げ、見た目と切り離して保持する身元の信号だ。
おすすめ- ソフト名
- HeyGen
- バージョン
- 20260916
- オープンソース
- 非オープンソース
- OS
- Web
- 公式サイト
- https://www.heygen.com/
- 更新日時
- 2026-10-06 06:56
出演する映像で本当に時間を食うのは、中身ではなく繰り返しの作業のほうだ。照明を立て、化粧を直し、服を三度着替え、同じ一節をレンズの前でもう一度言う。デジタルヒューマンが省こうとしているのはこの部分で、ここ数年はいつも同じところで止まっていた。一枚の絵は悪くないのに、並べるとばれる。背景を変えると顔が漂い、長く話すと口の動きがずれ、言語が増えると崩れる。
HeyGen はこの分野で比較的速く回っている。いま主力の Avatar V は製品ページでずばりと言う。ウェブカメラで 15 秒撮れば、シーンをまたいで崩れない演者が手に入り、175 を超える言語と方言を話せる、と。見た目がそれらしい人形と、本当に本人である分身の距離は、この一文の二つの言葉に集まる。一貫性と、多言語だ。
判断の物差しは一枚の絵ではない
Avatar V のページは人物の一貫性を最初の能力に置き、言い方も回りくどくない。一貫性が、使える分身と見せかけを分ける線だと書く。定義はこうだ。同じ顔、同じ微細な表情、同じ佇まいが、30 秒のクリップでも 10 分の講座でも成り立ち、漂わず、 アーティファクトも出さず、不気味の谷に落ちない。
この一文の裏で手法が切り替わっている。以前は一枚の写真から顔を動かす作りで、参考が一コマなら持てる身元の情報もその分だけだった。Avatar V は参考映像の全体のコンテキスト窓で動き、情報量の多い瞬間をモデル自身に選ばせる。
身元を外見から切り離す
公式の説明はこうだ。新しいモデルは「あなたが誰か」と「あなたがどう見えるか」を二つに分ける。学ぶのは、あなたがどう動き、どう身振りをし、どう感情を表すかという具体的な作法で、その作法はどの版のあなたにも当てられる。使う側から見れば、撮るのは一度だけで、何を着てどこで撮ったかは問題にならない。以後、分身はどんな背景にも、どんな服にも、どんな造型にも現れる。
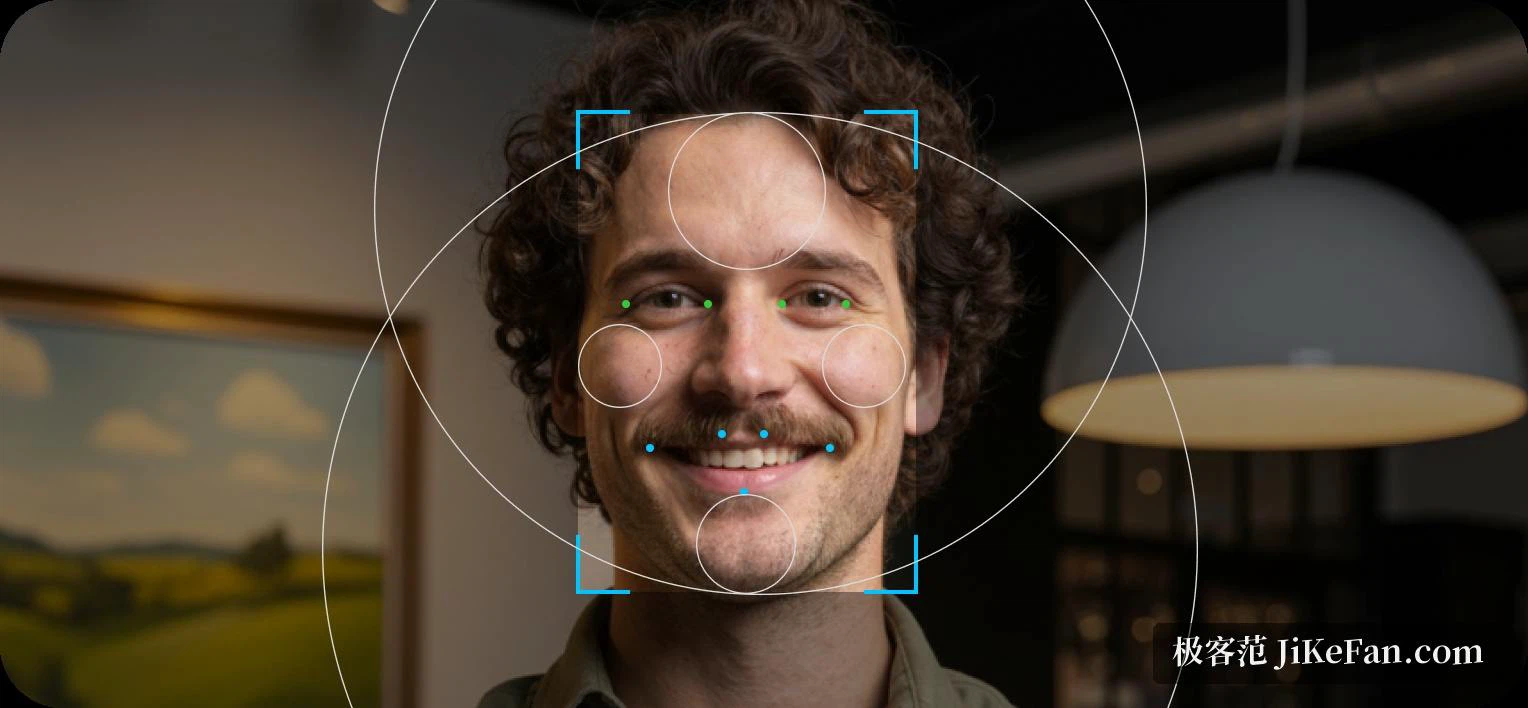
仕組みは選択的な注意だ。口の形、顔の輪郭の構造、表情の移り変わりといった身元の信号を多くのフレームから取り出し、同時に姿勢や照明、遮蔽の悪いフレームを積極的に抑える。こうして束ねた身元の表現はフレームをまたぎ、時間を持つ。狙う問題は身元の漂流と呼ばれる現象で、一コマ条件のモデルでは参考の身元と出力がだんだん分かれていく。この手法は、追加の微調整も追加の参考入力もなしに、シーン、カメラ位置、長い尺の上で安定を保つと主張する。
公表された数値では、長い映像で一貫性が 30 分を超えて保たれ、生成時に尺や画質の上限は設けない。訓練は三段階で説明される。まず同じシーンの中で顔の見た目を忠実に写すことを学び、次にシーンをまたぐ微調整で背景、照明、姿勢の分布の違いを吸収し、最後に人間の好みを報酬にした強化学習で身元の類似度を押し上げる。
Video Agent:一言で完成品、しかも描画のあとで直せる
分身が解くのは、あなたが画面に出るという問題だ。もう一本の製品ラインは、映像をどこから持ってくるかを解く。Video Agent はプロンプトから完成品を返し、ただ喋る頭を出すだけではないと強調する。動く図形、視覚的な重ね、説明のための動き、B-roll の素材まで物語の中に組み込み、台本、声、画面、転換を同じ生成の中で済ませる。
もっと面白いのは編集できることだ。描画が終わったあとも、文字、位置、色、時間軸、配置はすべて編集でき、AI Studio の中で直接変えられる。一行直すために映像全体を描き直す必要はない。公開前の下見もあり、案をシーンごとに分解し、自然言語でさらに調整できる。この二つがそろって初めて、一度作って気に入らなければやり直すだけの生成器との違いになる。
翻訳が入れ替えるのは声だけではない
多言語はデジタルヒューマンにとって最も自然な延長で、HeyGen が最初に知られた分野でもある。公式の翻訳ページの流れはこうだ。手元の映像を上げるか、ネット上の映像のリンクを貼り、エンジンと訳先の言語を選ぶ。あとは基盤が翻訳、吹き替え、口の合わせを済ませ、撮り直しも手作業の口合わせも要らない。元の話し手の声質、口の動き、表情は保たれる。
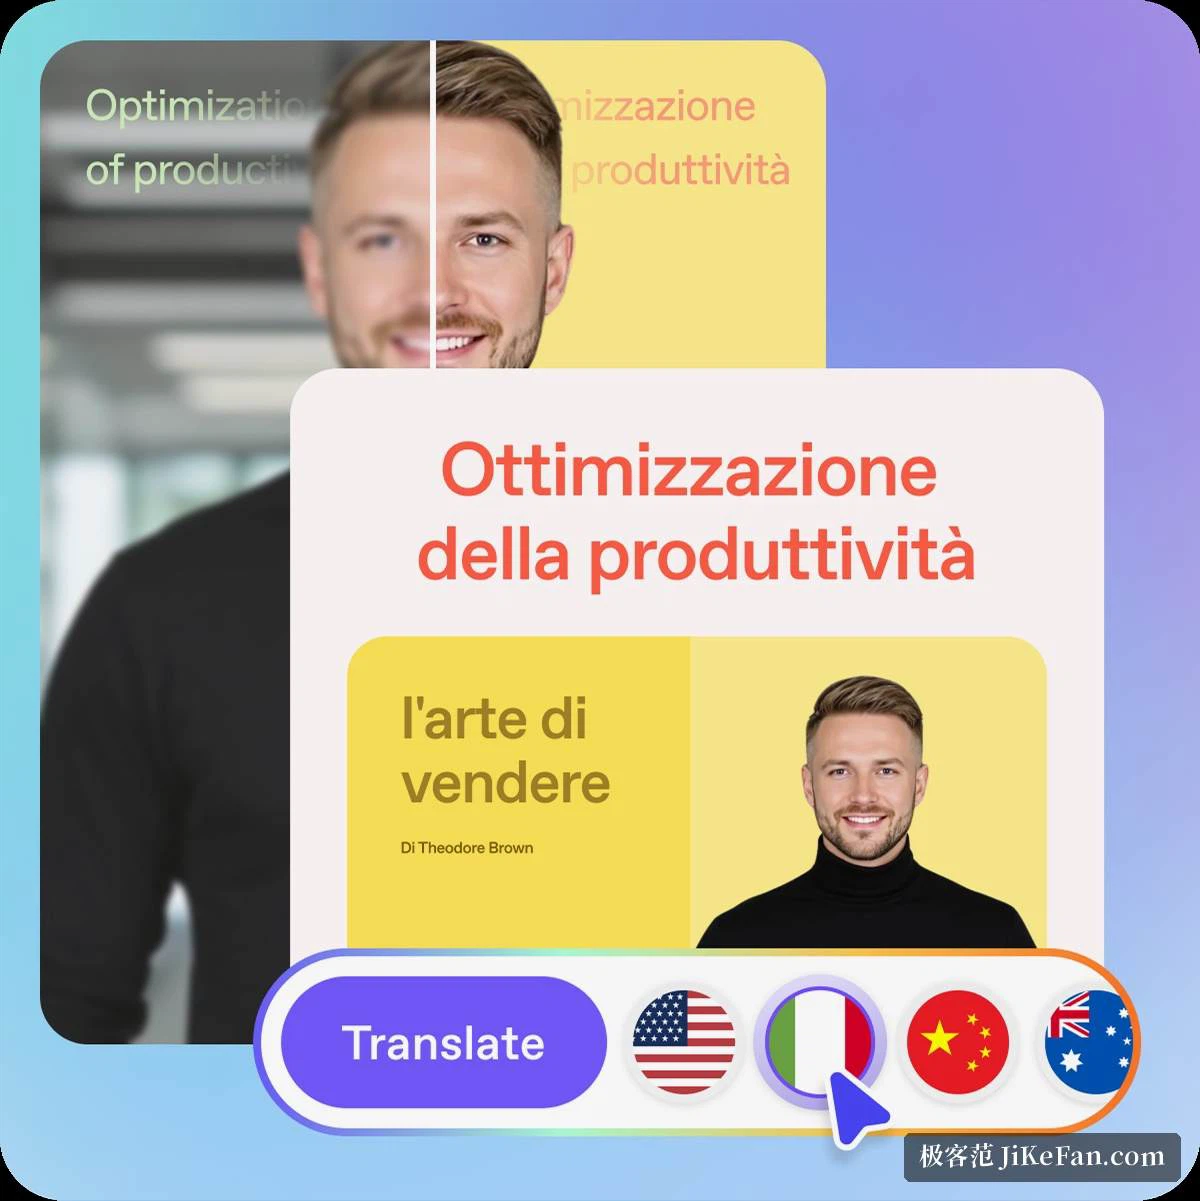
操作で覚えておきたい点が一つある。一度に最大 10 言語まで選べるので、一本の原本から複数言語を並行して出せる。一言語ずつ順番に並べる必要はない。ブランド側の制御も専用の設計があり、強化された用語集は強制翻訳、保護された用語、発音の補正に対応する。用語の集合を作り、訳文を直し、一本の映像から複数の言語版を作れる。映像の集合には多言語のプレーヤーを付けられ、ページや LMS にそのまま埋め込める。
本人確認は後付けではなく前提
この分野は信頼の問題を避けられない。HeyGen は本人確認を作成の最初に置く。自作の分身はすべて、撮影される本人がカメラの前で確認を終えることを求め、確認がなければ分身は作られない。本人からの削除の求めは必ず実行される。内容側は機械学習の走査と人の確認の二段で、暴力、政治運動、未成年への危害を越えてはいけない線として明示する。
各段階で実際に何ができるか
無料の案は月に 3 本、1 本 1 分までで、まず結果を確かめるのに向く。Creator は月 29 ドルからで、1 本の上限を 30 分に広げ、1080p の書き出しと声の複製を加え、言語の範囲も 175 を超える。Pro は月 49 ドルからで、4K の書き出しと処理の速さが主な違い。Business は月 149 ドルからで、自作の分身の数、席の管理、共同作業が増える。チームが大きくなるほど、席とクレジットで組むこの設計は使う量を先に見積もる必要がある。
構造で見れば、HeyGen は分身を作る、完成品を作る、各地の言語に訳すという、もともと別の道具に散らばっていた三つの仕事を一本の流れにまとめた。そこがより完成している部分だ。気をつけたいのは、枠と同時実行が段階で区切られていることで、たくさん出すチームは段を選ぶ前に実際の本数からクレジットの消費を計算しておきたい。
デジタルヒューマンの本当の関門は、一枚の絵が似ているかではなかった。シーンが変わり、尺が変わり、言語が変わったあとでも似ているかどうかだ。Avatar V は身元を外見から切り離して扱うことで一貫性に答え、Video Agent と翻訳が台本から多言語の完成品までの道を埋める。