
CogVideoX を手元で動かす:コードと 2B の重みは Apache 2.0
要約
CogVideoX は清影の背後にあるモデルのオープンソース版だ。五つのモデルは 720×480 から 1360×768 までをカバーし、必要メモリは INT8 で 18GB から 3.6GB まで下がる。2B の重みはコードと同じ Apache 2.0。
おすすめ- ソフト名
- CogVideoX
- バージョン
- 2
- 料金
- 無料
- オープンソース
- オープンソース
- OS
- WindowsLinuxmacOS
- 更新日時
- 2026-10-06 18:37
智譜の清影を使ったことがある人でも、その背後にあるモデルがオープンソースだと知らないことがある。CogVideoX の公式リポジトリはモデルの説明で率直に書いている。CogVideoX は清影(QingYing)に由来する映像生成モデルのオープンソース版だ、と。つまり、ウェブで順番待ちしているあの能力には、手元に持ってきて自分で動かせる対応版がある。
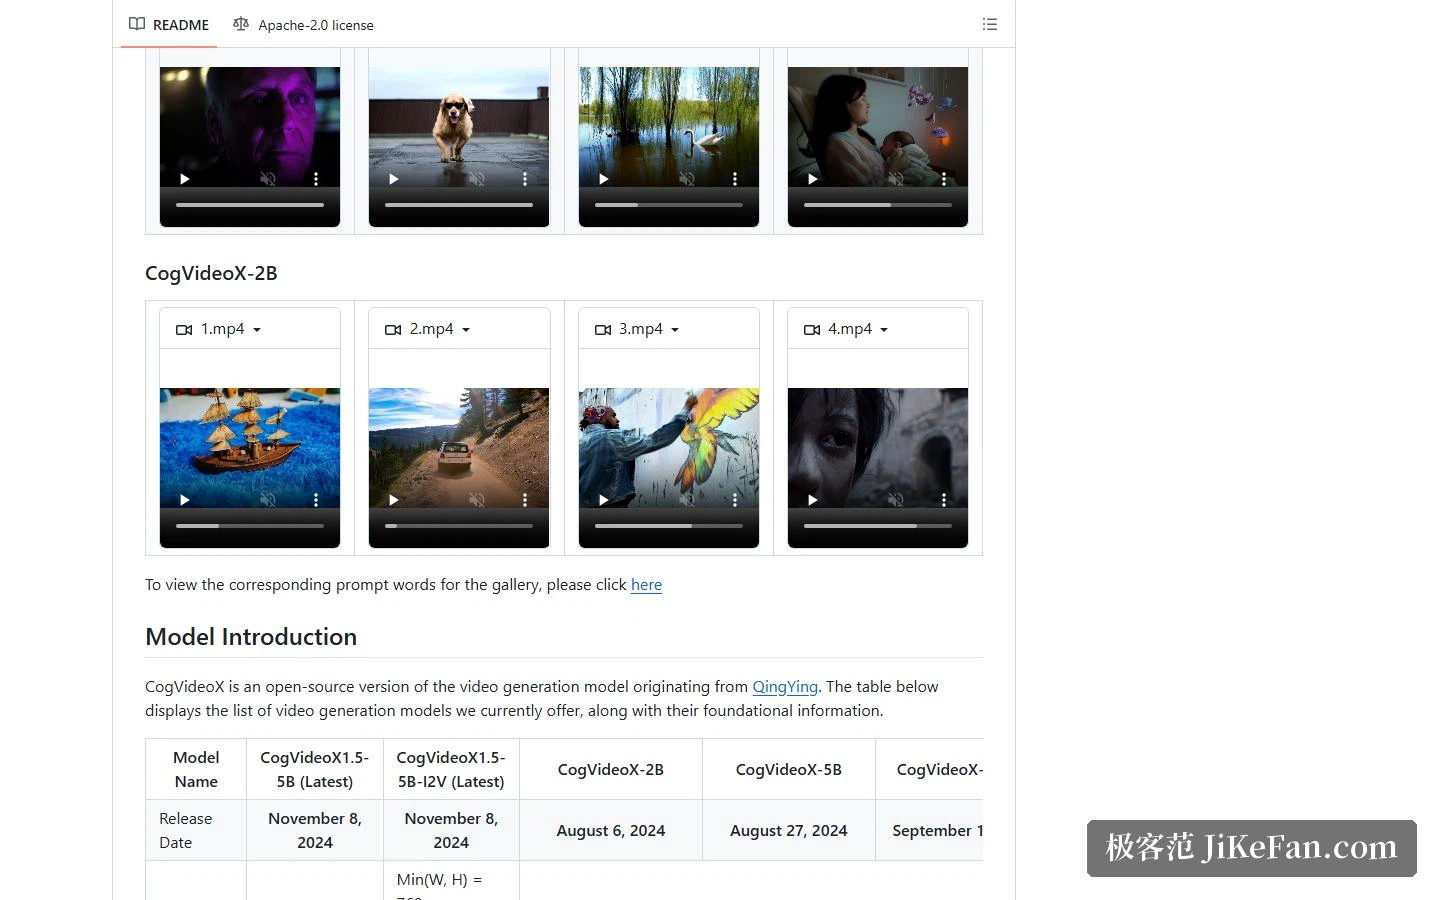
ただし両者は同じものではない。公式はページの冒頭で関係をはっきりさせている。より大きな商用の映像生成モデルを試したいなら清影と API の基盤へ、このリポジトリが提供するのは対応するオープンソース版だ。商用版はオンラインでの大規模生成に向き、オープンソース版は重みとコードを自分の手に置く。
五つの型番、仕様の差は小さくない
モデル表には現在提供されている型番が並ぶ。CogVideoX1.5-5B、CogVideoX1.5-5B-I2V、CogVideoX-2B、CogVideoX-5B、CogVideoX-5B-I2V の五つ。名前に付く I2V は画像から映像を作る意味で、残りはテキストから映像を作る。公開の順番からこの系統の進み方も分かる。2024 年 8 月 6 日に CogVideoX-2B、8 月 27 日に 5B、9 月 19 日に画像から映像の 5B-I2V を公開し、11 月 8 日に 1.5 へ更新した。
仕様は段をはっきり分けている。CogVideoX-2B は 720×480、秒 8 フレーム、6 秒。CogVideoX1.5-5B は 1360×768、秒 16 フレームで、長さは 5 秒か 10 秒。CogVideoX1.5-5B-I2V の解像度の決め方はもっと緩い。短い辺は幅と高さの小さいほうを 768 とし、長い辺は 768 から 1360 のあいだで 16 で割り切れること。その範囲ならどの解像度でも通る。720×480 から 1360×768、さらに画像から映像の柔軟な比率まで、よく使う出力の形はほぼ押さえている。
メモリと速度:自分の機械で動くか
公式の資料には三つのメモリ値があり、いずれも CogVideoX-2B の例だ。SAT と FP16 の推論で 18GB、diffusers 側の FP16 で最低 4GB、INT8 量子化(torchao)で最低 3.6GB まで下がる。同じ資料は、INT8 はメモリの小さいカードに合わせるためのもので推論は遅くなる、ただでは済まないとも書いている。
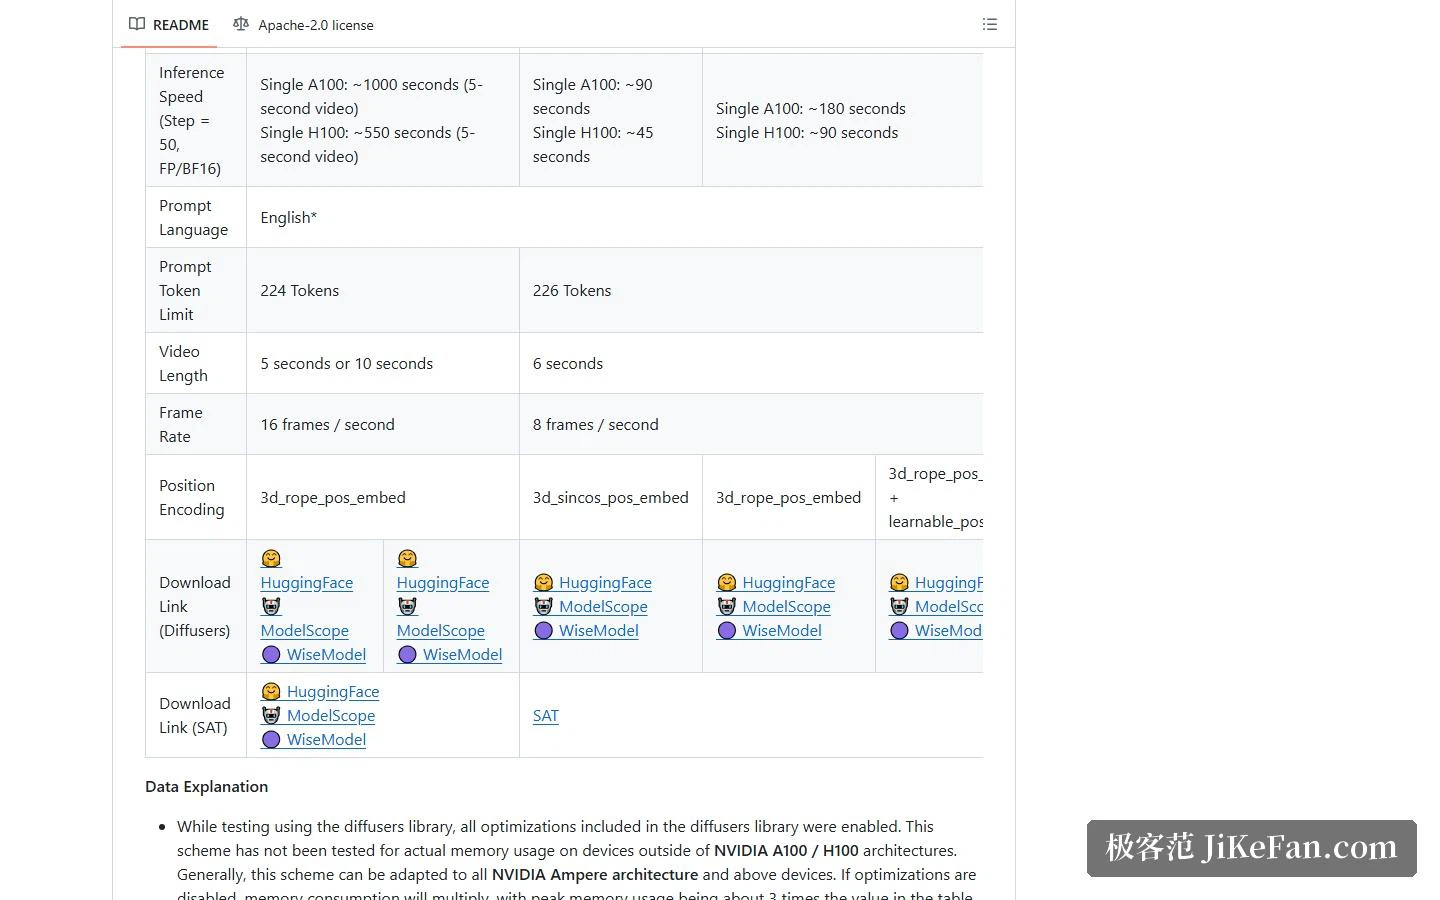
速度の測定条件はステップ数 50、FP16 か BF16 の精度。CogVideoX-5B は A100 一枚でおよそ 180 秒、H100 一枚でおよそ 90 秒かかる。新しい CogVideoX1.5-5B は 5 秒か 10 秒の高解像度映像を出すため、同じ条件で 5 秒の映像に H100 でおよそ 550 秒かかる。能力は上がるが、待ち時間ははっきり伸びる。公式はあわせて、この試験は diffusers にある最適化をすべて有効にしており、A100 と H100 以外では実際のメモリ使用量を確かめていないとも述べる。最適化を切ると、ピークのメモリは表の値のおよそ三倍になる。
始める前に確かめる二つのこと
一つは Python の版。SAT と diffusers の二つの推論経路のどちらにも同じ条件が書かれている。Python は 3.10 から 3.12 までで、3.10 と 3.12 そのものも含む。リポジトリはコードを二組そろえていて、SAT には SAT の重みの推論と微調整のコードが入り、diffusers のほうはよく使う引数の説明が詳しく、まず動かしてから手を入れるのに向く。
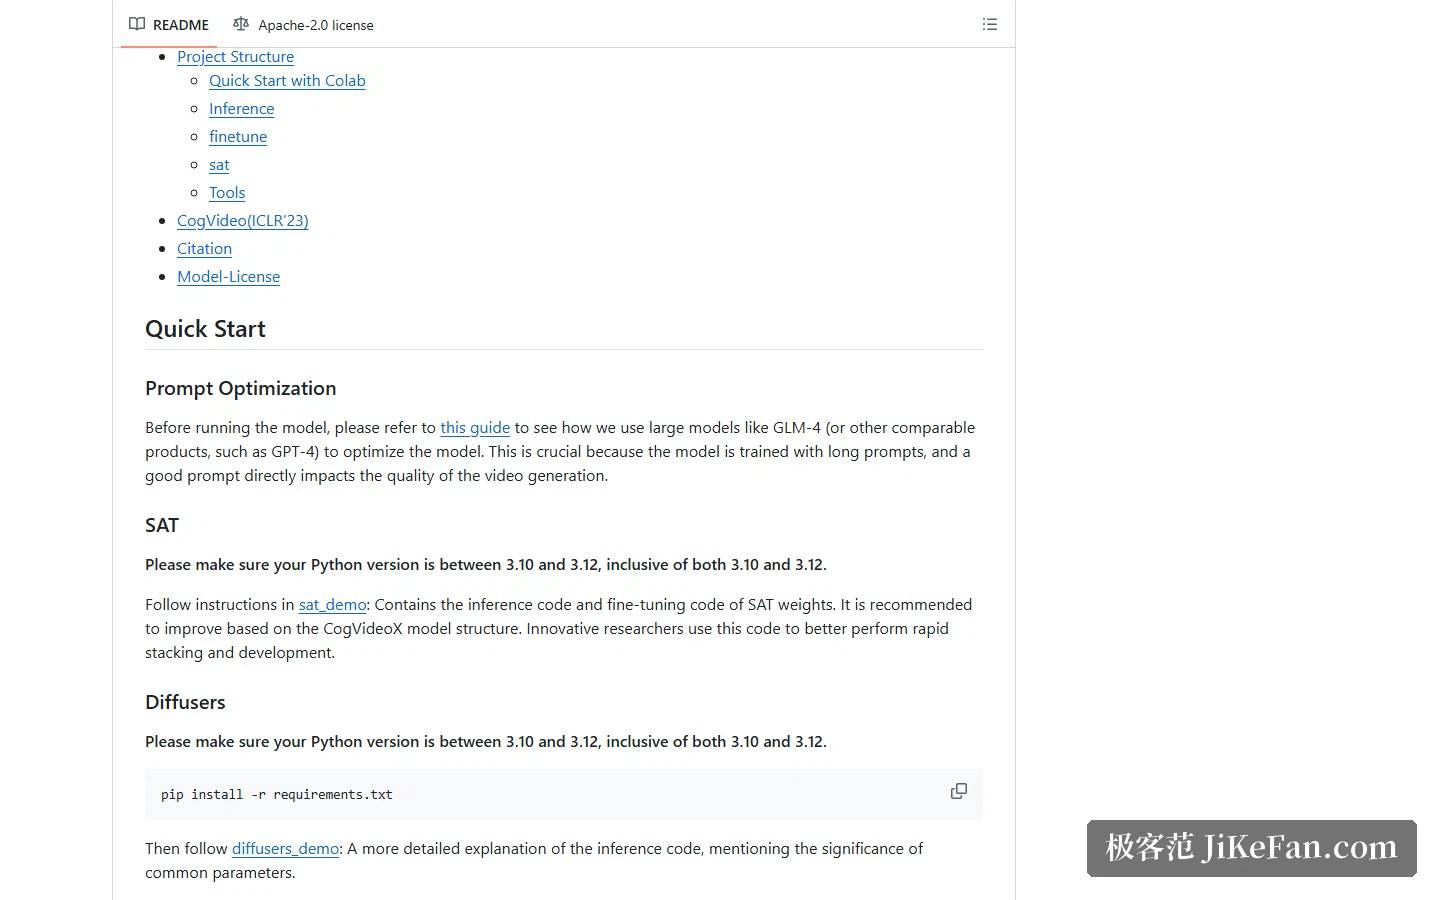
もう一つはプロンプトの言語だ。このモデルは英語の入力しか受け付けないので、他の言語は先に英語へ訳す必要がある。プロンプト最適化の節では GLM-4 などの大きなモデルで、入力を使いやすい長いテキストに整えることを勧めている。モデルは長いプロンプトで訓練されており、プロンプトの質がそのまま結果に効く。リポジトリが示す長さの上限は 224 から 226 トークン。
ライセンス:コードとモデルは分けて見る
コードは Apache 2.0 で公開されていて、ここに曖昧さはない。モデルは型番ごとに見る必要がある。CogVideoX-2B は対応する Transformer と VAE のモジュールを含めて Apache 2.0。CogVideoX-5B は Transformer モジュール、つまり I2V と T2V を含む部分だが、独自の CogVideoX LICENSE を使う。許諾の緩さが要るシーンなら 2B の線引きが明確だ。5B を使う前に、その LICENSE を最後まで読んでおきたい。
リポジトリの中身
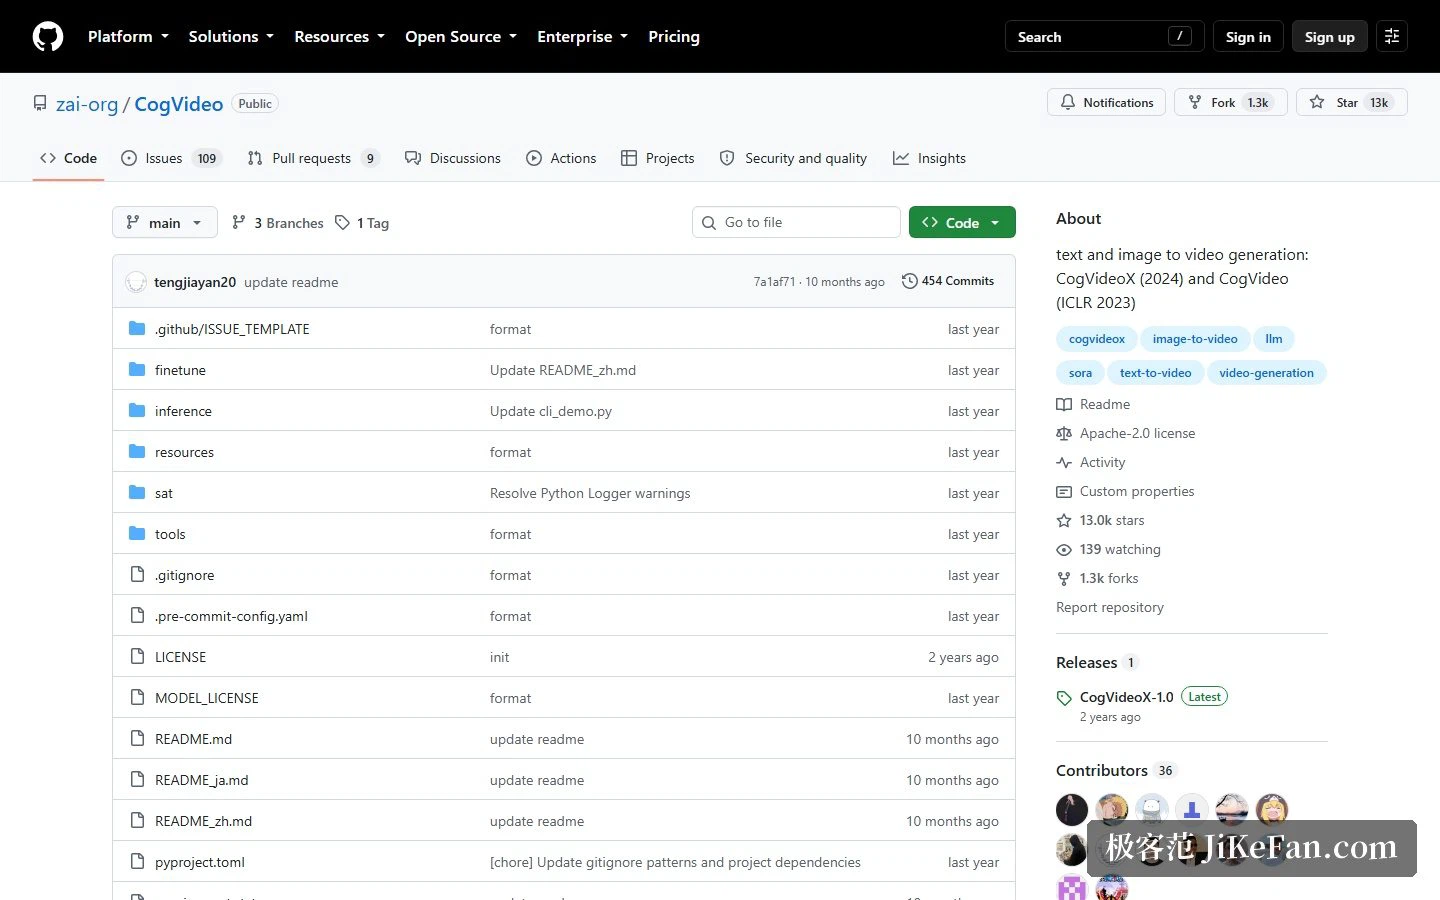
最上位はそっけない。sat と inference が二つの推論コード、finetune が微調整、resources が素材、tools が道具のスクリプト。ライセンスは二つのファイルに分かれ、LICENSE がコードを、MODEL_LICENSE がモデルを別に説明する。リポジトリはいま 13k のスターと 1.3k の fork を持ち、公式の登録版番号は CogVideoX-1.0。
この一年の更新
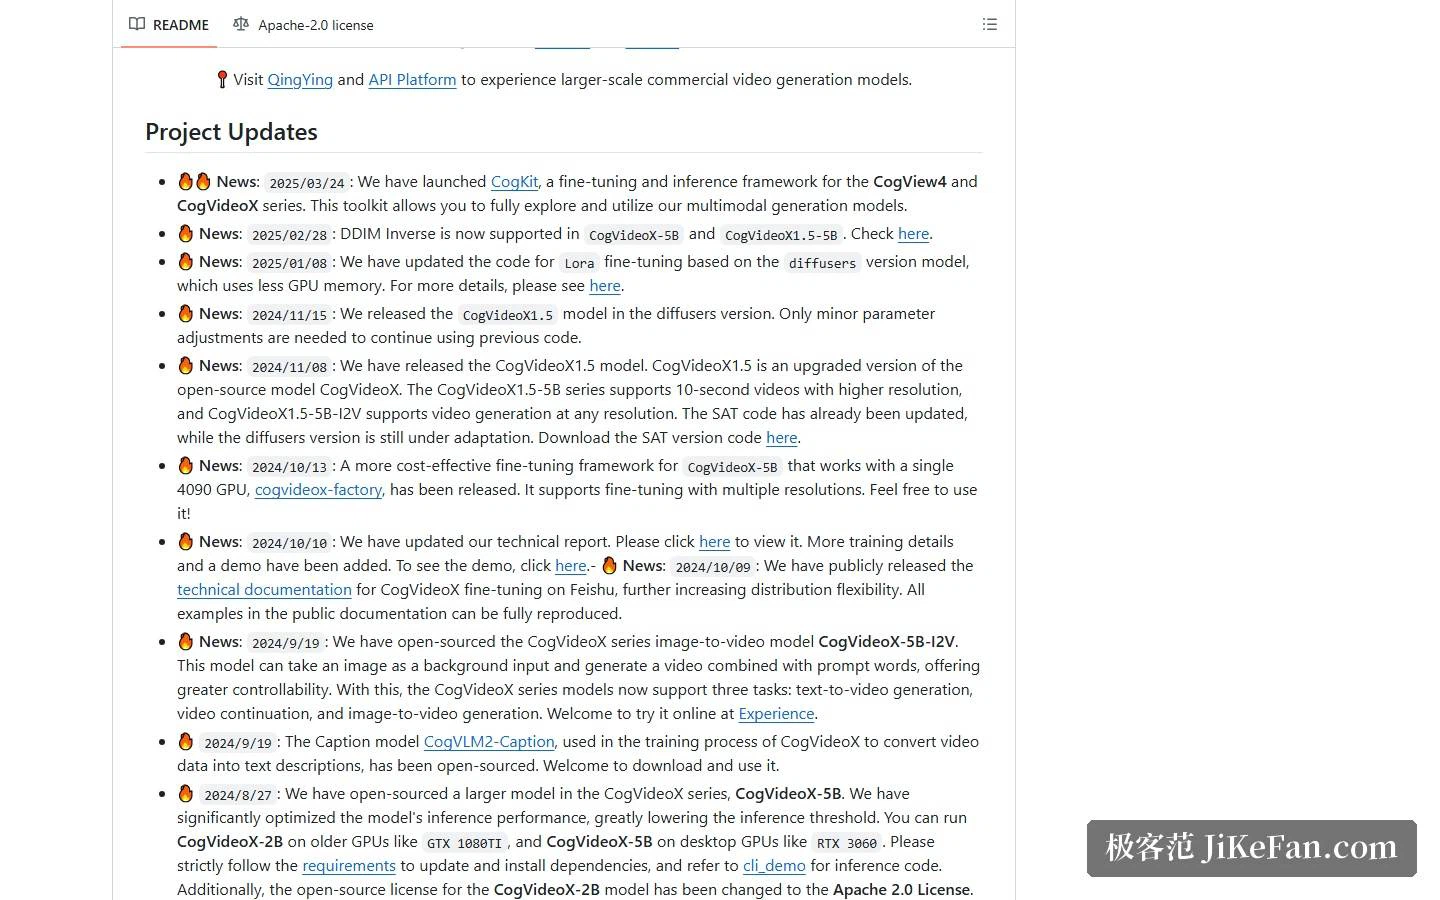
更新履歴からもこの系統の活発さが分かる。2025 年 3 月に CogKit を出した。CogView4 と CogVideoX の系統に向けた微調整と推論の枠組みだ。2 月には CogVideoX-5B と CogVideoX1.5-5B に DDIM Inverse の対応を足し、1 月には diffusers を使った LoRA 微調整のコードを更新した。さらに前、2024 年 10 月に出した枠組みで CogVideoX-5B の微調整が 4090 一枚で回るようになり、公式はあわせて CogVideoX-2B が GTX 1080Ti のような古いカードでも動き、5B は RTX 3060 のあたりのデスクトップ向けカードに当たると述べている。
誰に向くか
映像生成を自分の流れに組み込みたいが、オンラインサービスの順番待ちや枠、内容の方針に縛られたくないなら、CogVideoX は制御できる手元の道になる。重みが開き、コードが開き、メモリの下限は 3.6GB まで押せる。カードがあり、環境をいじる気もある人に向く。Python の版、依存、量子化の精度、プロンプトの言語、どれも自分で確かめることになる。
逆に、たまに一本作るだけなら、あるいは環境と依存を触りたくないなら、オンラインサービスのほうが楽だ。手元で動かすと制約は減るが、時間と、それに耐えるカードが要る。
先に知っておきたい点も一つある。このモデルは英語のプロンプトしか食べない。日本語で考える人が楽に使うには、まず「考えをモデルが分かる長い説明に訳す」工程を何とかする必要がある。そしてこの工程の質は、より大きな型番に替えることより効くことが多い。
オープンなモデルの価値は、オンラインサービスの能力をそっくり再現することにはない。生成の工程を自分の機械へ戻すことにある。まずカードと環境がそれを受け止められるかを確かめ、それから出来を語ればいい。