
SWE-agent: eine Fehlermeldung übergeben und einen Patch zurückbekommen, der den Code liest und die Dateien ändert
Zusammenfassung
Ein Forschungsagent, der eine einzelne Fehlermeldung übernimmt und die Reparatur zu Ende bringt: Er kopiert das Projekt, liest die Beschreibung, sucht die betroffenen Dateien, ändert sie, startet die Tests und liefert einen Patch, der sich zusammenführen lässt. Der eigentliche Beitrag ist nicht das Modell, sondern die Schnittstelle zum Lesen und Ändern von Code.
Empfehlen- Name
- SWE-agent
- Version
- 1.1
- Preis
- Kostenpflichtig
- Open Source
- Open Source
- Betriebssystem
- LinuxmacOS
- Webseite
- https://swe-agent.com/
- Aktualisiert
- 2026-10-06 07:31
Offene Projekte und kleine Teams sitzen in derselben unangenehmen Lage: Der Stapel unbehobener Meldungen wächst, und die Zahl der Leute, die eine davon aufnehmen können, bleibt genau dort, wo sie war. Die meisten Programmierassistenten hören damit auf, beim Vervollständigen der Zeilen vor einem zu helfen — schnelleres Tippen, aber niemand begleitet einen Fehler von Anfang bis Ende. Dieses Projekt nimmt den anderen Weg und gibt die ganze Arbeit ab.
SWE-agent wurde von Forschenden zweier Universitäten gebaut und als offenes Projekt veröffentlicht. Man gibt ihm die Adresse einer Fehlermeldung, und es kopiert das zugehörige Projekt, liest die Beschreibung, sucht im Code nach den betroffenen Stellen, arbeitet heraus, was falsch ist, ändert die Dateien, startet die Tests zur Bestätigung, dass nichts anderes gebrochen ist, und erzeugt einen Patch, der sich als Zusammenführungsanfrage einreichen lässt. Alles geschieht in einer abgeschotteten Umgebung, ohne dass jemand danebensteht und jeden Schritt freigibt.
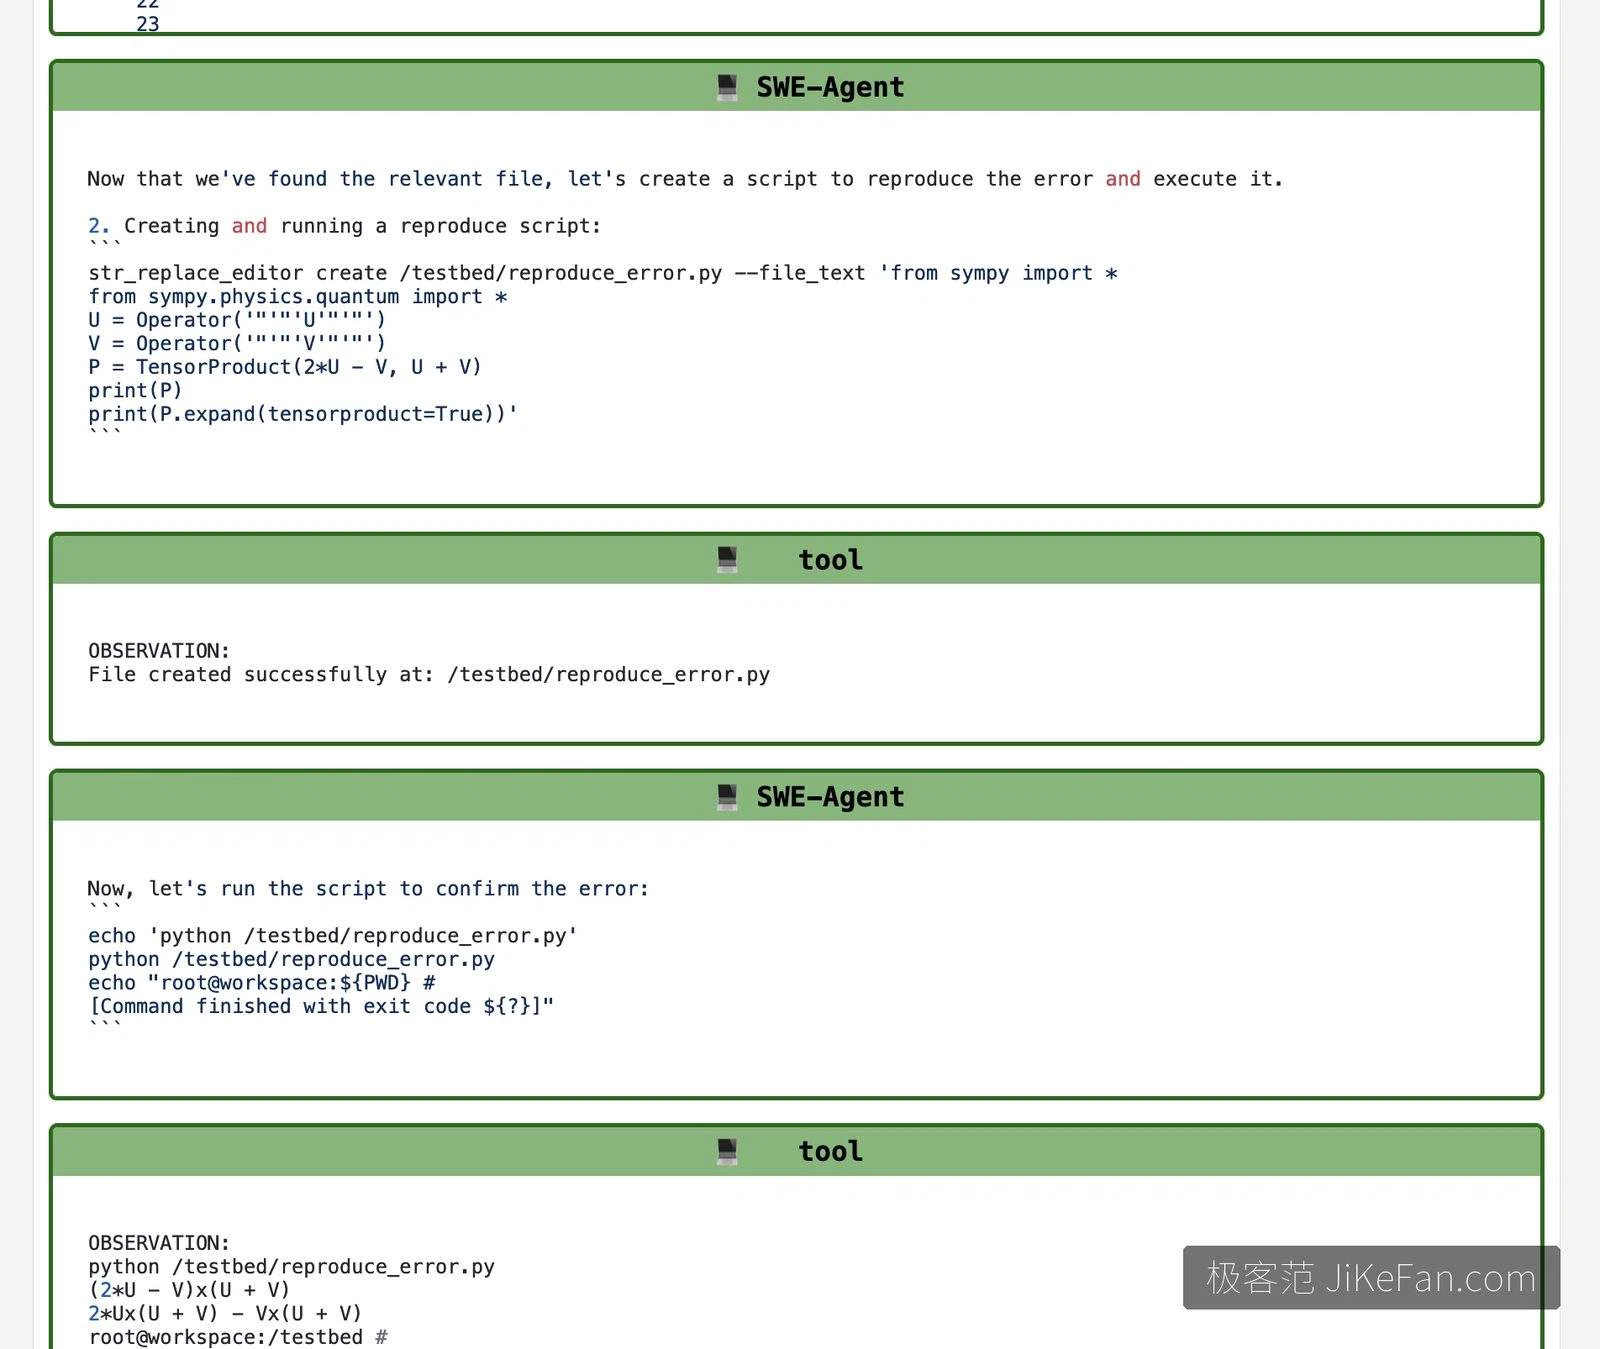
Keine Vervollständigung, sondern eine Reparatur bis zum Ende
Der Ansatz trat 2024 zum ersten Mal auf. In einer öffentlichen Messsammlung aus echten Meldungen löste er 12,29 Prozent der Aufgaben, bei durchschnittlich dreiundneunzig Sekunden pro Aufgabe. Das war das erste Mal, dass ein offener Ansatz eine zweistellige Zahl erreichte, und es verwandelte die Frage, ob ein Modell einen Fehler wirklich beheben kann, von einer Meinungsfrage in eine messbare Aufgabe. Als die Modelle besser wurden, setzte eine spätere größere Fassung den besten offenen Wert in dieser Art von Messung mehrfach neu.
Nicht das Modell ist der Punkt, sondern die Werkzeuge in seiner Hand
Lässt man ein gewöhnliches Dialogmodell in einem echten Projekt laufen, verirrt es sich meist: zu viele Dateien, mehr Kontext als hineinpasst, und eine einzige missratene Antwort macht alles Vorherige zunichte. Der zentrale Beitrag der begleitenden Arbeit ist eine Schnittstelle zwischen Agent und Rechner — kein rohes Terminal für das Modell, sondern ein Satz von Befehlen, der für die konkrete Arbeit des Lesens und Änderns von Code neu entworfen wurde.
Die Einzelheiten sind handfest. Die Dateiansicht zeigt pro Runde etwa hundert Zeilen, was zufällig in dem Bereich liegt, in dem ein Modell genau liest. Der Änderungsbefehl prüft zuerst die Syntax und weigert sich, eine ungültige Änderung anzuwenden. Eine Suche über ein ganzes Verzeichnis gibt nur die Namen passender Dateien zurück, statt Kontext hineinzustopfen. Ein Befehl ohne Ausgabe bekommt eine ausdrückliche Antwort, dass er erfolgreich war und nichts ausgegeben hat. Das sieht nach Kleinigkeiten aus und ist genau das, was ein Modell bei einer langen Aufgabe zusammenhält; die Arbeit bestätigt, dass dasselbe Modell ohne abgestimmte Schnittstelle deutlich schlechter abschneidet.
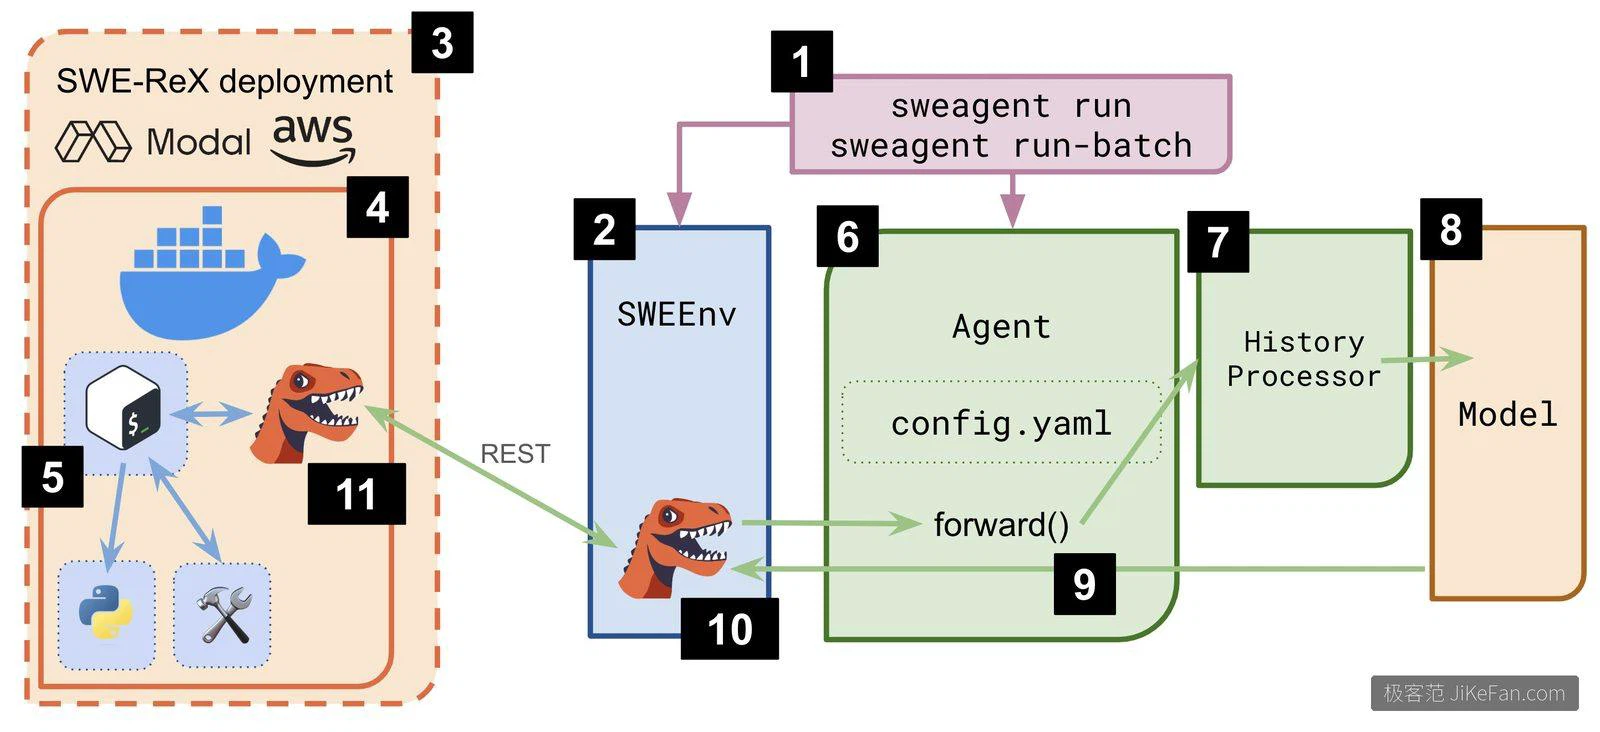
Beliebiges Modell, eine Datei Konfiguration
Hier ist kein Anbieter gebunden. Kommerzielle Modelle und offene Modelle auf der eigenen Maschine lassen sich beide anbinden, und Modell und Parameter stehen in einer einzigen Konfigurationsdatei, sodass ein Wechsel eine Zeile bedeutet statt einer Änderung am Code. Das macht es ungewöhnlich gut geeignet für den Vergleich, welches Modell bei derselben Aufgabe stärker ist.
Die Abschottung übernehmen Behälter: Jeder Lauf geschieht in einem Sandkasten und kann der eigenen Maschine nichts tun. Dutzende oder hunderte Meldungen lassen sich in parallelen Stapeln abarbeiten. Danach bleibt ein vollständiger Verlauf erhalten — welche Datei gelesen, was gesucht, was geändert wurde, alles nachvollziehbar — und eine Ansicht im Netz zeigt Schritt für Schritt, was jeder gekostet und wie viele Einheiten er verbraucht hat.
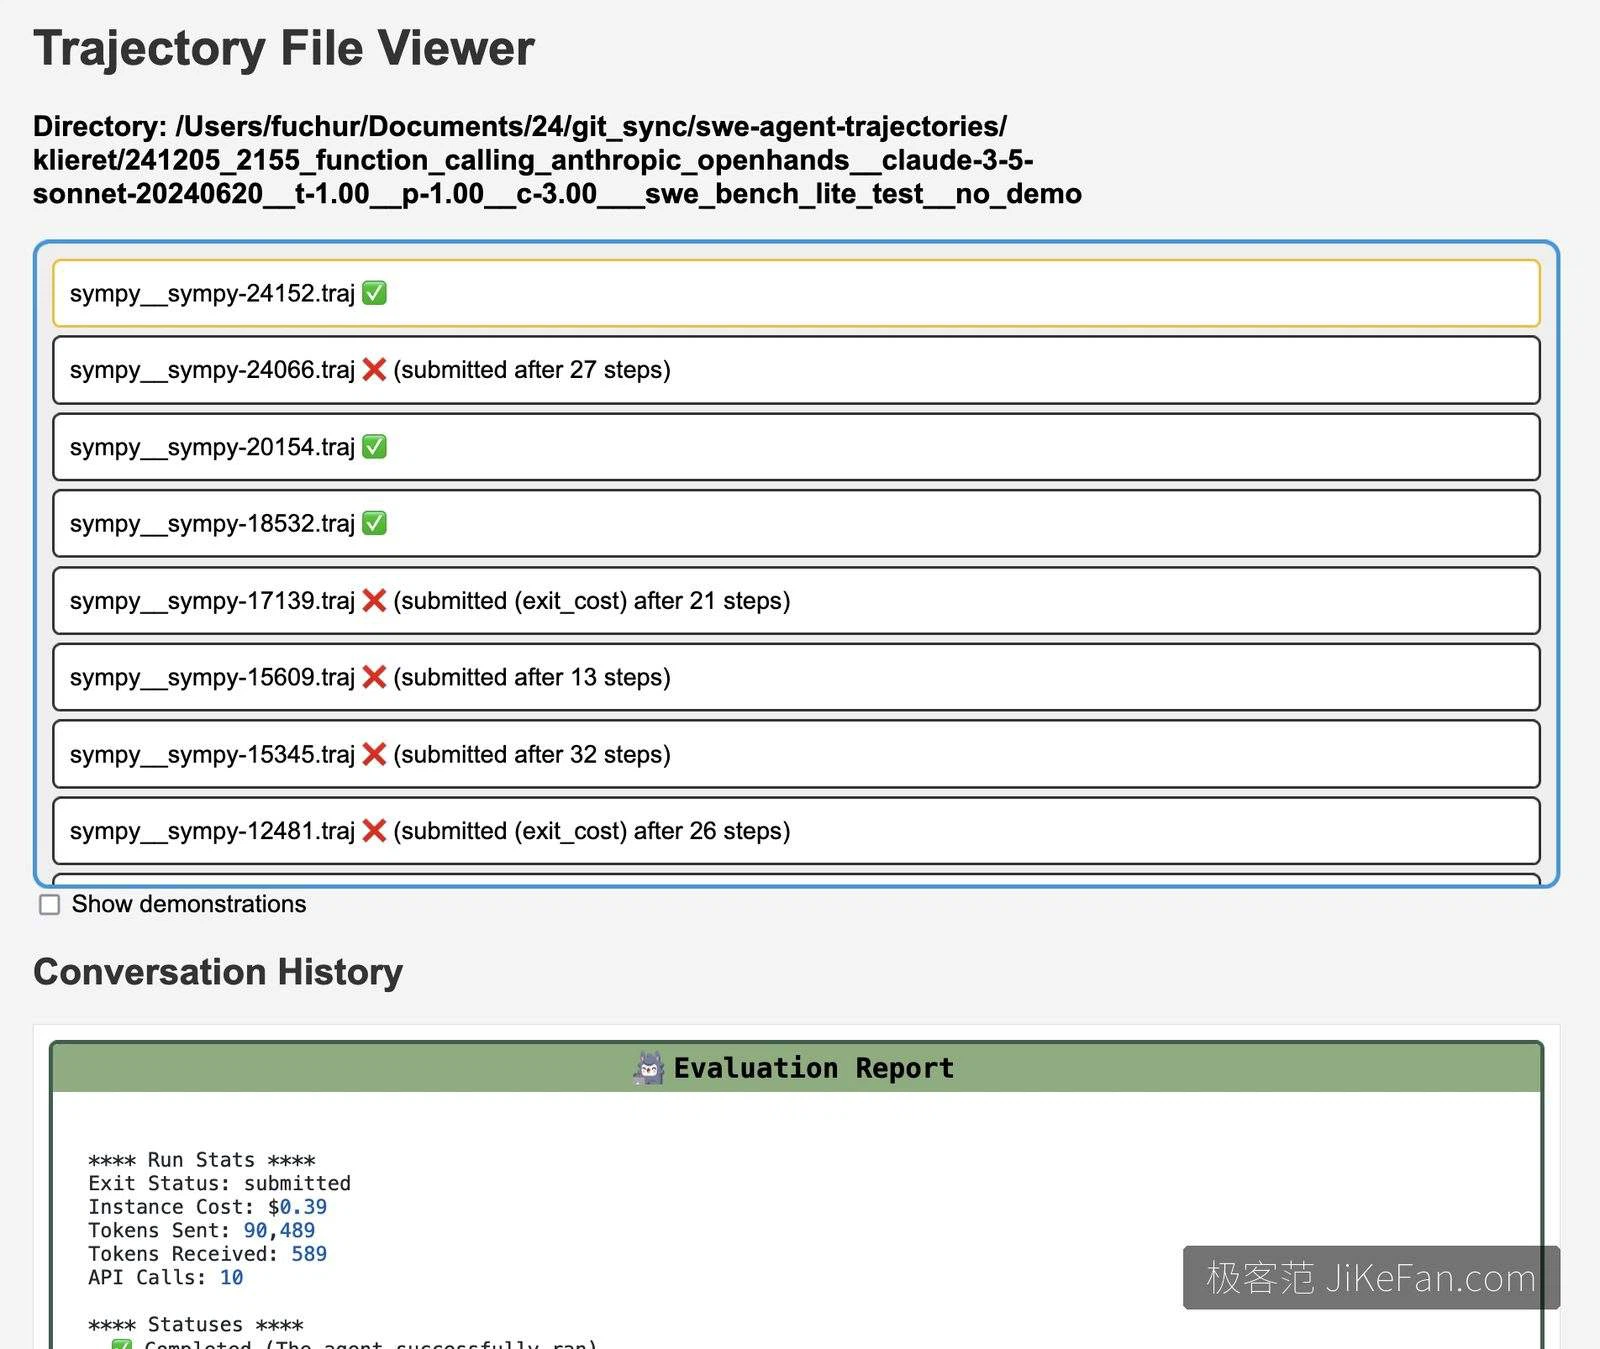
Fehler beheben ist nur der Anfang
Dasselbe Gerüst erledigt anderes. Teams haben es für Sicherheitswettbewerbe eingesetzt, wo es auf den betreffenden Ranglisten führende Plätze erreichte, und für Aufgaben im sportlichen Programmieren; alles, was sich als Arbeiten in einer Umgebung bis zum Erreichen eines Ziels beschreiben lässt, lässt sich anschließen. Das Projekt ist durchgehend offen — prüfbar, änderbar, reproduzierbar —, weshalb die akademische Literatur es immer wieder zitiert.
Wo es heute steht, ohne Beschönigung
Im Juli 2025 veröffentlichte dasselbe Team eine leichtere Fassung: rund hundert Zeilen Python, alle eigenen Werkzeuge entfernt, nur eine einfache Shell übrig, und immer noch etwa fünfundsechzig Prozent der Prüfungsaufgaben gelöst. Die aktuelle Empfehlung lautet, dass die meisten neuen Nutzer dort beginnen sollten; SWE-agent selbst ist in die Pflege übergegangen, neue Funktionen sind nicht mehr der Schwerpunkt.
Damit ist klar, wann es weiterhin die richtige Wahl ist: eine Werkzeugkette, die tiefe Konfigurierbarkeit braucht, Versuche mit verschiedenen Arten des Umgangs mit Verlauf, oder Forschung darüber, wie eine gute Agentenschnittstelle aussehen sollte. Das hier ist Forschungsinfrastruktur, kein fertig verpacktes Produkt. Ende 2026 hatte das Projekt zwanzigtausend Sterne und zweitausend Abspaltungen überschritten, und die begleitende Messsammlung ist zum öffentlichen Maßstab geworden, an dem dieses Feld nicht vorbeikommt.