
FastGPT beginnt bei der Wissensbasis und baut erst dann den Workflow
Zusammenfassung
Eine Plattform, auf der Wissensabfrage, visuelle Workflows, Agenten-Orchestrierung und Werkzeugaufrufe denselben Arbeitsbereich teilen. Die Lizenz erlaubt internen kommerziellen Einsatz, aber keinen Weiterverkauf als Dienst, und die Mühe steckt im Abrufen.
Empfehlen- Name
- FastGPT
- Version
- 4.17
- Open Source
- Open Source
- Betriebssystem
- WebLinuxmacOSWindows
- Webseite
- https://fastgpt.io/
- Aktualisiert
- 2026-10-06 13:16
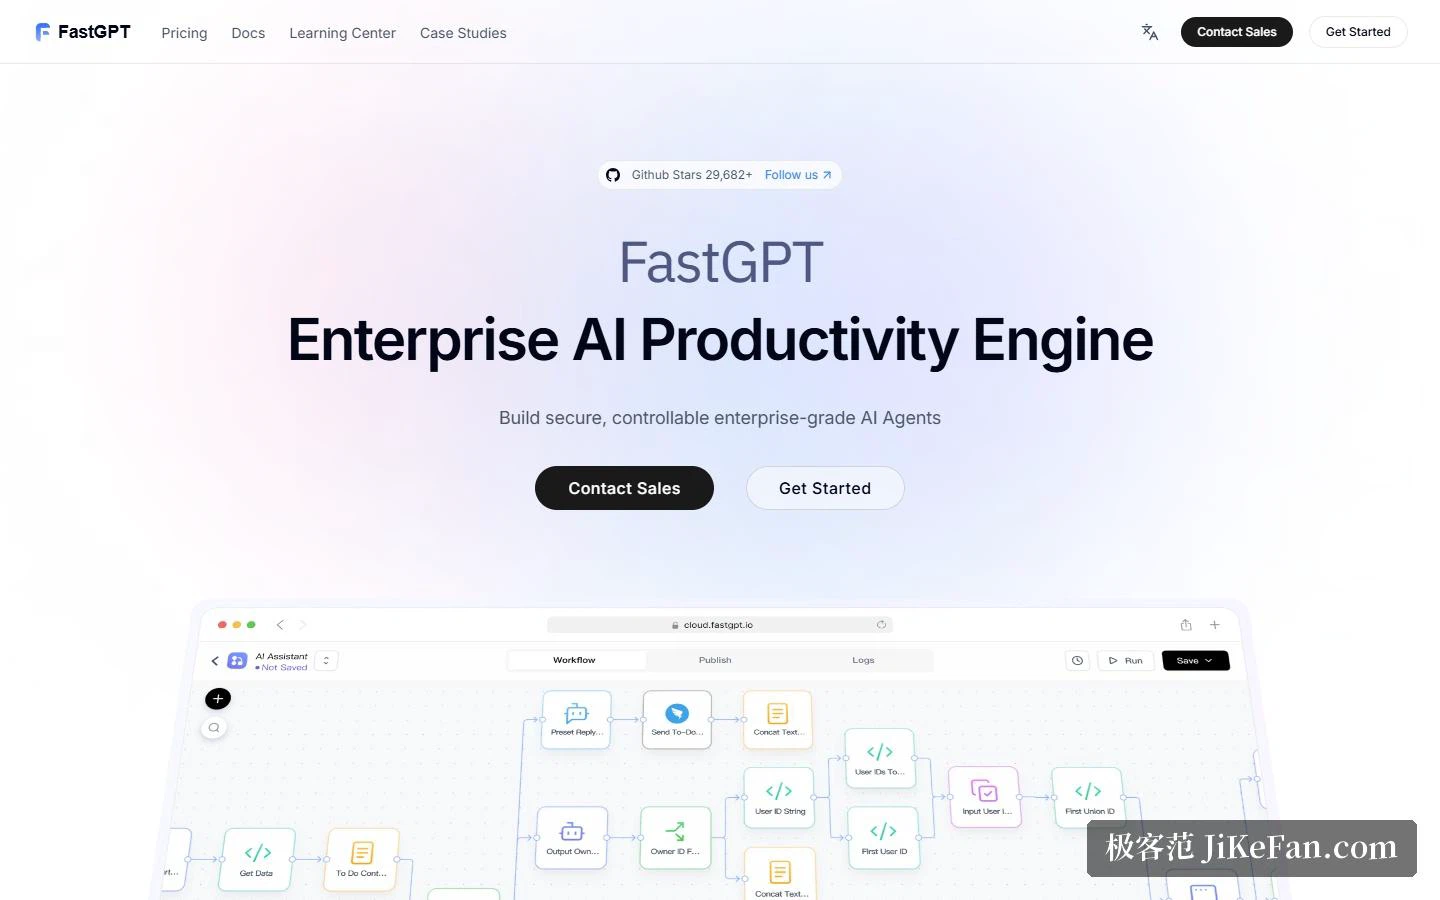
FastGPT hat seinen Ruf im chinesischsprachigen Raum zwei Dingen zu verdanken: einem Frage-und-Antwort-System auf einer Wissensbasis, das ohne Vorbereitung funktioniert, und der Entscheidung, visuelle Workflows und Agenten-Orchestrierung auf dieselbe Plattform zu legen statt sie getrennt zu verkaufen. Die Dokumentation nennt es eine Entwicklungsplattform für Agenten auf Basis großer Sprachmodelle, die Wissensabfrage, visuelle Workflows, Agenten-Orchestrierung, Werkzeugaufrufe und Erweiterbarkeit an einer Stelle versammelt. Die internationale Seite ist deutlicher beim Publikum und nennt sich eine Produktivitätsmaschine für Unternehmens-KI, mit dem Versprechen sicherer und kontrollierbarer Agenten.
Sechs Punkte, und alle zielen auf Kontrolle
Die Startseite gruppiert ihre Versprechen in sechs. Agenten in Produktionsreife, also Geschäftsagenten, die sich wie Bausteine zusammensetzen lassen, mit visuellen Workflows und einem API-Ökosystem für Erweiterung. Eine Unternehmens-Wissensbasis, die mit hybridem Abrufen Halluzinationen senkt und Daten bereinigt und aktuell hält. Verwaltung des gesamten Modelllebenszyklus mit Anbindung aller Anbieter sowie Debugging und Prüfung. Eine Architektur in Produktionsreife mit einmaliger Anmeldung und Rollenrechten, als sicheres Portal, das jedem etwas anderes zeigt. Und Begleitung von der Untersuchung bis zum maßgeschneiderten Machbarkeitsnachweis.
Die Branchenlösungen sind nach Funktion geschnitten: Vertrieb und Marketing, Service und Betrieb, Verwaltung und Personal, Finanzen und Recht. Auf der Vertriebsseite stehen drei Beispiele, ein intelligenter Vertriebsassistent, eine Börsenberichterstattung und ein Übungspartner für Vertriebstraining.
Die Fallbeispiele sind als gemessene Ergebnisse formuliert, nicht als Beiwörter. Ein Wissensassistent für die Entwicklung verkürzte den Einarbeitungszyklus um mehr als eine Woche, senkte Wiederholungsfragen um ein Zehntel und brachte den Abruf auf dreißig Sekunden. Die Automatisierung von Fondsberichten erreichte eine Automatisierungsquote über neun Zehnteln bei Datenfehlern unter einem Prozent. Die Spesenprüfung steigerte die Effizienz um die Hälfte, hob die Erkennung von Auffälligkeiten um sieben Zehntel und senkte Fehler in der Endprüfung um sechs Zehntel. Im Kundenservice wurden Antworten im Sekundenbereich erreicht und die Übergabe an Menschen um zweiundvierzig Prozent gesenkt. Das Unternehmen spricht von über tausend begleiteten Betrieben und listet seine Leistungen in vier Arten: Unterstützung des offenen Ökosystems, Fachberatung, Umsetzungshilfe und kundenspezifische Entwicklung.
Die Wissensbasis ist der Teil, in den die Arbeit floss
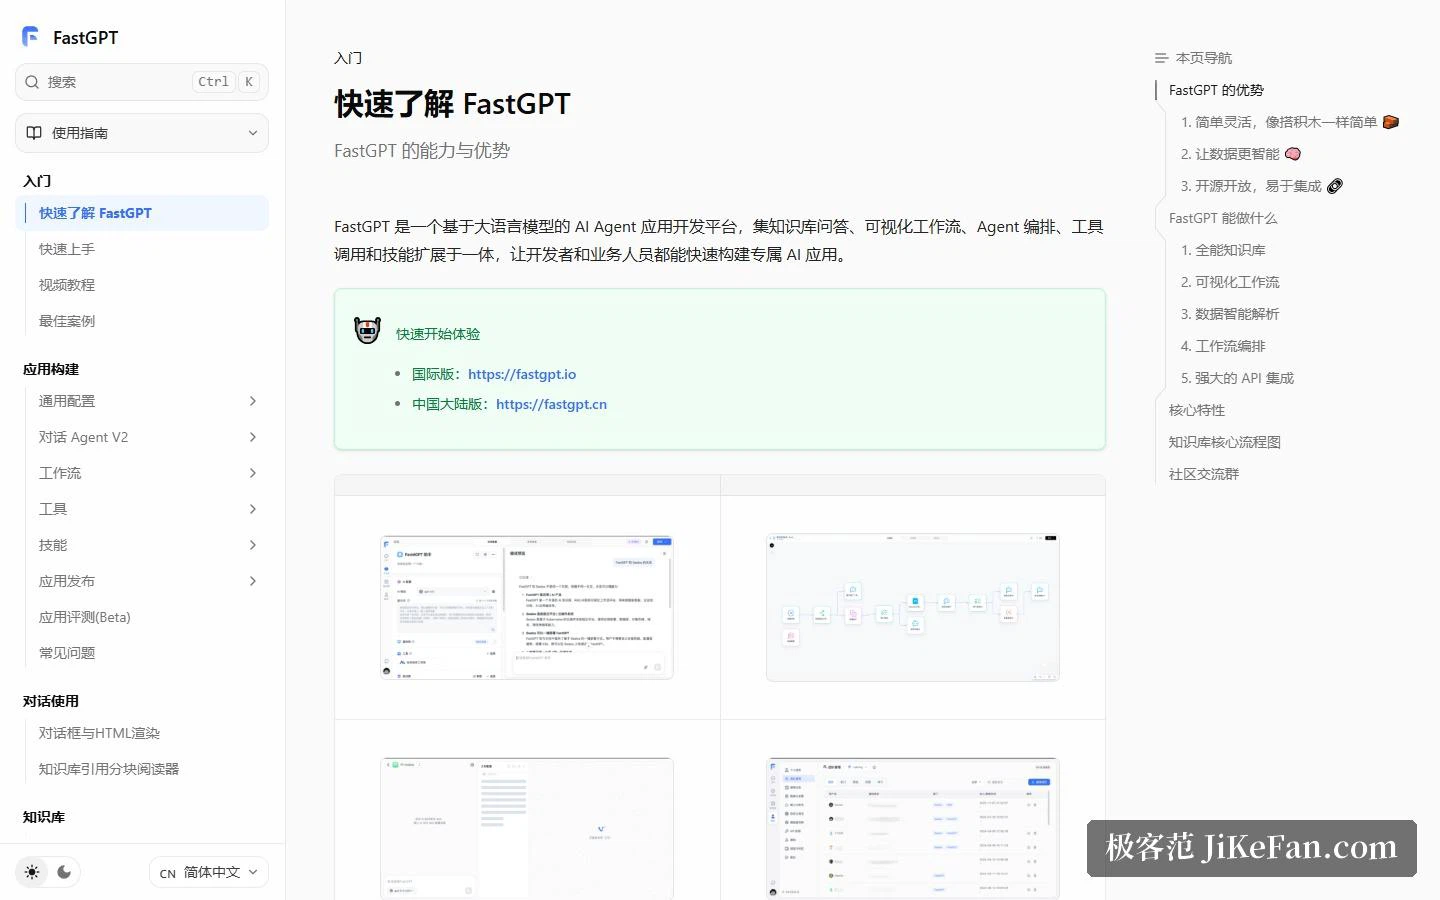
Die Dokumentation widmet der Datenverarbeitung einen eigenen Abschnitt, was für sich spricht: Sie verarbeitet die komplexe Struktur von PDFs und behält Bilder, Tabellen und mathematische Formeln, erkennt gescannte Dokumente automatisch und strukturiert sie zu Markdown, und indiziert Bilder mit automatischer Kennzeichnung, sodass auch Inhalte im Bild auffindbar sind. Die Anleitung ergänzt die Formatliste von reinem Text und Markdown über HTML, PDF, Word- und PowerPoint-Dokumente bis CSV und Tabellen, und unterstützt manuelle Eingabe, direktes Aufteilen, Import als Frage-und-Antwort-Paare, das Lesen einer Adresse und den Import von CSV in Stapeln.
Beim Abrufen gibt es die Wiederverwendung und Mischung mehrerer Bibliotheken, hybrides Abrufen mit Neusortierung und optional eine Wissensbasis über die API. Genau diese Kombination sollte ein Käufer am härtesten prüfen, weil sie entscheidet, ob eine Antwort den richtigen Absatz zitiert.
Orchestrierung und Debugging: die echte Liste steht im Repository
Die Anleitung sortiert die Kernfunktionen in fünf Gruppen, und das ist eine bessere Referenz als der Werbetext. Anwendungsorchestrierung umfasst die Orchestrierung von Agentenfertigkeiten, Chat- und Plugin-Workflows samt einfachen RPA-Knoten sowie beidseitiges MCP. Das Debuggen umfasst Einzelabfragen in der Wissensbasis, Gesprächsrückmeldungen mit bearbeitbaren und löschbaren Zitaten, vollständige Aufrufkettenprotokolle und Anwendungsbewertungen. Bei den Plugins gibt es Systemwerkzeuge, RAG-Module und Aktualisierungen der Agentenschleife im Betrieb. Der Betriebsteil enthält ein Freigabefenster ohne Anmeldung, Einbettung über einen iframe und eine einheitliche Sicht auf Gesprächsprotokolle mit Datenkennzeichnung.
Auf der Schnittstellenebene halten die Unterlagen fest, dass die API exakt dem Format von OpenAI entspricht und die Anbindung an die großen einheimischen Arbeitsplattformen ein kurzer Schritt ist. Die Verteilung besteht aus einem Container-Befehl, der die Konfiguration holt und dann startet; wenn alles läuft, antwortet der Dienst auf dem lokalen Port 3000.
Die Lizenz zieht die kommerzielle Grenze, und das zählt
Diesen Absatz sollte ein Team mit kommerziellen Absichten zweimal lesen. Das Repository nutzt die FastGPT Open Source License: kommerzielle Nutzung als Hintergrunddienst ist erlaubt, das Anbieten eines SaaS nicht. Ohne kommerzielle Lizenz muss jede Form kommerzieller Leistung die zugehörigen Urheberrechtshinweise behalten. Anders gesagt: selbst nutzen und die eigene Organisation bedienen ist erlaubt; FastGPT einpacken und anderen als Dienst verkaufen verlangt eine kommerzielle Lizenz.
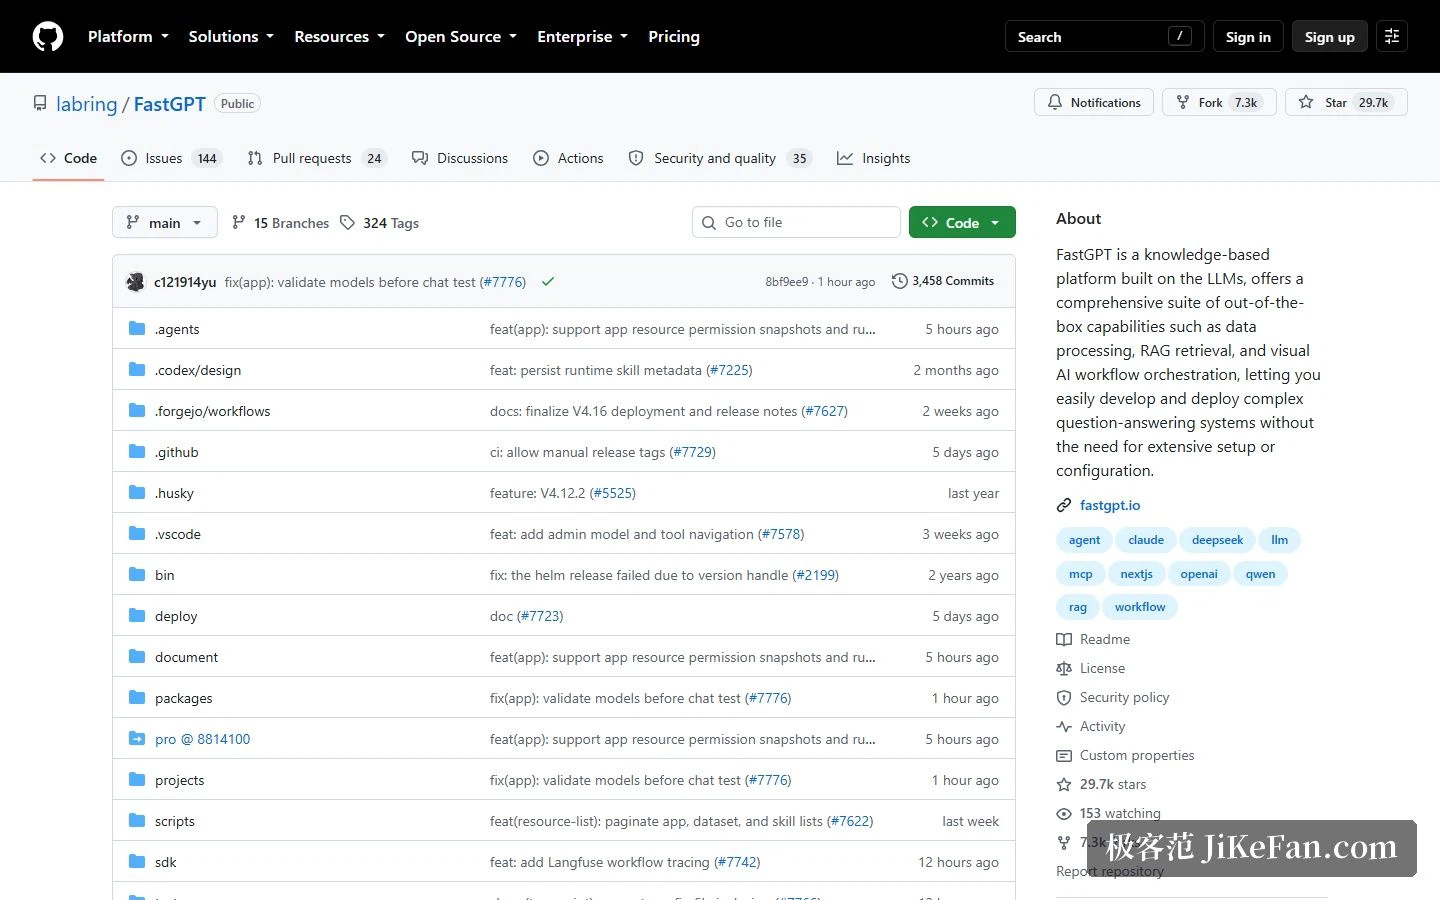
Das Repository zeigt rund 29 700 Sterne, 7 300 Abzweigungen, 200 Mitwirkende und 276 Veröffentlichungen, überwiegend in TypeScript. Weder die internationale noch die chinesische Seite veröffentlicht derzeit eine Preisliste: Cloud und private Verteilung werden über den Vertrieb angeboten, die Zahlen erscheinen in der Konsole, und hier wird keine zitiert.
Für wen es passt
Drei Gruppen passen zu dem Weg, den die Dokumentation beschreibt. Teams, die eine private Wissensabfrage über chinesischsprachigem Material brauchen, wobei Mehrformat-Import und hybrides Abrufen der Teil sind, in den das Projekt am meisten gesteckt hat. Fachbereiche, die die Abfrage in bereits genutzte Kanäle einhängen wollen, weil eine am OpenAI-Format ausgerichtete API die Anbindung billig hält. Und technische Teams, die Wissen, Workflows und Agenten-Orchestrierung auf einer Plattform pflegen wollen statt auf drei.
Ein Punkt verdient Beachtung: Umsetzung und Unterstützung, also Fachberatung, Umsetzungshilfe und kundenspezifische Entwicklung, sind Teil der kommerziellen Ausgabe. Hängt ein Vorhaben an verlässlicher Lieferung, sollte man zuerst die Gemeinschaftsausgabe zum Laufen bringen und danach die kommerzielle Seite bewerten, nicht umgekehrt.
Was die Zahlen aus den Fallbeispielen wert sind
Vom Anbieter veröffentlichte Effizienzwerte sind als Richtung zu lesen, nicht als Genauigkeit. Eine Automatisierungsquote von neun Zehnteln bei Berichten ist nützlich, weil sie sagt, dass die Arbeit nun überwiegend maschinell läuft und vom Menschen geprüft wird; ein Datenfehler unter einem Prozent ist nützlich, weil er sagt, dass die verbleibende Aufgabe die Kontrolle ist. Keine der beiden Zahlen sagt, was der eigene Bestand hergibt, und beide setzen stillschweigend voraus, dass die eingehenden Dokumente denen gleichen, auf die das System eingestellt wurde. Der ehrliche Test ist, das am schlechtesten gesetzte PDF aus dem eigenen Archiv hineinzugeben.
Zwei ehrliche Anmerkungen
Erstens gibt es auf keiner der beiden Seiten öffentliche Preise, deshalb zitiert dieser Artikel keine, und wer budgetiert, sollte das Verkaufsgespräch als Quelle nehmen. Zweitens ist der Lizenzunterschied oben keine Formsache: Er entscheidet, ob ein darauf gebauter Dienst überhaupt verkauft werden darf, also vor dem Entwurf eines Produkts den Lizenztext lesen.
Die Trennlinie zwischen Wissensbasisprodukten ist nicht, ob sie antworten können, sondern ob das Zitat, das sie zurückgeben, auch das richtige ist, nachdem man ein schlecht gesetztes PDF hineingeworfen hat.