
Firecrawl im Test: die Schicht, die aus chaotischen Seiten Agentenfutter macht
Zusammenfassung
Suche, Scraping und Interaktion laufen über eine Schnittstelle, zurück kommt sauberes Markdown, JSON nach Vorlage oder ein Screenshot. Proxys, Bot-Abwehr und Rendering sind Sache des Dienstes — und genau das ist der mühsame Teil.
Empfehlen- Name
- Firecrawl
- Version
- v2.11
- Open Source
- Open Source
- Betriebssystem
- WebLinuxmacOSWindows
- Webseite
- https://www.firecrawl.dev/
- Aktualisiert
- 2026-10-06 06:29
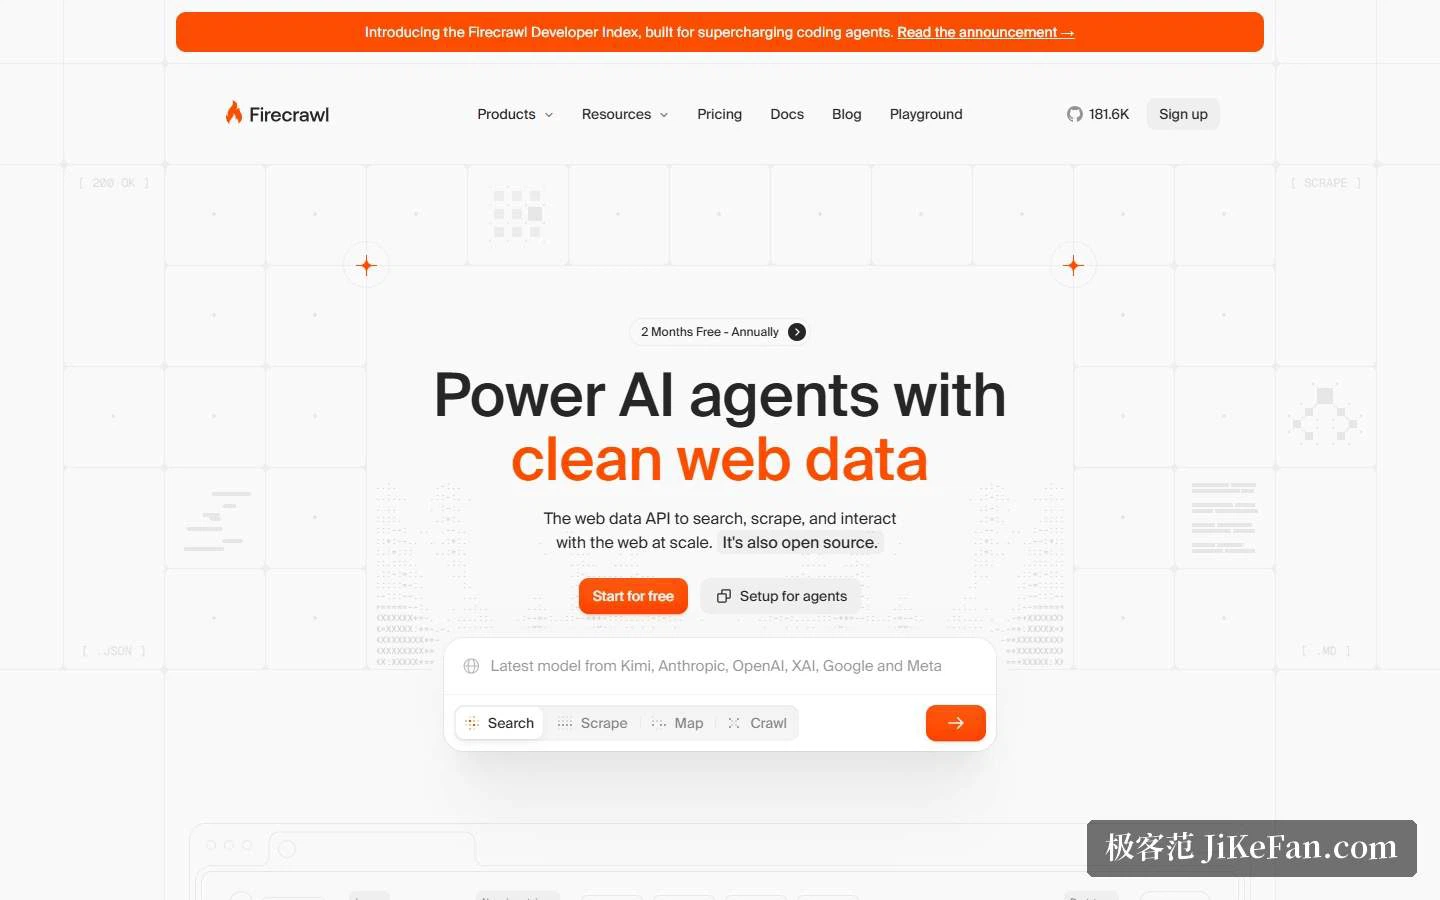
Wer Webseiten an einen Agenten verfüttert hat, weiß, wo es weh tut: Die Zielseite wehrt sich, der Inhalt erscheint erst, nachdem Skripte gelaufen sind, und der Artikeltext hängt zwischen Navigation und Werbung. Dieses Produkt schneidet genau an dieser Stelle. Es nennt sich Webschnittstelle für Daten — eine Adresse hinschicken, sauberes Markdown oder strukturiertes JSON zurückbekommen — und die schmutzige Arbeit passiert auf dem Server. Der Slogan der Startseite ist deutlich, und das Projekt ist zugleich quelloffen, was erklärt, wie das Repository etwas über 180.000 Sterne sammeln konnte.
Drei Aufgaben: suchen, scrapen, interagieren
Der Kern teilt sich in drei. Search findet Webseiten und bringt den Volltext der Trefferseiten gleich mit, was zum Muster passt: erst finden, dann lesen.. Scrape macht aus jeder Adresse Markdown, JSON oder einen Screenshot, und für strukturierte Ausgabe reicht man eine JSON-Vorlage hinein und bekommt die eigenen Felder in dieser Form zurück. Interact ist der jüngste der drei und der am wenigsten offensichtliche: Die Sitzung endet nicht mit dem Abruf der Seite, also dürfen natürliche Sprache oder Code weiterklicken, Formulare füllen, dynamische Inhalte holen und tiefer gehen. Das offizielle Beispiel ruft die Startseite eines Händlers ab, sucht darin ein Produkt, öffnet den Treffer und liest den Preis. Der Wert der Verbindung liegt darin, dass bei vielen Sammelaufgaben die eigentliche Schwierigkeit im dritten Schritt steckt — eine statische Kopie des HTML reicht oft nicht.
Mehr als eine Seite: ganze Seiten, Stapel, lokale Dateien
Um die Kernendpunkte liegt ein Ring weiterer Fähigkeiten. Map findet alle Adressen unter einer Seite, Crawl nimmt die Seite rekursiv auf, und Stapelverarbeitung deckt Hunderttausende Adressen asynchron ab. Auch das Auslesen beschränkt sich nicht auf Live-Seiten: lokale PDF-, DOCX-, XLSX- und HTML-Dateien lassen sich in Markdown oder strukturiertes JSON umwandeln. Dazu kommen ein autonomer Modus, in dem man beschreibt, was man will, und der Agent sammelt selbst; Webhooks, die Ergebnisse asynchron zustellen; und eine Browser-Sandbox, die gehostete Browsersitzungen für Interaktionsabläufe bereitstellt. Auch Aktionen vor dem Scrapen haben ihre Haken — Klicken, Scrollen, Tippen, Warten und Tastendrücke lassen sich in den Ablauf einbauen.
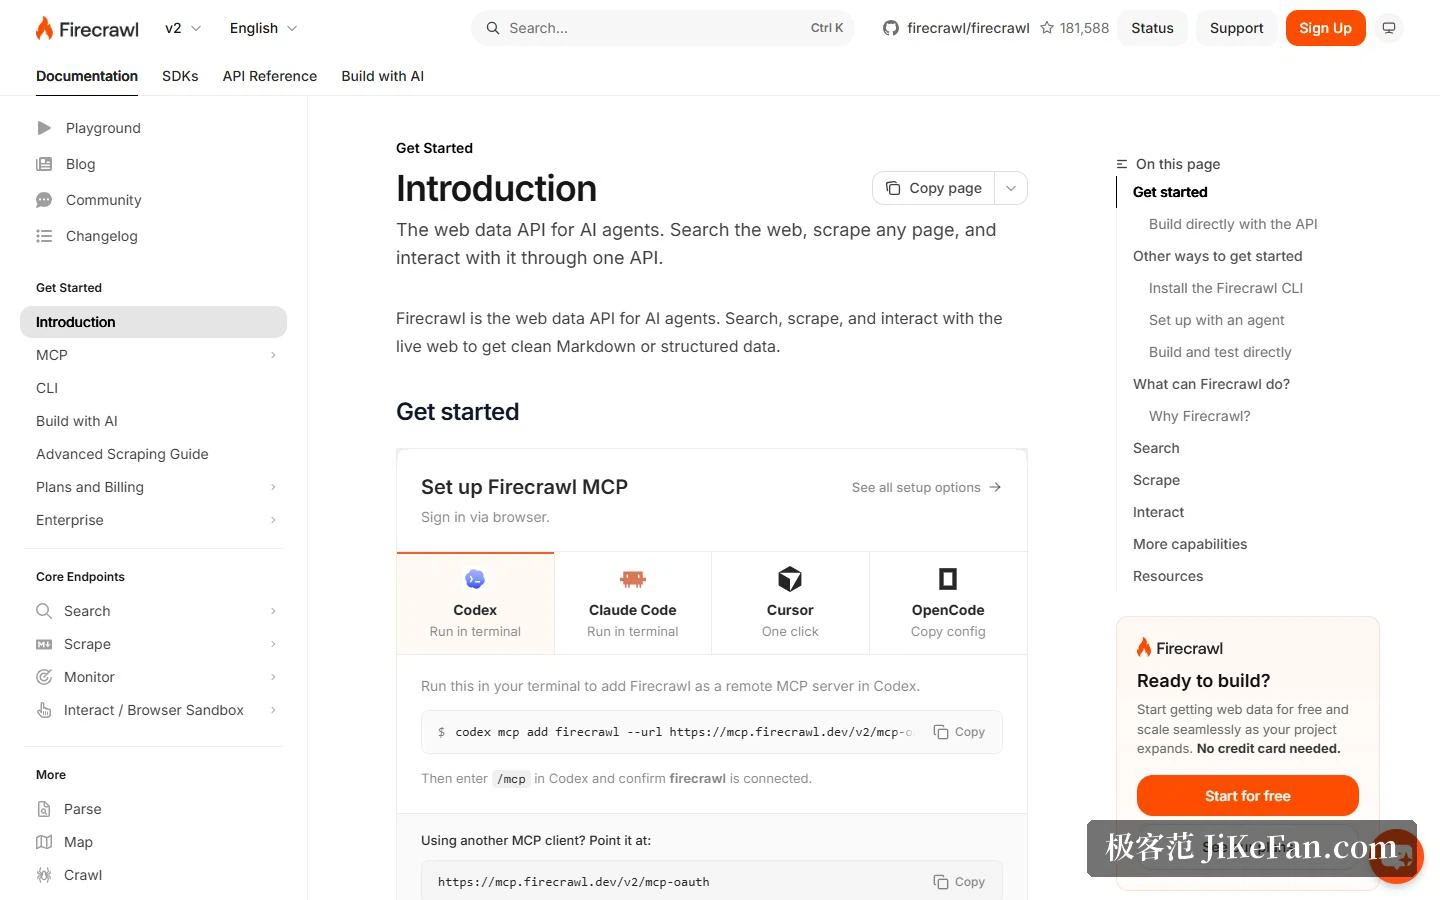
Die Anbindung ist gründlich. Es läuft als Server für das Modellkontextprotokoll, ein Befehl hängt es an einen Coding-Agenten. Dazu kommt ein Kommandozeilenwerkzeug, das sich selbst installiert und beim erkannten Coding-Agenten eine Fähigkeit einträgt. SDKs decken Python, Node und die Kommandozeile ab, und die Integrationsliste nennt die zwei gängigen Retrieval-Frameworks sowie mehrere Modellanbieter. Die Dokumentation empfiehlt sogar den Start ohne Schlüssel: Die ersten Anfragen brauchen keinen, ein Schlüssel lockert nur die Ratenbegrenzung.
Freikontingent und wie abgerechnet wird
Die Regeln sind ungewöhnlich gut lesbar. Jeden Monat kommen 1.000 Guthaben, rund tausend Seiten, ohne Kreditkarte. Darüber liegen vier Stufen, eine Unternehmensstufe wird einzeln verhandelt, und ein Jahresabo schenkt zwei Monate dazu. Die Einheit wechselt mit der Fähigkeit: Scrapen, ganze Seiten crawlen, Adressen finden und Überwachen kosten je ein Guthaben pro Seite; Suche kostet zwei Guthaben pro zehn Treffer; Seiteninteraktion zwei Guthaben pro Browser-Minute. Auch die Übertragung unterscheidet sich — ungenutzte Guthaben der beiden oberen Stufen wandern in den Folgemonat, bei den unteren nicht. Die offizielle Fragenliste ergänzt zwei Grenzen: Ein Scrape ohne Ergebnis kostet nichts, und Seiten, die mit einem Fehlerstatus antworten, werden trotzdem geliefert. Fünf Dollar Nachkauf entsprechen je nach Stufe 1.000, 2.000, 2.500 oder 5.000 Guthaben — dasselbe Geld kauft weiter oben mehr.
Die Lizenzform verdient Aufmerksamkeit. Das Projekt steht überwiegend unter AGPL-3.0, wer also eine veränderte Fassung als öffentlichen Dienst betreibt, muss seine Änderungen offenlegen; die SDKs und einige Oberflächenkomponenten sind MIT, der Aufruf der gehosteten Schnittstelle ist damit deutlich weniger eingeschränkt. Die gehostete Fassung bringt außerdem Fähigkeiten mit, die die selbst betriebene nicht hat, und die Funktionslisten in Repository und Dokumentation erlauben den Vergleich. Zur Compliance erklärt der Anbieter, robots.txt werde standardmäßig respektiert, und die Verantwortung für die Regeln der Zielseite liege beim Nutzer — ein Satz, den man vor kommerzieller Sammlung Wort für Wort lesen sollte.
Für wen es passt
Drei Lagen passen sauber. Teams, die die Retrieval- und Werkzeugschicht für Agenten bauen, weil sie Seiten zuverlässig in ein kontrollierbares Format brauchen und keine eigene Infrastruktur für Scraping und Bot-Abwehr betreiben wollen. Teams mit Datenpipelines und Interessentenanreicherung, wo Stapelverarbeitung plus strukturierte Vorlage eine unordentliche Seite direkt auf Datenbankfelder abbildet. Und Einzelne oder kleine Teams in der Prüfphase, weil das Freikontingent für einen vollständigen Durchlauf reicht und sowohl der Protokollserver als auch das Kommandozeilenwerkzeug in Minuten hängen.
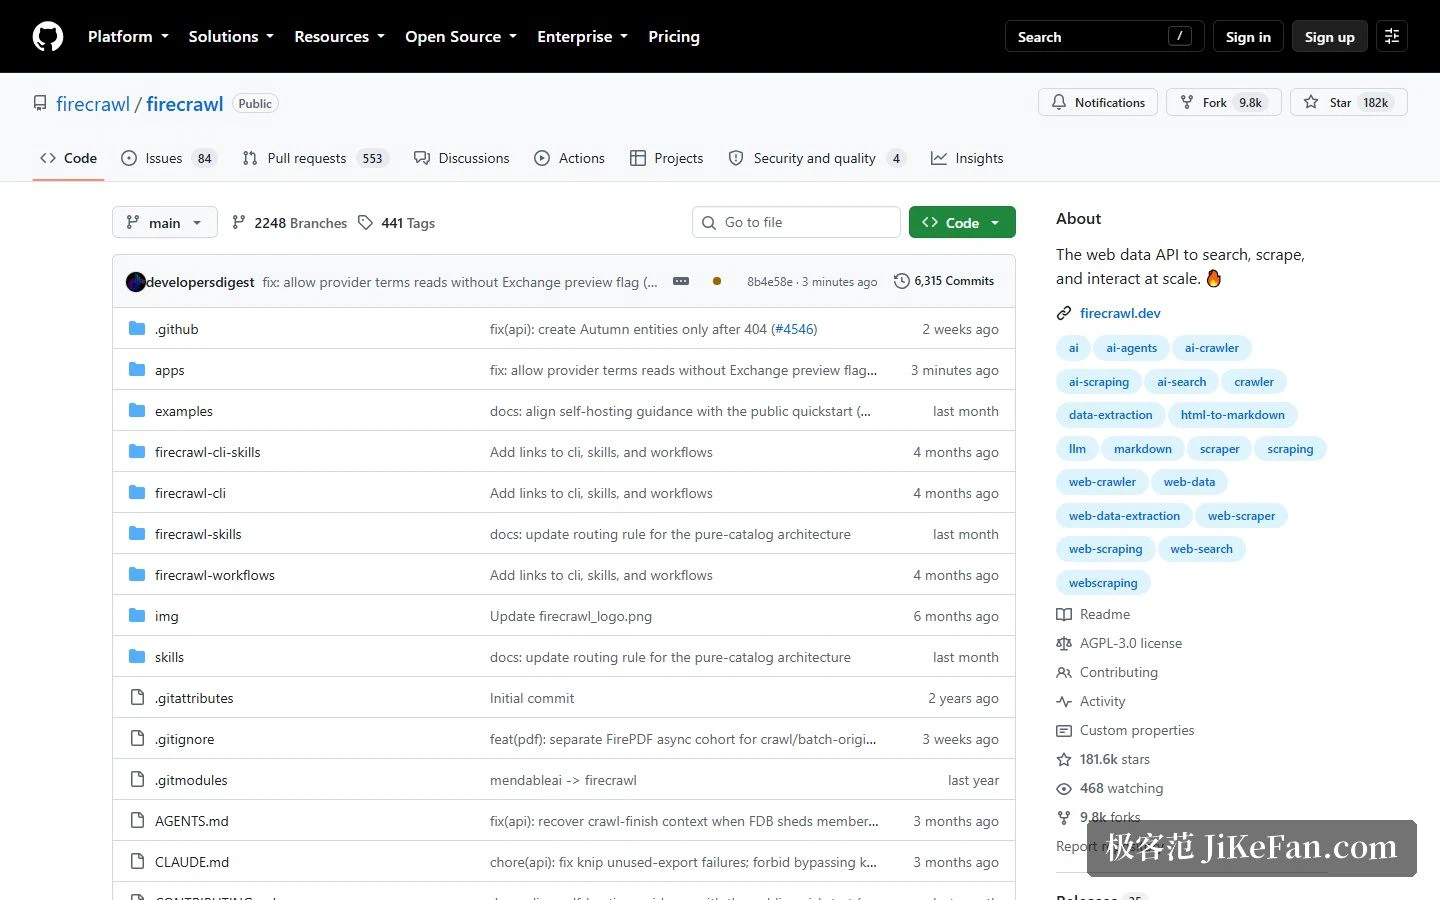
Zwei Abwägungen gehören genannt. Erstens die Lizenz: AGPL-3.0 schränkt den Verkauf einer veränderten Fassung als Dienst ein, was den Aufruf der gehosteten Schnittstelle nicht betrifft, aber vor einem öffentlich angebotenen Eigenbau ein Nachdenken über Pflichten verlangt. Zweitens Selbsthosting gegen Cloud: Selbsthosting behält Daten und Kosten in der Hand, zum Preis, Bot-Abwehr und Seitenabdeckung selbst zu tragen; die Cloud hostet all das, zum Preis mengenabhängiger Abrechnung und der Weitergabe von Anfragen an Dritte. Die Repository-Zahlen nennen rund 181,6k Sterne, 9,8k Forks, 35 Veröffentlichungen, 173 Beitragende und Version v2.11.0, überwiegend TypeScript mit Python und Rust daneben, bei 96 Prozent Seitenabdeckung und einer P95-Latenz von 3,4 Sekunden — Angaben des Anbieters, die die eigenen Zielseiten trotzdem verdienen.
Der Wert eines Scraping-Werkzeugs liegt nicht darin, ob es abrufen kann. Sondern darin, ob das Abgerufene direkt ins eigene Nachgelagerte passt. Wer diese Schicht sauber macht, spart wirklich Arbeit.