
Hailuo H3, 네 가지 모달리티를 한 컨텍스트에 담고 2K를 기본으로 내놓다
요약
프롬프트와 정지 이미지, 오디오를 한 번에 읽어내고 스테레오는 렌더링 뒤에 덧붙이지 않고 처음부터 함께 만든다. 2K도 유료 옵션이 아니라 출발점이며, 공식이 내세우는 초당 가격은 주류 모델의 3분의 1 아래다.
추천- 이름
- Hailuo
- 버전
- 20260916
- 요금
- 무료
- 오픈소스
- 오픈소스
- 운영체제
- WindowsmacOSiOSAndroid
- 공식 사이트
- https://hailuoai.com/
- 업데이트
- 2026-10-06 20:00
MiniMax는 자사 영상 생성기를 Hailuo라는 이름으로 내놓는다. 중국어 사이트 첫 화면의 문장은 꽤 직설적이다. 모든 아이디어가 한 편의 영화가 된다는 것. 지금 중심에 있는 것은 H3와 H3 Max 두 모델이고, 같은 공지 줄에 신규 사용자에게 3000 무료 포인트를 준다는 안내도 붙어 있다. 작업 공간은 좁다. 영상은 H3, 이미지, 오디오, 그리고 영상 만들기·이미지 만들기·Hailuo Agent 세 개의 입구다.
네 가지 모달리티, 하나의 모델
공식 규정은 한 문장이다. 오픈 웨이트 범용 옴니모달 생성 모델. 연구 목록에는 Open Weights 라벨도 붙어 있다. H3를 소개하는 글은 앞선 두 세대가 왜 그런 모습이었는지부터 설명한다. Hailuo 01은 시스템을 맨바닥에서 세웠고, Hailuo 02는 아키텍처 효율과 데이터 품질, 규모를 다듬었다. H3는 다른 길을 택해 잘게 쪼개져 있던 작업을 다시 붙인다.
이미지 쪽은 텍스트에서 이미지로, 편집, 피사체 참조, 동작 참조, 스타일 참조가 각각 전문 모델로 나뉘어 있었다. 오디오는 음성, 효과음, 음악이 따로 연구됐고, 영상은 텍스트에서 영상으로, 이미지에서 영상으로, 첫 프레임과 마지막 프레임, 피사체 참조, 동작 참조, 음색 참조, 영상 편집까지 잘게 갈라졌다. 모달리티 사이의 경계도 단단했다. 그 벽은 창작자가 요구할 수 있는 범위를 좁히고 모델의 일반화도 막았기에, 작업을 한 지붕 아래로 되돌리는 것이 H3의 첫 설계 원칙이 됐다.
결과물: 768P 또는 2K, 최대 15초, 스테레오 기본
글은 세 가지 주장으로 시작한다. H3는 텍스트와 이미지, 영상, 오디오를 한 컨텍스트에서 읽는다. 네이티브 스테레오 사운드가 담긴 영상을 만든다. 2K로 최대 15초이며 2K는 업그레이드가 아니라 기본값이다. 문서는 더 구체적이다. 출력은 768P와 2K, 길이는 4에서 15초이고 정수만 받는다. 추론 기반과 공동 발표하고 속도를 다듬은 H3 Max는 480P와 768P, 5에서 15초를 낸다.
오디오는 이 세대의 무게 중심 중 하나다. 공식 설명에 따르면 모든 오디오 출력이 네이티브 스테레오이고, 음성과 효과음, 음악을 따로 모델링하지 않고 함께 생성한다. 그래서 클립이 나올 때 소리가 이미 화면에 붙어 있고, 편집의 일은 더빙이 아니라 균형 맞추기로 바뀐다.
세 가지 생성 방식
텍스트에서 영상으로 갈 때는 프롬프트만 있으면 된다. 이미지에서 영상으로 갈 때는 첫 프레임과 마지막 프레임 이미지를 받고, 개수는 0, 1, 2장 중 하나다. 시작을 고정하거나 끝을 고정하거나, 둘 다 주고 사이를 모델이 채우게 하는 식이다. 마지막 방식은 정지 이미지를 움직이게 하되 다른 장면은 만들고 싶지 않을 때 쓸모가 있다.
참조 생성은 참조 이미지와 참조 영상, 참조 오디오를 섞어 인물, 동작, 카메라 움직임, 스타일, 음색, 편집 리듬을 고정한다. 한도는 명시돼 있다. 이미지 9장까지, 영상 3편까지(각 2에서 15초, 합계 15초 이내), 오디오 3편까지, 혼합 입력 전체 12개 파일까지다.
2K는 업스케일이 아니라 재생성
파이프라인 끝에 전용 업스케일 모듈을 붙이는 대신, 기반 모델이 자기 저해상도 출력을 컨텍스트 안에서 다시 만들게 한다. In-Context Regeneration이다. 이득은 둘이다. 이미 가진 생성 능력을 별도 네트워크에 복제하지 않고 다시 쓰게 되고, 재생성 단계에서 원래의 멀티모달 컨텍스트를 다시 불러올 수 있다. 기존 업스케일이 어림짐작만 하던 작은 글자와 미세한 질감이 돌아오는 이유가 여기에 있다.
이미 가진 소재에는 다른 문이 있다. 768P 규격을 만족하는 클립이라면 재생성 작업으로 2K까지 올릴 수 있다. 요청에는 원본을 만들 때 쓴 내용을 모두 재현하고 원본 영상 항목을 하나 더해야 한다.
생성 전에 컨텍스트를 읽는다
멀티모달 입력은 금세 감당하기 어려워지고 손으로 쓴 프롬프트로는 담기지 않는다. 공식 해법이 H3-Context-IR이다. 텍스트와 이미지, 오디오, 영상을 함께 분석하고 입력 사이의 관계를 추론해 더 의미가 짙은 구조화된 서술을 돌려준다. 돌아오는 것은 강화된 프롬프트뿐이고 영상은 나오지 않는다. 생성 전의 번역 계층이며 생성기 자체는 아니다.
뒤에 있는 것은 Contextual Omni Representation이다. 언어를 일반화 가능한 다리이자 해석기로 쓰고, 작업을 열린 서술 형태로 통일한다. 이해 파이프라인은 약 100K 토큰의 원자료를 평균 4K 토큰 정도로 증류한 뒤 모델에 넘긴다.
가격 주장
가격 대비 성능에 대해 글은 이렇게 쓴다. H3는 기본으로 2K를 주고, 2K에서 초당 가격이 주류 모델의 3분의 1 미만이며, 768P에서는 주류 모델이 720p에 매기는 가격의 절반 미만이다. 제공자 쪽 표현이므로 사용자는 자기 사용량으로 다시 계산하면 된다.
개인 사용자는 중국어 사이트가 월 42위안부터, 국제 사이트가 월 9달러 99센트부터라고 안내한다. 두 곳 모두 신규 가입에 무료 포인트를 준다고 하며, 중국어 사이트 표기는 3000 포인트다.
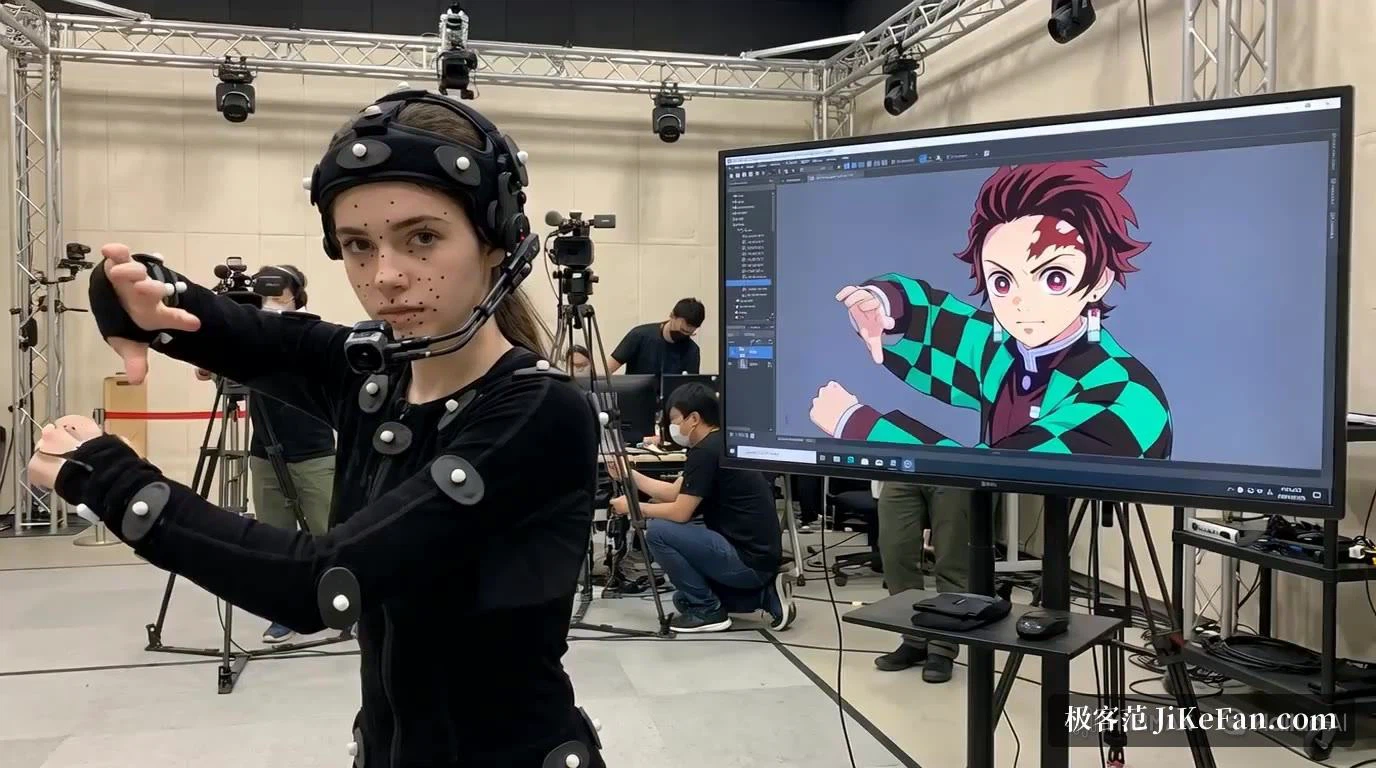
API로 다루기
생성은 비동기이고 문서는 세 단계로 나눈다. 먼저 작업을 만들어 task_id를 받는다. 그 id를 폴링하면 성공 시 응답이 완성된 영상 위치를 바로 준다. 별도 파일 id를 주고받을 필요가 없다. 마지막으로 그 위치에서 파일을 받는다. 10초 간격 확인을 권하며 failed와 cancelled는 종료 상태다.
입력 쪽 한도도 미리 알아 두면 좋다. 프롬프트는 7000자까지. 단일 파일은 영상 50 MB, 이미지 30 MB, 오디오 15 MB까지. 요청 본문은 64 MB까지이고 큰 소재는 URL로 넘기는 편이 낫다. 영상은 H.264/AVC와 H.265/HEVC, 이미지는 JPG, PNG, WEBP, HEIC, 오디오는 WAV와 MP3를 받는다.
세부 조건
오픈 웨이트는 아직 표명과 계획 단계다. 사이트는 이미 H3를 open-weight로 표시하지만, 글에는 적용 법규의 범위 안에서 추후 모델 가중치를 공개할 계획이라고 적혀 있다. 기준이 되는 것은 실제 배포된 버전이고 계획이 아니다.
참조 소재가 많다고 좋은 것은 아니다. 혼합 입력 전체 12개 파일이 단단한 상한이고, 중국어 사이트와 국제 사이트가 기본으로 보여 주는 값도 다르다. 실제 한도는 고른 모델과 등급에 달려 있다.
두 모델은 호환되지 않는다. H3는 768P와 2K에 4에서 15초, H3 Max는 480P와 768P에 5에서 15초다. 고르기 전에 완성본 요구에 먼저 맞춰야 한다.
3분의 1이라는 숫자는 제공자 주장이고 제3자 가격과 프로모션은 움직인다. 예산은 그때의 공식 가격으로 잡고, 생성물이 플랫폼 규범과 현지 법규를 지켜야 한다는 점도 기억해야 한다.
정리하면 이번의 볼거리는 영상 생성 입구가 하나 더 생긴 것이 아니다. H3가 영상과 이미지, 오디오의 이해를 한 컨텍스트로 접은 것이다. 2K가 기본, 최대 15초, 처음부터 스테레오, 2K는 업스케일이 아니라 재생성, 참조 한도는 이미지 9장에 영상 3편, 오디오 3편. 비슷한 도구와 나란히 놓았을 때의 실용성은 이 숫자들이 말해 준다.