
HeyGen, '누구인가'와 '어떻게 보이는가'를 분리해 175개 언어로 같은 아바타를
요약
웹캠으로 15초만 찍으면 배경을 바꾸고 옷을 갈아입고 언어를 바꿔도 무너지지 않는 출연자를 얻는다. 효과를 내는 것은 더 좋은 얼굴이 아니라, 프레임을 넘어 끌어올려 겉모습과 분리해 붙드는 정체성 신호다.
추천- 이름
- HeyGen
- 버전
- 20260916
- 오픈소스
- 비오픈소스
- 운영체제
- Web
- 공식 사이트
- https://www.heygen.com/
- 업데이트
- 2026-10-06 06:56
출연 영상에서 시간을 잡아먹는 것은 대개 내용이 아니다. 조명을 세우고 화장을 고치고 셔츠를 세 번 갈아입은 뒤 같은 문단을 렌즈 앞에서 다시 말하는 일이다. 디지털 휴먼이 없애려는 것이 바로 이 반복이고, 지난 몇 년간 늘 같은 지점에서 멈췄다. 한 프레임은 괜찮은데 이어 붙이면 들통난다. 배경을 바꾸면 얼굴이 흔들리고, 길게 말하면 입 모양이 어긋나고, 언어가 늘면 그냥 무너진다.
HeyGen은 이 분야에서 비교적 빠르게 도는 플랫폼이다. 지금 주력인 Avatar V는 제품 페이지에서 단도직입적으로 말한다. 웹캠으로 15초를 찍으면 장면을 넘어 일관된 출연자를 얻고 175개가 넘는 언어와 방언을 말할 수 있다고. 그럴듯해 보이는 아바타와 실제로 맞는 아바타 사이의 거리는 이 문장의 두 단어에 달려 있다. 일관성과 다국어다.
판단 기준은 한 프레임이 아니었다
Avatar V 페이지는 인물 일관성을 첫 능력으로 두고 표현도 에두르지 않는다. 일관성이 쓸 만한 아바타와 겉치레를 가르는 선이라고 적는다. 정의는 이렇다. 같은 얼굴, 같은 미세 표정, 같은 존재감이 30초 클립에서도 10분 강의 모듈에서도 성립하고, 흔들리지 않고, 인공물이 끼지 않고, 언캐니 밸리로 떨어지지 않는다.
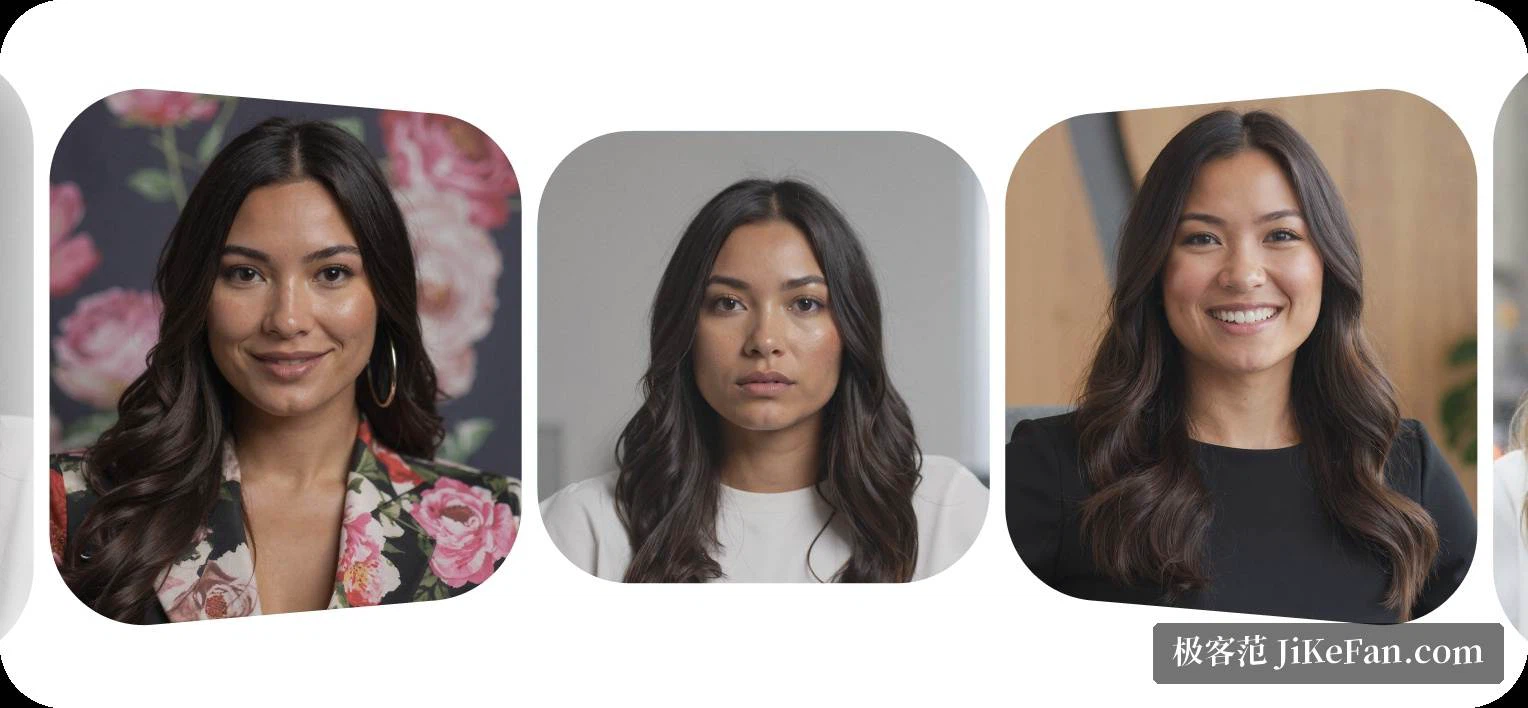
이 문장 뒤에서 방법이 바뀌었다. 이전에는 사진 한 장에서 얼굴을 움직이는 방식이었고, 참조가 한 프레임이면 담을 수 있는 정체성 정보도 그만큼이었다. Avatar V는 참조 영상 전체의 컨텍스트 창 위에서 동작하며, 정보량이 큰 순간을 모델이 스스로 고르게 한다.
정체성을 겉모습에서 떼어내다
공식 설명은 새 모델이 '누구인가'와 '어떻게 보이는가'를 둘로 나눈다고 말한다. 모델이 배우는 것은 당신이 움직이고 손짓하고 감정을 드러내는 구체적인 방식이며, 그 방식은 어떤 버전의 당신에게도 적용된다. 쓰는 쪽에서 보면 촬영은 한 번이고, 무엇을 입고 어디서 찍었는지는 중요하지 않으며, 이후 아바타는 어떤 배경에도 어떤 옷에도 어떤 스타일에도 나타난다.
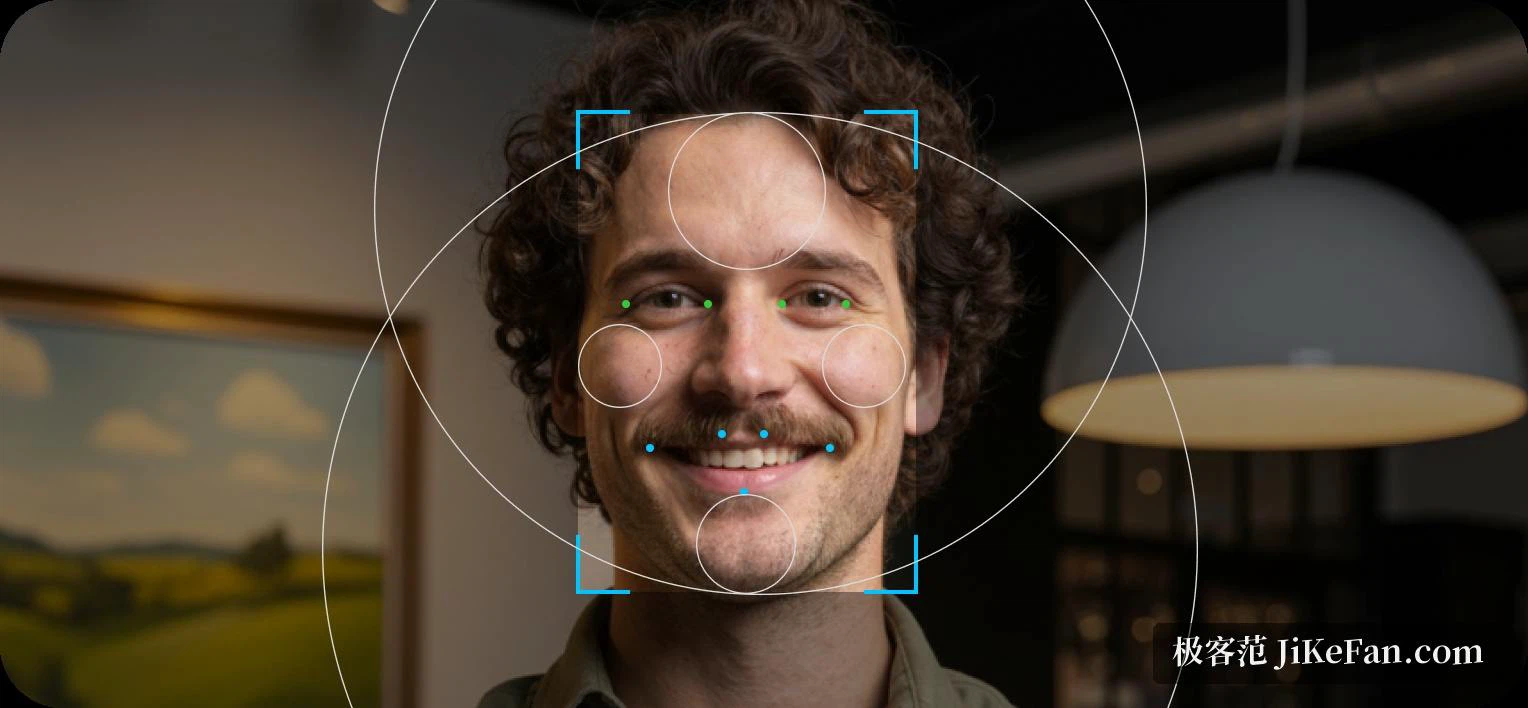
방식은 선택적 주의다. 입의 기하와 얼굴 윤곽 구조, 표정 전이 패턴 같은 정체성 신호를 여러 프레임에서 끌어오고, 동시에 자세나 조명, 가림이 나쁜 프레임을 적극적으로 억제한다. 이렇게 모은 정체성 표현은 프레임을 넘고 시간을 지닌다. 겨냥하는 문제는 정체성 드리프트다. 한 프레임 조건 모델에서 참조 정체성과 결과가 서서히 갈라지는 현상이고, 이 방식은 추가 미세 조정이나 참조 입력 없이도 장면과 카메라 위치, 긴 길이에서 안정을 유지한다고 주장한다.
공개된 수치는 긴 영상에서 일관성이 30분을 넘겨 유지되고, 생성 시 길이나 화질에 상한을 두지 않는다고 밝힌다. 훈련은 세 단계다. 먼저 한 장면 안에서 얼굴 겉모습을 충실히 복제하는 법을 배우고, 다음에 장면을 넘는 미세 조정으로 배경과 조명, 자세 분포의 차이를 흡수하고, 마지막으로 인간 선호를 보상으로 쓰는 강화 학습으로 정체성 유사도를 끌어올린다.
Video Agent: 한 문장으로 완성본, 렌더 뒤에도 수정
아바타는 당신이 화면에 나오는 문제를 푼다. 다른 제품 축은 영상이 어디서 오는지를 푼다. Video Agent는 프롬프트에서 완성본을 돌려주고, 단지 말하는 머리를 내놓는 것이 아니라고 강조한다. 움직이는 그래픽과 시각적 오버레이, 설명용 애니메이션, B-roll 소재까지 이야기 안에 엮어 대본과 음성, 화면, 전환을 같은 생성에서 끝낸다.
더 흥미로운 것은 편집 가능성이다. 렌더가 끝난 뒤에도 모든 동적 요소가 편집 가능하다. 글자와 위치, 색, 타임라인, 배치를 AI Studio에서 바로 바꾸므로 한 줄 고치려고 영상 전체를 다시 렌더할 필요가 없다. 공개 전 미리보기도 있고, 기획을 장면별로 나눠 자연어로 더 다듬을 수 있다. 이 둘이 합쳐져야 한 번 만들고 마음에 안 들면 다시 시작하는 생성기와 갈린다.
번역이 바꾸는 것은 목소리만이 아니다
다국어는 디지털 휴먼의 가장 자연스러운 확장이고 HeyGen이 처음 알려진 영역이다. 공식 번역 페이지의 흐름은 이렇다. 로컬 영상을 올리거나 온라인 영상 링크를 붙이고, 엔진과 대상 언어를 고르면 플랫폼이 번역과 더빙, 입 모양 정렬을 처리한다. 다시 찍을 필요도, 손으로 입을 맞출 필요도 없다. 원래 화자의 음색과 입 모양, 표정은 유지된다.
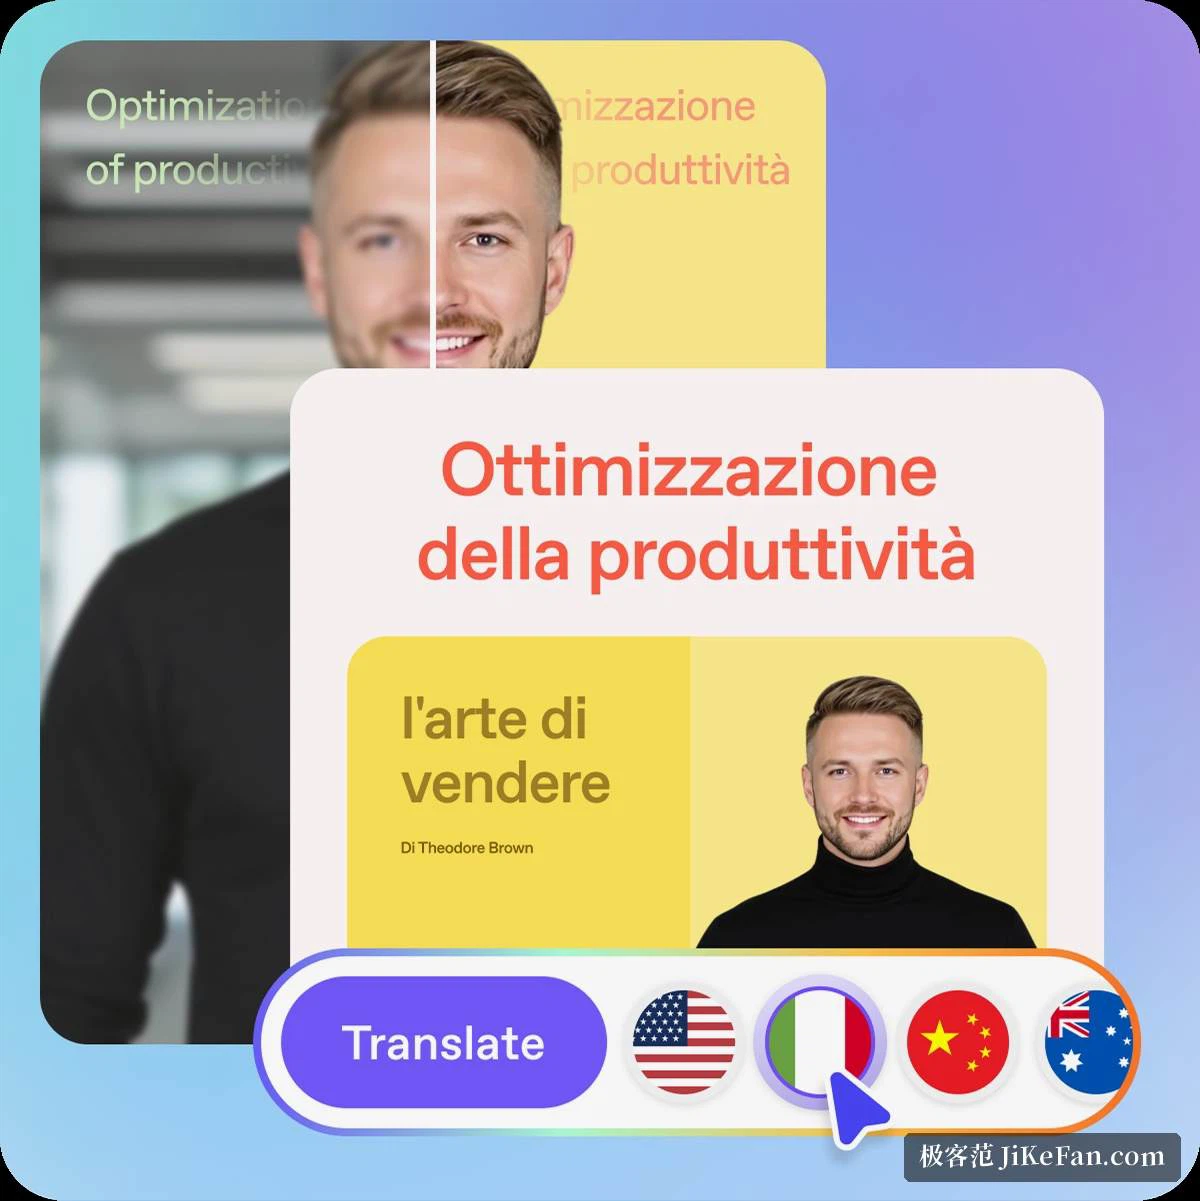
조작에서 기억할 점이 하나 있다. 한 번에 최대 10개 언어를 골라 번역할 수 있어 원본 하나로 여러 언어를 동시에 펼칠 수 있다. 한 언어씩 줄 세울 필요가 없다. 브랜드 쪽 제어도 따로 설계돼 강화된 용어집이 강제 번역과 보호 용어, 발음 교정을 지원한다. 용어 집합을 만들고 번역문을 고쳐 한 편의 영상에서 여러 언어판을 만든다. 영상 모음에는 다국어 플레이어를 붙여 페이지나 LMS에 바로 넣을 수 있다.
본인 확인은 덧붙임이 아니라 전제
이 분야는 신뢰 문제를 피할 수 없다. HeyGen은 본인 확인을 생성 단계 맨 앞에 둔다. 모든 맞춤 아바타는 촬영되는 본인이 카메라 앞에서 확인을 마쳐야 하고, 확인이 없으면 아바타도 없다. 본인의 삭제 요청은 항상 실행된다. 내용 쪽은 기계 학습 스캔과 사람 검토 두 단계이며, 폭력과 정치 운동, 미성년자에 대한 해악을 넘지 말아야 할 선으로 명시한다.
각 요금제가 실제로 주는 것
무료 요금제는 월 3편, 편당 1분까지로 결과를 먼저 확인하기에 맞는다. Creator는 월 29달러부터로 편당 상한을 30분으로 늘리고 1080p 내보내기와 음성 복제를 더하며 언어 범위도 175개를 넘긴다. Pro는 월 49달러부터로 4K 내보내기와 더 빠른 처리가 주된 차이다. Business는 월 149달러부터로 맞춤 아바타 수와 좌석 관리, 협업이 늘어난다. 팀이 커질수록 좌석과 크레딧으로 짜인 이 설계는 사용량을 미리 어림해야 한다.
구조로 보면 HeyGen은 아바타 만들기, 완성본 만들기, 현지 언어로 번역하기라는 원래 다른 도구에 흩어져 있던 세 작업을 한 줄로 묶었다. 그쪽이 더 완성된 부분이다. 유의할 점은 한도와 동시 실행이 등급으로 나뉜다는 것이고, 많이 내보내는 팀은 등급을 고르기 전에 실제 제작 빈도로 크레딧 소모를 계산해 두는 편이 좋다.
디지털 휴먼의 진짜 문턱은 한 프레임이 비슷한가가 아니었다. 장면과 길이, 언어가 바뀐 뒤에도 비슷한가다. Avatar V는 정체성을 겉모습에서 분리해 다루며 일관성에 답하고, Video Agent와 번역이 대본에서 여러 언어의 완성본까지 가는 길을 채운다.