
Open WebUI : l'interface qui manquait à un modèle hébergé chez soi
Résumé
Pointé vers un serveur de modèles déjà en place ou vers une interface compatible, une fenêtre de navigateur devient un espace de travail : modèles côte à côte, base documentaire interrogeable, droits par rôle et authentification unique.
Recommander- Nom
- Open WebUI
- Version
- 0.11.3
- Open source
- Open source
- Système
- Web
- Mis à jour
- 2026-10-28 22:00
Quiconque a fait tourner un grand modèle chez soi connaît la même scène. Le modèle travaille tranquillement sur la machine du coin, et dès qu'un proche ou un collègue veut s'en servir, il ne trouve qu'une ligne de commande nue, ou une boîte de dialogue ajoutée après coup. Monter un espace de travail partagé correct sans confier les données à un service hébergé, voilà précisément le manque que ce projet comble.
Le départ était modeste. Il est né comme façade pour un moteur de modèles local bien précis, a pris son nom actuel en janvier 2024, et sa tâche initiale était de donner à ce moteur une couche graphique utilisable. Après plusieurs cycles rapides, l'ambition a dépassé le mot façade. La description officielle parle d'une plateforme d'intelligence artificielle auto-hébergée, extensible, dense en fonctions et capable de tourner entièrement hors réseau. On peut la diriger vers un serveur de modèles local, ou coller l'adresse de n'importe quelle interface compatible, et les modèles des grands fournisseurs comme ceux d'un moteur d'inférence sur votre propre carte graphique apparaissent dans la même fenêtre. Un seul socle, n'importe quel fournisseur : c'est le tempérament de la chose depuis le début.
D'une façade de dialogue à quelque chose que l'on exploite
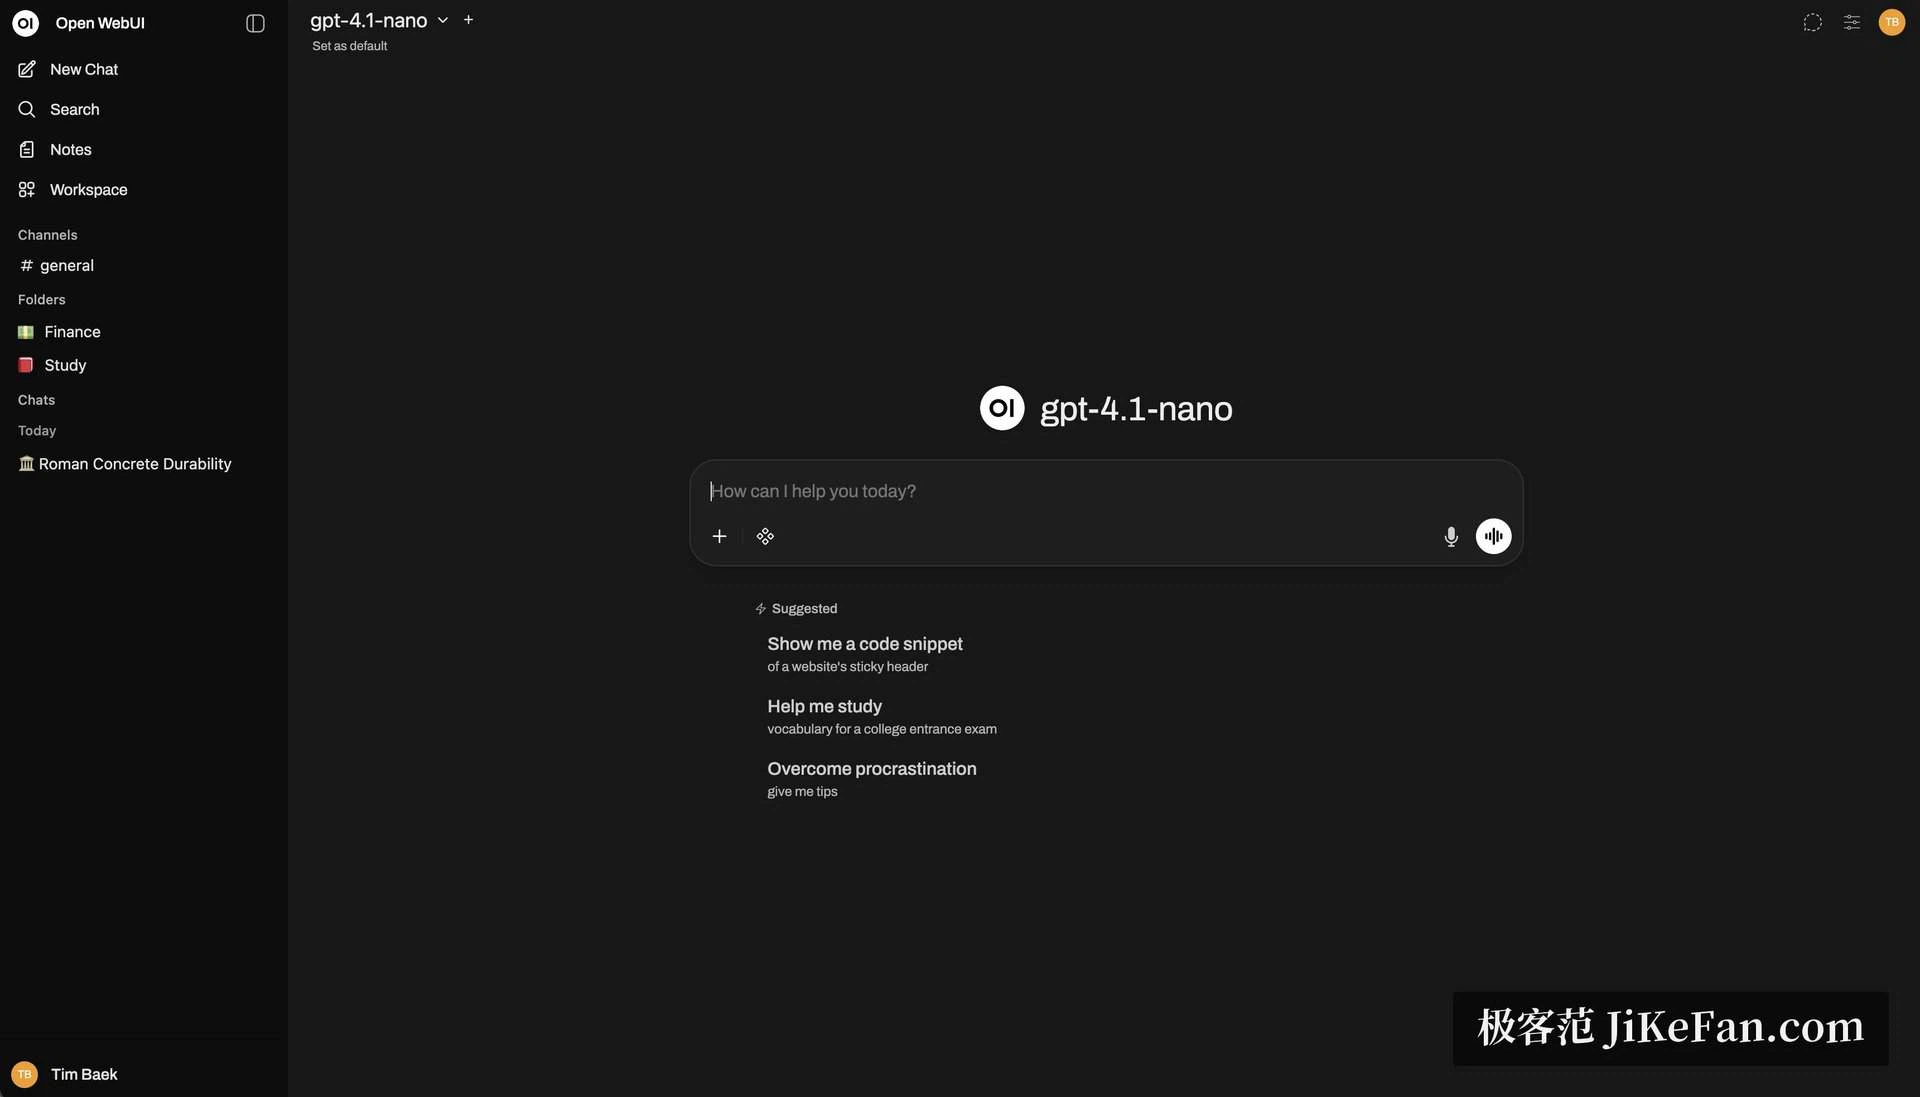
L'installation suit la même logique : déployer une fois, servir tout le monde. Une seule commande de conteneur monte une instance complète en bien moins d'une minute ; un gestionnaire de paquets l'installe dans un environnement Python existant ; il existe même une version officielle pour poste de travail. On ouvre ensuite un navigateur et la disposition de dialogue familière est simplement là, si bien que ceux qui viennent d'un assistant hébergé n'ont presque rien à réapprendre.
Des essais indépendants ont mesuré ce que coûte cette couche supplémentaire. Même modèle quantifié de soixante-dix milliards de paramètres, même carte graphique : l'écart de vitesse d'inférence entre un accès direct et un appel passant par cette interface ressort à environ deux pour cent, la sortie en flux reste fluide, et un serveur au repos occupe quelques centaines de mégaoctets de mémoire. Ce sont les chiffres qui décident si une couche de confort vaut la peine.
Ce que contient réellement cette fenêtre
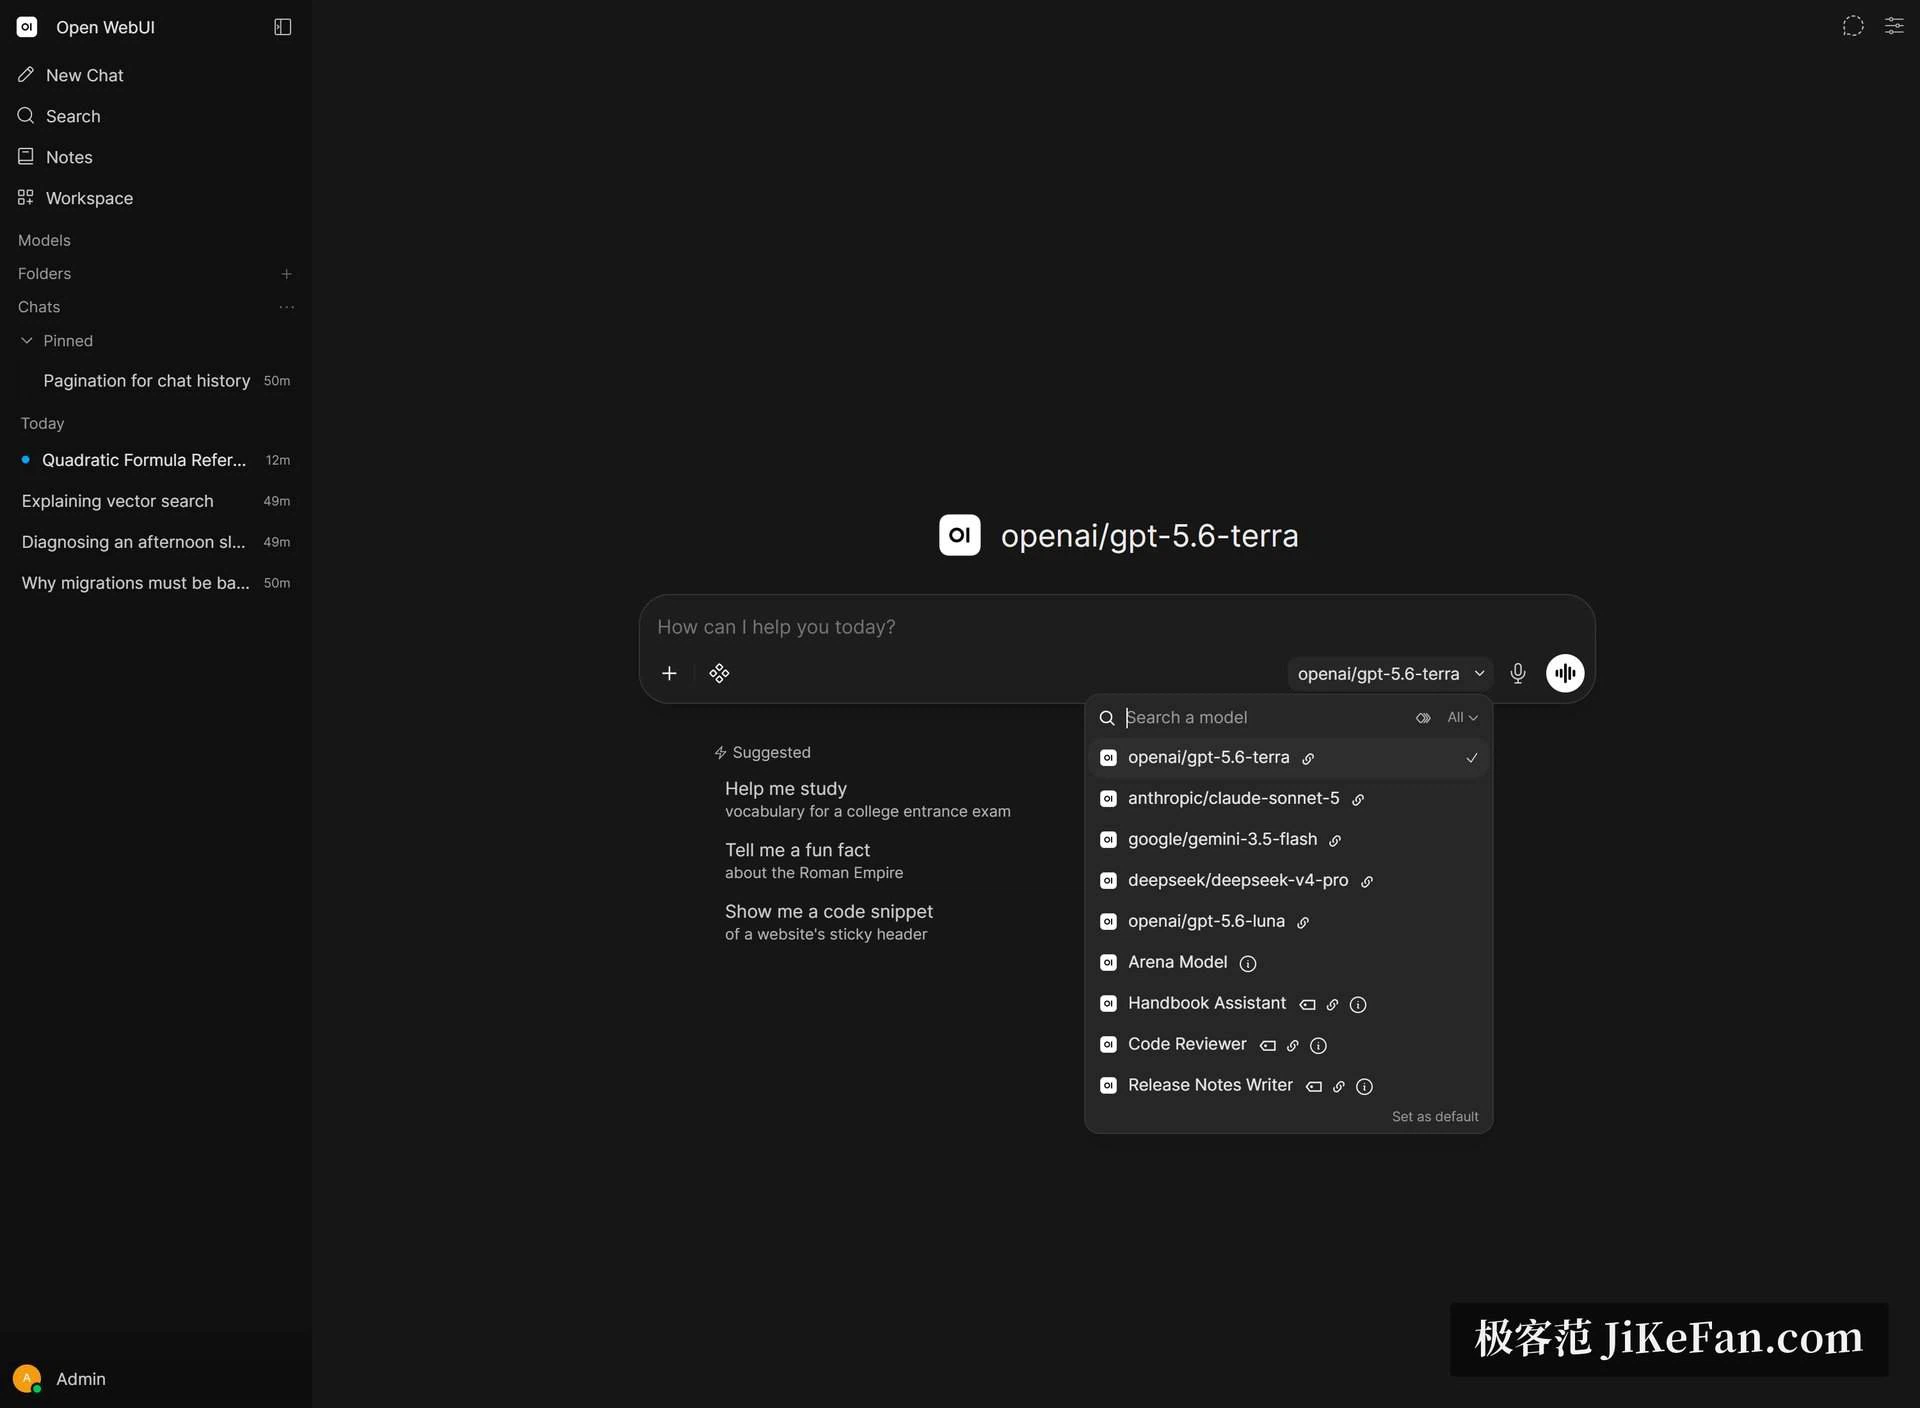
Ce qui sort ce projet de la masse des interfaces de dialogue, c'est l'épaisseur de la liste de fonctions. Deux modèles ou plus répondent côte à côte, ce qui permet de comparer directement leurs sorties, et changer de modèle en cours de conversation conserve le contexte. Markdown et LaTeX sont composés correctement, les notes techniques et les formules ont donc l'air de ce qu'elles sont. La dictée, la synthèse vocale et même un mode appel vidéo sont intégrés. La génération d'images se branche sur plusieurs moteurs différents. Une file de messages permet de continuer à taper pendant qu'une réponse s'écoule, une mémoire transporte les préférences d'une conversation à l'autre, et une automatisation planifiée peut déclencher une consigne à intervalle fixe.
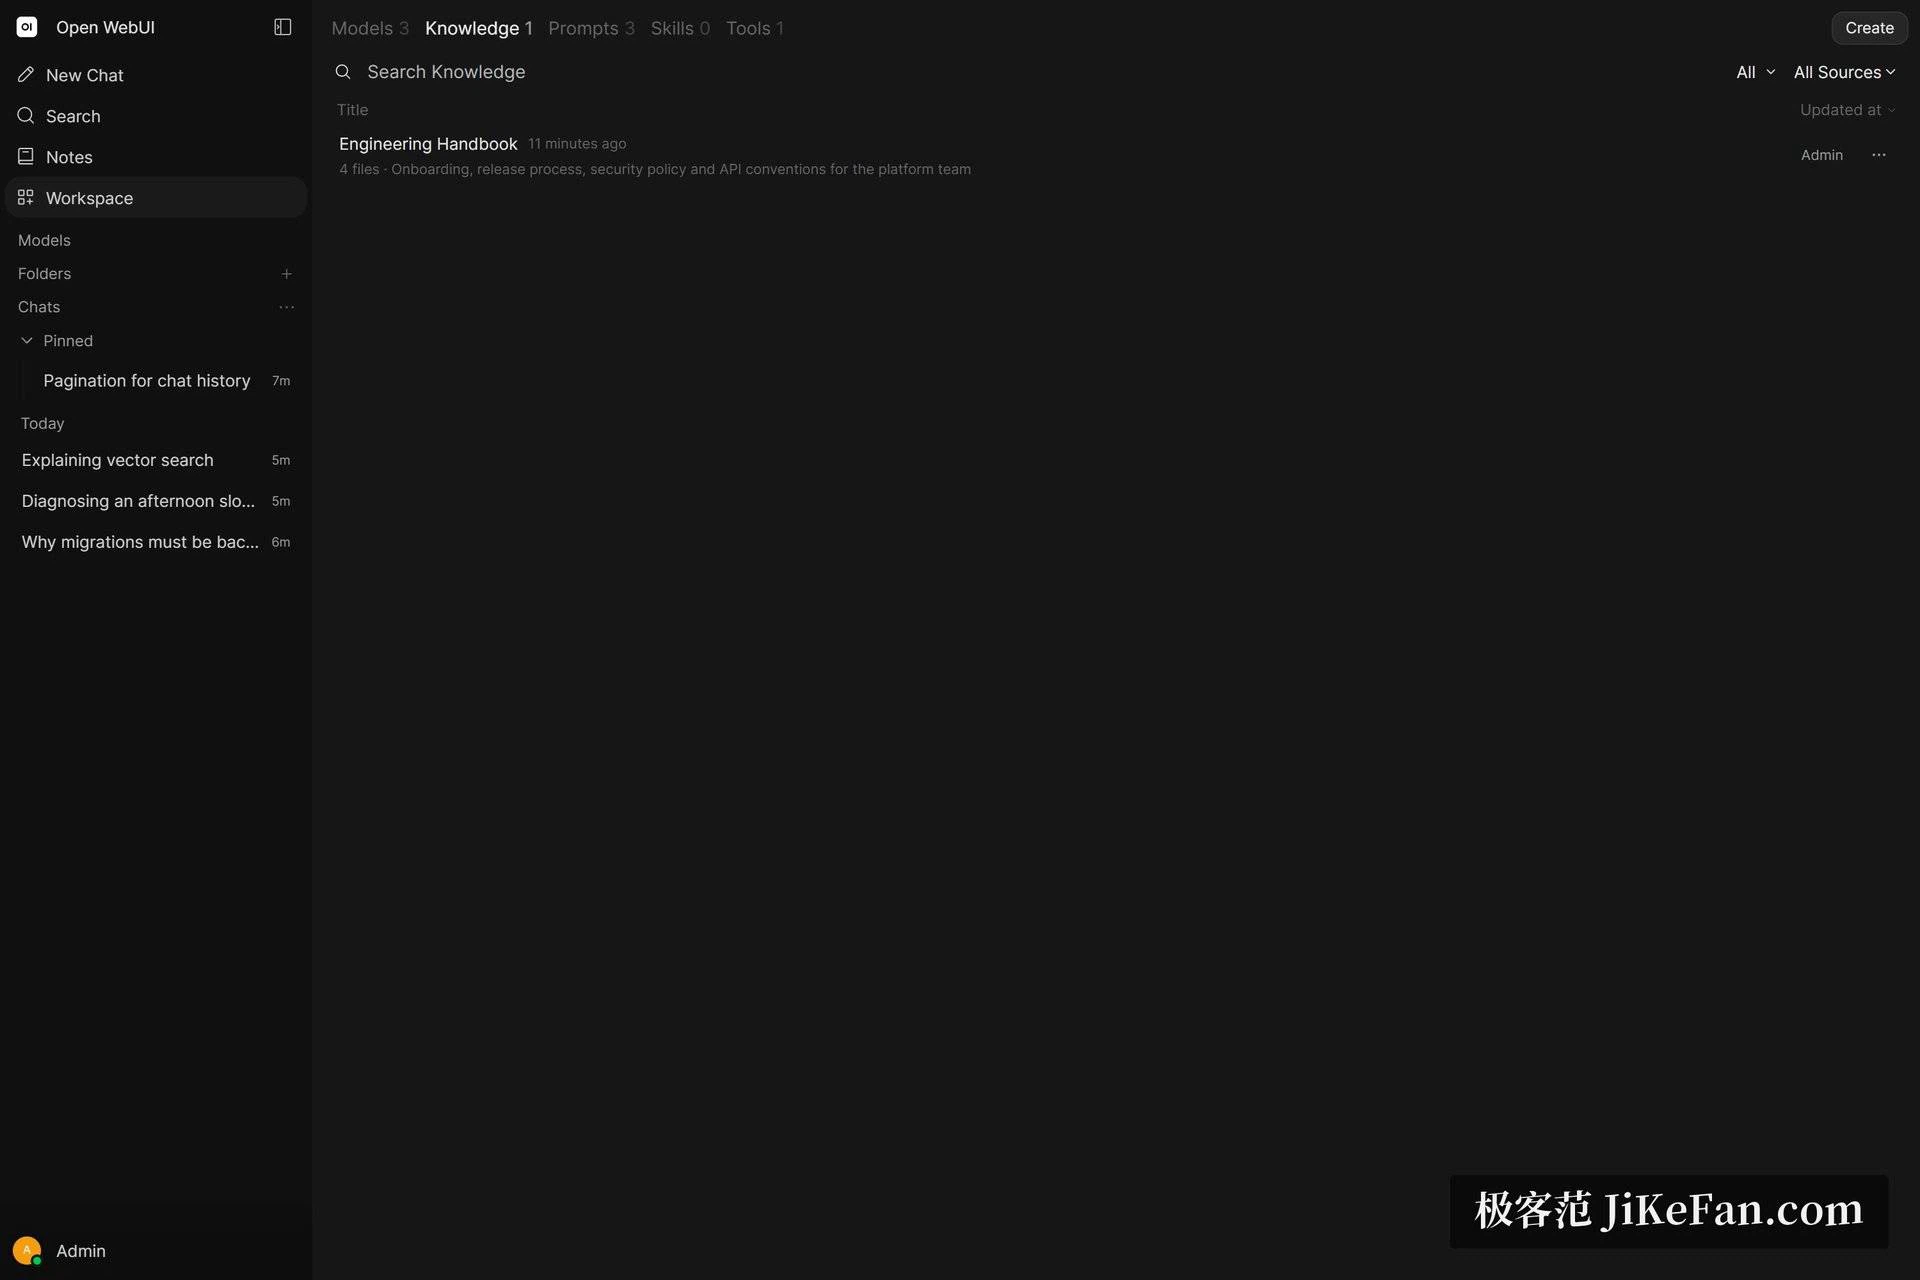
Pour qui travaille avec des documents, le versant recherche mérite son paragraphe. Deux magasins vectoriels sont entretenus officiellement, une douzaine d'autres raccordements existent pour d'autres magasins, et une variété comparable d'extracteurs couvre le versant lecture. La recherche mixte combine un score de mots-clés et une proximité vectorielle, puis reclasse par un encodeur croisé ; quand la précision compte plus que le coût, un mode plein contenu saute le découpage et injecte un document entier dans le contexte. Construire une base de connaissances à partir de fichiers PDF et laisser le modèle y chercher seul demandait hier d'assembler une pile de briques. Ici, cela arrive en état de marche.
Niveau équipe, pas jouet personnel
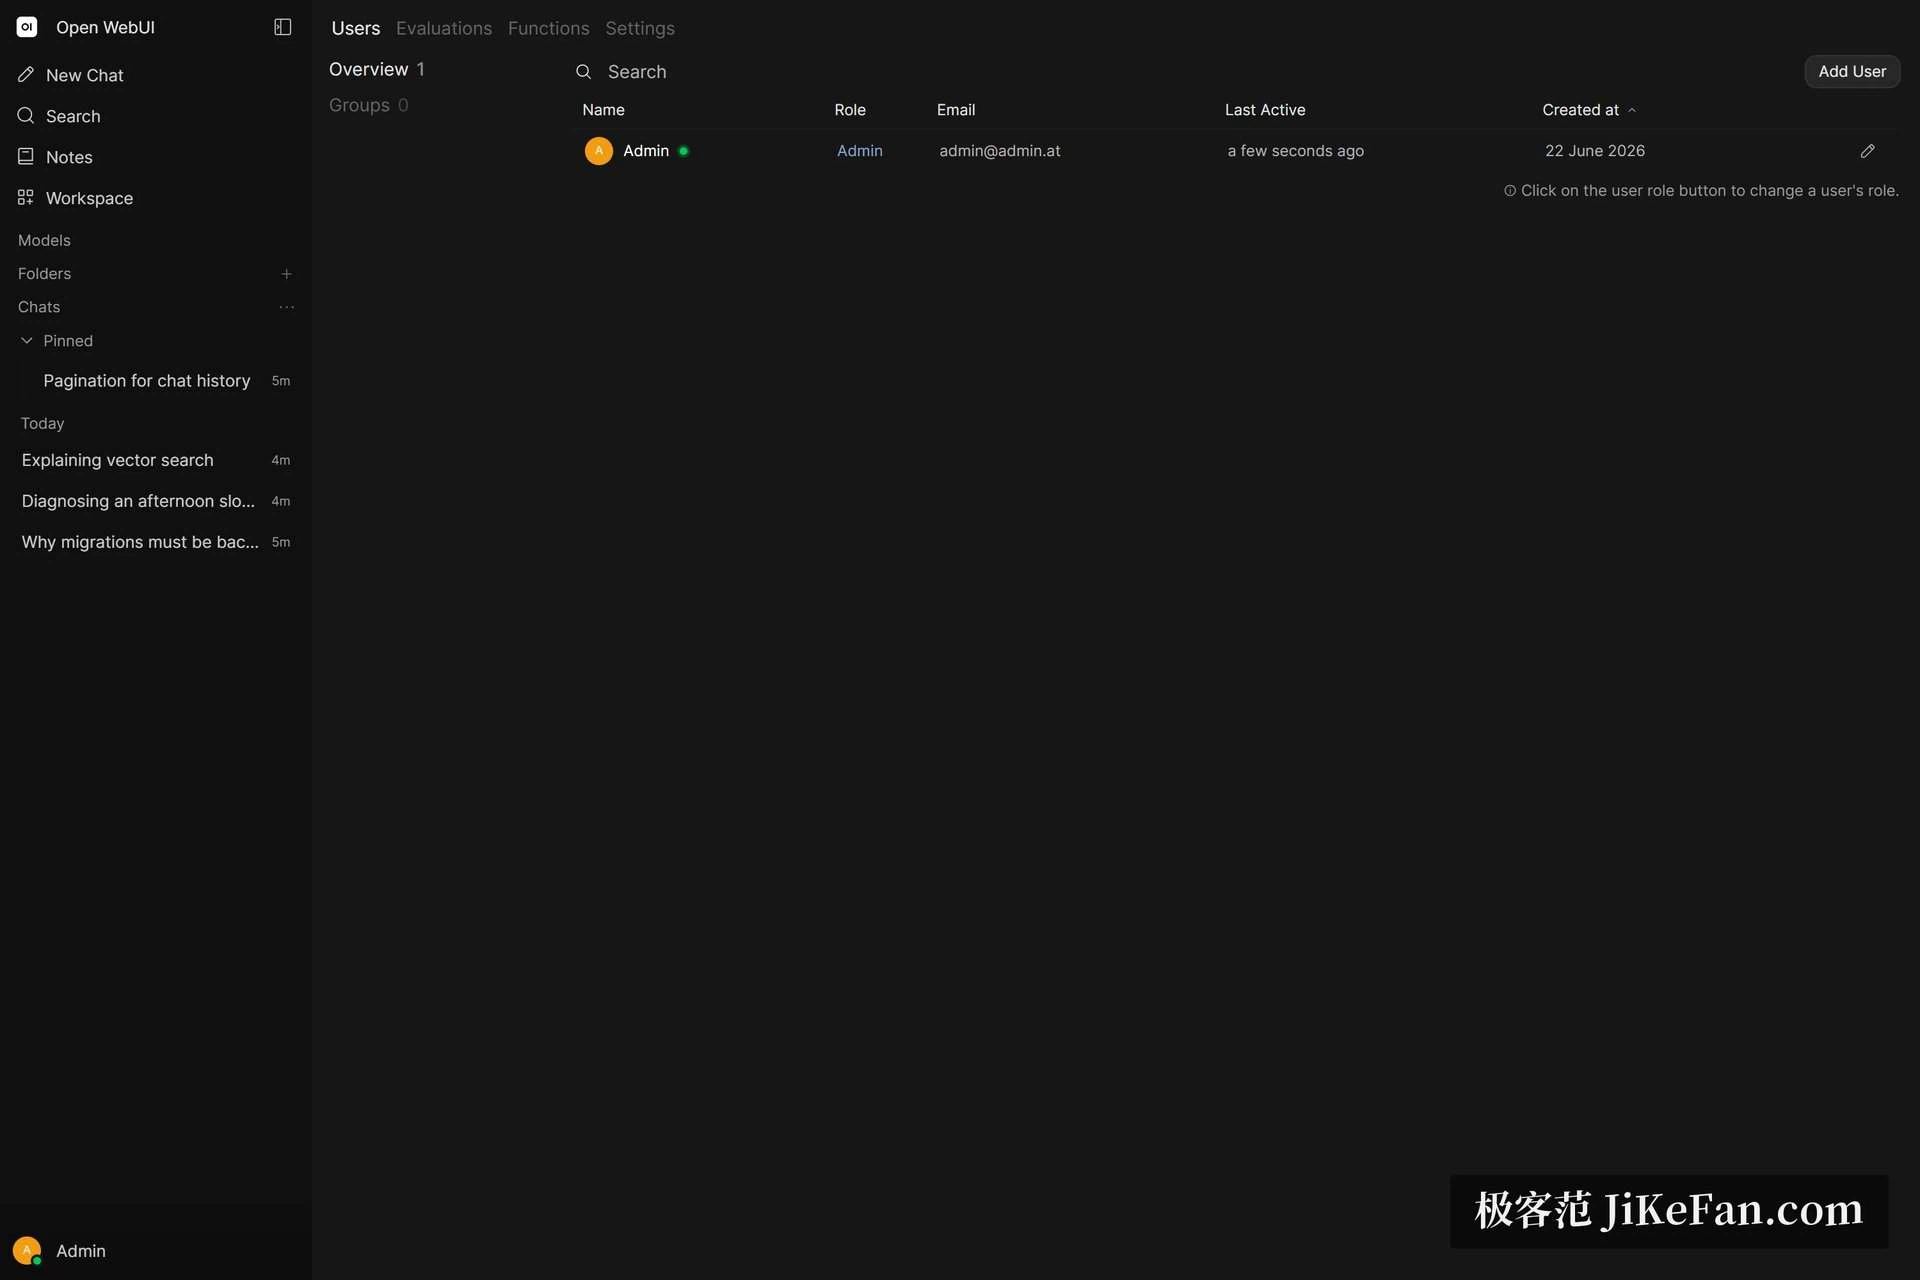
Beaucoup d'interfaces de dialogue libres s'arrêtent à l'usage individuel. Celle-ci place des fonctions d'entreprise dans l'édition communautaire gratuite : des droits par rôle décident précisément qui peut utiliser quel modèle, une authentification unique via OIDC et un annuaire s'accroche à un système d'identité existant, un provisionnement automatique maintient les groupes d'utilisateurs en phase avec cet annuaire, et un journal d'audit consigne chaque usage. La documentation dit clairement que ces fonctions d'identité sont gratuites pour un nombre illimité d'utilisateurs, sans clé de licence.
La collaboration a son propre mobilier. Les canaux placent personnes et modèles sur une même chronologie : on demande à un modèle d'esquisser une approche, puis à un autre de l'attaquer. Les notes se réécrivent sur place par un modèle et peuvent être injectées comme contexte dans la conversation. Pour une petite équipe qui veut posséder sa couche intermédiaire plutôt que la louer, l'ensemble est généreux.
L'extensibilité comme second rempart
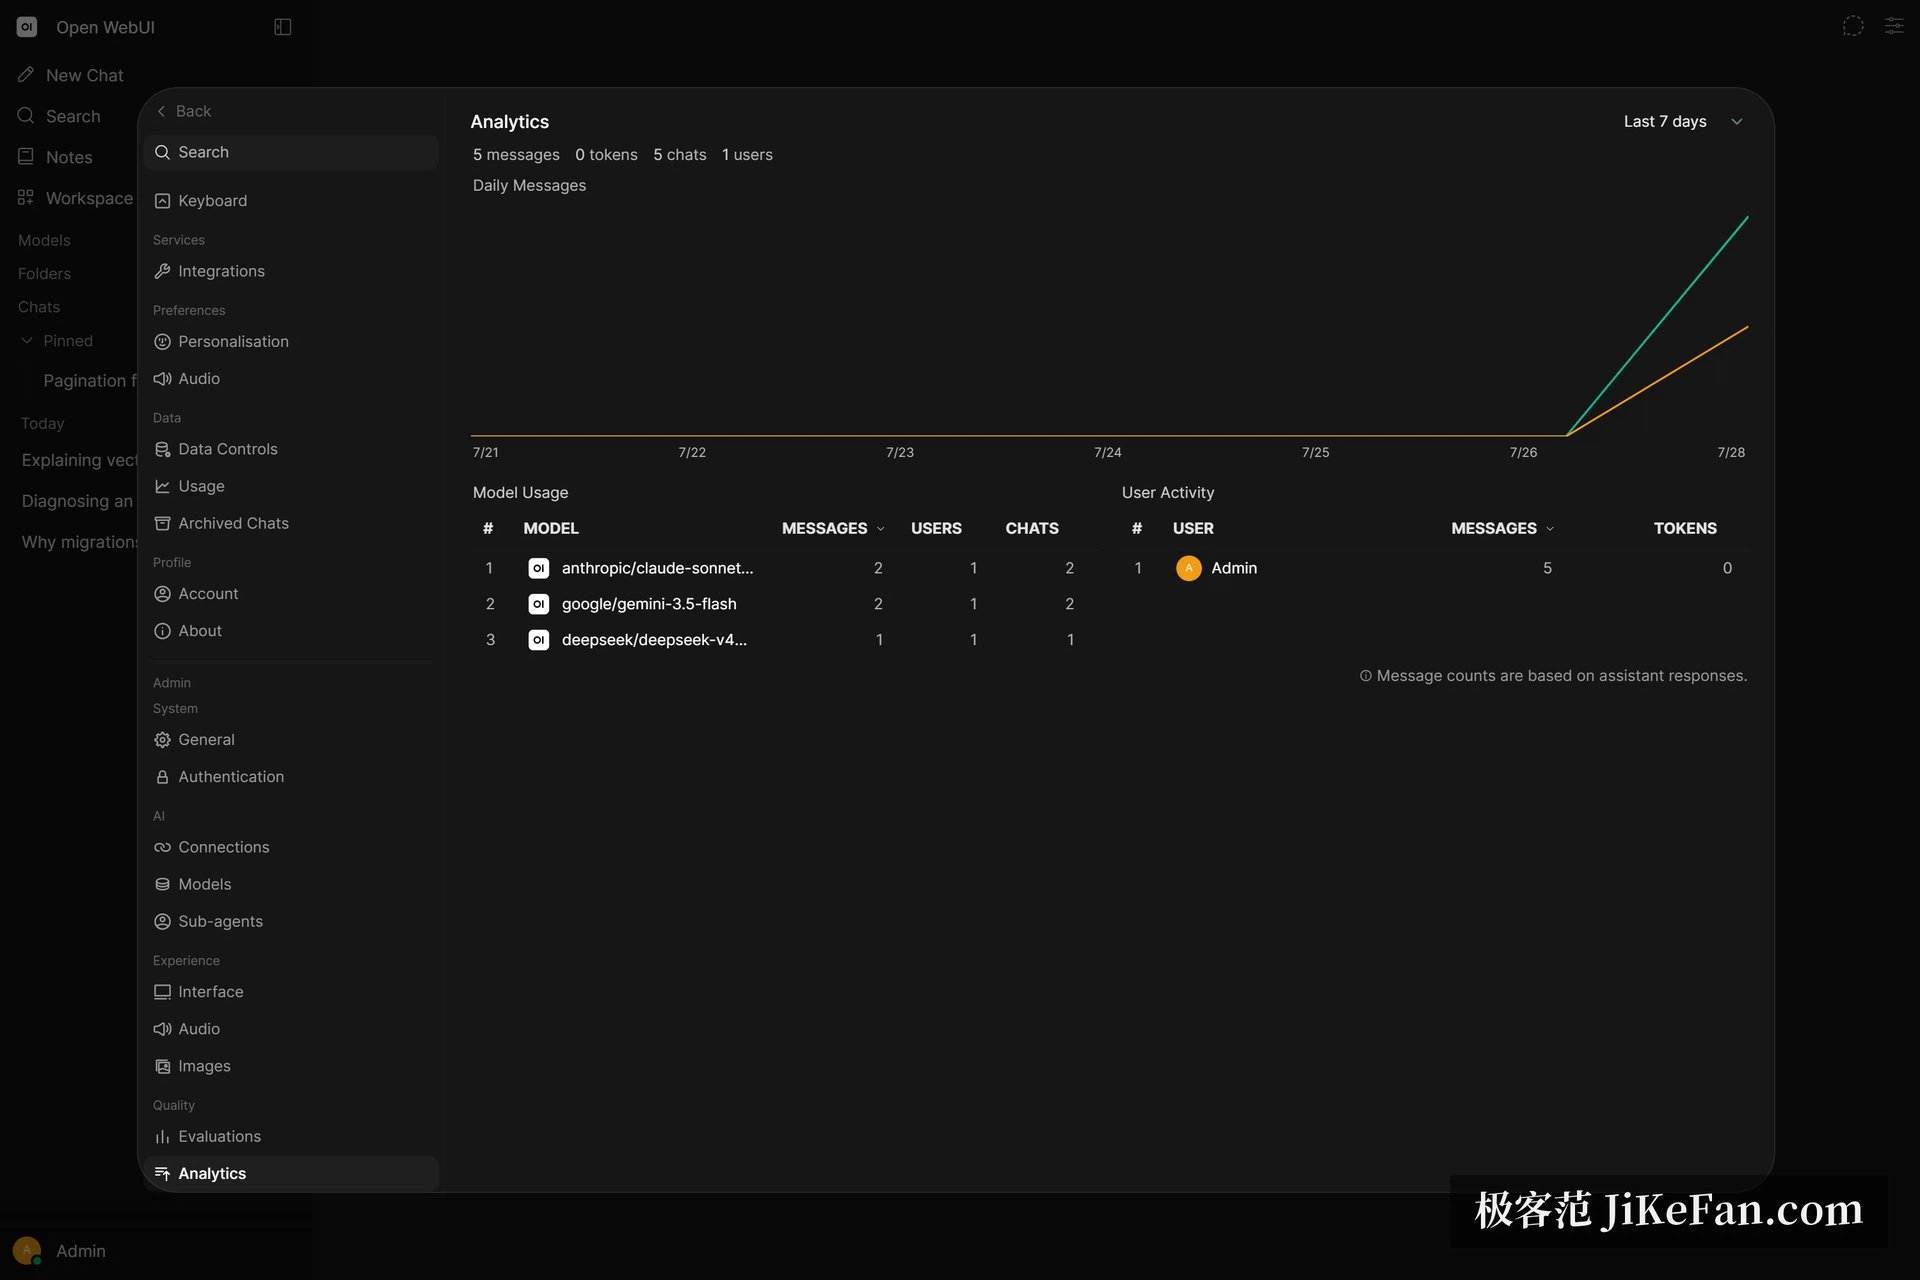
Des outils en Python s'écrivent dans le navigateur et s'exposent directement au modèle. Une chaîne d'extensions filtre et transforme chaque message : c'est ainsi que se construisent une limite de débit, une modération ou un relais vers un autre service. La prise en charge native de MCP relie un modèle à des serveurs d'outils extérieurs, et une fonction de terminal lui donne quelque chose comme un vrai ordinateur : écrire du code, l'exécuter, lire la sortie, corriger ses propres erreurs, tout dans la conversation. Ajoutez une arène de modèles, un tableau de consommation et un classement par note, et l'on a plutôt une infrastructure que l'on exploite des années qu'une application essayée une semaine.
Formes de déploiement et souveraineté des données
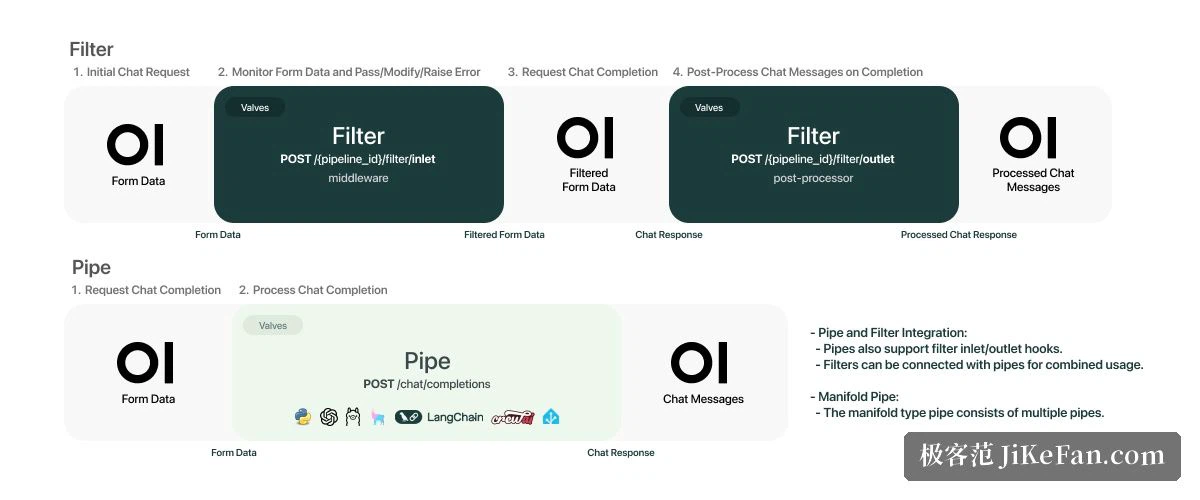
Les voies de déploiement sont volontairement larges. Un boîtier de stockage domestique ou un petit serveur virtuel à quelques dollars par mois suffit à un bout ; un ensemble de conteneurs est pris en charge à l'autre. En déplaçant l'état des sessions dans un magasin en mémoire, l'application s'étend horizontalement sur plusieurs nœuds, et en pointant les fichiers vers un stockage d'objets, des instances sans état deviennent possibles. Traces, mesures et journaux s'exportent par un protocole de traçage courant vers la surveillance que vous exploitez déjà.
La capacité qui compte le plus est de tourner sans aucun réseau extérieur. Sur un segment isolé ou avec le câble retiré, un modèle local et une base de connaissances locale bouclent encore tout le cycle, et c'est exactement pourquoi les cabinets médicaux, les études juridiques et les administrations soumises à des règles de résidence des données y jettent un œil. Les données restent sur vos disques du début à la fin, et changer de fournisseur de modèles ne change les habitudes de personne, une liberté qu'aucun service hébergé n'offre.
La licence est une ligne de partage
Un point se vérifie avant de déployer. En avril 2025, le projet est passé d'une licence BSD à trois clauses à une licence maison. La base reste BSD, avec une clause de marque ajoutée : un déploiement comptant au plus cinquante utilisateurs finaux actifs sur une fenêtre glissante de trente jours peut retirer librement les marques, au-delà il faut les conserver ou obtenir une autorisation écrite. Les particuliers, les familles et les petites équipes ne sont pas concernés, mais qui compte distribuer une version commerciale débaptisée doit peser cette ligne d'abord.
Les versions continuent de paraître à cadence serrée, la plus récente est 0.11.3, et le dépôt a dépassé cent cinquante mille étoiles et des centaines de millions de téléchargements, ce qui est une communauté qui vote par son attention.
Ramenez le regard. Si une machine capable de faire tourner un modèle est déjà là, il ne manque que la couche qui en fait une plateforme utilisable par une équipe. Ce projet la remplit avec l'encombrement d'un conteneur : interface, base de connaissances, droits et extensibilité, le choix du matériel restant entre vos mains. Pour des personnes et des équipes attentives à l'endroit où vivent les données et lassées de payer au siège, c'est aujourd'hui la voie la moins encombrante.